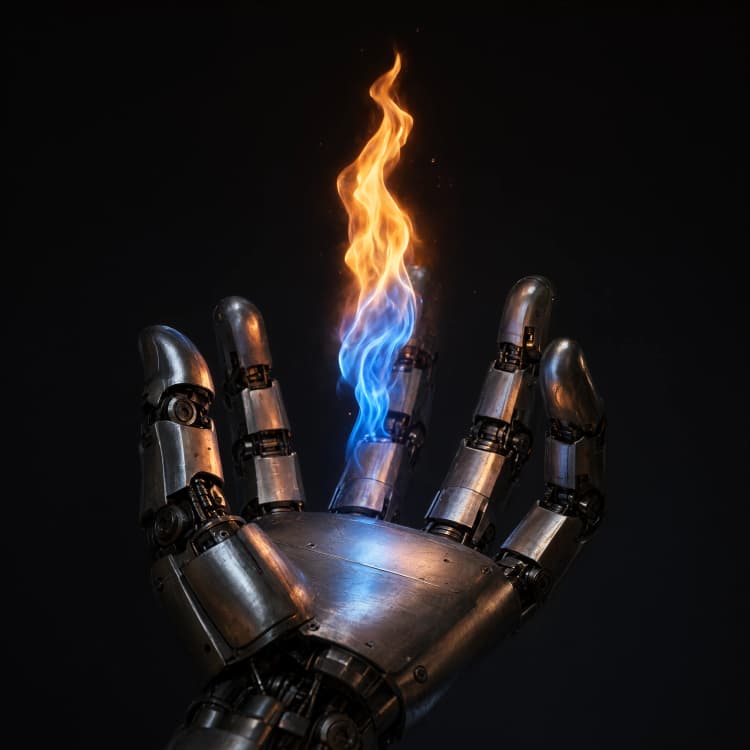
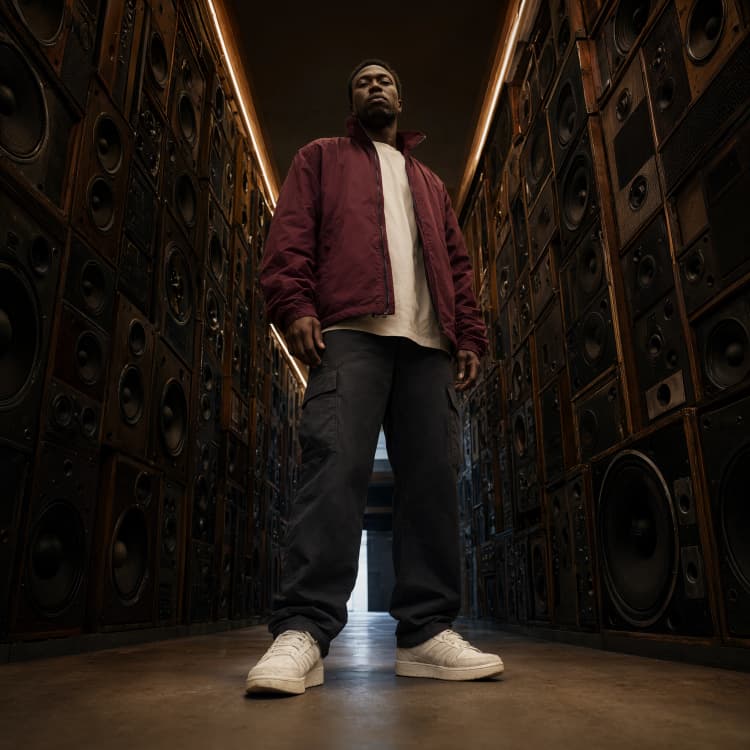
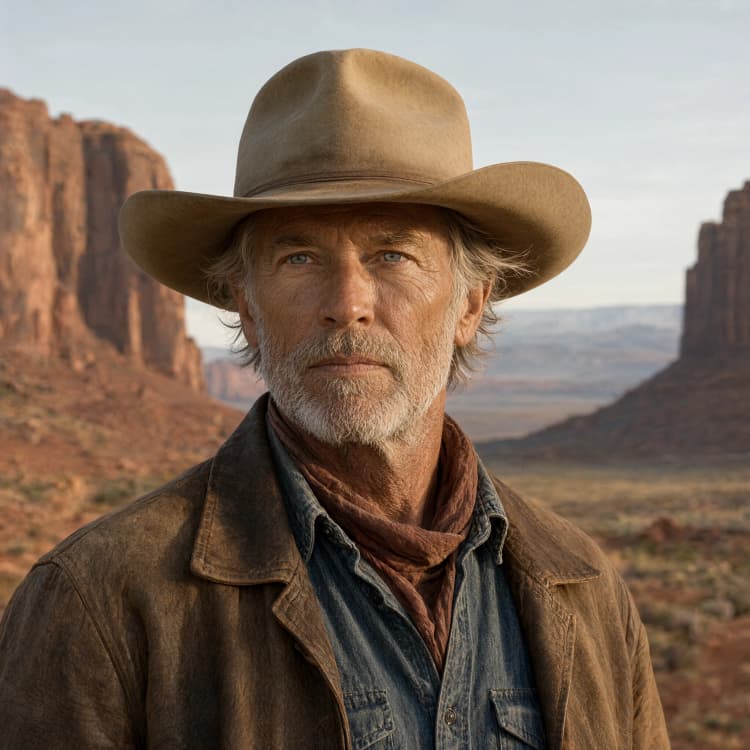
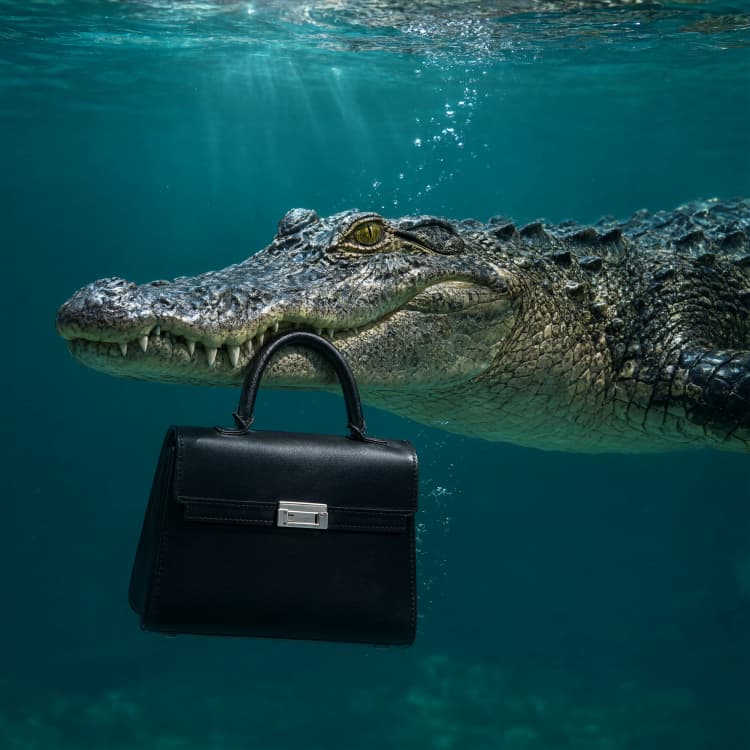
Qwen Image 2.1 Текст-в-Изображение ComfyUI Workflow#
Преобразуйте текстовые подсказки в детализированные изображения высокого разрешения с официальными открытыми весами Qwen-Image-2.1, упакованными для ComfyUI. Этот Qwen Image 2.1 Текст-в-Изображение ComfyUI Workflow разработан для создателей, которые хотят получать воспроизводимые результаты и четкий вывод на родном разрешении 2048×2048. Он поддерживает вывод INT8 для эффективного использования VRAM и сохраняет чистые RGBA PNG, что делает его подходящим для модных портретов, кинематографических кадров и отполированных продуктовых концепций.
Построенный вокруг простого пути генерации–декодирования–сохранения, рабочий процесс даёт вам прямой контроль над текстом подсказки, семенем и разрешением. Сохраните фиксированное семя для версионных итераций, переключайте стили с помощью формулировки подсказки и экспортируйте активы с прозрачным фоном, готовые для дизайнерских конвейеров.
Ключевые модели в Comfyui Qwen Image 2.1 Текст-в-Изображение ComfyUI Workflow#
- Qwen-Image-2.1 (Comfy-Org): Основная модель с открытыми весами текст-в-изображение, которая интерпретирует вашу подсказку и синтезирует изображение в скрытом пространстве. Она использует генератор в стиле MMDiT, оптимизированный для высокой детализации и композиции с учётом типографики. Comfy-Org/Qwen-Image-2.1
- Qwen-Image-2.1 VAE: Автоэнкодер, который декодирует сгенерированные латенты обратно в пиксели. Он сохраняет тонкую деталь и тональную согласованность на высоких разрешениях. Распространяется с тем же пакетом моделей, что и выше.
- Официальный шаблон (эталон): Авторитетная графика текст-в-изображение, которую вы можете сравнить с вашими нуждами или адаптировать. image_qwen_image_2_1_t2i.json
Как использовать Comfyui Qwen Image 2.1 Текст-в-Изображение ComfyUI Workflow#
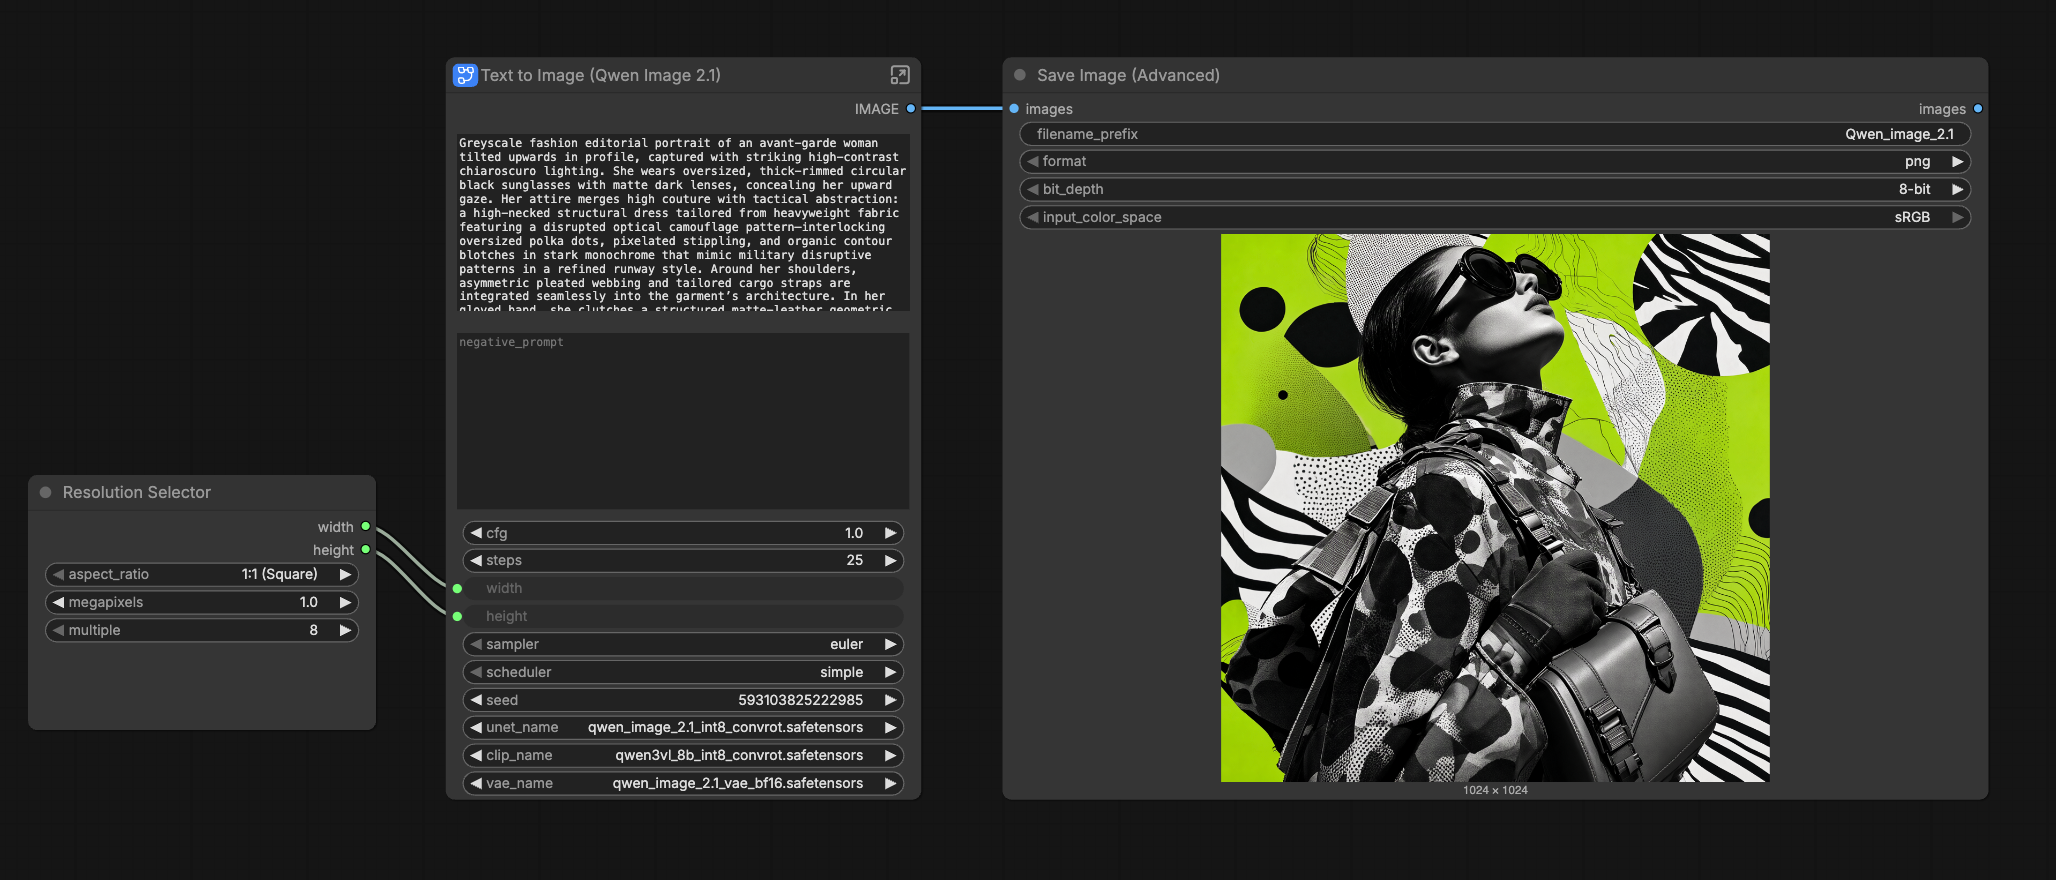
Общий поток: подсказки и семя определяют модель, сэмплер создаёт изображение в скрытом пространстве, VAE декодирует в пиксели, и вывод сохраняется как RGBA PNG. Группы работают слева направо, чтобы вы могли быстро просматривать и итеративно работать.
Подсказка и стиль
- Используйте положительную подсказку для намерения и направленности искусства, а отрицательную подсказку, чтобы избежать артефактов. Для модных портретов укажите освещение, угол камеры, объектив и материалы; для кинематографических кадров направьте настроение и цветокоррекцию; для продуктовых снимков укажите поверхности, студийное освещение и отражения. Сохраните стабильное семя, когда вам нужна строгая воспроизводимость при изменении подсказок.
Разрешение и семя
- Установите целевой размер в узле разрешения перед сэмплированием. Рабочий процесс проверен на 2048×2048 с весами INT8 и размером пакета 1 для надёжности на современных GPU. Если вам нужны более быстрые предварительные просмотры, уменьшите до 1024 или 1536, а затем вернитесь к 2048 для окончательных рендеров. Семя доступно пользователю, чтобы вы могли зафиксировать вариации или рандомизировать исследования.
Загрузка модели
- Группа моделей загружает веса Qwen-Image-2.1 INT8 и сопровождающий VAE. Никакой ручной проводки не требуется, кроме выбора правильных контрольных точек. Подсказки кодируются и передаются генератору, чтобы сэмплер имел как текстовое кондиционирование, так и скрытое полотно, которое ему нужно.
Сэмплирование
- Этап
KSamplerобрабатывает траекторию диффузии. Шаги и CFG открыты, чтобы вы могли балансировать скорость и соответствие подсказке. Варианты сэмплера и планировщика включены для контроля стиля и стабильности; начните с настроек по умолчанию, затем корректируйте только при необходимости изменить вид или усилить следование подсказке.
Декодирование и сохранение
- VAE декодирует финальный латент в изображение, и группа сохранения записывает RGBA PNG. Если ваша композиция предполагает прозрачность (логотипы, UI-оверлеи, вырезы продуктов), экспортер сохраняет альфа-канал, чтобы активы попадали прямо в дизайнерские инструменты без дополнительного маскирования.
Ключевые узлы в Comfyui Qwen Image 2.1 Текст-в-Изображение ComfyUI Workflow#
UNETLoaderЗагружает Qwen-Image-2.1 INT8 диффузионную основу, которая фактически выполняет генерацию. Держите это направленным на веса 2.1 для согласованности между сессиями; переключайтесь только при тестировании вариантов.CLIPLoaderили загрузчик текстового энкодера, специфичный для модели Инициализирует энкодер подсказок, чтобы ваш текст был правильно встроен для генератора. Если вы меняете энкодеры, слегка подстройте CFG и проверьте формулировку подсказки, чтобы сохранить тот же визуальный замысел.EmptySD3LatentImageОпределяет размер и пакет скрытого полотна. Установите ширину и высоту здесь на 2048 × 2048 для финалов, затем уменьшите для более быстрых черновиков. Держите размер пакета 1 на родном разрешении, чтобы избежать давления на VRAM.KSamplerВедёт процесс диффузии. Используйте шаги для обмена скоростью на детали и корректируйтеcfg, чтобы усилить или расслабить соответствие подсказке. Если вы переключаете сэмплеры или планировщики, делайте небольшие, постепенные изменения и сравнивайте результаты на фиксированном семени.SaveImageЭкспортирует декодированное изображение как RGBA PNG с выбранным вами шаблоном именования. Это сохраняет прозрачность для компоновки и обеспечивает точную воспроизводимость в сочетании с фиксированным семенем и подсказкой.
Дополнительные опции#
- Рабочие шаблоны подсказок: "35mm модный портрет, мягкий ободковый свет, редакционный стиль, деталь текстуры ткани, нейтральный фон" или "киноширокий кадр, объемный свет через жалюзи, цветокоррекция бирюзово-оранжевый, высокий контраст" или "студийный рендер продукта, глянцевая керамическая кружка, трёхточечное освещение, мягкая тень на бесшовной бумаге."
- Воспроизводимость: Журнал подсказки, отрицательной подсказки, семени и разрешения с каждым экспортом. Небольшие правки против фиксированного семени — самый быстрый способ настроить вид без потери композиции.
- Производительность: Веса INT8 снижают использование VRAM и делают 2048×2048 практичным. Для оборудования с меньшей памятью предварительно просматривайте на 1024 и увеличивайте или повторно рендерите в полном размере, когда будете удовлетворены.
- Референсная сборка: Если вы хотите сравнить структуру узлов или восстановить настройки по умолчанию, начните с официального шаблона и перенесите ваши узлы подсказок и сохранения. image_qwen_image_2_1_t2i.json
- Пакет моделей: Используйте поддерживаемое распределение Comfy-Org для согласованного поведения в разных средах. Comfy-Org/Qwen-Image-2.1
Признание#
Этот рабочий процесс реализует и опирается на следующие работы и ресурсы. Мы выражаем благодарность Comfy.org за статью о выпуске ComfyUI, Comfy-Org за открытые веса Qwen-Image-2.1 и Comfy-Org за официальный шаблон рабочего процесса текст-в-изображение за их вклад и поддержку. Для авторитетных деталей, пожалуйста, обратитесь к оригинальной документации и репозиториям, указанным ниже.
Ресурсы#
- Comfy.org/ComfyUI статья о выпуске
- Документация / Примечания к выпуску: Comfy.org блог пост
- Comfy-Org/Официальные веса Comfy-Org Qwen-Image-2.1
- Hugging Face: Comfy-Org/Qwen-Image-2.1
- Comfy-Org/Официальный шаблон текст-в-изображение
- GitHub: Comfy-Org/workflow_templates
Примечание: Использование указанных моделей, наборов данных и кода подчиняется соответствующим лицензиям и условиям, предоставленным их авторами и поддерживающими.