pixverse-c1/transition
Anime uma transição controlada entre os quadros inicial e final escolhidos.
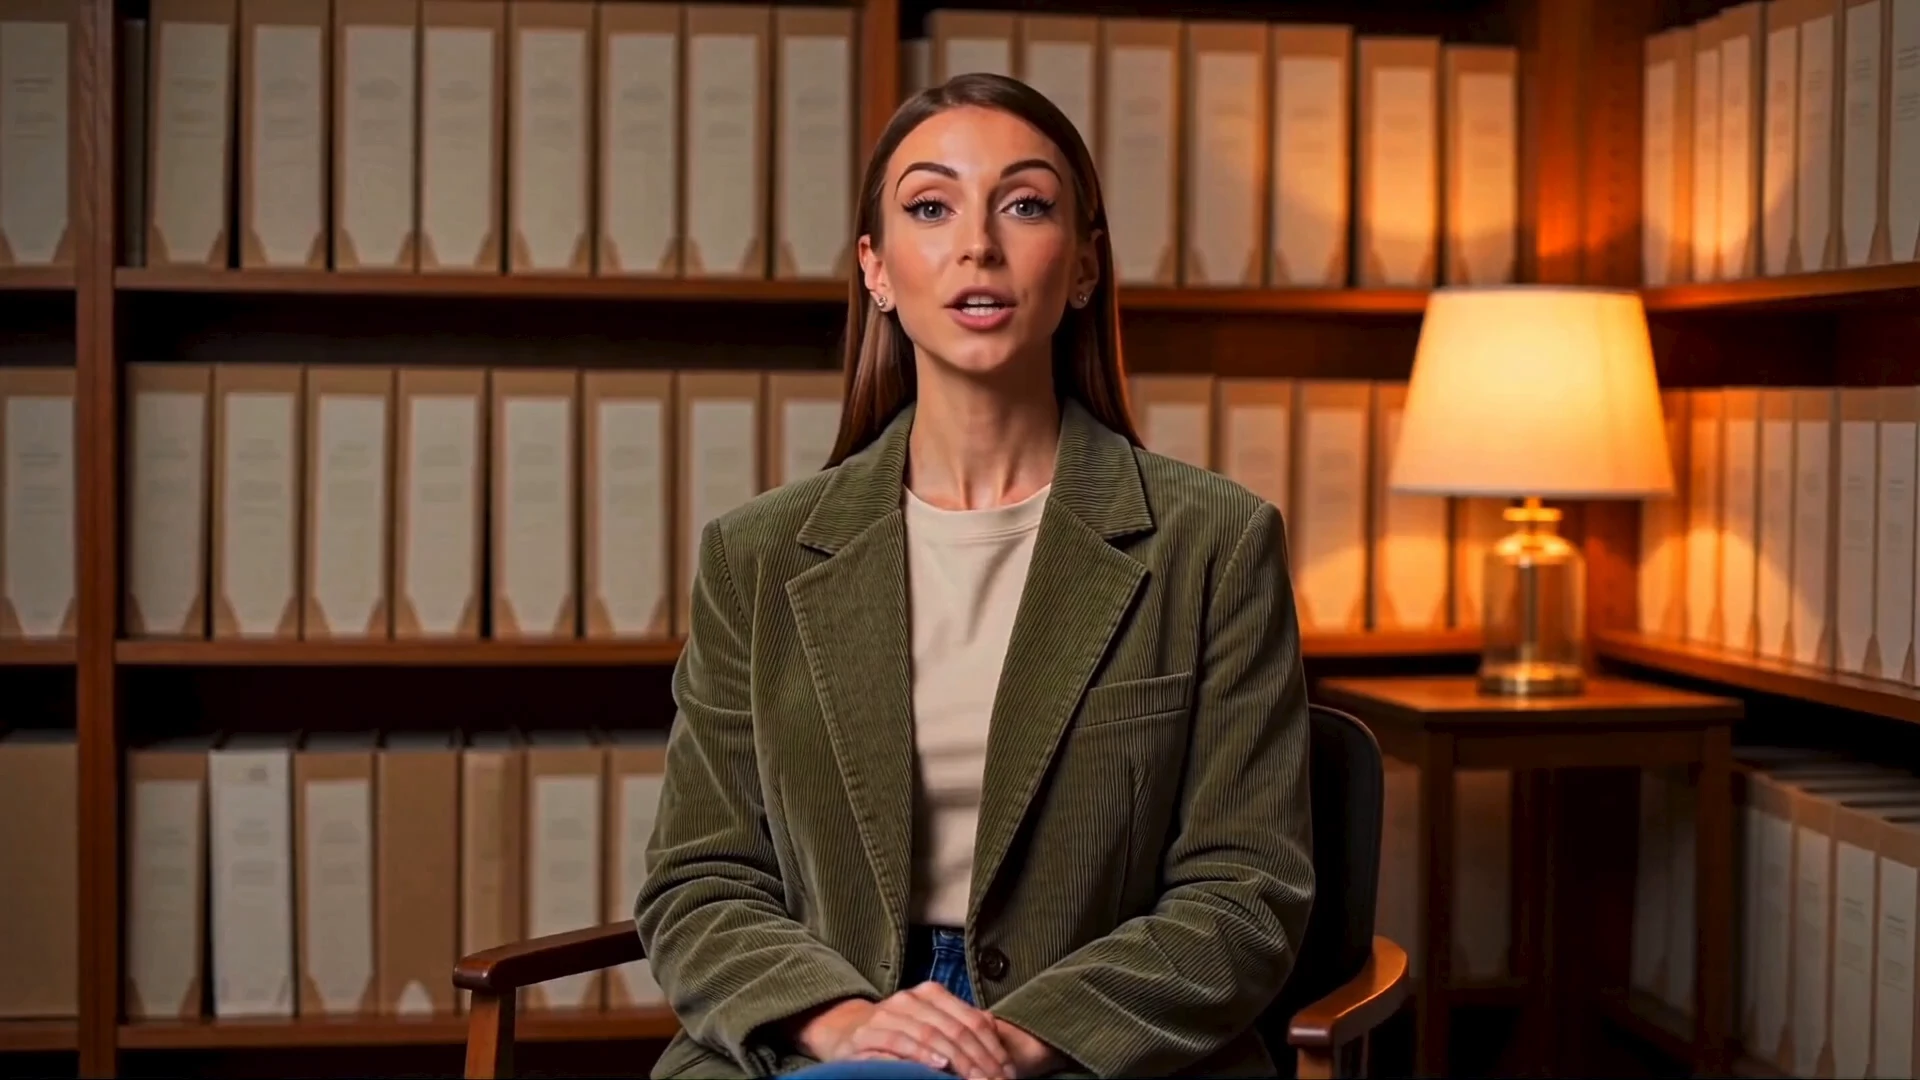
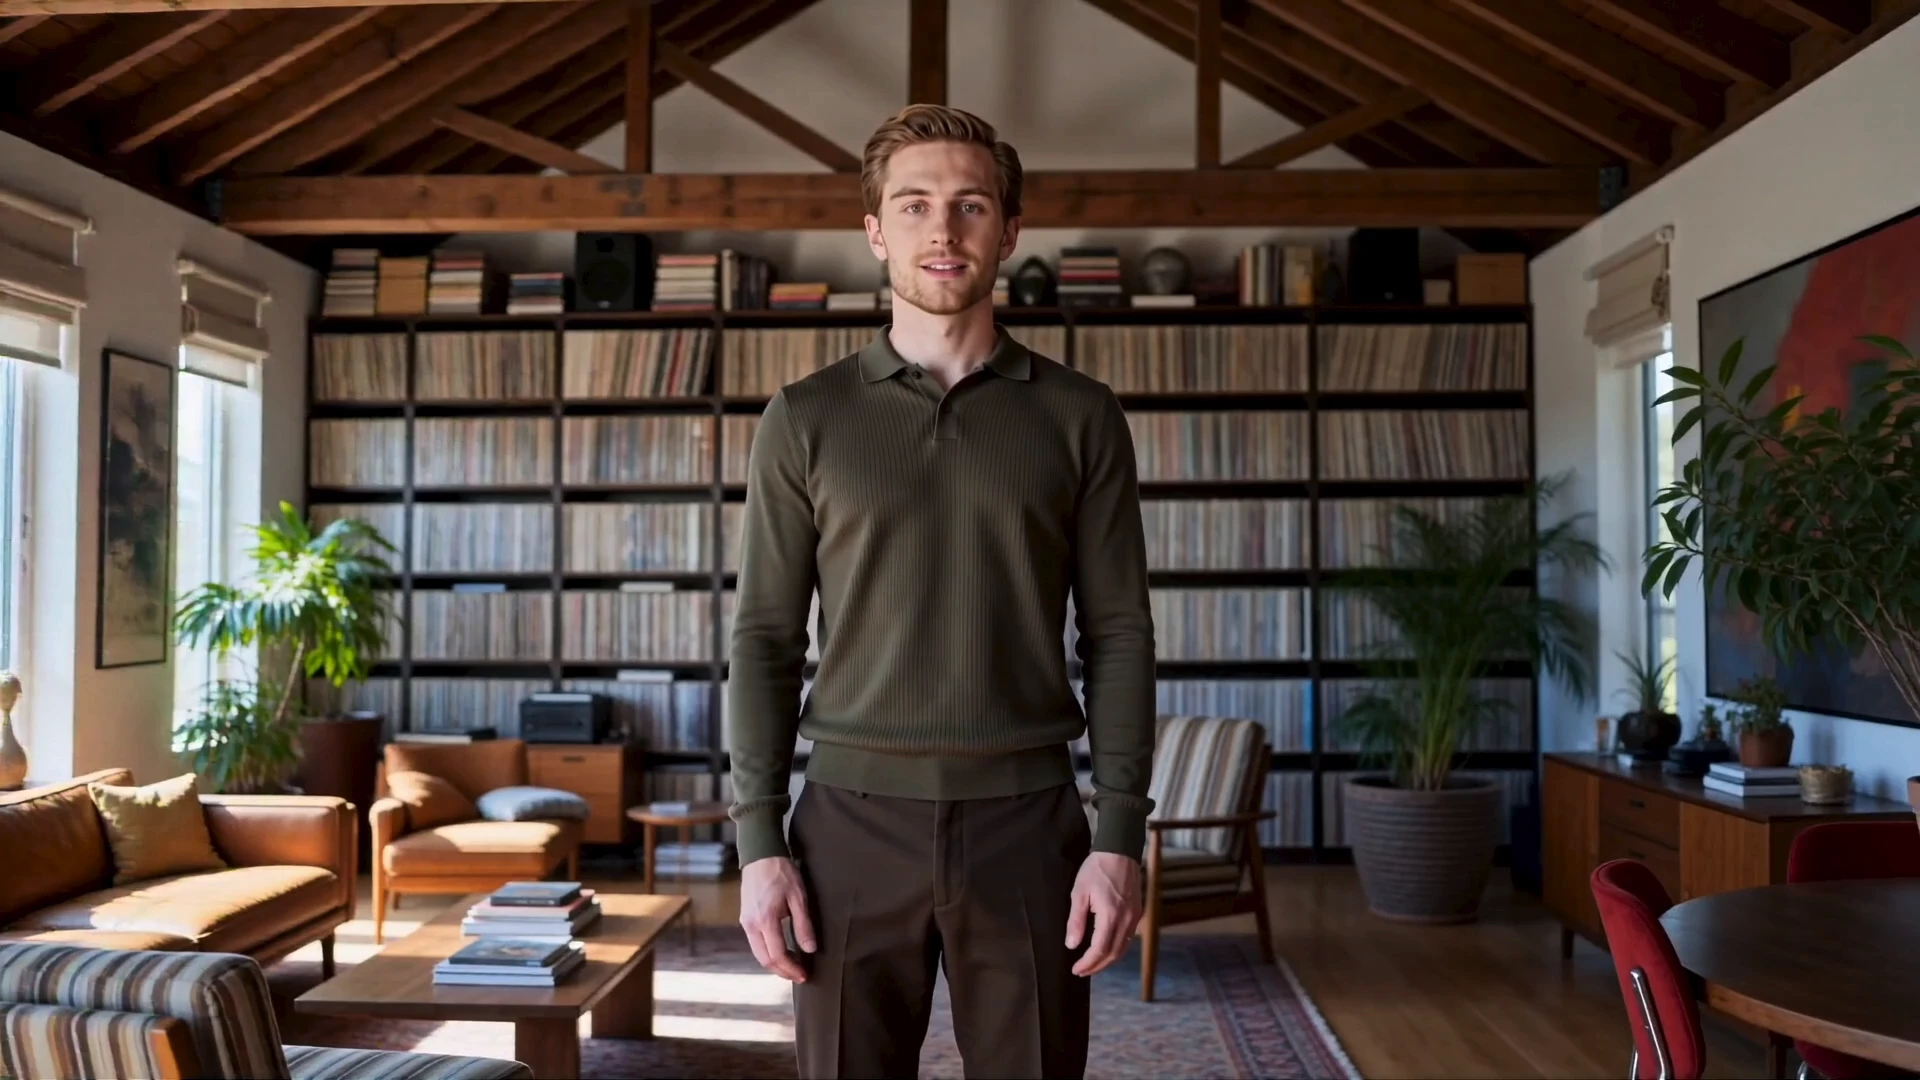
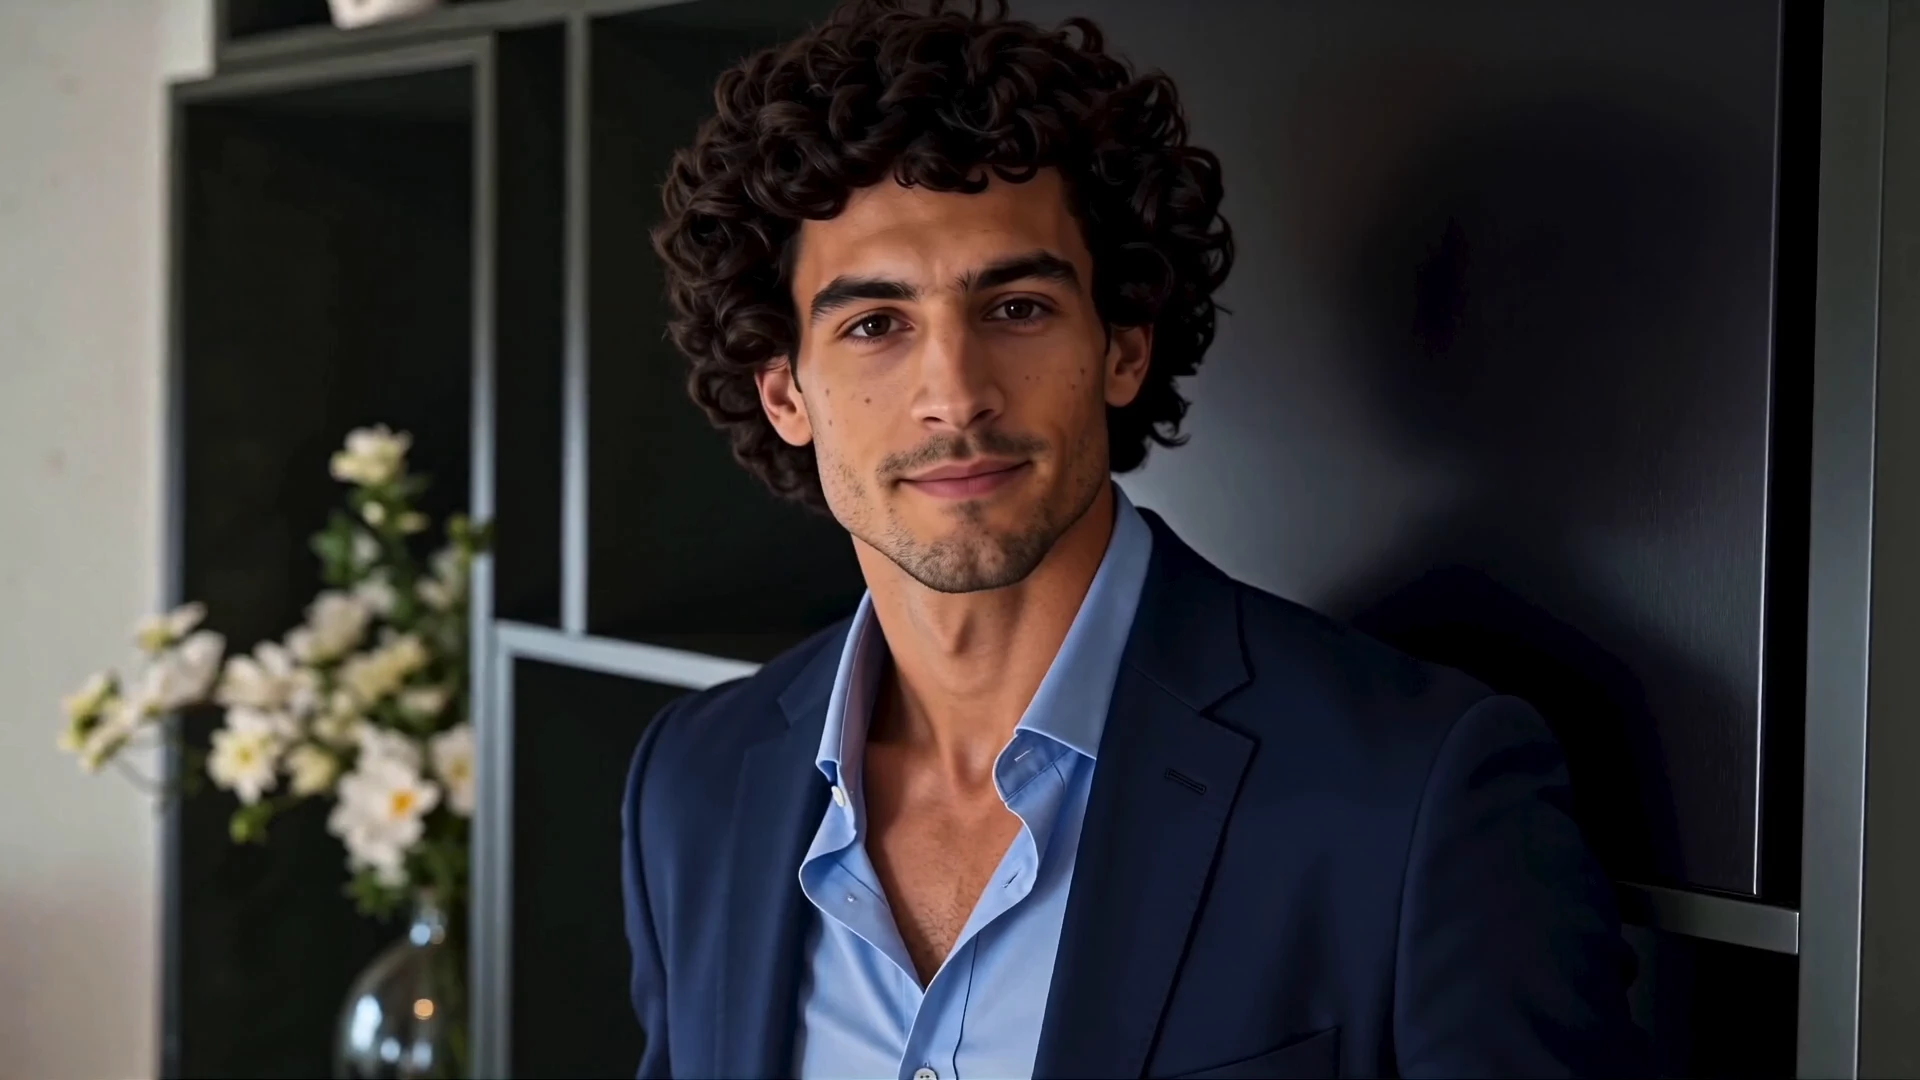
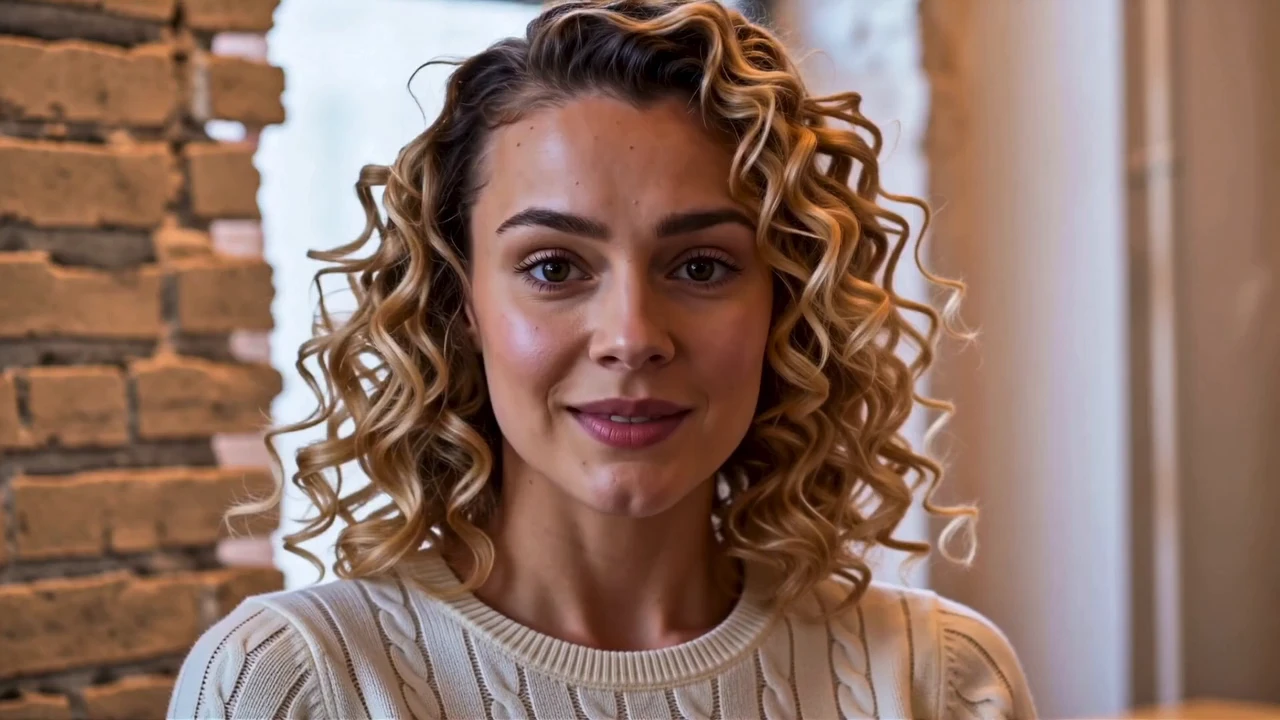
Um retrato mostra um rosto. A linha que você digita deve se tornar uma performance. Avatar V repete esse roteiro e adiciona um pequeno aceno de cabeça ou uma mão mais calma quando você pergunta.
| Vantagem | O que você ganha |
|---|---|
| Discurso guiado por roteiro | A boca segue as palavras que você envia. |
| Uma aparência reutilizável | Uma pessoa pública pode carregar uma série de clipes Avatar V. |
| Movimento opcional | Uma breve nota pode solicitar um aceno de cabeça. Ignore-o e a linha Avatar V ainda estará na frente. |
| Uma tarifa | 720p e 1080p compartilham o mesmo preço por segundo. |
Você escolhe uma voz nesta página. Você não carrega uma gravação. As direções da câmera não reconstruirão a sala Avatar V, pois o visual já está definido.
Em RunComfy, experimente uma linha na UI do modelo e repita a mesma aparência, voz e script por meio da API HTTP.
avatar_id, voice_id, script, resolution e opcional motion_prompt.Estes são os únicos controles nesta página.
| Parâmetro | Obrigatório | Tipo | Padrão | Gama / Opções | Descrição |
|---|---|---|---|---|---|
avatar_id* | Sim (*) | Corda | Eliseu | Oito olhares públicos | Pessoa na câmera. |
voz_id* | Sim (*) | Corda | Aparência de correspondência | Look correspondente, ou oito vozes | Voz para o roteiro. |
roteiro* | Sim (*) | Corda | Linha de mercado portuário | Até 5.000 caracteres | Palavras para falar. O comprimento define o clipe. |
resolução | Não | Corda | 1080p | 720p, 1080p | Tamanho do quadro. Mesma taxa por segundo. |
motion_prompt | Não | Corda | Vazio | Texto curto | Aceno opcional ou nota manual. |
Não há controle deslizante de duração. A linha falada define o comprimento.
Avatar V cobra US$ 0,11 por segundo do clipe finalizado. Ambos os tamanhos de quadro usam essa taxa.
| Comprimento do clipe | Preço |
|---|---|
| 5s | US$ 0,55 |
| 10s | US$ 1,10 |
| 20 anos | US$ 2,20 |
| 30 anos | US$ 3,30 |
Um roteiro mais longo custa mais apenas porque o vídeo é mais longo. O visual e a voz não agregam taxa.
script. Não descreva a sala lá.Anime uma transição controlada entre os quadros inicial e final escolhidos.

Anime imagens estáticas em clipes cinematográficos 4K nativos, com quadros inicial e final como referência e som sincronizado.
Redefina o estilo do primeiro quadro e garanta consistência visual em todo o vídeo.

Reestilize um vídeo existente com instruções de texto, preservando o movimento original e a composição geral.

Estenda um vídeo existente em 7 segundos a 720p, com orientação por prompt e geração opcional de áudio.

Clipes de imagem para vídeo de 3–15 s por $0.083 por segundo.
Avatar V transforma um roteiro escrito e uma visão pública em um clipe falado com sincronização labial. A boca segue as palavras que você envia, e uma nota de movimento opcional pode pedir um aceno de cabeça ou uma mão mais calma. Ele se adapta a hosts de produtos, introduções de aulas e pequenas atualizações do fundador.
Avatar V oferece oito olhares públicos, cada um com uma voz emparelhada, além de oito vozes públicas nomeadas. Escolha Corresponder aparência para manter a voz que pertence à pessoa selecionada ou escolha uma voz nomeada quando desejar uma leitura diferente. Você não carrega uma gravação nesta página.
Avatar V aceita um script de até 5.000 caracteres e a linha falada define o comprimento. Não há controle deslizante de duração. Um roteiro mais longo custa mais apenas porque o vídeo finalizado é mais longo.
Não. Avatar V cobra US$ 0,11 por segundo do clipe finalizado em 720p e 1080p. O visual e a voz não agregam taxa à parte. Leia a linha uma vez se quiser um comprimento aproximado antes de gerar.
Use a nota de movimento Avatar V para um pequeno gesto, como um aceno de cabeça ou uma mão aberta. Humores opostos na mesma nota lutam entre si. Deixe-o vazio quando quiser apenas que as palavras sejam ditas.
Avatar V precisa de uma visão pública, uma voz e um roteiro. A resolução é 720p ou 1080p. A nota de movimento é opcional e o roteiro deve ter no máximo 5.000 caracteres. Esses looks não são uma ferramenta de título, então adicione legendas depois.
Sim. Protótipo Avatar V no Playground Web UI e, em seguida, envie a mesma aparência, voz, script, resolução e nota de movimento opcional por meio da API RunComfy. A API usa o mesmo modelo. Não promete um retorno fixo ou simultaneidade ilimitada.
Avatar V custa US$ 0,11 por segundo do vídeo finalizado. Um clipe de 10 segundos custa US$ 1,10 e um clipe de 30 segundos custa US$ 3,30. As gerações consomem créditos em dólares americanos e as novas contas normalmente começam com um balancete.
RunComfy é a principal ComfyUI plataforma, oferecendo ComfyUI online ambiente e serviços, juntamente com fluxos de trabalho do ComfyUI apresentando visuais impressionantes. RunComfy também oferece AI Models, permitindo que artistas utilizem as mais recentes ferramentas de AI para criar arte incrível.