flux-1-kontext/max/edit
FLUX Kontext Maxでプロンプトに沿って画像を編集し、シードを設定して9種類のアスペクト比から選択します。
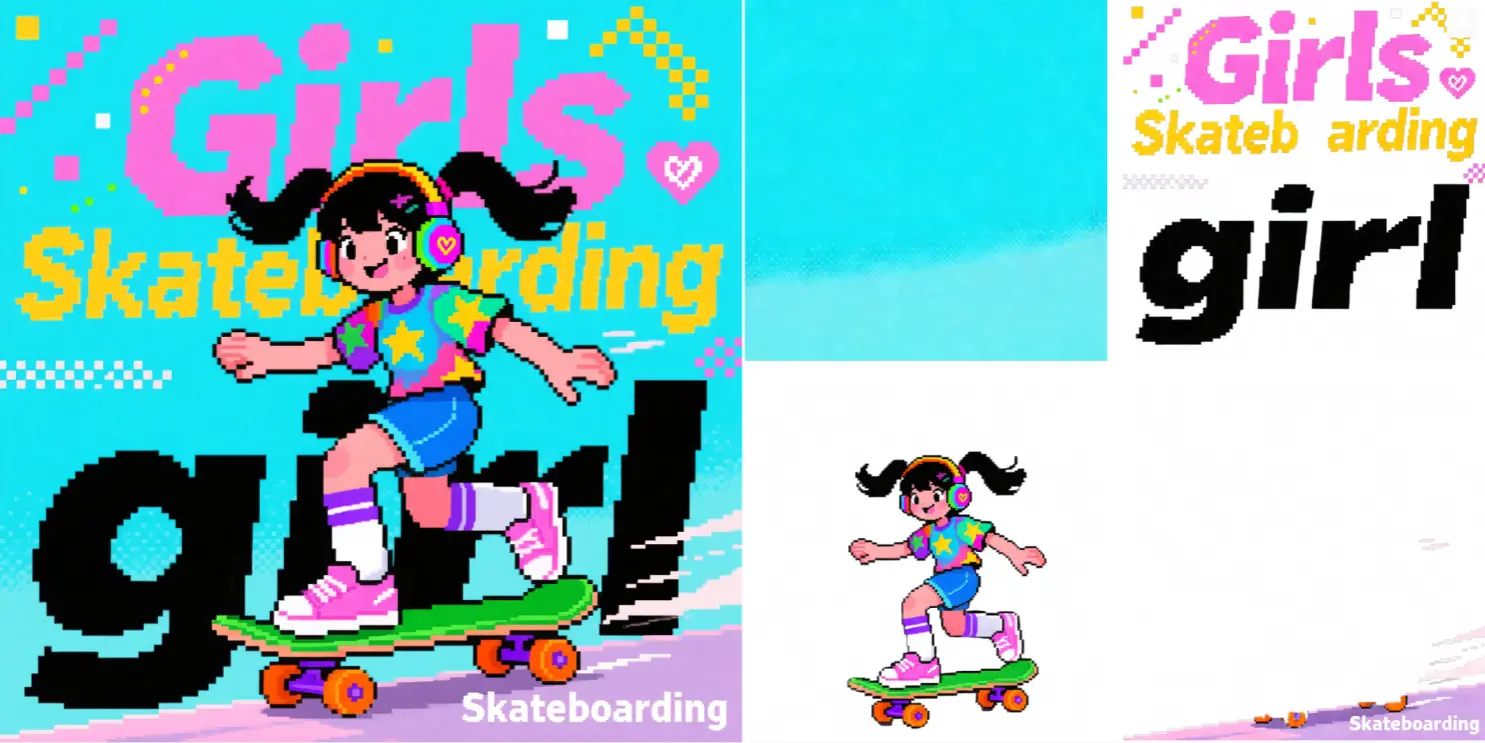
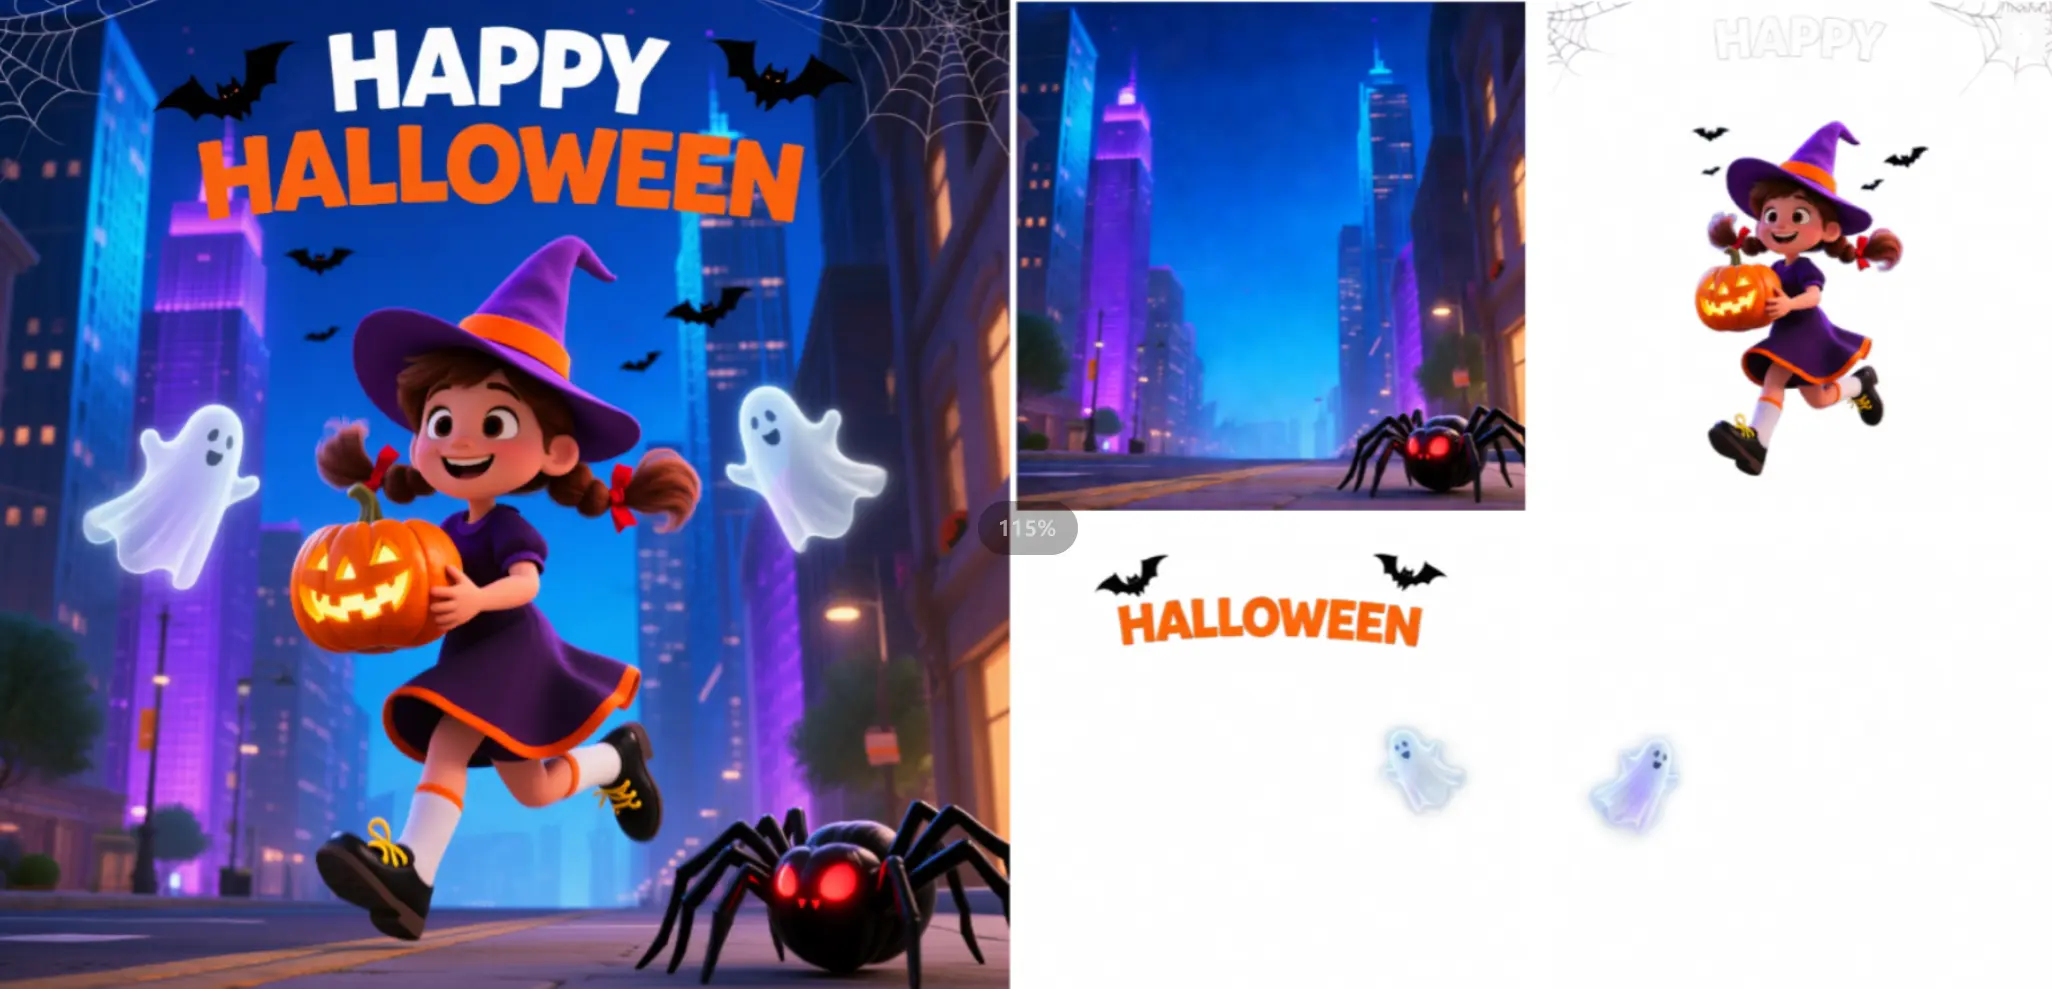
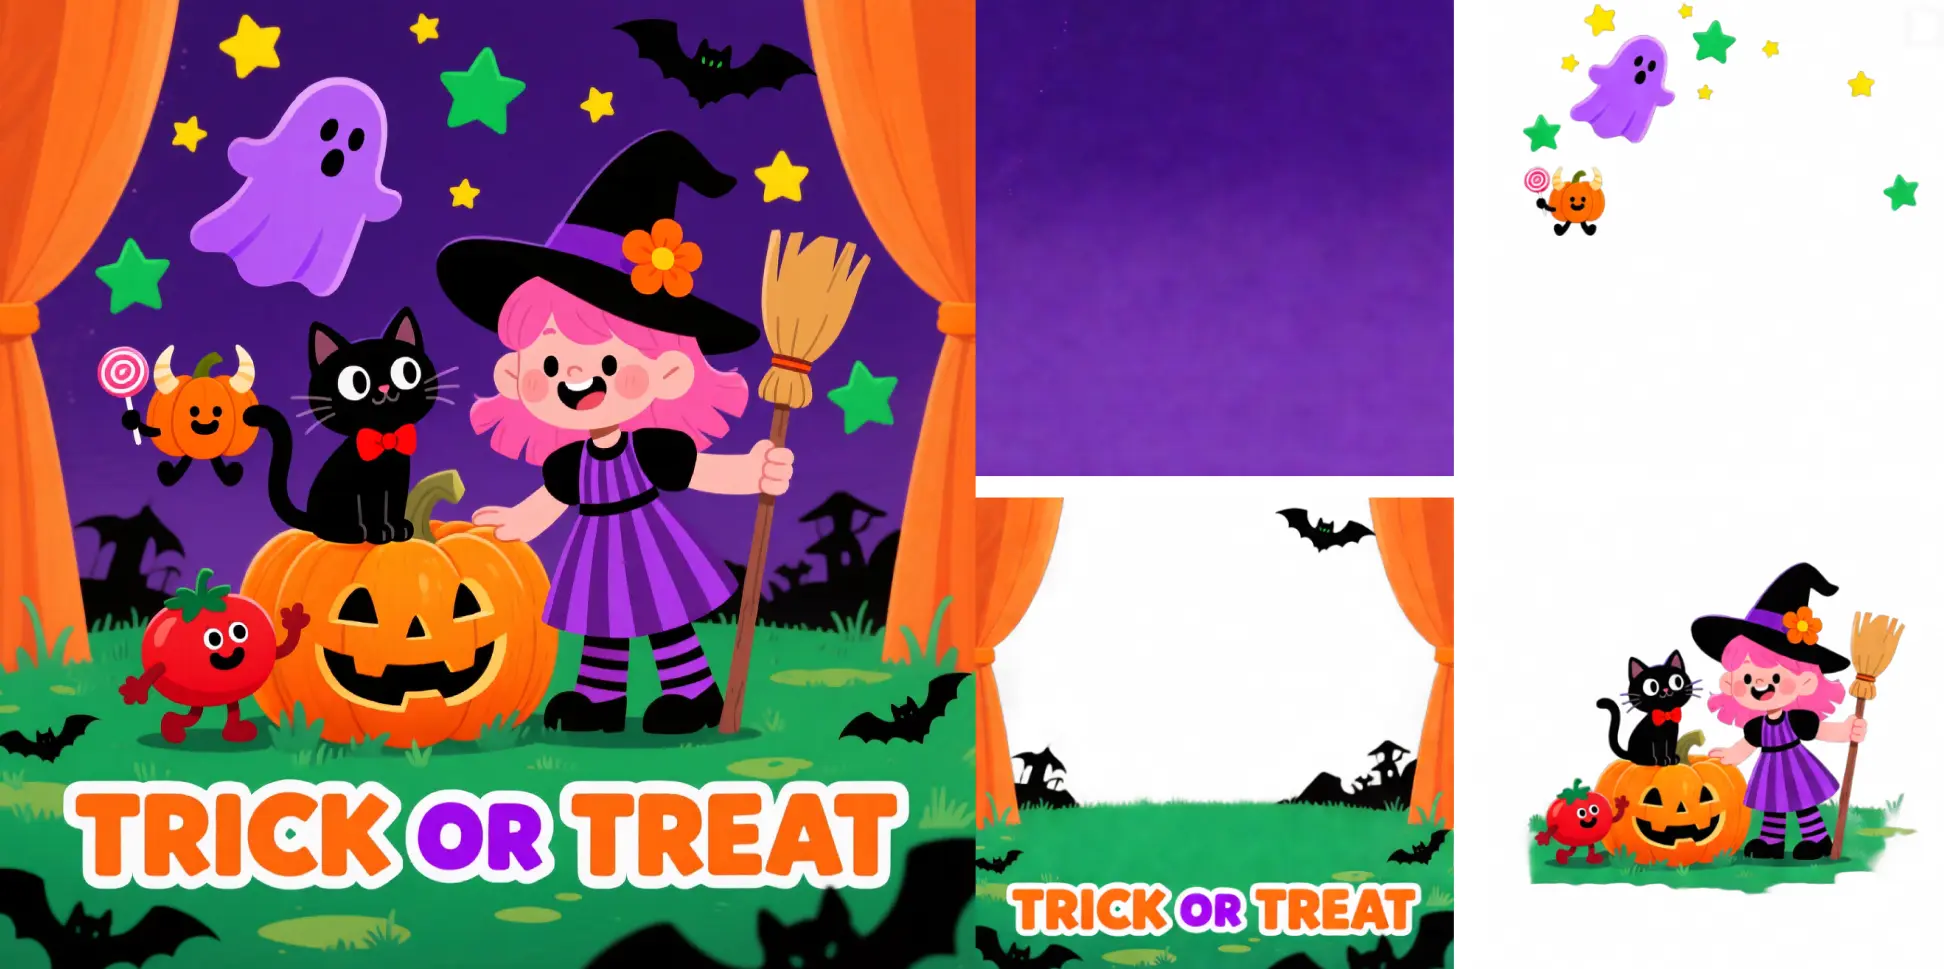
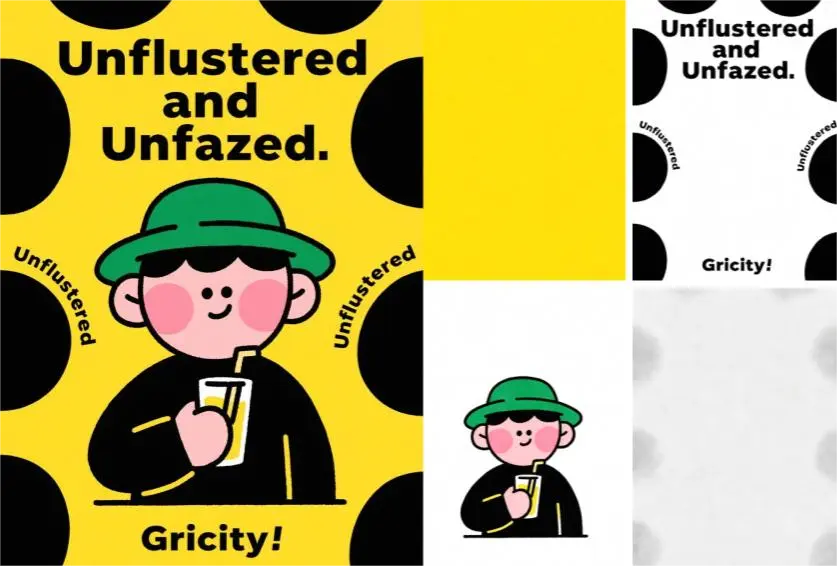
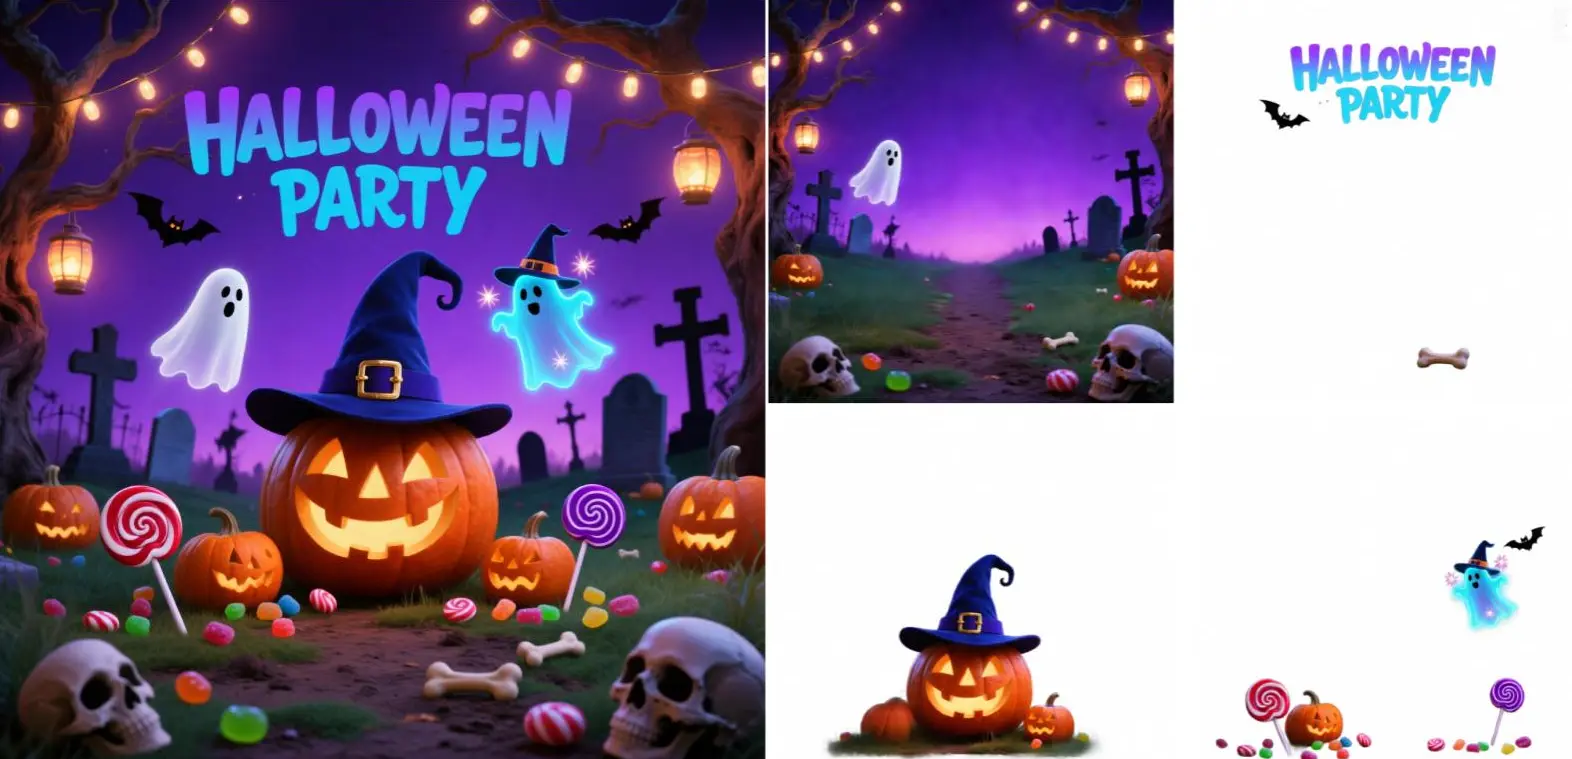
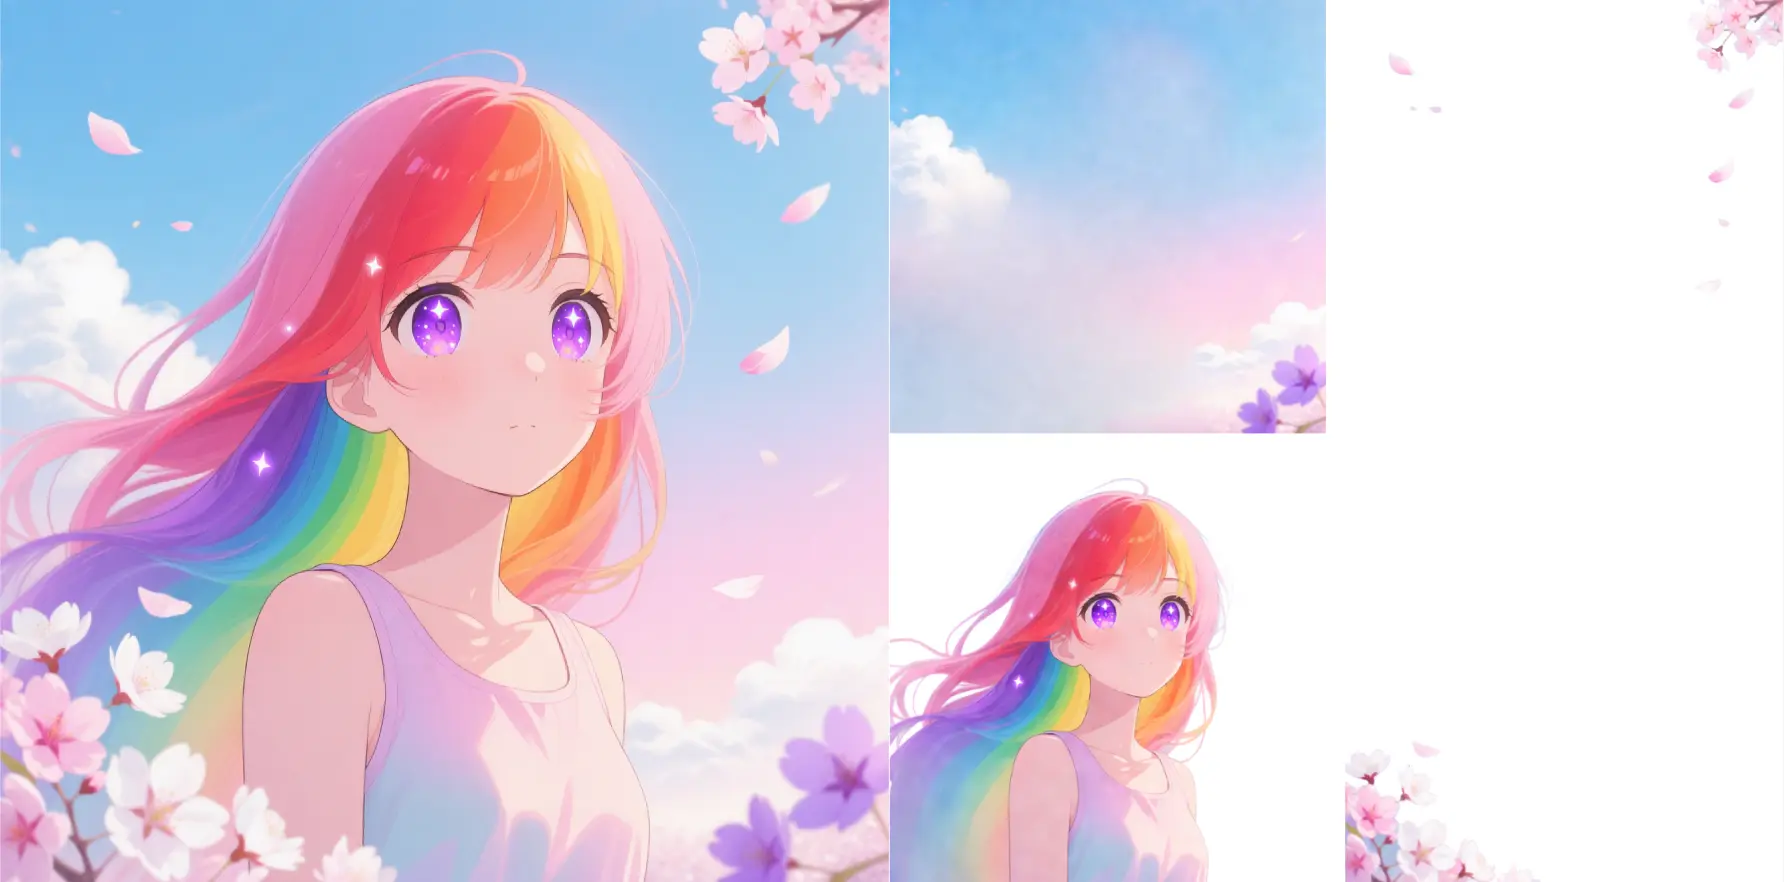
Qwen Image Layered は、1 つの入力 RGB 画像を、1 画像あたり $0.055で編集可能な RGBA レイヤーに変換します。透明性を維持しながら意味的に異なる要素を分離するため、オブジェクトの分離と非破壊編集が大幅に高速化されます。 num_layers を使用して 1 ~ 10 のレイヤーをリクエストし、必要に応じて prompt と negative_prompt で分解をガイドします。 RunComfy では、モデルはブラウザ内で、セルフホスティングなしで HTTP API を通じて利用できます。
用途: 正確なオブジェクトの分離 |ラピッド レイアウト プロトタイピング |ブランド資産の統合
| Parameter | Type | Default/Range | 説明 |
|---|---|---|---|
| image_url | string | Required | 入力画像のURL。 |
| prompt | string | Optional | レイヤー構造と画像コンテンツに関するガイダンス。 |
| negative_prompt | string | Optional | 除外する要素。 |
| num_layers | integer | Default: 4; Range: 1-10 | 生成するRGBAレイヤーの数。 |
| num_inference_steps | integer | Default: 28; Range: 1-50 | 推論ステップの数。 |
| guidance_scale | float | Default: 5; Range: 1-20 | 結果が prompt にどれだけ近いか。 |
| seed | integer | Default: 0 | 再現可能な結果を得るための固定 seed。 |
| output_format | string | Options: png, webp; Default: png | 出力画像フォーマット。透明性を維持する必要がある場合は、png をお勧めします。 |
RunComfy API はブラウザ インターフェースと同じフィールドを使用します。 image_urlは必須です。 prompt と negative_prompt はオプションのコントロールです。応答には、エディターまたは自動化されたパイプラインで使用するために生成されたレイヤー アセットが含まれています。
Qwen Image Layered の API エンドポイント
フラット画像の特定領域を編集するには、Qwen-Image-Edit-2509 を試してください。
FLUX Kontext Maxでプロンプトに沿って画像を編集し、シードを設定して9種類のアスペクト比から選択します。

テキストから画像を生成し、ネガティブプロンプト、6種類の構図、サンプリング設定を調整できます。
Ideogram 3.0でテキストから画像を生成し、アスペクト比、速度、配色、スタイルを設定します。

必須のプロンプトに従って元画像を編集します。任意のマスク、2〜50の推論ステップ、480pまたは720pの解像度、シード、3種類の出力形式を設定できます。

Nano Banana 2 Edit によるプロンプト主導の画像編集。複数画像入力に対応し、アスペクト比・解像度・安全性許容度・出力を細かくコントロールできます。
テキスト入力だけで高精細な画像を創り出す次世代AIツール。柔軟な編集も対応。
1 つの入力画像を、意味的に分離された複数の RGBA レイヤーに分解します。各レイヤーは透明度を保持し、個別に移動、色変更、編集、合成を行うことができます。
このモデルは Apache-2.0 に基づいてリリースされており、ライセンス条項に基づいて商用利用が許可されています。入力画像に対する権利を保持し、コンテンツ内のサードパーティの知的財産を尊重する必要があります。
num_layers の範囲は 1 ~ 10、num_inference_steps の範囲は 1 ~ 50、guidance_scale の範囲は 1 ~ 20 です。エンドポイントは、解像度設定や prompt トークン制限を公開しません。
このページでは image_url が1つ必須です。必要に応じて、画像をどのようにレイヤー分解するか指示する prompt と negative_prompt も指定できます。ControlNet、IP-Adapter、複数の参照画像に相当する入力項目はありません。
RunComfy ブラウザ インターフェースで設定をテストし、同じ入力フィールドでモデルの RunComfy API エンドポイントを使用します。 image_urlは必須です。必要に応じて、他の公開されたコントロールを追加できます。
公開されたモデルの説明では、Layer3D RoPE の位置埋め込みを持つ VLD-MMDiT バックボーンが識別され、セマンティック要素を分離しながらレイヤー間でコンテキストを共有するように設計されています。
その RGBA-VAE は、共有潜在空間内の RGB および RGBA データを表します。これにより、各セマンティック コンポーネントに対して一貫したアルファ情報が生成され、下流でレイヤーを編集または合成できるようになります。
テキストを含む領域を編集可能なレイヤーに分離できますが、テキストの正確な忠実度は入力と設定によって異なる場合があります。制作環境でレイヤーを使用する前に、重要なタイポグラフィを検査してください。
一般的な用途には、オブジェクトの分離、ブランド資産の適応、UI コンポーネントの抽出、背景の置換、レイアウトのプロトタイピング、アニメーションの準備、VFX 合成などが含まれます。
Qwen Image Edit は、フラット イメージの選択された領域を変更します。 Qwen Image Layered は代わりに、画像を複数の RGBA レイヤーに分解します。これは、レイヤーレベルの編集と合成を繰り返すのに適しています。
RunComfyは最高の ComfyUI プラットフォームです。次のものを提供しています: ComfyUIオンライン 環境とサービス、および ComfyUIワークフロー 魅力的なビジュアルが特徴です。 RunComfyはまた提供します AI Models, アーティストが最新のAIツールを活用して素晴らしいアートを作成できるようにする。