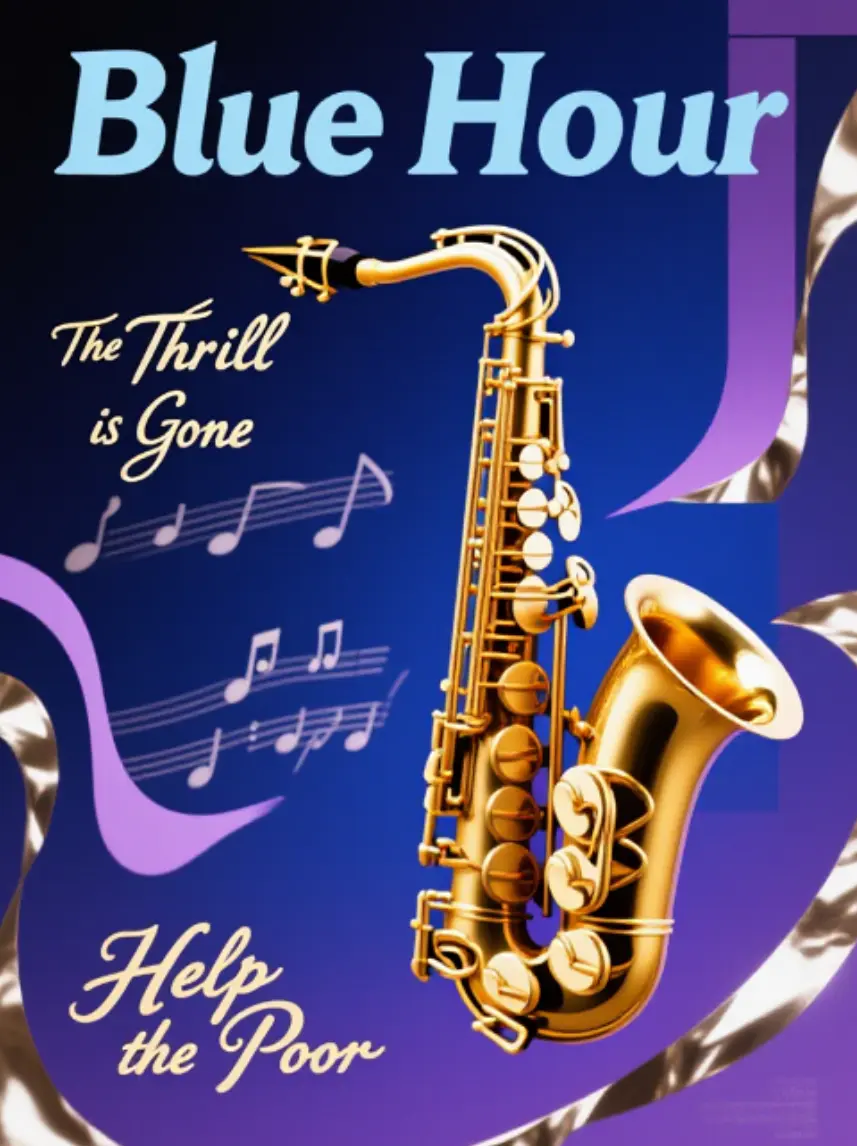
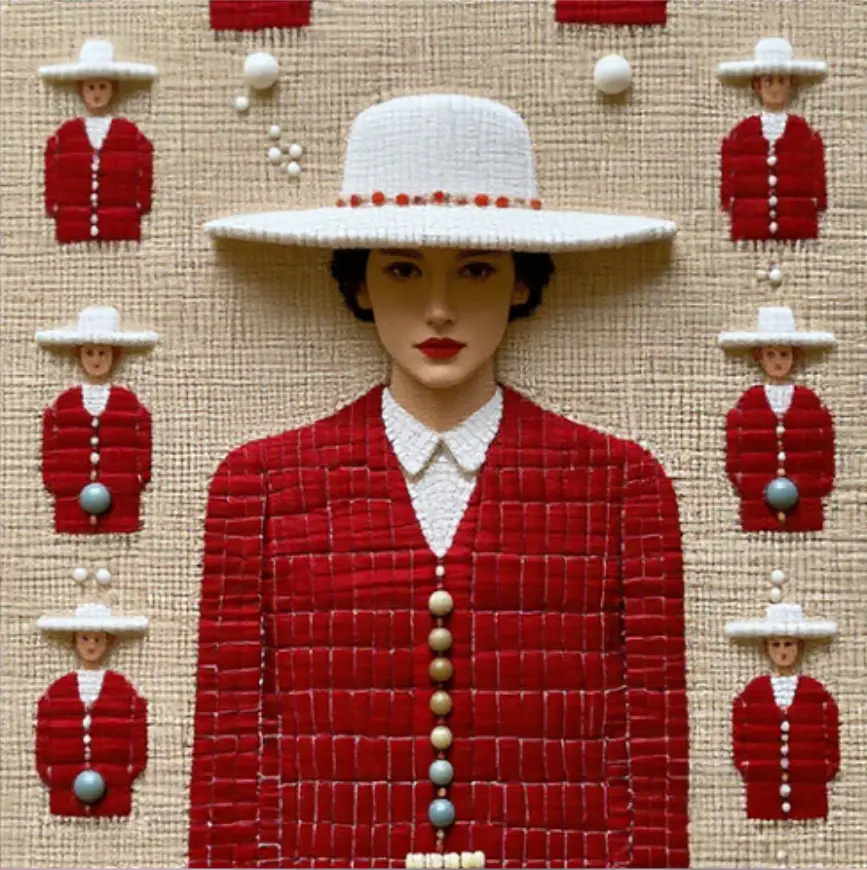
qwen-image-2.1/edit
Qwen Image 2.1: 統一された生成、編集、透明性
Ovis ImageはAIDC-AIのテキスト画像生成モデルです。必須のプロンプトに加え、任意のネガティブプロンプト、6種類の画像サイズ、推論ステップとガイダンス、シード、出力形式を設定できます。
promptは必須、negative_promptは任意です。image_sizeはsquare_hd、square、portrait_4_3、portrait_16_9、landscape_4_3、landscape_16_9から選択します。初期値はlandscape_4_3です。num_inference_stepsは1〜50、初期値は28です。guidance_scaleは1〜20、初期値は5です。seedは任意の整数で、初期値はnullです。output_formatはjpeg、png、webpに対応し、初期値はpngです。まず初期値のまま、内容を整理したプロンプトで生成します。negative_promptには表示したくない要素だけを記述します。設定を比較するときは同じシードを使い、ステップ数やガイダンスは1項目ずつ変更してください。被写体の細部、構図、不要な要素を確認します。
Qwen Image 2.1: 統一された生成、編集、透明性

鮮明なディテールと正確な画像内テキストを備えた高速なテキストから画像への生成。
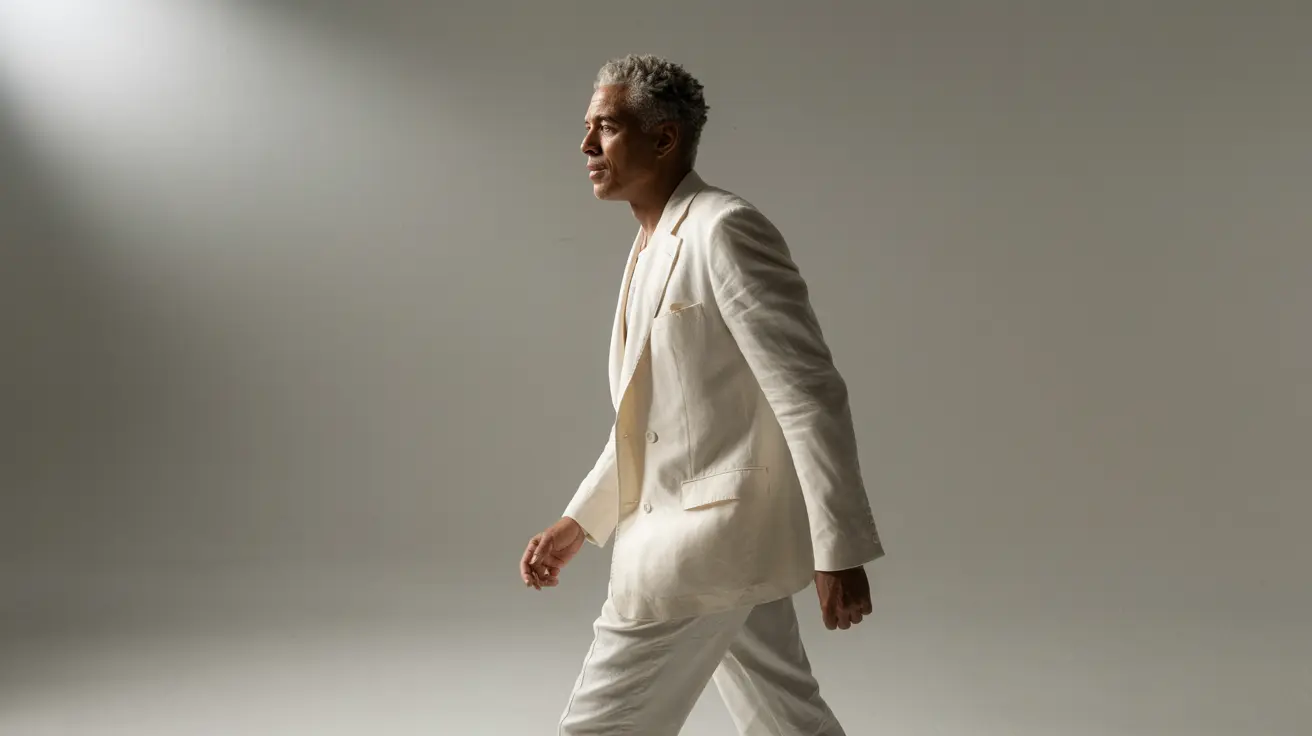
Ideogram 3でプロンプトに沿って画像をリミックスし、画像の重み、アスペクト比などを設定します。

必須のプロンプトに従って1枚の元画像のカメラアングルを変えるか、その他の編集を行います。6種類の出力サイズ、推論ステップ、ガイダンススケール、1〜4枚の結果、JPEGまたはPNG出力を設定できます。
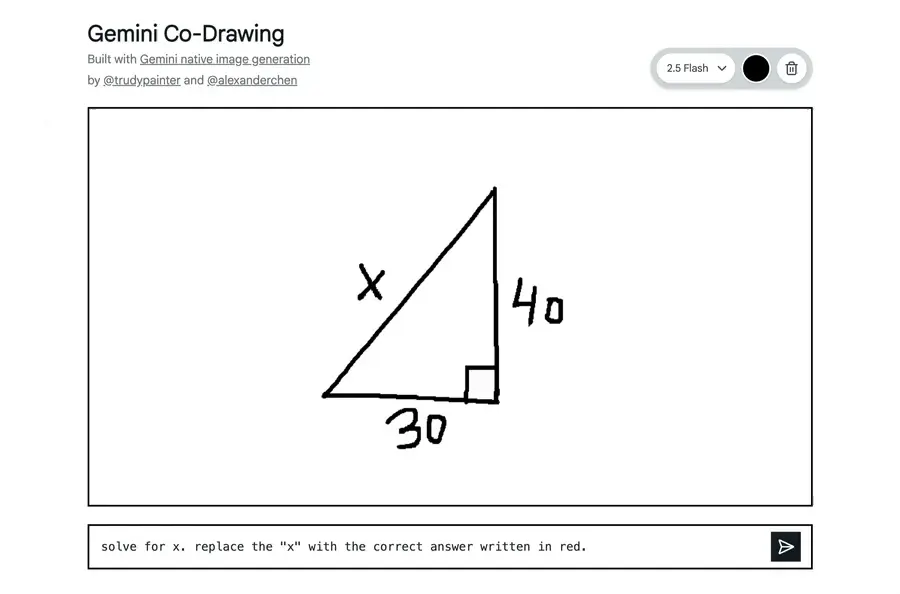
1〜10枚の画像をプロンプトに沿って編集・合成し、アスペクト比、形式、出力数を設定します。

LoRA を使って構造と人物の一貫性を保ちながら、画像を精密に編集できるモデルです。
テキストプロンプトから画像を生成し、ネガティブプロンプト、画像サイズ、サンプリング、シード、ファイル形式も調整できます。
必須なのはpromptだけです。negative_prompt、image_size、ステップ数、ガイダンス、シード、出力形式は任意または初期値があります。
square_hd、square、portrait_4_3、portrait_16_9、landscape_4_3、landscape_16_9の6種類です。初期値はlandscape_4_3です。
num_inference_stepsは1〜50で初期値は28、guidance_scaleは1〜20で初期値は5です。
seedは任意の整数で初期値はnullです。出力形式はjpeg、png、webpから選べ、初期値はpngです。
ページに記載された提供元のリンクを確認してください。このモデルページ自体が追加の利用権を付与するものではありません。
RunComfyは最高の ComfyUI プラットフォームです。次のものを提供しています: ComfyUIオンライン 環境とサービス、および ComfyUIワークフロー 魅力的なビジュアルが特徴です。 RunComfyはまた提供します AI Models, アーティストが最新のAIツールを活用して素晴らしいアートを作成できるようにする。