logo
RunComfy
  • ComfyUI
  • トレーナー
  • モデル
  • MCP新着
  • 価格
  • Seedance 2.5話題
  • Seedream 5.5新着

モデル別ワークフロー

話題MiniMax H3テキスト・画像・参照から音声付き動画話題Qwen Image 2.1画像生成と参照での写真編集Wanテキストや画像から動画、モーション転送FLUX画像生成・編集・キャラクターのバリエーションLTXテキストや画像から音声同期動画Qwen Image Editテキストと参照画像で写真編集Krea 2画像生成・スタイル転送・参照編集Z-Imageテキストから素早く人物や構想を生成

人気・新着ワークフロー

新着MiniMax H3 Character Swap V1.5動画の人物を差し替え、元の音声は保持新着P-H3-Image Reference Edit参照画像に沿って写真を編集話題MiniMax H3 Image-to-Video1 枚の画像から音声同期のシネマティック動画話題LTX 2.5 Image-to-Video1 フレームから音声同期の鮮明な動画話題MiniMax H3 Character Swap (SAM3)動きに合わせて動画の人物を差し替えQwen Image 2.1 Multi-Image Editing最大 10 枚の参照画像から精密なシーンFLUX Klein Face Swap自然でリアルな顔の入れ替えSeedVR2 Video Upscaler鮮明で滑らかな動画アップスケール
その他のワークフローを見る

モデルをトレーニング

新着MOSS-Image Base画像生成、新たに対応新着FLUX.3 Klein画像生成、新たに対応話題Krea 2最も多くトレーニングされた画像モデル話題Krea 2 Turbo少ステップで画像生成話題Qwen Image 2.1画像生成と編集Z-Image Turbo人物やコンセプト画像を素早く生成MiniMax H3音声同期の動画

トレーニングとデプロイ

はじめにOstris AI Toolkit で最初のトレーニングデータセットトレーニング用データセットのアップロードと管理推論学習済みモデルを Playground や API で実行デプロイメント学習済みモデルを専用エンドポイントで提供
その他のモデルをトレーニング

画像モデル

新着GPT Image 2.65% OFF · 精細なテキストから画像生成、GIF・SVG 対応、最大 4K新着Seedream 5.510% OFF · 最大2Kのテキストから画像生成、透過PNG対応新着MiniMax H3 Image10% OFF · テキストまたは参照画像から、最大4Kの静止画新着FLUX 3 Image Klein10% OFF · テキストまたは参照画像から、768〜4Kの静止画話題Seedream 5.0 Pro41% OFF · 参照画像での編集、多言語テキスト対応話題Seedream 4.520% OFF · ブランドの一貫性を保つフォトリアルな編集話題Wan 2.6 Image指示ベースの画像編集Nano Banana Pro77% OFF · スケッチから精密な 2K〜4K ビジュアル

ビデオモデル

新着Seedance 2.5 Flash34% OFF · Text, image, or reference to video新着Kling 4.010% OFF · 静止画を 3〜30 秒の動画に話題Wan 3.0 Prime13% OFF · 参照動画からすばやく生成話題Seedance 2.536% OFF · より長く一貫性の高いシネマティック動画話題Wan 3.0画像・動画・音声の参照から生成話題MiniMax H3最初のフレームを 5〜15 秒の動画にWan 2.510% OFF · 滑らかな動きとネイティブ音声FLUX 3 Maxテキスト・静止画・キーフレームから生成
その他のモデルを見る

API

Serverless (ComfyUI)ComfyUIワークフローをサーバーレスエンドポイントとしてデプロイ。Serverless (LoRA)LoRAをサーバーレスエンドポイントとしてデプロイ。Model APIデプロイ不要でホストされたモデルをオンデマンドで実行。Trainer APIAPI で LoRA のトレーニング、管理、取得を行います。CLIRun RunComfy models from your terminal.
モデル
探索
すべてのモデル
ライブラリ
生成履歴
モデルAPI
APIドキュメント
APIキー
アカウント
使用量

Qwen Image 3.0 Pro: モデルと API での Pro Text-to-Image |ランコンフィ | Models and API | RunComfy

qwen/qwen-image-3.0/pro/text-to-image

Qwen Image 3.0 Pro は、プロンプトを、強力な詳細とプロンプト準拠、1K または 2K 出力、アスペクト比制御、プロンプト拡張、およびシードを備えたプロダクション グレードの画像に変換します。

件名、設定、スタイル、およびレンダリングしたい正確なテキストを説明します。言葉遣いを引用符で囲んでそのまま表現します。
出力詳細層。ドラフトを高速化するには 1k を選択し、最大限の詳細を表示するには 2k を選択します。
生成された画像のアスペクト比。
モデルを生成する前に、短いプロンプトに詳細を追加して強化します。プロンプトがすでに正確である場合はオフにします。
再現性を高めるためのランダムシード。各実行のランダム シードには -1 を使用します。
Idle
The rate is $0.038 per 1k image and $0.072 per 2k image.

Qwen Image 3.0 Pro の概要

Qwen Image 3.0 Pro は、高精細、忠実なプロンプト、および柔軟な出力解像度向けに調整された Qwen のプロダクショングレードのテキストから画像へのモデルです。

Qwen Image 3.0 Pro は、ノイズの多いドラフトと手動クリーンアップを 1 つの洗練されたジェネレーターに置き換えて、アーティスト、マーケティング担当者、開発者がキャラクター アート、ポートレート、コマーシャル ビジュアルを制作するのに役立ちます。

開発者にとって、RunComfy の Qwen Image 3.0 Pro はブラウザーと HTTP API 経由の両方で使用できるため、モデルを自分でホストしたりスケールしたりする必要はありません。

最適な用途: キャラクター & コンセプト アート |ファッション&ポートレート |コマーシャルおよびマーケティングビジュアル

パラメータ#


Qwen Image 3.0 Pro は、書かれたプロンプトから静止画を生成します。これらのコントロールは、Qwen Image 3.0 Pro の各レンダリングを形成します。


パラメータ必須タイプデフォルト範囲/オプション説明
プロンプト*はい (*)文字列プロンプトの例最大 ~4,500 トークン件名、設定、スタイル、および正確なテキストを説明します。文言を引用してそのまま表現します。
解像度いいえ文字列2k1k、2k詳細層: 簡単なドラフトの場合は「1k」、最大限の詳細の場合は「2k」です。
アスペクト比いいえ文字列1:11:1、16:9、9:16、4:3、3:4フレームを配置に合わせます。
enable_prompt_expansionいいえブール値本当true、false生成する前に短いプロンプトを充実させます。プロンプトがすでに正確である場合はオフになります。
シードいいえ整数-1-1 または 0-2147483647シードを修正して結果を再現します。新しいバリエーションには -1 を使用します。

  • 必須フィールドです。

料金#


Qwen Image 3.0 Pro は出力ティア別課金です:1K 画像あたり $0.038、2K 画像あたり $0.072。バッチの合計は「画像単価 × 枚数」です。


関連モデル

wan-2-6/image-to-image

Wan 2.6 Image-to-Image:シームレスなビジュアル編集とスケーラブルなスタイル適応のための指示ベースAI

flux-2/pro/edit

テキスト指示と最大10枚の元画像を使って編集し、7種類の出力サイズとJPEGまたはPNGを選択できます。

qwen-image-2.1/edit

Qwen Image 2.1: 統一された生成、編集、透明性

gpt-image-2.5/flare/edit

クリエイターのコンテンツ、ソーシャル投稿、製品バリエーションのリファレンスベースの画像編集を高速に実行します。

flux-1-1-pro/ultra/text-to-image

FLUX1.1 Pro Ultraで最大2Kの写実的な画像を生成します。

grok-2/image

テキストプロンプトから、1 回のリクエストで 1〜10 枚の画像を生成します。

よくある質問

Qwen Image 3.0 Pro の優れている点は何ですか?

Qwen Image 3.0 Pro は、洗練された詳細な結果を得るために構築されたプロダクショングレードのテキストから画像への変換モデルです。キャラクター アート、ポートレート、ファッションや製品のビジュアル、マーケティングやコンセプトの画像を処理し、プロンプトに厳密に従って、テクスチャ、照明、細部を 1 回のパスできれいに保ちます。

Qwen Image 3.0 Pro は標準モデルとどう違うのですか?

Qwen Image 3.0 Pro は、プロダクション グレードの品質に合わせて調整されており、細部のレンダリングが強化され、最終成果物に向けた迅速な遵守が実現します。簡単な下書きではなく、商用またはポートフォリオの作品で洗練された結果が必要な場合に使用します。

Qwen Image 3.0 Pro でテキストを正確にレンダリングするにはどうすればよいですか?

Qwen Image 3.0 Pro がそれをそのまま表示できるように、プロンプト内の正確な文言を引用符で囲み、各テキスト ブロックが配置される場所を説明します。これは、明確な主題と読みやすいタイポグラフィーを組み合わせたポスター、表紙、製品モックアップに適しています。

Qwen Image 3.0 Pro はどの解像度とアスペクト比をサポートしていますか?

Qwen Image 3.0 Pro は、1K または 2K の詳細層と 1:1、16:9、9:16、4:3、および 3:4 のアスペクト比を提供します。素早い探索には 1K を選択し、印刷または配信の準備が整った詳細には 2K を選択します。正確なオプションについては、現在の RunComfy パネルを確認してください。

Qwen Image 3.0 Pro はプロンプト拡張とシードをサポートしていますか?

はい。オプションのプロンプト展開設定により、生成前に短いプロンプトに追加の詳細が追加され、固定シードにより結果を再現できます。実行ごとに新しいバリエーションを作成するには、-1 を使用します。

RunComfy での Qwen Image 3.0 Pro の価格はいくらですか?

Qwen Image 3.0 Pro は出力層ごとに請求されます。1K 画像あたり 0.038 ドル、2K 画像あたり 0.072 ドルです。バッチの場合、合計は、単純にイメージごとのレートと生成されたイメージの数を掛けたものになります。

開発者は API を通じて Qwen Image 3.0 Pro を使用できますか?

Qwen Image 3.0 Pro は出力ティア別課金です:1K 画像あたり $0.038、2K 画像あたり $0.072。バッチ合計は画像単価 × 生成枚数です。

フォローする
  • LinkedIn
  • Facebook
  • Instagram
  • Twitter
サポート
  • Discord
  • メール
  • システムステータス
  • アフィリエイト
ビデオモデル
  • Seedance 2.5 Flash Text To Video
  • Seedance 2.5 Flash
  • Seedance 2.5 Flash Reference to Video
  • Wan 3.0
  • MiniMax H3 Fast
  • Wan 2.5
  • すべてのモデルを見る →
画像モデル
  • Seedream 5.5
  • Seedream 5.5 Edit
  • Seedream 5.5 Layer Decomposition
  • Wan 2.6 Image to Image
  • Nano Banana Pro
  • Seedream 5.0 Pro
  • すべてのモデルを見る →
法的情報
  • 利用規約
  • プライバシーポリシー
  • Cookieポリシー
RunComfy
著作権 2026 RunComfy. All Rights Reserved.

RunComfyは最高の ComfyUI プラットフォームです。次のものを提供しています: ComfyUIオンライン 環境とサービス、および ComfyUIワークフロー 魅力的なビジュアルが特徴です。 RunComfyはまた提供します AI Models, アーティストが最新のAIツールを活用して素晴らしいアートを作成できるようにする。
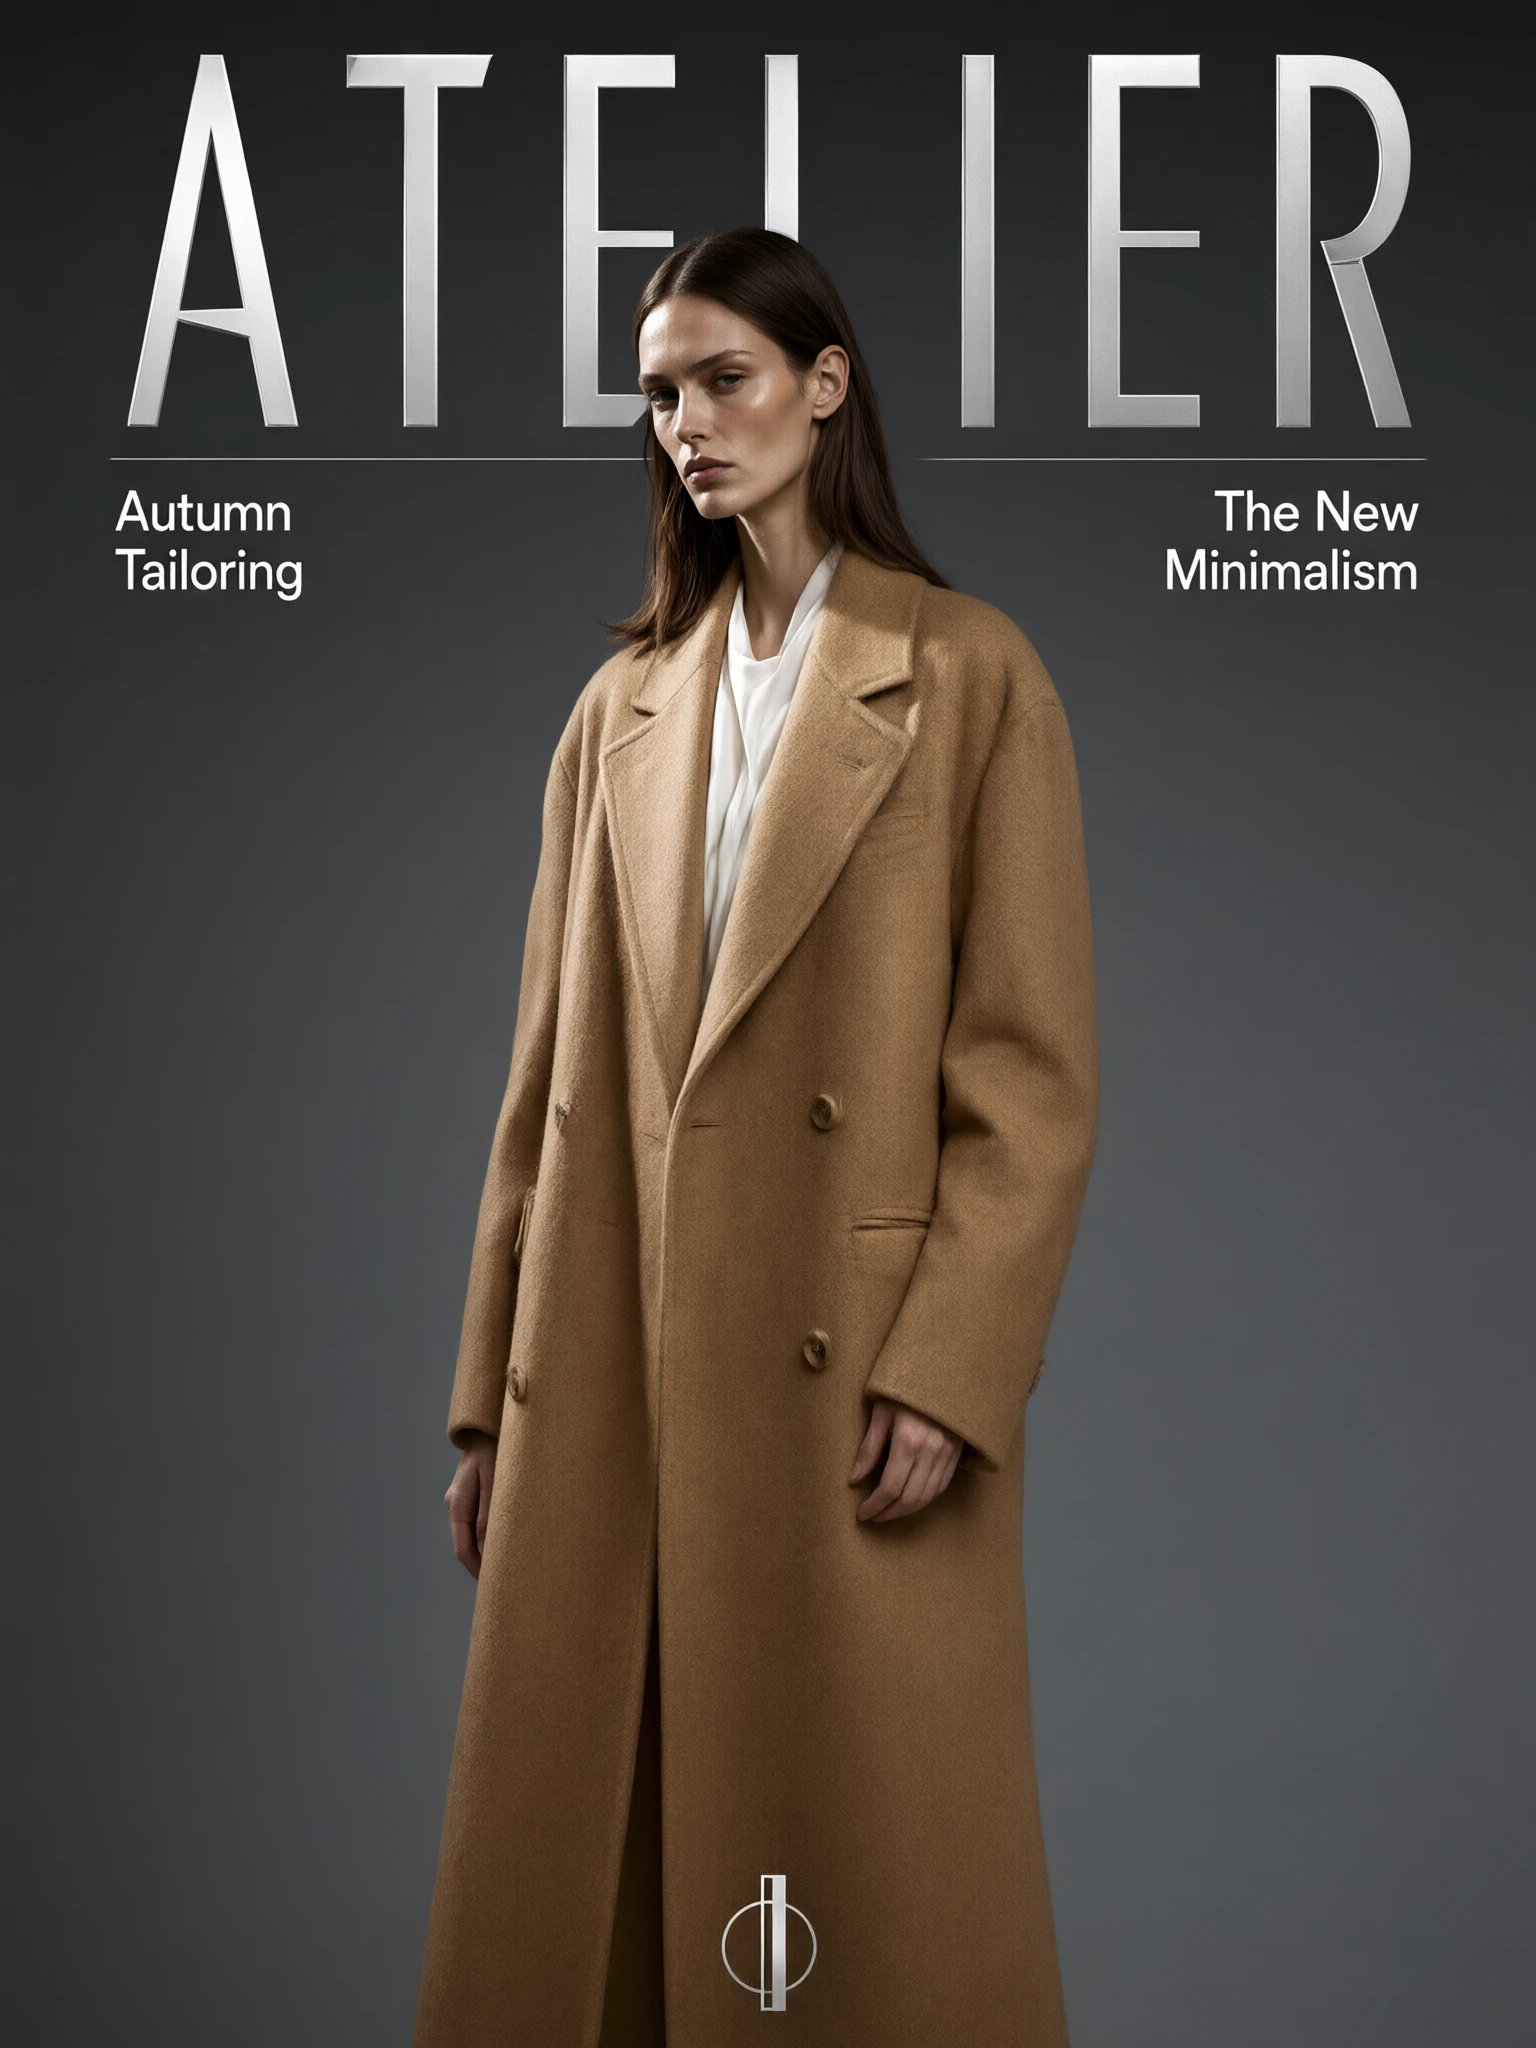
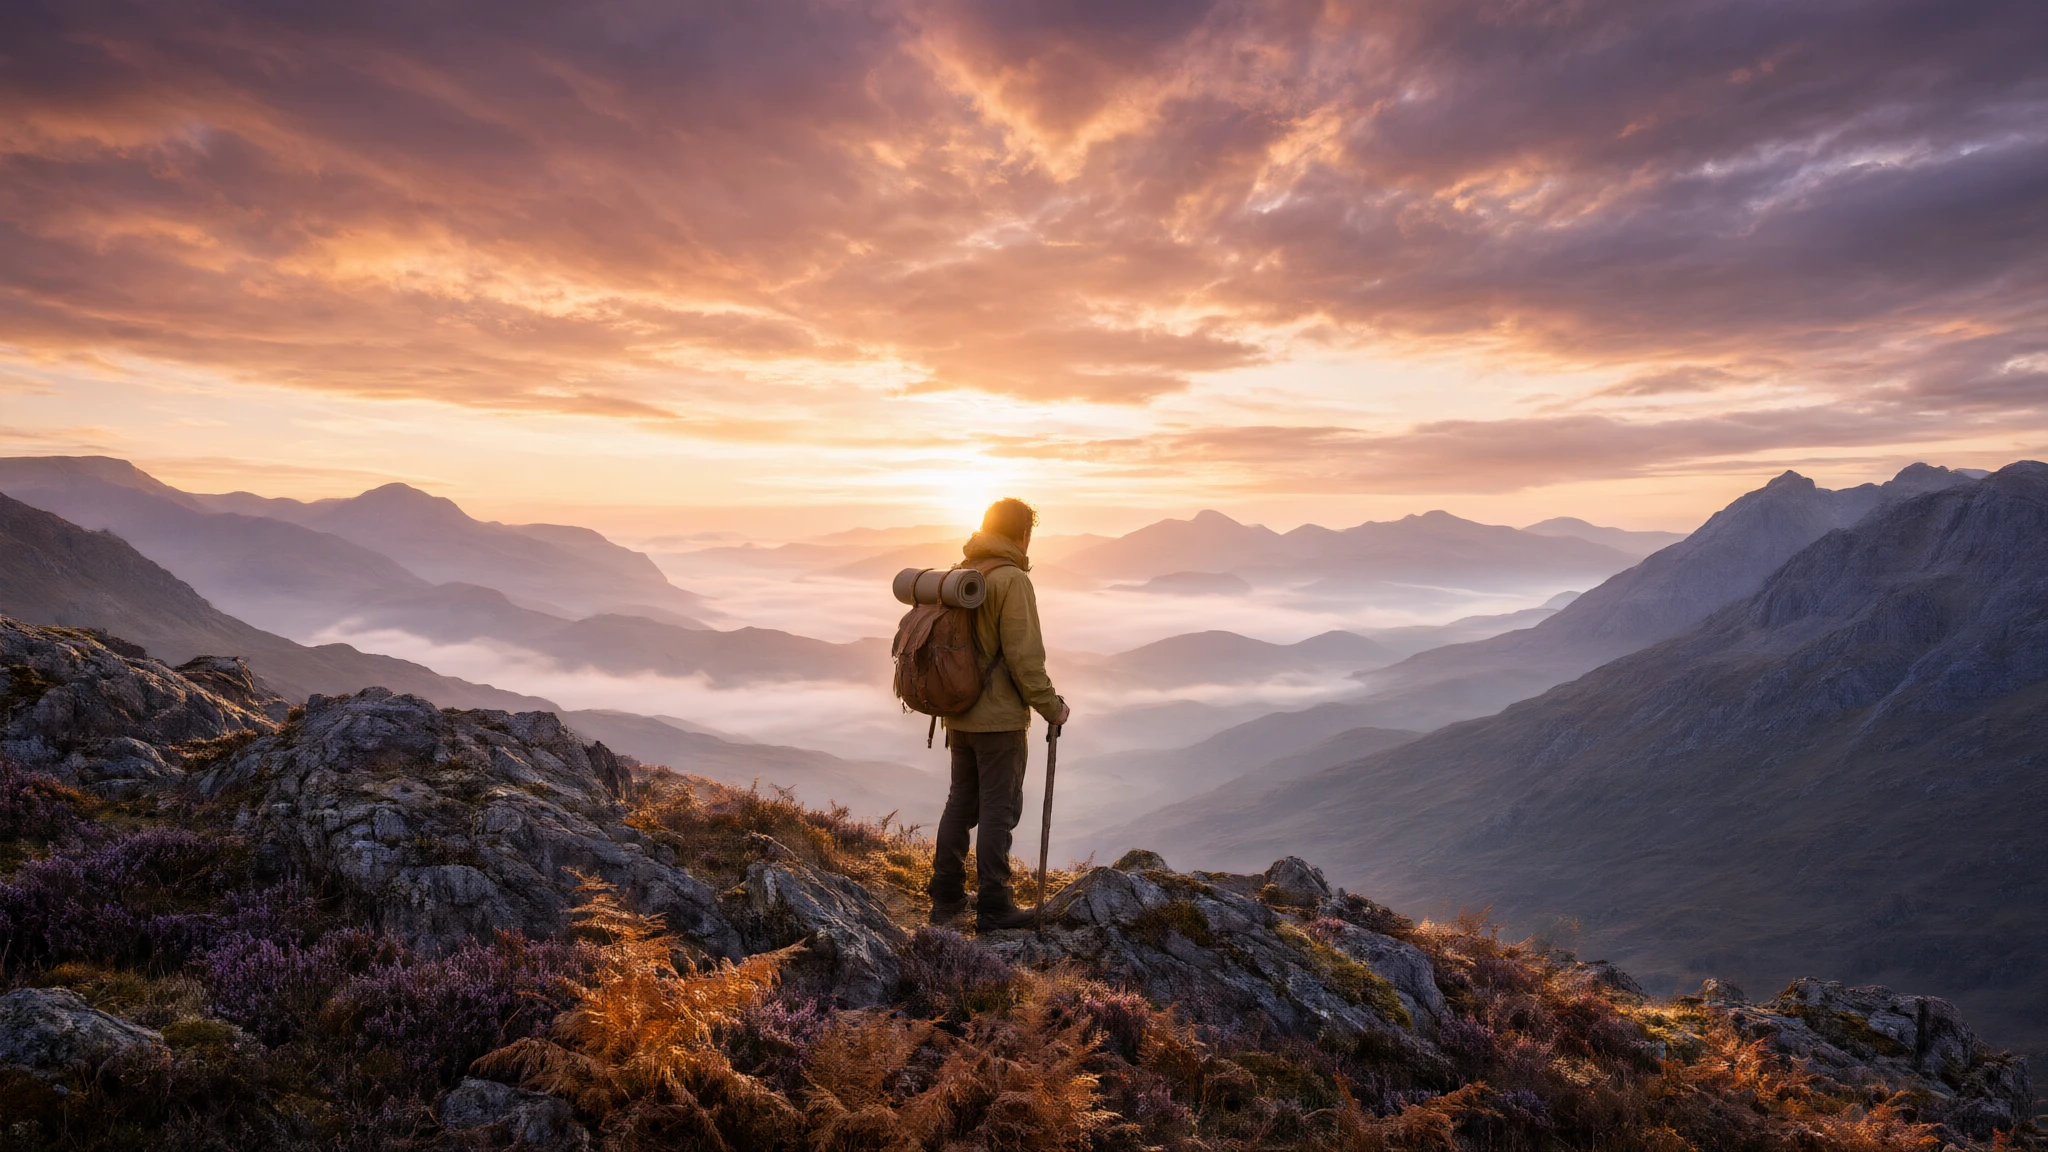
Qwen Image 3.0 Pro の例