kling-2-6/pro/image-to-video
1枚の参照画像から5秒または10秒の動画を生成し、任意のネガティブプロンプトとネイティブ音声を設定できます。
live avatar generator は、音声を使って 1 枚のポートレートを動かすためのモデルです。人物の特徴、顔の構造、構図を保ちながら、自然で一貫したトーキング動画を生成します。精度の高いリップシンク、控えめな表情変化、安定した動きにより、さまざまな音声や演出で繰り返し制作できます。
主な機能
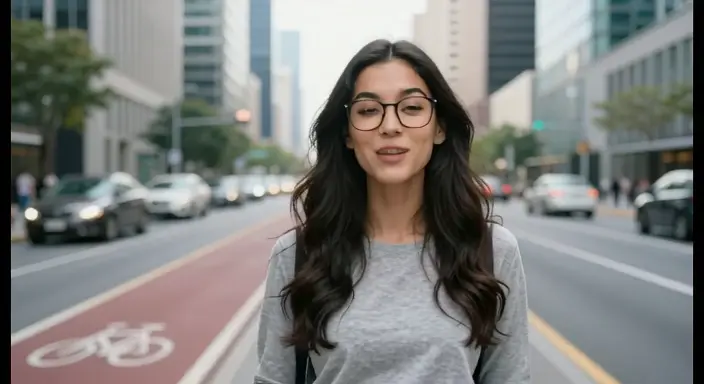
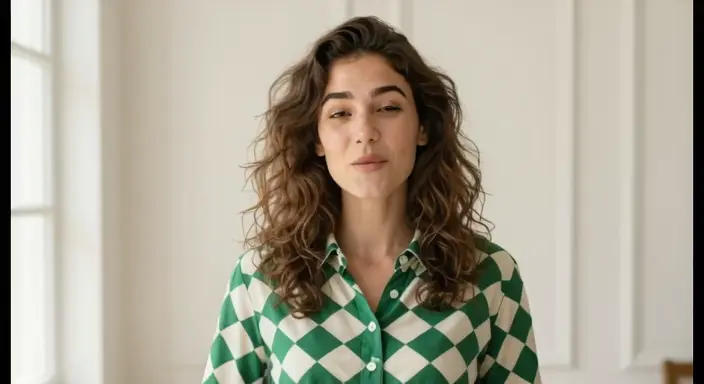
image_url に人物画像、audio_url に WAV または MP3 音声を指定し、表情、話すテンポ、動きの範囲を簡潔なプロンプトで説明します。num_clips を 1 増やすごとに長さは約 3 秒増えます。frames_per_clip は動きの滑らかさを調整する値で、4 の倍数にする必要があります。プロンプトへの忠実度を高めたい場合は guidance_scale を少しずつ上げ、同じ傾向の結果を得たい場合は seed を再利用してください。視線と顔の形を安定させるには、顔が中央にある鮮明な正面写真と、シンプルな背景を使用します。
例:
ヒント:
1枚の参照画像から5秒または10秒の動画を生成し、任意のネガティブプロンプトとネイティブ音声を設定できます。
高い視覚整合性とリアルな動きを備えた次世代映像生成AI
テキストや画像からリアルな映像と音声を一体化し、創造的な動画を生成。

正確なリップシンクとカメラ制御を備えた映画的な2K動画を生成します。

プロンプトから音声オプション付きの指向性マルチクリップ動画を生成する。

AI で動きを高精度に転写し、安定したキャラクターアニメーションを効率よく生成します。
live avatar generator は、1 枚の静止画、WAV または MP3 音声、プロンプトを組み合わせて動画を生成します。入力音声に合わせて顔と口を動かし、プロンプトで表情、テンポ、動きの大きさを調整します。
本格的な撮影をせずにトーキング動画を作りたいコンテンツ制作者、教育関係者、マーケティング担当者、プロダクトチームに向いています。AI スポークスパーソン、講義、解説、顧客向けアバターなどに利用できます。
RunComfy では生成時にクレジットを消費します。利用可能な試用枠と、現在の設定に必要なクレジットは RunComfy の画面に表示されるため、実行前に確認できます。
num_clips は約 3 秒単位でおおよその長さを決めます。frames_per_clip は動きの滑らかさを調整し、4 の倍数にする必要があります。guidance_scale はプロンプトへの忠実度、seed は結果の再現性に関係します。
有効な image_url、WAV または MP3 音声を指す有効な audio_url、プロンプトが必要です。出力はトーキング動画です。解像度はサービス側で決まり、入力項目としては公開されていません。
このエンドポイントは、1 回につき 1 枚のポートレートと 1 本の音声を処理します。複数人の会話を作る場合は、話者ごとに動画を生成してから編集ソフトで結合してください。
顔が中央にある鮮明な正面写真、シンプルな背景、ノイズの少ない音声を使用し、表情と動きを簡潔なプロンプトで指定してください。条件を詰め込みすぎず、guidance_scale は少しずつ調整するのが効果的です。
顔のアニメーションとトーキングショット向けのため、全身動作や大きなジェスチャーが中心の場面にはあまり向きません。長い動画ほどドリフトが起きやすいため、鮮明な入力素材と適切なクリップ設定を使用してください。
RunComfy のブラウザ画面から実行するほか、HTTP API で組み込むこともできます。処理はクラウド上で行われるため、モデルをローカルにインストールしたり運用したりする必要はありません。
RunComfyは最高の ComfyUI プラットフォームです。次のものを提供しています: ComfyUIオンライン 環境とサービス、および ComfyUIワークフロー 魅力的なビジュアルが特徴です。 RunComfyはまた提供します AI Models, アーティストが最新のAIツールを活用して素晴らしいアートを作成できるようにする。