sora-2/image-to-video
テキストや画像からリアルな映像と音声を一体化し、創造的な動画を生成。
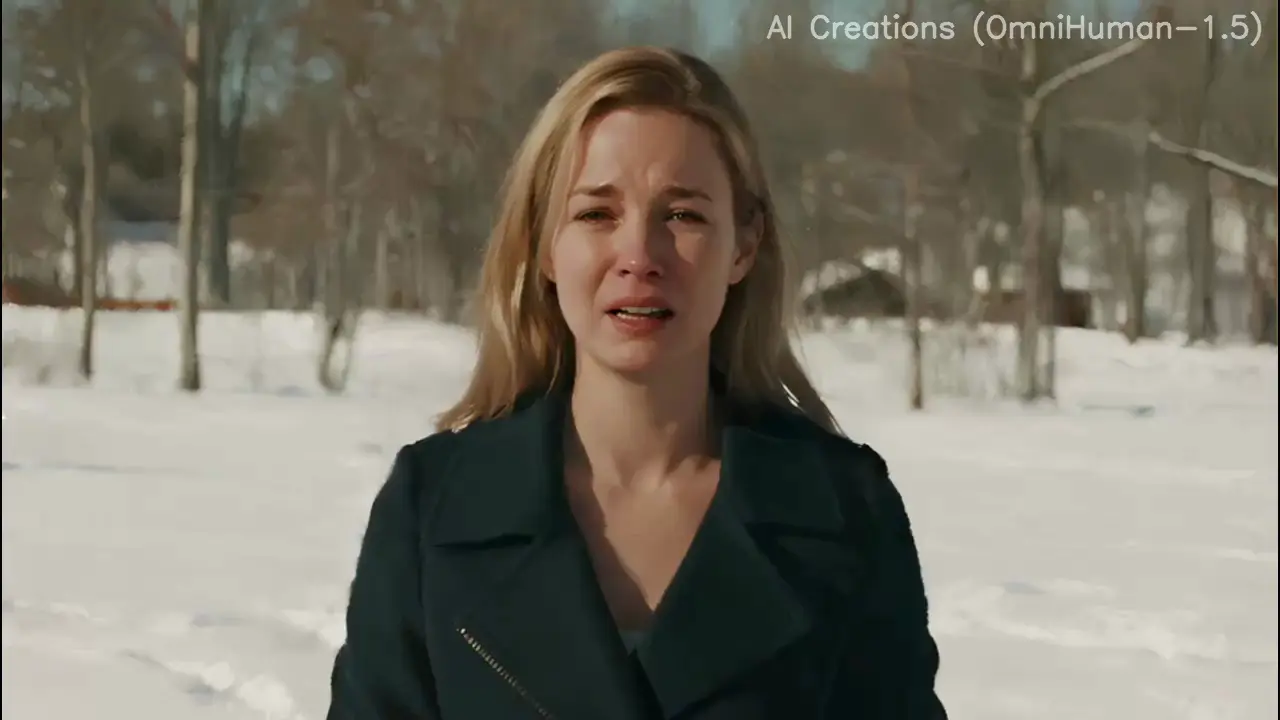
Omnihuman 1.5 は、必須の人物画像1枚と必須の音声1件から動画を生成します。入力として設定できるのは、2つの素材URL、任意のテキストガイダンス、シードです。
image_url — 必須。人物画像1枚の直接アクセス可能なURLを指定します。audio_url — 必須。動画を駆動する音声のURLを指定します。音声は35秒未満にする必要があります。prompt — 任意の生成ガイダンスです。中国語、英語、日本語、韓国語、メキシコのスペイン語、インドネシア語に対応します。seed — 生成を制御する整数のシードです。デフォルト値は-1です。image_url に人物画像1枚のURLを指定します。audio_url に音声URLを指定し、35秒未満であることを確認します。prompt に入力します。seed を設定し、リクエストを送信します。入力スキーマには、出力解像度、アスペクト比、フレームレート、出力形式の設定はありません。
テキストや画像からリアルな映像と音声を一体化し、創造的な動画を生成。

Wan 3.0 Prime Reference To Video は参照からクリップを高速に構築します

動きとデザインの一貫性を保ちながら、AIで既存映像を変換します。
テキストを高精細1080p映像に変換し、動きと感情をリアルに表現できるAI映像生成ツール。

必須の動画URLと音声URLからリップシンク動画を作成し、入力時間の不一致を5種類のモードで処理できます。

音声トラックの指定区間だけを正確に編集し、残りはそのまま保持。
必須の image_url に指定した人物画像と、必須の audio_url に指定した音声から動画を生成します。任意の prompt と seed も設定できます。
image_url と audio_url が必須です。prompt と seed は任意の設定です。
映像素材として使用する人物画像1枚の、直接アクセス可能なURLを指定します。
audio_url に指定する音声は35秒未満にする必要があります。
prompt は中国語、英語、日本語、韓国語、メキシコのスペイン語、インドネシア語に対応します。
seed は整数の生成制御項目で、デフォルト値は-1です。
image_url と audio_url に直接アクセスできることと、音声が35秒未満であることを確認します。
入力スキーマには、出力解像度、アスペクト比、フレームレート、出力形式の項目はありません。
image_url と audio_url を指定し、音声を35秒未満にします。prompt を使う場合は対応言語を選び、送信前に seed を確認します。
RunComfyは最高の ComfyUI プラットフォームです。次のものを提供しています: ComfyUIオンライン 環境とサービス、および ComfyUIワークフロー 魅力的なビジュアルが特徴です。 RunComfyはまた提供します AI Models, アーティストが最新のAIツールを活用して素晴らしいアートを作成できるようにする。