logo
RunComfy
  • ComfyUI
  • Entraîneur
  • Modèles
  • MCPNouveau
  • Tarification
  • Seedance 2.5Hot
  • Seedream 5.5Nouveau

Workflows par modèle

HotMiniMax H3Vidéo avec audio à partir de texte, d'images ou de référencesHotQwen Image 2.1Créez des images et retouchez des photos par référenceWanVidéo à partir de texte ou d'images, transfert de mouvementFLUXGénération, retouche et variations de personnagesLTXVidéo avec audio synchronisé à partir de texte ou d'imagesQwen Image EditRetouche photo par texte et images de référenceKrea 2Création d'images, transfert de style et retouchesZ-ImagePortraits et concepts rapides à partir de texte

Workflows populaires et nouveaux

NouveauMiniMax H3 Character Swap V1.5Remplacez des personnages en gardant l'audio d'origineNouveauP-H3-Image Reference EditRetouchez une photo guidée par une image de référenceHotMiniMax H3 Image-to-VideoUne image en vidéo cinématique avec audio synchroniséHotLTX 2.5 Image-to-VideoUne image en vidéo nette avec audio synchroniséHotMiniMax H3 Character Swap (SAM3)Remplacez des personnages en suivant le mouvementQwen Image 2.1 Multi-Image EditingScènes précises avec jusqu'à 10 images de référenceFLUX Klein Face SwapÉchange de visage naturel et réalisteSeedVR2 Video UpscalerUpscaling vidéo net et fluide
Voir plus de workflows

Entraîner un modèle

NouveauMOSS-Image BaseGénération d'images, nouvellement prise en chargeNouveauFLUX.3 KleinGénération d'images, nouvellement prise en chargeHotKrea 2Le modèle d'image le plus entraînéHotKrea 2 TurboGénération d'images en peu d'étapesHotQwen Image 2.1Génération et retouche d'imagesZ-Image TurboPortraits et images conceptuelles rapidesMiniMax H3Vidéo avec audio synchronisé

Entraîner et déployer

Pour commencerVotre premier entraînement avec Ostris AI ToolkitJeux de donnéesImportez et gérez vos jeux de donnéesInférenceUtilisez vos modèles dans le playground ou via l'APIDéploiementsDéployez vos modèles sur des endpoints dédiés
Entraîner d'autres modèles

Modèles d'images

NouveauGPT Image 2.6-5 % · Texte vers image détaillé, GIF et SVG, jusqu'en 4KNouveauSeedream 5.5-10 % · Texte vers image jusqu'en 2K, avec PNG transparentsNouveauMiniMax H3 Image-10 % · Texte ou références vers une image jusqu’en 4KNouveauFLUX 3 Image Klein-10 % · Texte ou références vers une image de 768 à 4KHotSeedream 5.0 Pro-20 % · Retouches par référence, texte multilingueHotSeedream 4.5-20 % · Retouches photoréalistes fidèles à la marqueHotWan 2.6 ImageRetouche d'image par instructionsNano Banana Pro-77 % · Visuels 2K à 4K précis à partir de croquis

Modèles vidéo

NouveauSeedance 2.5 Flash-34 % · Text, image, or reference to videoNouveauKling 4.0-9 % · Animez une image en clip de 3 à 30 sHotWan 3.0 Prime-13 % · Clips rapides à partir de vidéos de référenceHotSeedance 2.5-35 % · Vidéo cinématique plus longue et plus cohérenteHotWan 3.0Clips à partir d'images, de vidéos et d'audioHotMiniMax H3Animez une première image en clip de 5 à 15 sWan 2.5-10 % · Mouvement fluide et audio natifFLUX 3 MaxClips à partir de texte, d'une image ou d'images clés
Voir plus de modèles

API

Serverless (ComfyUI)Déployez des workflows ComfyUI en endpoints serverless.Serverless (LoRA)Déployez des LoRAs en endpoints serverless.Model APIExécutez des modèles hébergés à la demande sans déploiement.Trainer APIEntraînez, gérez et récupérez des LoRAs via l'API.CLIRun RunComfy models from your terminal.
MODÈLES
Explorer
Tous les modèles
BIBLIOTHÈQUE
Générations
APIS DE MODÈLES
Documentation API
Clés API
COMPTE
Utilisation

Seedance 2.0 Fast : génération vidéo multimodale | RunComfy

bytedance/seedance-2.0/fast

Générez des vidéos cinématographiques à partir de texte et de médias, avec audio natif, synchronisation labiale précise et narration maîtrisée — pour itérer plus vite sur les publicités, les prévisualisations et les contenus de marque.

Prompt pour la vidéo (environ ≤500 caractères chinois ou ≤1000 mots anglais recommandés).
Images de référence pour le mode de référence multimodal (0–9). Prise en charge de jpeg, png, webp, bmp, tiff, gif.
Vidéos de référence pour le mode de référence multimodal (0–3). Prise en charge de mp4, mov. La durée de la vidéo doit être comprise entre 2 et 15 secondes.
Audio de référence pour le mode de référence multimodal (0–3). Prise en charge de wav, mp3. La durée de l'audio doit être comprise entre 2 et 15 secondes. La taille doit être inférieure à 15 Mo.
Le réglage par défaut de Seedance 2.0 Fast est adaptatif (le modèle sélectionne le rapport le plus proche ; le rapport réel est renvoyé lors de la requête de tâche).
Secondes entières en [4, 15].
Lorsque la valeur est true, le modèle produit une vidéo avec un audio synchronisé (parole, SFX, musique).
Seed aléatoire pour la génération vidéo.
Lorsque `web_search` est inclus, le modèle peut exécuter une recherche en ligne en fonction du prompt (par exemple, produits spécifiques, météo actuelle), ce qui peut améliorer la actualité des informations mais augmente la latence.
Idle
Billed on total video seconds (input + output). The rate per second is $0.065 for 480p and $0.14 for 720p. Text-to-video counts only the generated duration; when a reference video is provided, both the input and output durations are counted.

Présentation de la création vidéo avec Seedance 2.0 Fast

Seedance 2.0 Fast de ByteDance transforme texte et références en vidéos cinématographiques avec audio natif et synchronisation labiale à la milliseconde. Il conserve le workflow multimodal de la version Pro tout en privilégiant des générations plus rapides.

Idéal pour : itérations créatives rapides | publicités vidéo performantes | prévisualisation précise des plans | récits multilingues cohérents avec la marque et synchronisés sur les lèvres

ByteDance Seed / Seedance 2.0 Fast#


Seedance 2.0 Fast est un modèle text-to-video multimodal optimisé pour la vitesse de ByteDance Seed qui transforme les descriptions de scènes et les références facultatives en courts clips cinématographiques. Sur RunComfy, vous pilotez la génération avec un prompt et des images facultatives (jusqu'à 9), des vidéos (jusqu'à 3) et de l'audio (jusqu'à 3) pour le mode de référence multimodal, et vous pouvez définir le rapport d'aspect, la durée, la résolution, les options générer de l'audio et seed, ainsi que des outils facultatifs (par ex. [{ "type": "web_search" }] pour permettre la recherche en ligne lorsque le modèle en a besoin).


Points forts#

  • Références multimodales : Jusqu'à 9 images, 3 vidéos de référence (2–15 s chacune, mp4/mov) et 3 références audio (2–15 s, wav/mp3, moins de 15 Mo chacune), accompagnées d'un prompt textuel précis.
  • Cadre flexible : Le rapport adaptatif par défaut permet au modèle de choisir le format le plus proche ; des ratios fixes sont disponibles pour une livraison spécifique à la plateforme.
  • Vidéo avec audio : Activez Générer de l'audio pour synchroniser la parole, les effets sonores et la musique avec le clip.
  • Durée contrôlable : La durée est un nombre entier compris entre 4 et 15 secondes (par défaut 5).
  • Reproductibilité : Définissez seed lorsque vous avez besoin de résultats reproductibles tout en affinant les prompts ou les références.
  • Recherche Web facultative : Passez les outils avec type: web_search afin que le modèle puisse effectuer une recherche sur le Web en cas de besoin ; vérifiez usage.tool_usage.web_search dans la réponse à la requête de tâche pour connaître le nombre de recherches exécutées.

Playgrounds associés

luma-ray-2/image-to-video

Créez des vidéos réalistes à partir d’images avec fluidité et style.

kling-video-o3/4K/reference-to-video

Génération cinématographique 4K à partir de références, à 0,419 $ par seconde de sortie.

infinite-talk/fast

Générez une vidéo à partir d’une piste audio et d’une image, avec prompt et seed facultatifs.

ltx-2/pro/text-to-video

Générez une vidéo 1080p à partir d’un prompt obligatoire, d’une durée de 6, 8 ou 10 secondes, avec un son facultatif.

flux-3/text-to-video

FLUX 3 Video transforme les invites de texte en clips cinématographiques avec audio natif

veo-3-1/image-to-video

Transformez vos images en vidéos réalistes grâce à la puissance de l'IA Veo 3.1.

Questions Fréquemment Posées

Qu'est-ce que Seedance 2.0 Fast sur RunComfy ?

Seedance 2.0 Fast est le modèle vidéo multimodal orienté vers la vitesse de ByteDance Seed : vous décrivez la scène dans du texte et pouvez ajouter des images, une vidéo de référence et un audio de référence afin que le modèle aligne le mouvement, l'apparence et le son. Sur RunComfy, il est réglé pour un délai d'exécution plus rapide tout en prenant en charge les courts clips cinématographiques, l'audio natif en option, les résultats avec une synchronisation labiale précise et le contrôle de la caméra lorsque vous dirigez la prise de vue dans votre prompt.

Quelle résolution et quel rapport hauteur/largeur puis-je choisir pour Seedance 2.0 Fast ?

La résolution est 480p ou 720p (par défaut). Le rapport d'aspect est par défaut adaptatif (le modèle sélectionne la correspondance la plus proche ; le résultat de la tâche affiche le rapport de sortie réel). Vous pouvez aussi le fixer à 16:9, 9:16, 4:3, 3:4, 1:1 ou 21:9.

Comment fonctionne la saisie multimodale ? Quelles sont les limites pour les prompts et les médias de référence avec Seedance 2.0 Fast ?

Seul prompt est requis ; les références sont facultatives mais définissent le mode de référence multimodal lorsque vous les ajoutez. Prompt : environ ≤500 caractères chinois ou ≤1000 mots anglais sont recommandés. Images : jusqu'à 9 (jpeg, png, webp, bmp, tiff, gif). Vidéos de référence : jusqu'à 3 (mp4, mov), chacune d’une durée de 2–15 secondes. Audio de référence : jusqu'à 3 (wav, mp3), chacune d’une durée de 2–15 secondes et moins de 15 Mo. Des prompts clairs et des références alignées donnent généralement l'identité, le style et la synchronisation les plus stables.

Quelle peut être la durée des sorties et comment puis-je définir la durée avec Seedance 2.0 Fast ?

La durée est un nombre entier 4–15 secondes (par défaut 5). Choisissez n’importe quelle durée entière dans cette plage par tâche.

Seedance 2.0 Fast génère-t-il de l'audio et prend-il en charge la synchronisation labiale ?

Avec Générer l'audio (generate_audio) défini sur true (valeur par défaut), le modèle peut produire une vidéo avec audio synchronisé (dialogue, SFX ou musique). Réglez-le sur false pour une vidéo silencieuse. La qualité de la synchronisation labiale dépend de la manière dont vous décrivez explicitement la parole, le cadrage et le timing dans le prompt ; la référence audio peut également guider le rythme ou le ton lorsque vous utilisez des références multimodales.

Quand dois-je choisir Seedance 2.0 Fast au lieu de Seedance 2.0 Pro ?

Choisissez Fast lorsque vous privilégiez des temps d'attente plus courts et des itérations rapides : mêmes champs du Playground (prompt, image_url, video_url, audio_url, aspect_ratio, duration, resolution, generate_audio, seed), avec une sortie 480p/720p et l’ensemble des limites de référence multimodale. Choisissez Pro lorsque vous souhaitez bénéficier de la fidélité cinématographique la plus élevée proposée par le fournisseur pour une prise de vue. Effectuez des tests A/B avec le même prompt et les mêmes références pour juger de la qualité par rapport à la vitesse de votre pipeline.

Qu’apporte Seedance 2.0 Fast par rapport à Seedance 1.5 Pro et au reste de la gamme Seedance 2.x ?

Seedance 2.0 Fast se concentre sur de courts clips cinématographiques avec de riches références multimodales (de nombreuses images plus vidéo et audio en option), une durée 4–15 s, des rapports d'aspect adaptatifs ou fixes et un audio intégré lorsque generate_audio est activé. Les améliorations dépendent du cas d'utilisation ; comparez vos propres prompts, personnages et packs de référence plutôt que de vous fier à un seul benchmark.

Comment Seedance 2.0 Fast se compare-t-il à des modèles comme Wan 2.5 ou Kling Video 2.6 ?

Cela dépend du budget, de la latence et du type de mouvement dont vous avez besoin. Sur RunComfy, Seedance 2.0 Fast met l'accent sur le text-to-video multimodal rapide avec jusqu'à neuf images, trois vidéos de référence, trois références audio, des préréglages 480p/720p et une bascule générer de l'audio. Wan 2.5 et Kling 2.6 diffèrent en termes de prix, de limites et de points forts : effectuez des tests en parallèle sur vos briefs et ensembles de référence typiques.

Comment passer du Playground à l’API RunComfy avec Seedance 2.0 Fast ?

Reprenez le schéma d’entrée du Playground : prompt, image_url, video_url, audio_url, aspect_ratio, duration, resolution, generate_audio et seed. Appliquez les mêmes limites de prompts et de médias dans votre application, puis authentifiez-vous avec votre clé API et vos crédits pour les tâches par lots ou automatisées.

Puis-je utiliser les sorties Seedance 2.0 Fast à des fins commerciales ?

L'utilisation commerciale dépend de la licence de ByteDance pour le modèle et des conditions de service de RunComfy. Lisez la licence officielle du modèle et la documentation RunComfy, ou envoyez un e-mail à hi@runcomfy.com avant d'utiliser les séquences générées dans des campagnes payantes, dans le cadre d'un travail client ou pour une diffusion à grande échelle.

Qui tire le plus de valeur de Seedance 2.0 Fast sur RunComfy ?

Créateurs et équipes qui ont besoin d'une génération rapide de vidéos multimodales : concepts sociaux et publicitaires, storyboards et prévisualisations, courts métrages de marque et flux de travail à forte itération où la vitesse compte autant qu'un seul visuel phare. Associez le texte à des références lorsque vous avez besoin d'un look, d'un personnage ou d'un mouvement guidé par l’audio reproductible, puis passez à Pro pour une finition finale lorsque la prise de vue le justifie.

Suivez-nous
  • LinkedIn
  • Facebook
  • Instagram
  • Twitter
Support
  • Discord
  • Email
  • État du système
  • affilié
Modèles vidéo
  • Seedance 2.5 Flash Text To Video
  • Seedance 2.5 Flash
  • Seedance 2.5 Flash Reference to Video
  • Wan 3.0
  • MiniMax H3 Fast
  • Wan 2.5
  • Voir tous les modèles →
Modèles d'images
  • Seedream 5.5
  • Seedream 5.5 Edit
  • Seedream 5.5 Layer Decomposition
  • Wan 2.6 Image to Image
  • Nano Banana Pro
  • Seedream 5.0 Pro
  • Voir tous les modèles →
Légal
  • Conditions d'utilisation
  • Politique de confidentialité
  • Politique relative aux cookies
RunComfy
Droits d'auteur 2026 RunComfy. Tous droits réservés.

RunComfy est la première ComfyUI plateforme, offrant des ComfyUI en ligne environnement et services, ainsi que des workflows ComfyUI proposant des visuels époustouflants. RunComfy propose également AI Models, permettant aux artistes d'utiliser les derniers outils d'IA pour créer des œuvres d'art incroyables.
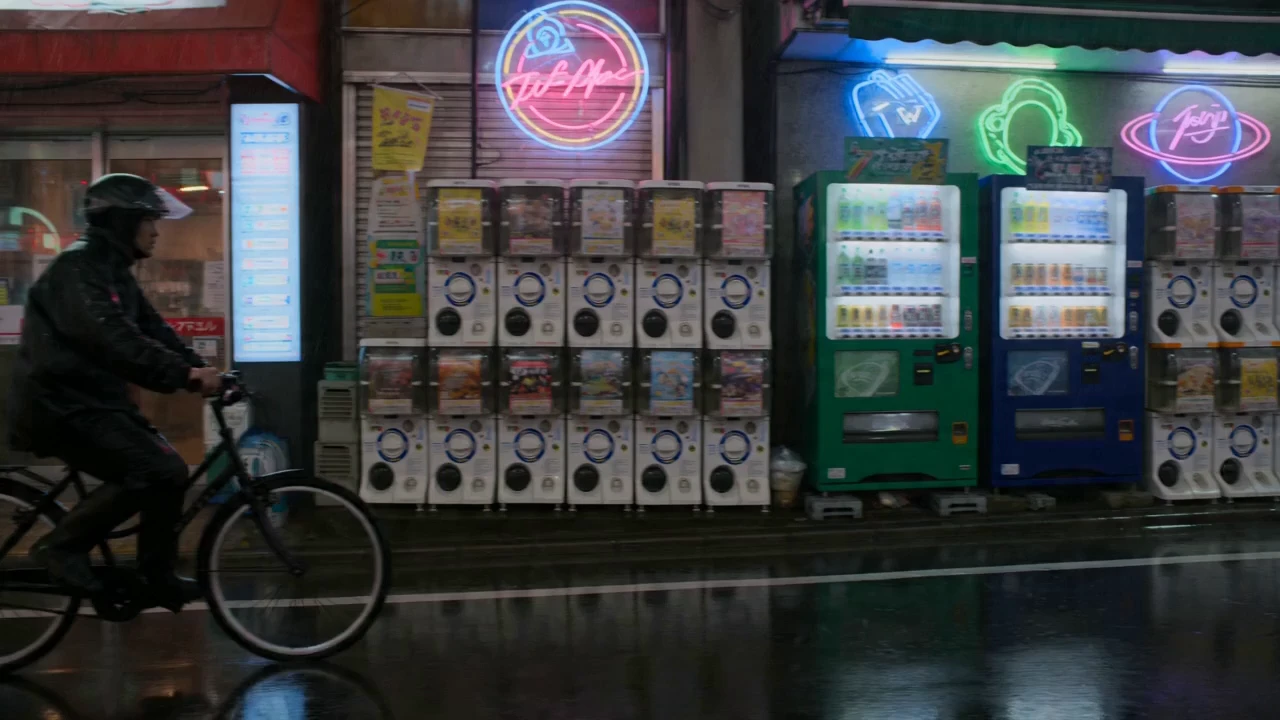
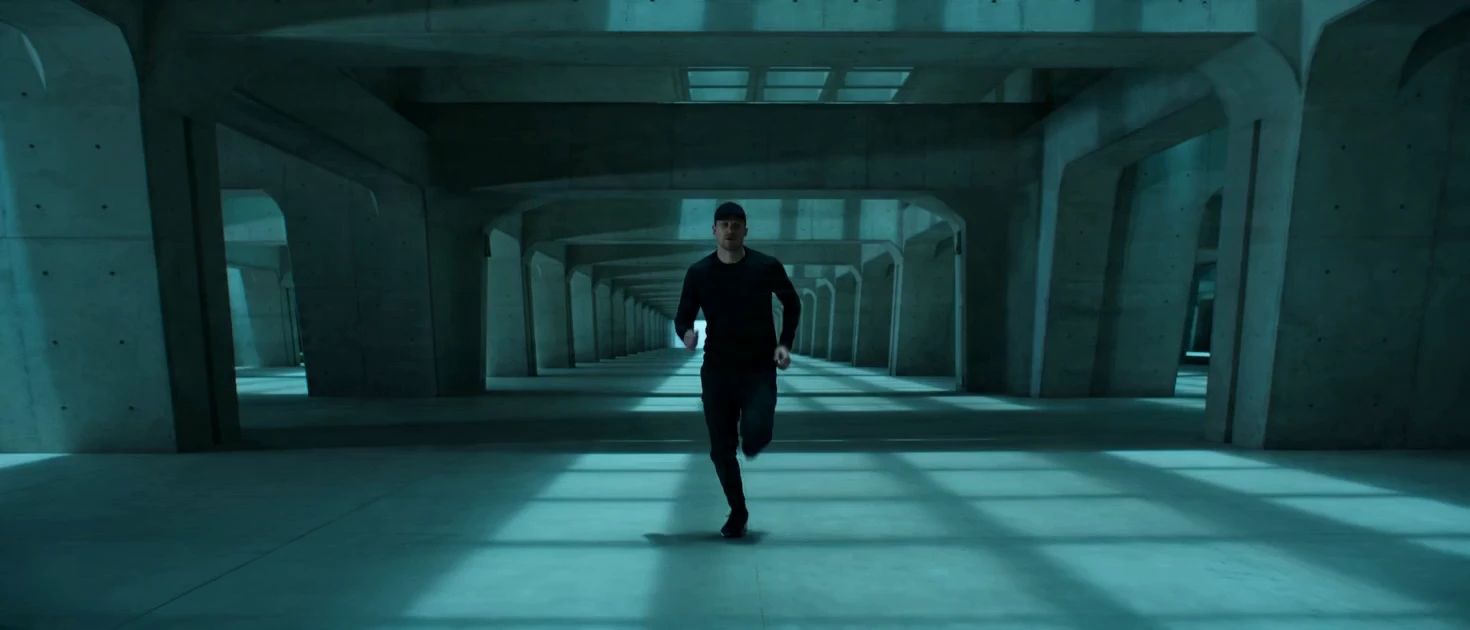
Exemples vidéo de Seedance 2.0 Fast

Video thumbnail
Loading...
Video thumbnail
Loading...
Video thumbnail
Loading...
Video thumbnail
Loading...
Video thumbnail
Loading...
Video thumbnail
Loading...