logo
RunComfy
  • ComfyUI
  • Entrenador
  • Modelos
  • MCPNuevo
  • Precios
  • Seedance 2.5Hot
  • Seedream 5.5Nuevo

Flujos de trabajo por modelo

HotMiniMax H3Video con audio a partir de texto, imágenes o referenciasHotQwen Image 2.1Crea imágenes y edita fotos con referenciasWanVideo desde texto o imágenes, transferencia de movimientoFLUXGeneración y edición de imágenes y variaciones de personajesLTXVideo con audio sincronizado desde texto o imágenesQwen Image EditEdición de fotos con texto e imágenes de referenciaKrea 2Creación de imágenes, transferencia de estilo y edicionesZ-ImageRetratos y conceptos rápidos a partir de texto

Flujos populares y nuevos

NuevoMiniMax H3 Character Swap V1.5Cambia personajes de video y conserva el audioNuevoP-H3-Image Reference EditEdita una foto guiada por una imagen de referenciaHotMiniMax H3 Image-to-VideoUna imagen a video cinematográfico con audio sincronizadoHotLTX 2.5 Image-to-VideoUn fotograma a video nítido con audio sincronizadoHotMiniMax H3 Character Swap (SAM3)Cambia personajes de video siguiendo el movimientoQwen Image 2.1 Multi-Image EditingEscenas precisas con hasta 10 imágenes de referenciaFLUX Klein Face SwapCambio de rostro natural y realistaSeedVR2 Video UpscalerEscalado de video nítido y fluido
Ver más flujos de trabajo

Entrenar un modelo

NuevoMOSS-Image BaseGeneración de imágenes, recién admitidoNuevoFLUX.3 KleinGeneración de imágenes, recién admitidoHotKrea 2El modelo de imagen más entrenadoHotKrea 2 TurboGeneración de imágenes en pocos pasosHotQwen Image 2.1Generación y edición de imágenesZ-Image TurboRetratos e imágenes conceptuales rápidosMiniMax H3Video con audio sincronizado

Entrenar y desplegar

Primeros pasosTu primer entrenamiento con Ostris AI ToolkitConjuntos de datosSube y gestiona conjuntos de datosInferenciaUsa tus modelos entrenados en el playground o por APIDesplieguesDespliega tus modelos como endpoints dedicados
Entrenar más modelos

Modelos de Imagen

NuevoGPT Image 2.65 % dto. · Texto a imagen detallado, GIF y SVG, hasta 4KNuevoSeedream 5.510 % dto. · Texto a imagen hasta 2K, con PNG transparentesNuevoMiniMax H3 Image10 % dto. · Texto o referencias a una imagen de hasta 4KNuevoFLUX 3 Image Klein10 % dto. · Texto o referencias a una imagen de 768 a 4KHotSeedream 5.0 Pro41 % dto. · Ediciones con referencias y texto multilingüeHotSeedream 4.520 % dto. · Ediciones fotorrealistas con coherencia de marcaHotWan 2.6 ImageEdición de imágenes por instruccionesNano Banana Pro77 % dto. · Imágenes precisas de 2K a 4K a partir de bocetos

Modelos de Video

NuevoSeedance 2.5 Flash34 % dto. · Text, image, or reference to videoNuevoKling 4.010 % dto. · Anima una imagen en un clip de 3 a 30 sHotWan 3.0 Prime13 % dto. · Clips rápidos a partir de videos de referenciaHotSeedance 2.536 % dto. · Video cinematográfico más largo y coherenteHotWan 3.0Clips a partir de imágenes, video y audioHotMiniMax H3Anima un primer fotograma en un clip de 5 a 15 sWan 2.510 % dto. · Movimiento fluido con audio nativoFLUX 3 MaxClips a partir de texto, una imagen o fotogramas clave
Ver más modelos

API

Serverless (ComfyUI)Despliega flujos de trabajo de ComfyUI como endpoints serverless.Serverless (LoRA)Despliega LoRAs como endpoints serverless.Model APIEjecuta modelos alojados bajo demanda sin despliegue.Trainer APIEntrena, gestiona y obtén LoRAs a través de la API.CLIRun RunComfy models from your terminal.
MODELOS
Explorar
Todos los modelos
BIBLIOTECA
Generaciones
APIS DE MODELOS
Documentación de la API
Claves API
CUENTA
Uso

Wan 2.7 Texto a imagen: Genera imágenes con IA online | Modelos y API | RunComfy

wan-ai/wan-2.7/text-to-image

Crea imágenes de alta calidad con WAN 2.7 usando prompts en chino o inglés, prompt negativo, tamaños preestablecidos, hasta cinco variantes por solicitud y seeds reproducibles. Precio aproximado: 0,03 USD por imagen en RunComfy. También incluye un filtro de seguridad configurable.

Prompt de texto que describe la imagen deseada. Admite chino e inglés.
Contenido que debe evitarse en la imagen generada. Máximo 500 caracteres.
Tamaño de salida preestablecido. Cuando sea compatible, puede enviarse un objeto `{width, height}` personalizado en lugar de una cadena preestablecida.
Número máximo de imágenes que se generarán (1–5). Valor predeterminado: 1.
Seed aleatorio para reproducir resultados (0–2147483647).
Idle
The rate is $0.03 per image.

Introducción a Wan 2.7 texto a imagen

Wan 2.7 texto a imagen de Alibaba está pensado para crear imágenes listas para producción: interpreta los prompts con precisión, admite instrucciones en chino e inglés y ofrece tamaños prácticos mediante image_size. En RunComfy puedes configurar prompt, negative_prompt, image_size, max_images y seed. La familia Wan 2.7 destaca por su composición razonada y su fidelidad al prompt. El filtro de seguridad se controla mediante enable_safety_checker.

Ideal para: imágenes de marketing | arte conceptual | formatos para redes sociales | exploración rápida de diseños antes de renderizar con la versión Pro

Wan 2.7 texto a imagen#


Descripción general#


Wan 2.7 texto a imagen en RunComfy convierte prompts en chino o inglés en imágenes estáticas. El modelo prioriza la comprensión precisa del prompt y los resultados detallados. La resolución máxima y los límites fijos dependen del despliegue actual en RunComfy.


Campos de respuesta#


Cada solicitud correcta devuelve de una a cinco imágenes en el array images, texto opcional del modelo en generated_text y un seed en la respuesta.


Funciones principales#


  • Mensajes bilingües: Se admiten inglés y chino.
  • Mensaje negativo: Hasta 500 caracteres para evitar elementos no deseados.
  • Preajustes de image_size: square_hd, square, retrato y paisaje 4:3 y 16:9. Es posible que se admita un objeto {width, height} en integraciones avanzadas.
  • Exploración por lotes: max_images 1–5 para variaciones en un trabajo.
  • Reproducción: seed entero opcional en el rango [0, 2147483647].
  • Seguridad: enable_safety_checker modera la entrada y salida (predeterminado activado).

Parámetros#

ParámetroObligatorioTipoPredeterminadoRango / OpcionesDescripción
prompt*Sístring——Escena principal, estilo y composición
negative_promptNostring""máx. 500 caracteresContenido que debe evitarse
image_sizeNostringsquare_hdenum presetsFormato o tamaño de salida
max_imagesNointeger11–5Número de imágenes que se generarán
seedNointeger—0–2147483647Reproducción del resultado
enable_safety_checkerNobooleantrueon / offModeración de entrada y salida

Precios#

FacturaciónPrecio
Por imagen generada0,03 USD

Los cargos aumentan con la cantidad de imágenes (max_images) en una sola solicitud.


Cómo usarlo#


  1. Escriba un mensaje estructurado: tema, entorno, iluminación, lente y estilo.
  2. Agregue un breve negative_prompt solo para cosas concretas que desee suprimir.
  3. Elija un tamaño preestablecido que coincida con la relación de aspecto de su entrega.
  4. Establezca max_images en mayor que 1 al explorar variaciones; mantenga la seed fija para comparar las ediciones rápidas.
  5. Enviar e iterar. Ajusta el vocabulario de la cámara si la composición se desvía.

Consejos para prompts#


  • Liderar con el tema héroe, luego la iluminación y los materiales.
  • Especifique las necesidades de aspecto explícitamente cuando no esté utilizando un ajuste preestablecido coincidente.
  • Para la iteración, cambie una dimensión a la vez (indicador versus semilla versus tamaño).

Modelos Wan 2.7 relacionados#


  • Wan 2.7 Text-to-Image Pro en RunComfy: nivel de mayor fidelidad.
  • Wan 2.7 Image Edit en RunComfy: ediciones basadas en referencias.
  • Wan 2.7 Text-to-Video — flujos de trabajo de movimiento en RunComfy.

Modelos relacionados

flux-1-1-pro/ultra/text-to-image

Genera imágenes fotorrealistas de hasta 2K con FLUX1.1 Pro Ultra.

recraft-v3/text-to-image

Cree imágenes rasterizadas, de ilustración digital o de estilo vectorial con controles detallados de estilo, tamaño y color.

ideogram-v3/edit

Edita con Ideogram 3 una zona enmascarada de una imagen mediante un prompt.

flux-2-klein/4b/text-to-image

Conversión de texto a imagen en menos de un segundo en 4 pasos con imágenes precisas

nano-banana-2-lite/edit

Edición de imágenes rápida, económica y guiada por prompts con resolución fija de 1K.

qwen-image-3.0/pro/text-to-image

Qwen Image 3.0 Pro: generación de texto a imagen de nivel de producción

Preguntas Frecuentes

¿Qué impulsa la conversión de texto a imagen Wan 2.7 en RunComfy?

RunComfy integra Wan 2.7 texto a imagen de la familia de modelos de Alibaba. Los campos documentados prompt, negative_prompt, image_size, max_images, seed y enable_safety_checker se envían al servicio de inferencia configurado para este modelo.

¿Cuánto cuesta la conversión de texto a imagen de Wan 2.7 por imagen en RunComfy?

El precio de RunComfy es de 0,03 USD por imagen generada. Si defines max_images por encima de 1, el coste total aumenta según el número de imágenes que devuelva la tarea.

¿La conversión de texto a imagen de Wan 2.7 admite mensajes en chino?

Sí. En la interfaz del modelo de RunComfy puedes escribir prompts en chino o inglés.

¿Cuántas imágenes puedo generar en una solicitud de texto a imagen de Wan 2.7?

Para este modelo, max_images debe ser un número entero entre 1 y 5.

¿Debo utilizar texto a imagen Wan 2.7 o texto a imagen Wan 2.7 Pro?

Ambas versiones usan los mismos nombres de parámetros. La versión estándar cuesta menos y resulta adecuada para borradores e iteraciones rápidas; Pro busca un resultado más detallado a un precio superior por imagen. Elige Standard para explorar y Pro para crear la imagen principal definitiva.

¿Puedo definir un ancho y un alto personalizados en lugar de usar un ajuste `image_size`?

Esta interfaz utiliza ajustes preestablecidos de tipo string para que la integración predeterminada asigne las entradas de forma fiable. Un objeto {width, height} personalizado puede estar disponible en configuraciones avanzadas o solo mediante API. Confirma la compatibilidad en tu espacio de trabajo de RunComfy antes de usar dimensiones arbitrarias.

Síguenos
  • LinkedIn
  • Facebook
  • Instagram
  • Twitter
Soporte
  • Discord
  • Correo electrónico
  • Estado del sistema
  • afiliado
Modelos de Video
  • Seedance 2.5 Flash Text To Video
  • Seedance 2.5 Flash
  • Seedance 2.5 Flash Reference to Video
  • Wan 3.0
  • MiniMax H3 Fast
  • Wan 2.5
  • Ver todos los modelos →
Modelos de Imagen
  • Seedream 5.5
  • Seedream 5.5 Edit
  • Seedream 5.5 Layer Decomposition
  • Wan 2.6 Image to Image
  • Nano Banana Pro
  • Seedream 5.0 Pro
  • Ver todos los modelos →
Legal
  • Términos de servicio
  • Política de privacidad
  • Política de cookies
RunComfy
Derechos de autor 2026 RunComfy. Todos los derechos reservados.

RunComfy es la principal ComfyUI plataforma, ofreciendo ComfyUI en línea entorno y servicios, junto con flujos de trabajo de ComfyUI con impresionantes imágenes. RunComfy también ofrece AI Models, permitiendo a los artistas aprovechar las últimas herramientas de AI para crear arte increíble.
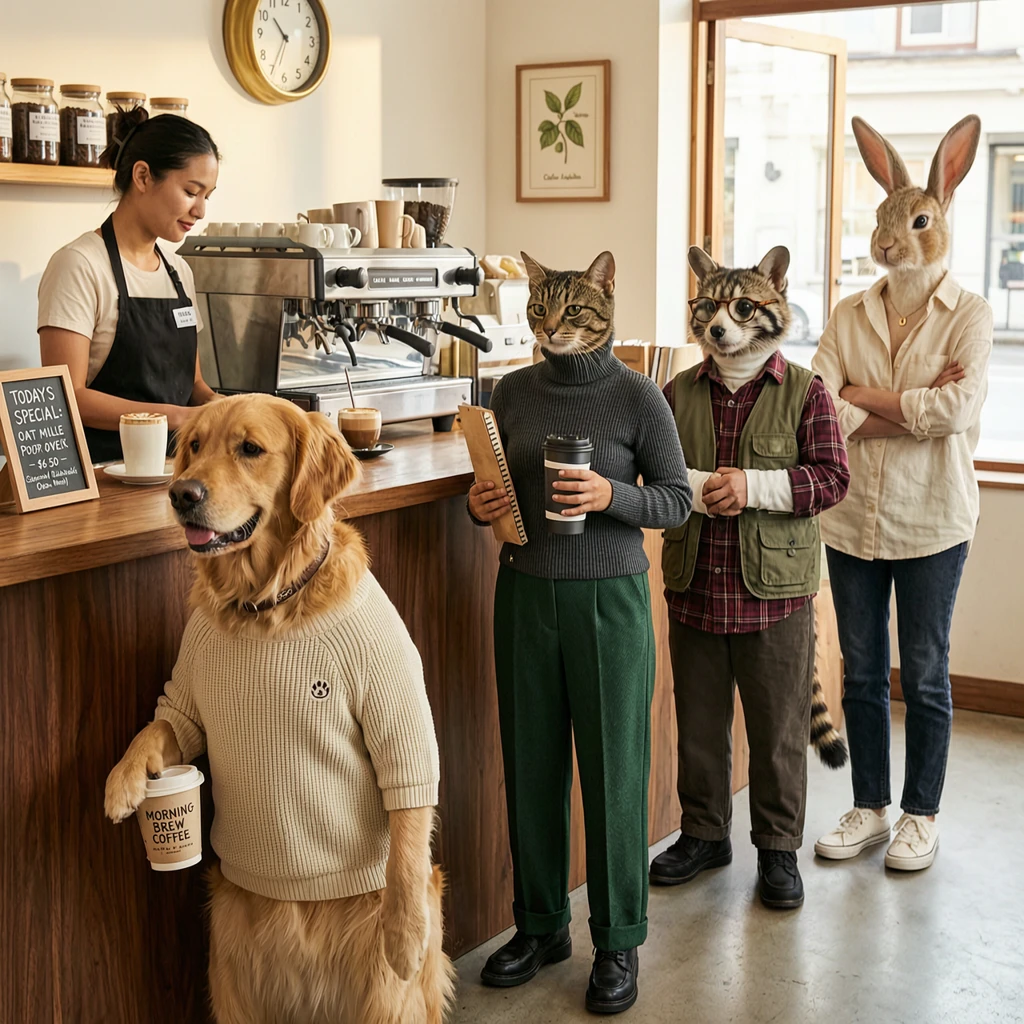
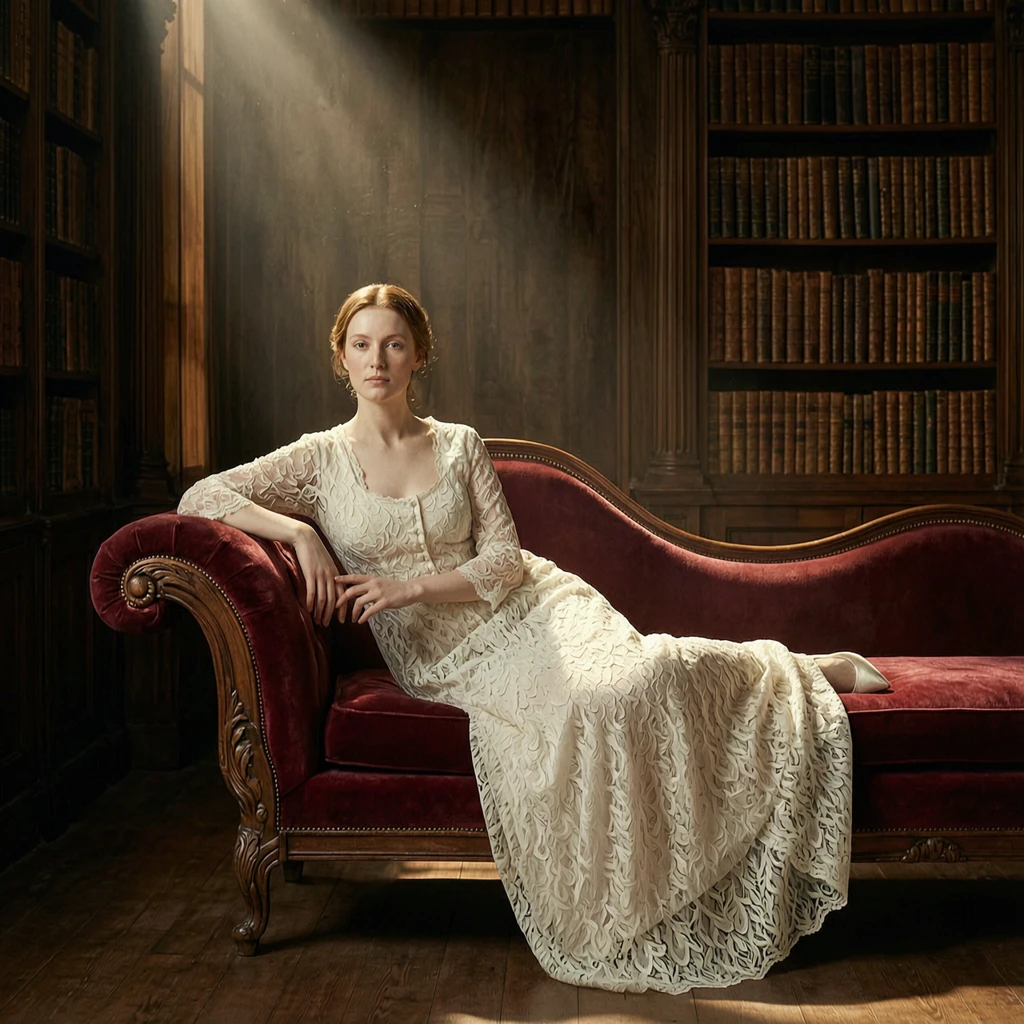
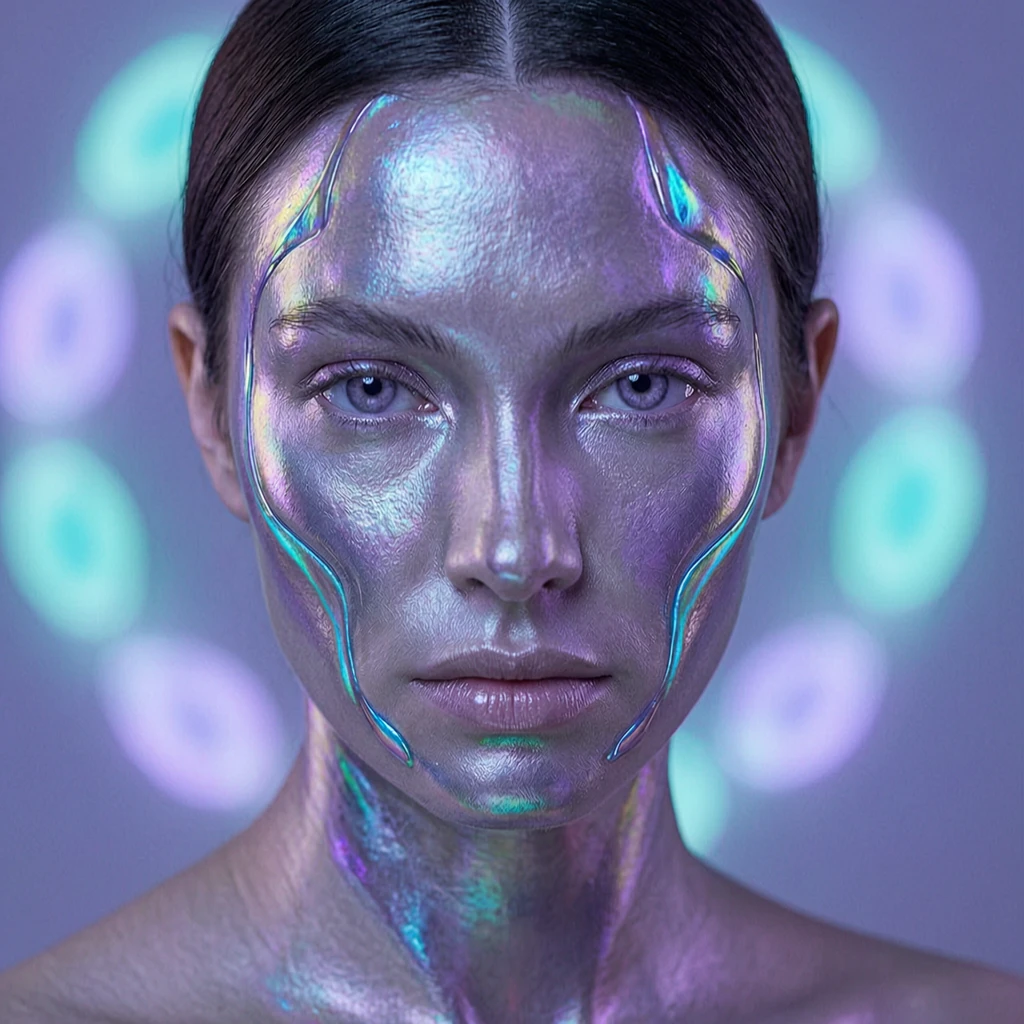
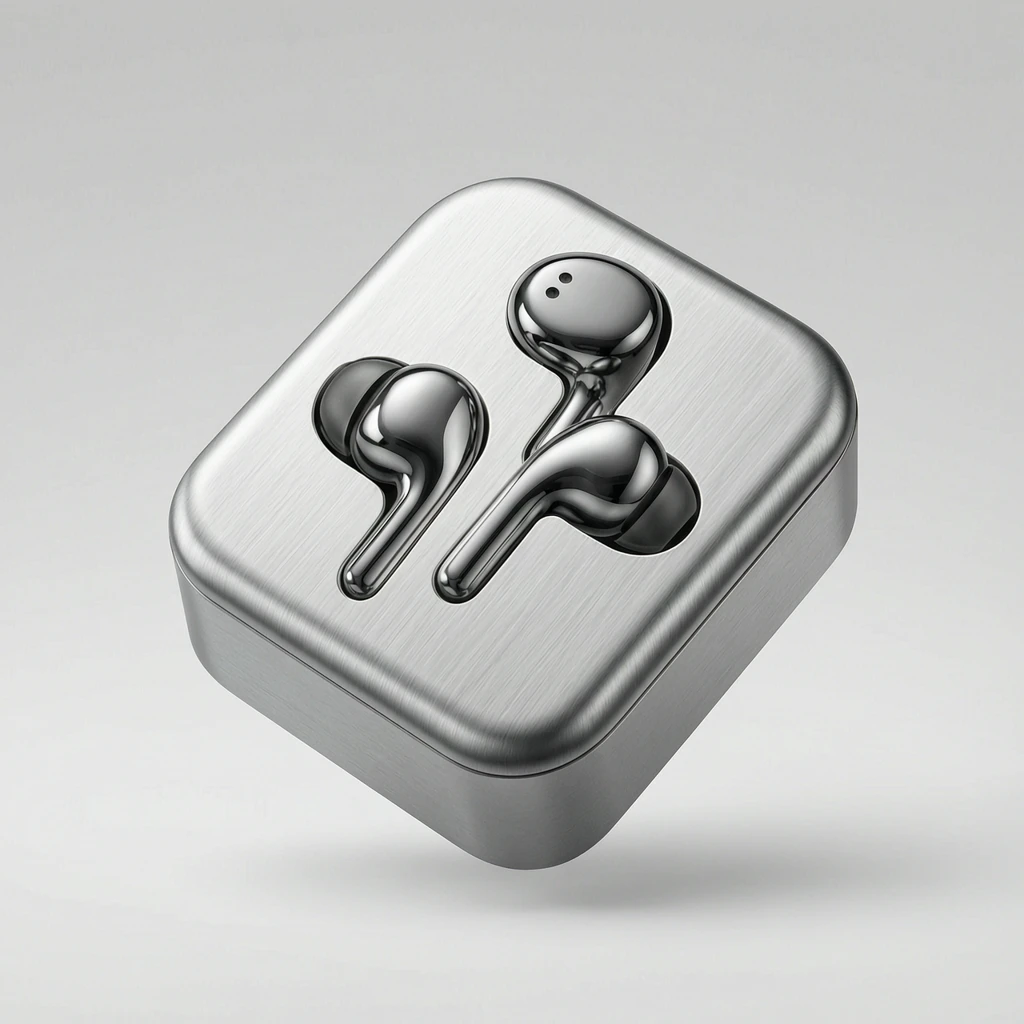
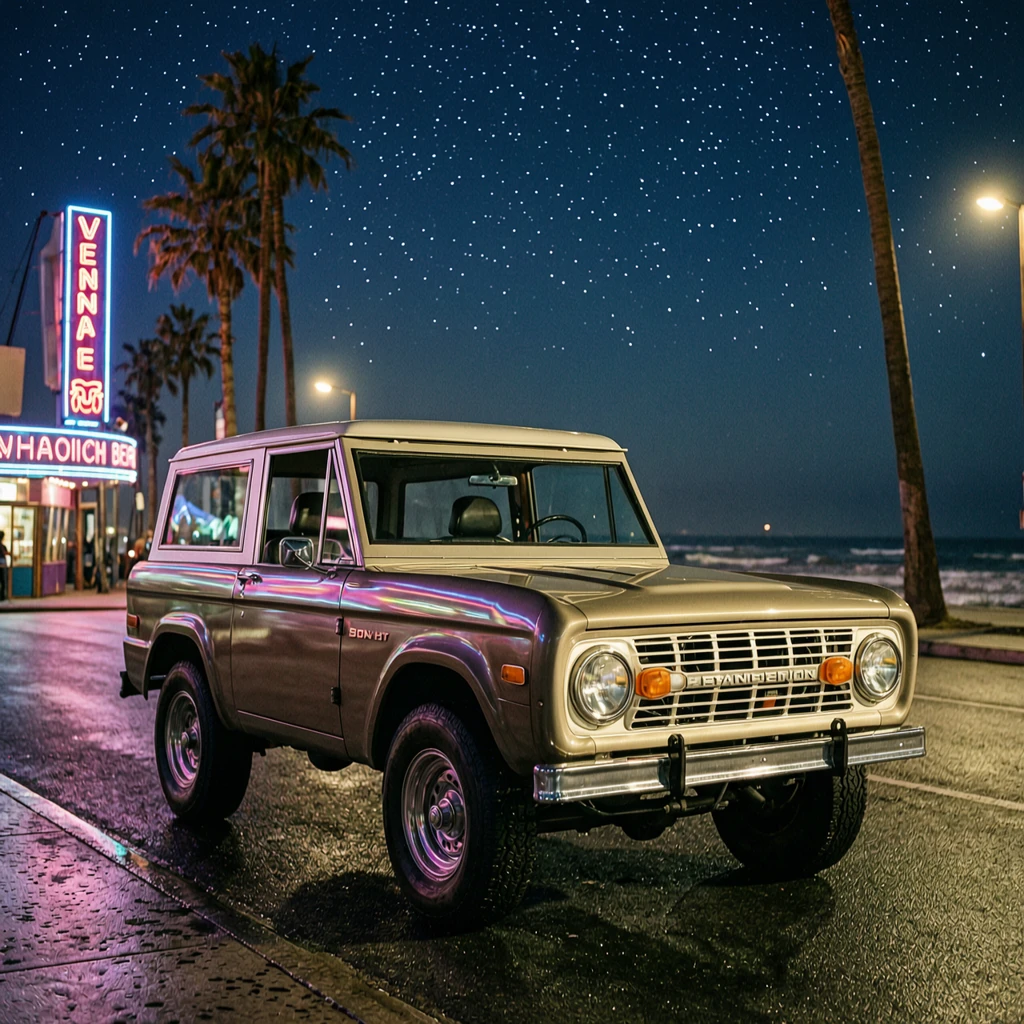
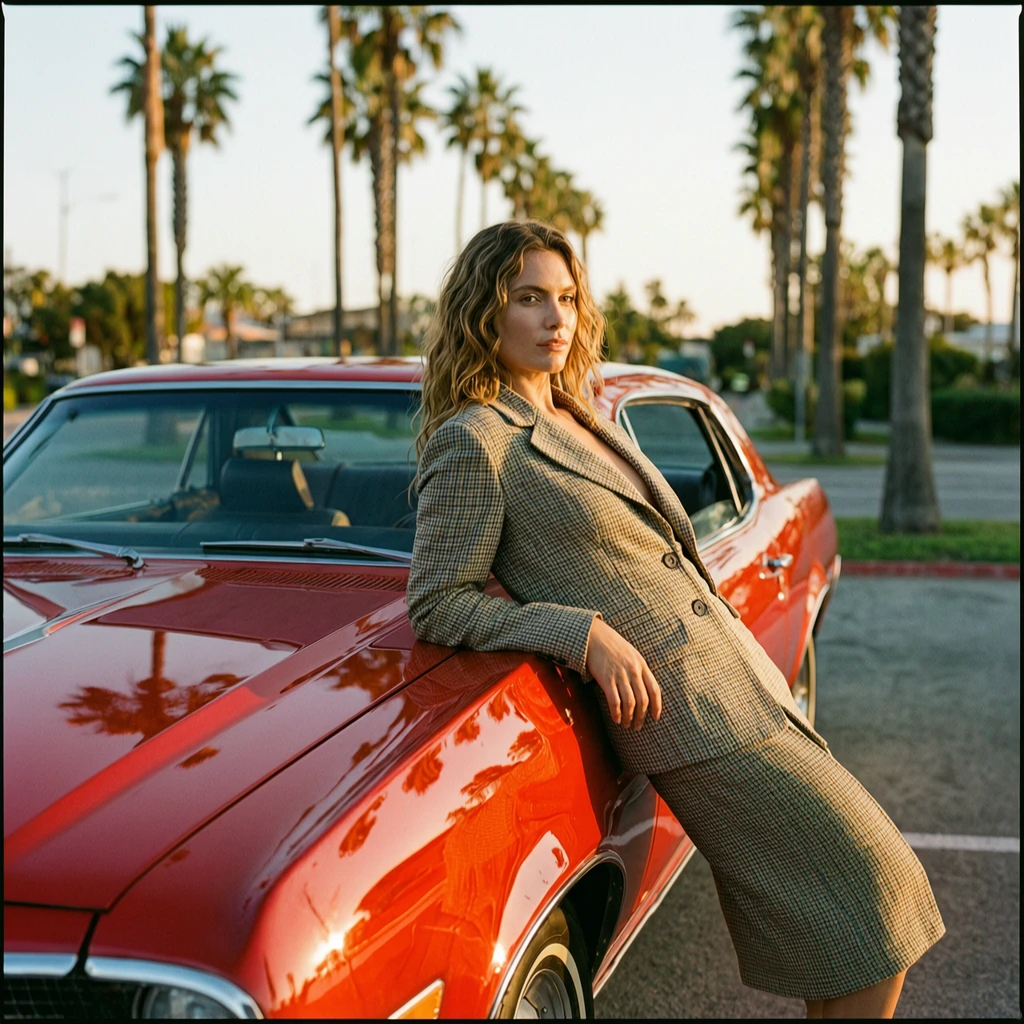
Ejemplos de Wan 2.7 texto a imagen