Qwen Image 2.1 Cambio de Atuendo ComfyUI Workflow#
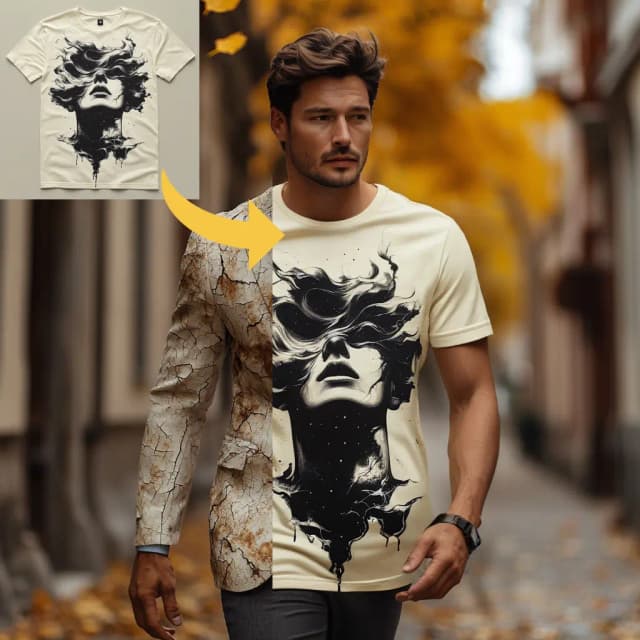
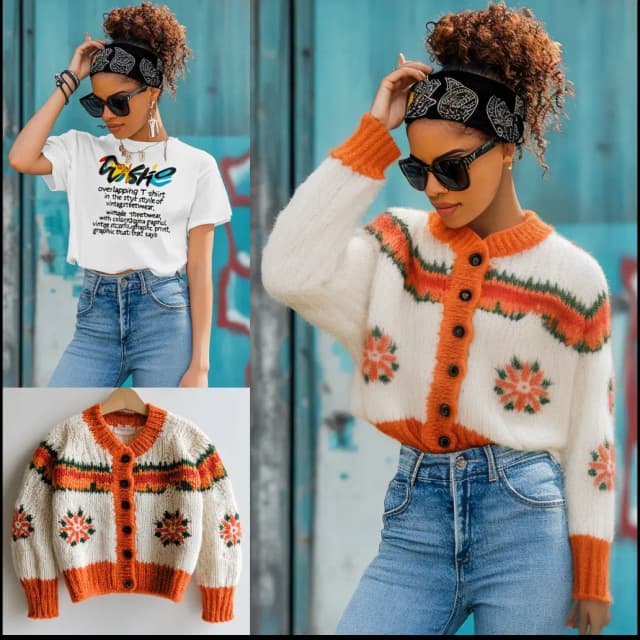
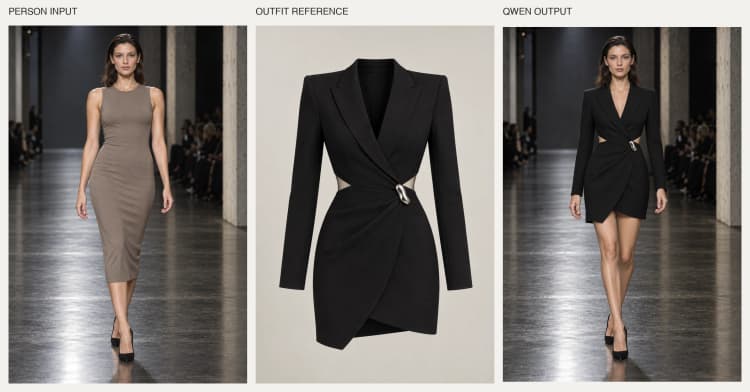
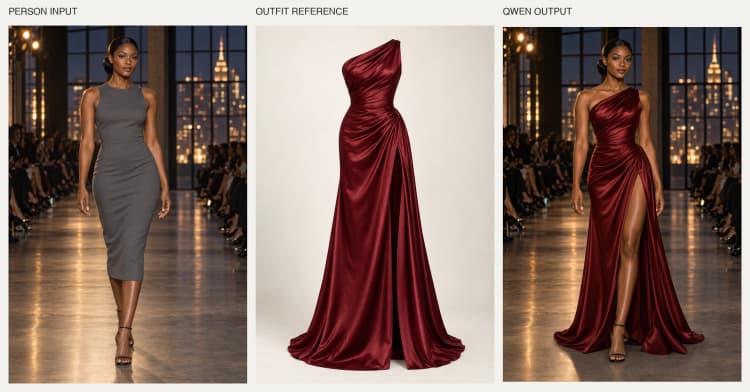
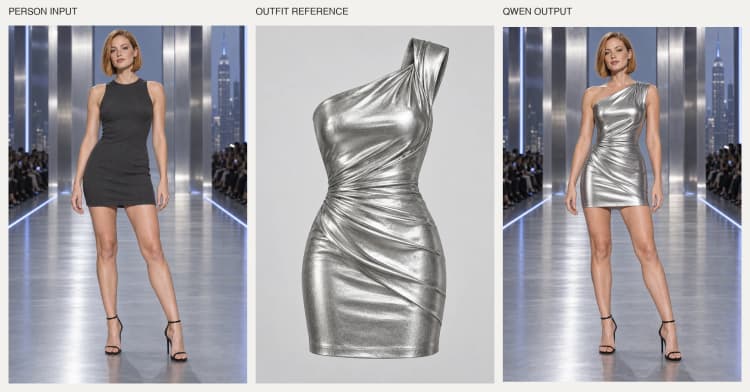
El flujo de trabajo Qwen Image 2.1 Cambio de Atuendo ComfyUI transfiere la ropa de una imagen de referencia de atuendo a una persona de una segunda imagen, guiado por una breve instrucción. Intenta mantener el sujeto, la pose, la cara, el fondo y el encuadre de la cámara de la Imagen 1 mientras toma la silueta, el color y la textura de la Imagen 2, produciendo una sola fotografía realista.
Construido alrededor del modelo unificado Qwen-Image-2.1 con mejora de aviso, este flujo de trabajo está diseñado para estilo virtual, editoriales de moda, maquetas de comercio electrónico y visualización de vestuario. Proporcionas la Imagen 1 (la persona), la Imagen 2 (el atuendo) y un aviso conciso; la tubería maneja el acondicionamiento multimodal, la generación y la decodificación por ti.
Modelos clave en ComfyUI Qwen Image 2.1 Cambio de Atuendo ComfyUI Workflow#
- Qwen-Image-2.1. El modelo unificado de generación de imágenes y lenguaje visual que interpreta tu instrucción junto con ambas imágenes, luego impulsa el proceso de difusión para sintetizar el intercambio de atuendos final. Model card
- Qwen-Image-2.1 VAE. El codificador automático variacional que codifica imágenes a latentes para el acondicionamiento y decodifica la salida del muestreador de nuevo a RGB, preservando el detalle fino del tejido y la fidelidad del color. Los pesos se proporcionan con el paquete ComfyUI. Weights
- Codificadores de texto Qwen-Image-2.1. Los codificadores de texto de la familia Qwen-VL que transforman tu instrucción y contexto visual en un acondicionamiento que la espina dorsal de difusión puede seguir. Incluidos con los pesos de ComfyUI. Weights
Cómo usar ComfyUI Qwen Image 2.1 Cambio de Atuendo ComfyUI Workflow#
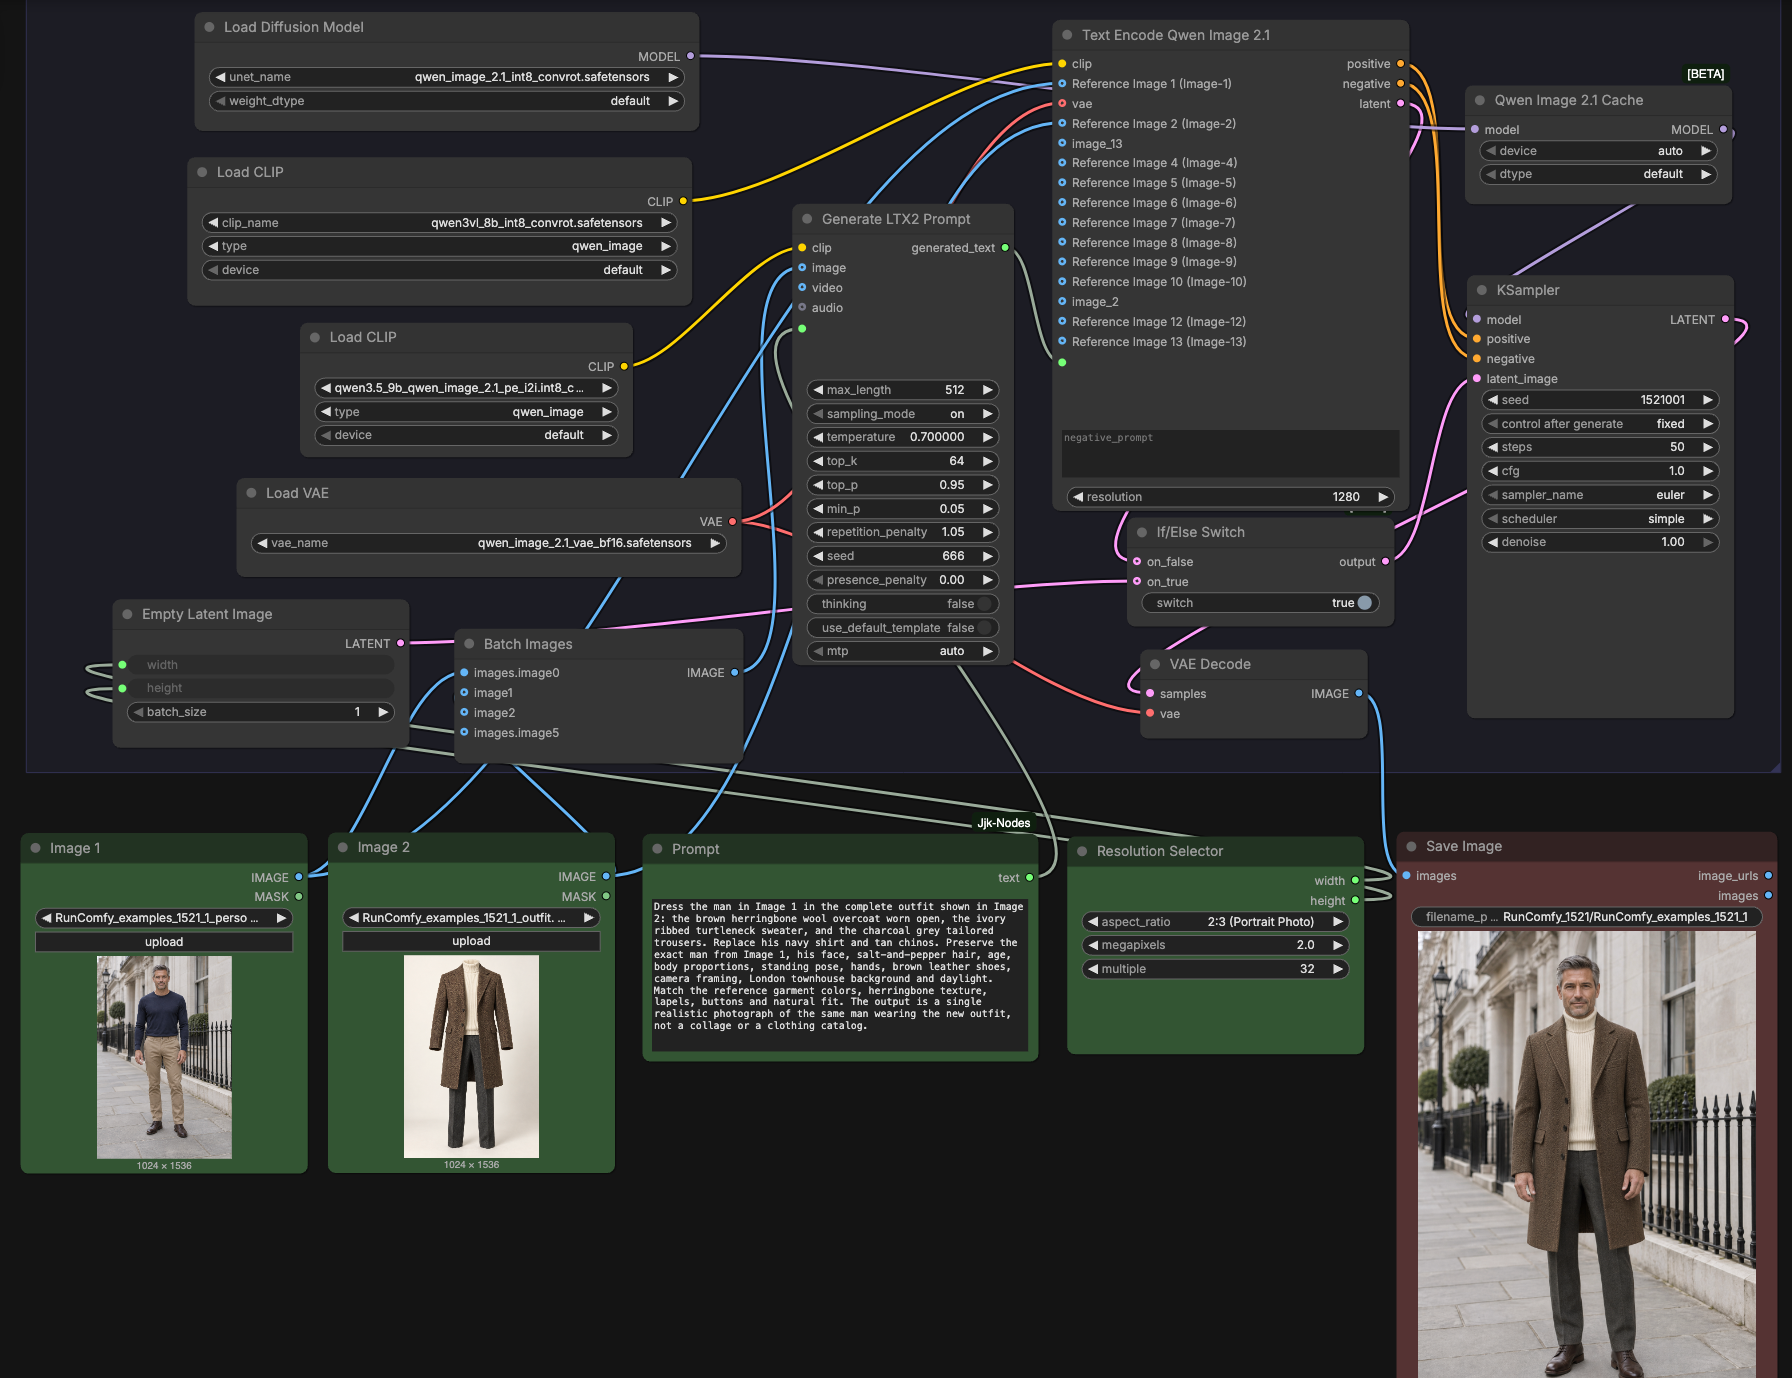
Este flujo de trabajo se ejecuta como un solo grupo que ingiere dos imágenes más una instrucción de texto, enriquece el aviso usando ambos visuales, construye un acondicionamiento multimodal para Qwen-Image-2.1, luego muestrea y decodifica la imagen final.
Grupo de Intercambio de Atuendo Qwen Image 2.1#
Este grupo empareja la Imagen 1 (la persona a restyling) con la Imagen 2 (la referencia de atuendo) y tu instrucción, luego las enruta a través de la mejora de aviso y el acondicionamiento Qwen-Image-2.1. La tubería preserva la identidad y la escena de la Imagen 1 mientras transfiere la silueta de la prenda, el color y las características del tejido de la Imagen 2. Crea el lienzo latente a la resolución que elijas, muestrea con el modelo Qwen-Image-2.1 y decodifica a una imagen lista para guardar. Usa este grupo para un cambio de atuendo de extremo a extremo con una configuración mínima.
LoadImage (#470) Imagen 1#
Carga aquí la foto de la persona fuente. Elige una toma única, bien encuadrada donde el sujeto y la pose que deseas mantener sean claramente visibles. La imagen alimenta tanto al mejorador de aviso como al codificador Qwen-Image-2.1 para que la identidad, la pose y el fondo se preserven durante la generación.
LoadImage (#510) Imagen 2#
Carga aquí la referencia de atuendo. Elige una vista clara de la ropa con silueta y texturas visibles. Esta referencia informa la mejora del aviso y se convierte en parte del acondicionamiento visual del codificador para que el color, el tejido y la estructura de la prenda se transfieran con precisión.
JjkText (#516) Aviso#
Escribe una breve instrucción que le diga al modelo qué intercambiar y qué preservar. Menciona las piezas de la prenda a transferir de la Imagen 2 y declara explícitamente que la identidad, la pose y el fondo de la Imagen 1 deben permanecer. Mantenlo específico y conciso para una adherencia más fuerte.
BatchImagesNode (#505)#
Esta utilidad combina la Imagen 1 y la Imagen 2 para el mejorador de aviso. Asegura que el mejorador vea ambos visuales al reformular tu instrucción, lo que mejora los nombres de las prendas, los términos de color y los descriptores de tejido en el aviso final.
TextGenerateLTX2Prompt (#502)#
Genera una instrucción refinada y amigable para el modelo leyendo ambas imágenes junto con tu texto. El resultado es una única cadena de aviso mejorada que captura los atributos de las prendas, el ajuste y las señales de preservación de la escena. Esta cadena se pasa corriente abajo como la instrucción final.
CLIPLoader (#500) y CLIPLoader (#478)#
Estos nodos cargan los codificadores de texto Qwen-Image-2.1 usados por el mejorador y el codificador principal. Tokenizan tu instrucción refinada y preparan incrustaciones de lenguaje alineadas con las características visuales extraídas de las dos imágenes.
TextEncodeQwenImage21 (#485)#
Construye el acondicionamiento multimodal para Qwen-Image-2.1 desde la Imagen 1, la Imagen 2, el aviso refinado y el VAE. Emite un acondicionamiento positivo y negativo más un latente inicial opcional que puede anclar la composición y el diseño. Este es el corazón de la transferencia de atuendos, alineando el lenguaje y ambas imágenes antes del muestreo.
ResolutionSelector (#13)#
Elige el ancho y la altura de salida para la generación. Selecciona una relación de aspecto que coincida con tu encuadre de destino, luego establece el tamaño general. La selección impulsa el lienzo latente utilizado durante el muestreo.
EmptyLatentImage (#480) y ComfySwitchNode (#483)#
Crea un nuevo lienzo latente a la resolución elegida, y te permite alternar entre comenzar desde este latente en blanco o desde el latente del codificador. Usa el interruptor para favorecer una transferencia de atuendos más fuerte (latente en blanco) o una preservación más estricta de la composición de la Imagen 1 (latente del codificador).
UNETLoader (#477) y QwenImage21Cache (#484)#
Cargan y preparan la espina dorsal de difusión Qwen-Image-2.1 para un muestreo eficiente. La caché mantiene el estado del modelo listo a través de ejecuciones, reduciendo la sobrecarga durante la iteración.
KSampler (#482)#
Ejecuta el proceso de difusión con el modelo Qwen-Image-2.1 y el acondicionamiento producido anteriormente. Interpreta tu instrucción mientras equilibra la adherencia a las prendas de la Imagen 2 y la preservación de la identidad y la escena de la Imagen 1. El resultado es una imagen latente lista para decodificar.
VAEDecode (#481) y SaveImage (#518)#
Decodifica el latente final de nuevo a una imagen RGB con el VAE Qwen-Image-2.1, luego guárdala usando el prefijo de nombre de archivo que elijas. La salida guardada es una sola foto cohesiva del sujeto de la Imagen 1 vestido con el atuendo de la Imagen 2.
Nodos clave en ComfyUI Qwen Image 2.1 Cambio de Atuendo ComfyUI Workflow#
TextEncodeQwenImage21 (#485)#
Este nodo fusiona la Imagen 1, la Imagen 2, tu instrucción refinada y el VAE en un acondicionamiento que la espina dorsal Qwen-Image-2.1 puede seguir. Ajusta el prompt y el negative_prompt opcional para dirigir el detalle de la prenda frente a la preservación de la escena. La entrada resolution determina la escala de trabajo del codificador y debe ser consistente con tu tamaño de salida elegido. Consulta la tarjeta del modelo para el contexto de comportamiento. Qwen/Qwen-Image-2.1
ComfySwitchNode (#483)#
Controla el punto de partida para el muestreo. Deja el switch encendido para comenzar desde un nuevo latente para una adopción de atuendo más fuerte, o apágalo para reutilizar el latente del codificador cuando quieras bloquear la composición o la pose de la Imagen 1. Altera para explorar diferentes compensaciones entre identidad y atuendo sin reescribir tu aviso.
KSampler (#482)#
Gobierna cuán fielmente el modelo sigue la instrucción y las referencias. Usa denoise para equilibrar la fuerza del atuendo contra la preservación de la imagen base, y ajusta cfg, sampler_name, steps y seed para sabor, nitidez y reproducibilidad. Para orientación general sobre el comportamiento del muestreo en ComfyUI, consulta el repositorio del proyecto. ComfyUI
ResolutionSelector (#13)#
Configura tus dimensiones de salida. Empareja la relación de aspecto con el encuadre de tu foto de entrada cuando quieras que el fondo y el recorte permanezcan estables, o cámbialo para recomponer la toma. Los tamaños más grandes capturan más textura de tejido a costa de cálculo.
Extras opcionales#
- Usa entradas de alta calidad: una Imagen 1 nítida y bien iluminada frontalmente y una Imagen 2 clara y sin obstrucciones producen una mejor transferencia de silueta y textura.
- Sé explícito en tu instrucción: nombra piezas de prendas, colores, texturas y lo que debe preservarse de la Imagen 1.
- Para mantener la composición, rostros y fondo casi idénticos a la Imagen 1, cambia al latente del codificador y reduce la agresividad general mediante
denoise. - Para una adopción de estilo más fuerte cuando el atuendo de la Imagen 2 es muy diferente, comienza desde un nuevo latente y mantén el aviso conciso y específico.
- Varía
seedpara explorar alternativas sin cambiar tu configuración, luego bloquea la que te guste para resultados reproducibles.
Enlaces a recursos del modelo
- Tarjeta del modelo Qwen-Image-2.1: https://huggingface.co/Qwen/Qwen-Image-2.1
- Paquete de pesos ComfyUI (UNet, VAE, codificadores de texto): https://huggingface.co/Comfy-Org/Qwen-Image-2.1
Agradecimientos#
Este flujo de trabajo implementa y se basa en los siguientes trabajos y recursos. Agradecemos a Qwen por el modelo y lanzamiento de Qwen-Image-2.1, a Comfy-Org por los pesos ComfyUI Qwen-Image-2.1, y a Wendy Wu por el flujo de trabajo fuente por sus contribuciones y mantenimiento. Para detalles autorizados, por favor consulta la documentación original y los repositorios enlazados a continuación.
Recursos#
- Wendy Wu/flujo de trabajo fuente
- Documentación / Notas de lanzamiento: runninghub.ai post
- Qwen/Qwen-Image-2.1
- GitHub: QwenLM/Qwen-Image-2.1
- Hugging Face: Qwen/Qwen-Image-2.1
- Comfy-Org/pesos ComfyUI Qwen-Image-2.1
- GitHub: Comfy-Org/workflow_templates
- Hugging Face: Comfy-Org/Qwen-Image-2.1
- Qwen/Qwen-Image-2.1 lanzamiento
- Documentación / Notas de lanzamiento: Qwen blog
Nota: El uso de los modelos, conjuntos de datos y código referenciados está sujeto a las licencias y términos respectivos proporcionados por sus autores y mantenedores.