logo
RunComfy
  • ComfyUI
  • Trainer
  • Modelle
  • MCPNeu
  • Preise
  • Seedance 2.5Hot
  • Seedream 5.5Neu

Workflows nach Modell

HotMiniMax H3Video mit Audio aus Text, Bildern oder ReferenzenHotQwen Image 2.1Bilder erstellen und Fotos mit Referenzen bearbeitenWanVideo aus Text oder Bildern, BewegungsübertragungFLUXBilderzeugung, Bearbeitung und CharaktervariantenLTXVideo mit synchronem Audio aus Text oder BildernQwen Image EditFotobearbeitung mit Text- und BildreferenzenKrea 2Bilderzeugung, Stiltransfer und ReferenzbearbeitungZ-ImageSchnelle Porträts und Konzepte aus Text

Beliebte & neue Workflows

NeuMiniMax H3 Character Swap V1.5Videofiguren tauschen, Originalton behaltenNeuP-H3-Image Reference EditFoto anhand eines Referenzbilds bearbeitenHotMiniMax H3 Image-to-VideoEin Bild zu Kinovideo mit synchronem AudioHotLTX 2.5 Image-to-VideoEin Frame zu scharfem Video mit synchronem AudioHotMiniMax H3 Character Swap (SAM3)Videofiguren tauschen, Bewegung beibehaltenQwen Image 2.1 Multi-Image EditingPräzise Szenen aus bis zu 10 ReferenzbildernFLUX Klein Face SwapNatürlicher, lebensechter GesichtstauschSeedVR2 Video UpscalerScharfes, flüssiges Video-Upscaling
Weitere Workflows ansehen

Modell trainieren

NeuMOSS-Image BaseBilderzeugung, neu unterstütztNeuFLUX.3 KleinBilderzeugung, neu unterstütztHotKrea 2Das meisttrainierte BildmodellHotKrea 2 TurboBilderzeugung mit wenigen SchrittenHotQwen Image 2.1Bilderzeugung und -bearbeitungZ-Image TurboSchnelle Porträts und KonzeptbilderMiniMax H3Video mit synchronem Audio

Trainieren & Bereitstellen

Erste SchritteIhr erster Trainingsjob mit Ostris AI ToolkitDatensätzeTrainingsdatensätze hochladen und verwaltenInferenzTrainierte Modelle im Playground oder per API nutzenBereitstellungenTrainierte Modelle als dedizierte Endpunkte bereitstellen
Weitere Modelle trainieren

Bildmodelle

NeuGPT Image 2.65 % Rabatt · Detailliertes Text-zu-Bild, GIF und SVG, bis 4KNeuSeedream 5.510 % Rabatt · Text-zu-Bild bis 2K, mit transparenten PNGsNeuMiniMax H3 Image10 % Rabatt · Text oder Referenzen zu einem Standbild bis 4KNeuFLUX 3 Image Klein10 % Rabatt · Text oder Referenzen zu einem Standbild von 768 bis 4KHotSeedream 5.0 Pro41 % Rabatt · Referenzbasierte Bearbeitung mit mehrsprachigem TextHotSeedream 4.520 % Rabatt · Fotorealistische Bearbeitung mit MarkenkonsistenzHotWan 2.6 ImageBildbearbeitung per AnweisungNano Banana Pro77 % Rabatt · Präzise 2K- bis 4K-Bilder aus Skizzen

Videomodelle

NeuSeedance 2.5 Flash34 % Rabatt · Text, image, or reference to videoNeuKling 4.010 % Rabatt · Standbild zu einem 3- bis 30-s-Clip animierenHotWan 3.0 Prime13 % Rabatt · Schnelle Clips aus ReferenzvideosHotSeedance 2.536 % Rabatt · Längere, konsistentere KinovideosHotWan 3.0Clips aus Bild-, Video- und AudioreferenzenHotMiniMax H3Ersten Frame zu einem 5- bis 15-s-Clip animierenWan 2.510 % Rabatt · Flüssige Bewegung mit nativem AudioFLUX 3 MaxClips aus Text, Standbild oder Keyframes
Weitere Modelle ansehen

API

Serverless (ComfyUI)ComfyUI-Workflows als serverlose Endpunkte bereitstellen.Serverless (LoRA)LoRAs als serverlose Endpunkte bereitstellen.Model APIGehostete Modelle bei Bedarf ohne Deployment ausführen.Trainer APILoRAs per API trainieren, verwalten und abrufen.CLIRun RunComfy models from your terminal.
MODELLE
Erkunden
Alle Modelle
BIBLIOTHEK
Generierungen
MODELL-APIS
API-Dokumentation
API-Schlüssel
KONTO
Nutzung

Qwen Image 2512: Hochwertige Text-zu-Bild-Generierung in wenigen Sekunden | RunComfy

qwen/qwen-image/qwen-image-2512

Erzeugen Sie produktionsreife Bilder mit realistischen Materialien, sauberer chinesischer und englischer Schrift sowie festen Seitenverhältnissen.

Beschreibt Elemente, die im erzeugten Bild nicht erscheinen sollen.
Anzahl der auszuführenden Inferenzschritte.
Stärke, mit der der Prompt die Bilderzeugung steuert.
Dateiformat des erzeugten Bildes.
Idle
The rate is $0.022 per image.

Einführung in Qwen Image 2512

Alibabas Qwen Image 2512 verwandelt Text-Prompts für $0.022 pro Bild in produktionsreife Grafiken. Das Modell nutzt feste, auf Qualität optimierte Seitenverhältnisse und rendert chinesischen wie englischen Text besonders zuverlässig. Dadurch sinkt der Aufwand für manuelles Kerning, komplexe Masken und aufwendige Porträtretusche, während Übergaben und Freigaben in E-Commerce-, Design- und Marketingteams schneller werden. Auf RunComfy lässt sich Qwen Image 2512 im Browser oder per HTTP-API nutzen, ohne dass Sie das Modell selbst hosten oder skalieren müssen.

Ideal für: Mehrsprachige Poster und Präsentationen | Fotorealistische Porträtkampagnen | Produktdetailseiten

Alibaba / Qwen Image 2512#


Qwen Image 2512 ist ein auf RunComfy verfügbares Text-zu-Bild-Modell, das aus einem prompt und einem optionalen negative_prompt ein einzelnes hochwertiges Standbild erzeugt. Es eignet sich für Kreativdesign, Marketinggrafiken, Poster mit eingebettetem Text und fotorealistische Szenen.


Ausgabeformate: square_hd, square, portrait_4_3, portrait_16_9, landscape_4_3, landscape_16_9


Highlights#


  • Starke zweisprachige Textwiedergabe: mehrzeiliger chinesischer und englischer Text erscheint häufig sauberer und lesbarer.
  • Realistischere Menschen: Gesichter, Haare und Haut wirken weniger künstlich und detailreicher.
  • Layouttreue: Posteraufbau, Raster und typografische Ausrichtung bleiben konsistenter.
  • Sehr schnelle Generierung: Ein hochwertiges Bild entsteht in etwa 5 Sekunden.

Parameter#


ParameterErforderlichTypeDefaultRange / OptionsBeschreibung
prompt*Ja (*)string——Prompt, aus dem das Bild erzeugt wird.
negative_promptNeinstring""—Optionale Begriffe für Inhalte, die abgeschwächt oder vermieden werden sollen.
image_sizeNeinImageSizeEnum or objectlandscape_4_3Enum: square_hd, square, portrait_4_3, portrait_16_9, landscape_4_3, landscape_16_9.
num_inference_stepsNeininteger28—Anzahl der Inferenzschritte; höhere Werte können mehr Details liefern, benötigen aber mehr Zeit.
guidance_scaleNeinfloat5—Stärke der Prompt-Bindung; mittlere Werte bieten meist ein gutes Verhältnis von Präzision und Kreativität.
seedNeininteger——Fester Seed für reproduzierbare Ergebnisse mit identischen Einstellungen.
output_formatNeinOutputFormatEnum"png"jpeg, png, webpDateiformat des erzeugten Bildes.

Verwendung#


  1. Prompt eingeben: Beschreiben Sie Motiv, Umgebung, Kameraansicht, Licht und den Text, der im Bild erscheinen soll.
  2. negative_prompt ergänzen (optional): Nennen Sie Artefakte, unerwünschte Objekte oder Stile, die vermieden werden sollen.
  3. image_size wählen: Nutzen Sie das passende feste Seitenverhältnis für den gewünschten Bildausschnitt.
  4. num_inference_steps einstellen: Beginnen Sie mit 28 und erhöhen Sie den Wert leicht, wenn mehr Details nötig sind.
  5. guidance_scale abstimmen: Ein Wert um 5 ist ausgewogen; erhöhen Sie ihn vorsichtig, wenn das Ergebnis vom prompt abweicht.
  6. seed für Vergleiche fixieren: Verwenden Sie denselben Wert, um kleine Prompt- oder Parameteränderungen fair zu vergleichen.
  7. output_format wählen: PNG für verlustfreie Grafiken, JPEG für kleinere Dateien oder WEBP als moderne Zwischenlösung.
  8. Generieren und prüfen: Erstellen Sie das Bild, kontrollieren Sie das Ergebnis und verfeinern Sie es mit kleinen Anpassungen.

Eingabeaufforderung und Referenztipps#


  • Seien Sie wörtlich, wenn Sie eingebetteten Text benötigen. Setzen Sie genaue Zeichenfolgen in Anführungszeichen, damit sie als Kopie und nicht als Stil behandelt werden.
  • Fügen Sie Layout-Anleitungen hinzu (z. B. „Titel oben links, Bildunterschrift unten“), damit Elemente vorhersehbar platziert werden können.
  • Geben Sie Kamera- und Objektivbedingungen für eine konsistente Komposition an (z. B. 50 mm, flacher DOF, Aufnahme über Kopf).
  • Verwenden Sie einen kurzen Stilstapel (z. B. „redaktionell, matt, diffuses Licht“), um Qwen Image 2512 fokussiert zu halten.
  • Verwenden Sie einfache Einheiten und gebräuchliche Farbnamen; klaren Beschreibungen folgt das Modell zuverlässiger.

– Iterieren Sie mit einem festen Seed, um Änderungen an Schrittzahl und Guidance in Qwen Image 2512 ohne zufällige Drift zu vergleichen.

– Fügen Sie eine sanfte Negativaufforderung hinzu (z. B. „verschwommen, Wasserzeichen, zusätzliche Finger“), wenn Qwen Image 2512 kleinere Artefakte aufweist.


Vergleich von Qwen Image 2512 mit anderen Modellen#


  • Im Vergleich zu früheren Qwen-Image-Versionen bietet es realistischere menschliche Merkmale, eine stärkere Wiedergabetreue zweisprachiger Texte und extrem schnelle Generierungsgeschwindigkeiten basierend auf Community-Berichten.
  • Wichtige Verbesserungen: Qwen Image 2512 verbessert allgemein die natürlichen Texturdetails, verbessert die Layoutgenauigkeit für Poster/Folien und verfeinert die sofortige Haftung, ohne dass eine extreme Anleitung erforderlich ist.
  • Idealer Anwendungsfall: Wählen Sie es, wenn Sie saubere In-Bild-Typografie und lebensechte Porträts in einem Arbeitsablauf kombinieren möchten.
  • Im Vergleich zu Flux 2 wird Qwen Image 2512 normalerweise wegen der Klarheit eingebetteter Texte und des menschlichen Realismus bevorzugt, während Flux 2 eine größere Stilvielfalt und flexible Auflösungen bietet.

Weitere Modelle zum Ausprobieren#


  • Qwen-Image-Edit-2511
  • Qwen-Image-Edit-2509

Offizielle Ressourcen#


  • GitHub (Qwen-Organisation): https://github.com/QwenLM
  • Hugging Face (Qwen-Organisation): https://huggingface.co/Qwen

Verwandte Modelle

qwen-edit-2509/lora/relight

Beleuchten Sie ein Quellbild anhand eines Pflicht-Prompts neu oder bearbeiten Sie es. Einstellbar sind sechs Ausgabegrößen, Inferenzschritte, Guidance-Skala, 1 bis 4 Ergebnisse, Seed sowie JPEG- oder PNG-Ausgabe.

minimax-h3-image/edit

Bearbeiten Sie 1 bis 16 Referenzbilder in einem Standbild 1K, 2K oder 4K.

flux-2-klein/9b/text-to-image

Hochpräzise 4-stufige Text-zu-Bild-Umwandlung mit gestochen scharfer Textwiedergabe

stepx-edit2

Bearbeiten Sie ein Quellbild per Textanweisung – mit optionalem negativem Prompt, Seed, Denk- und Reflexionsmodus sowie JPEG- oder PNG-Ausgabe.

flux-3/text-to-image

FLUX 3 Image ist ein multimodales Bildmodell mit Referenzsteuerung und gut lesbarer Textdarstellung

flux-2/lora/edit

Bearbeiten Sie bis zu drei Bilder mit bis zu drei LoRAs und präzisen Einstellungen für Guidance-Skala, Inferenzschritte, Größenvorgabe, Seed und Ausgabeformat.

Häufig gestellte Fragen

Wie wechsle ich vom Testen im RunComfy Modellseite zur Produktion mit der Qwen Image 2512 API?

Nach dem Test im RunComfy Modellseite können Entwickler dieselbe Modellkonfiguration über die RunComfy API verwenden. Dafür erstellen sie einen API-Schlüssel, setzen die Generierungsparameter im Code, überwachen Nutzung und Kosten und beachten bei der Produktion mit Qwen Image 2512 die Apache-2.0-Bedingungen.

Wie geht Qwen Image 2512 mit mehrsprachigem Text und Typografie in den generierten Bildern um?

Qwen Image 2512 verarbeitet sowohl chinesischen als auch englischen Text mit hoher Präzision und unterstützt mehrzeilige Absätze und Poster in verschiedenen Sprachen. Die Schulung integriert das Layout-Verständnis und ermöglicht es Entwicklern und Designern, auch bei komplexen Designs eine klare Schriftausrichtung und minimale Verzerrung beizubehalten.

Warum wird Qwen Image 2512 für Menschenporträts und textlastige Szenen bevorzugt?

Qwen Image 2512 zeichnet sich durch die Wiedergabe von Hauttonvariationen, Haardetails und ausdrucksstarken Körperhaltungen aus und sorgt gleichzeitig für sauberen, lesbaren eingebetteten Text. Diese Stärken machen es ideal für Zeitschriftencover, Anzeigen und Infografiken, die sowohl Realismus als auch exakte Typografie erfordern.

Wie unterscheidet sich Qwen Image 2512 von Mitbewerbern wie Nano Banana Pro oder Flux 2 in der Textwiedergabe und dem Realismus?

Im Gegensatz zu einigen Konkurrenten, die sich hauptsächlich auf fotorealistischen Stil oder die Ausgabe in 4K-Auflösung konzentrieren, legt Qwen Image 2512 Wert auf eine originalgetreue Textwiedergabe und ausgewogene natürliche Texturen. Darüber hinaus verfügt es über eine schnelle Generierungsgeschwindigkeit. Benchmark-Ergebnisse zeigen, dass die Layoutausrichtung für zweisprachige Inhalte vergleichbare Open-Source-Alternativen übertrifft.

Welche Arten von Projekten profitieren am meisten von der Integration von Qwen Image 2512 in ihre kreative Pipeline?

Qwen Image 2512 ist optimal für Agenturen, Pädagogen und Verlage, die hochwertige, mehrsprachige Infografiken, Poster und Anzeigenvisualisierungen suchen. Es bietet eine Mischung aus professionellem Bildrealismus und generativer Flexibilität und eignet sich daher sowohl für das Prototypendesign als auch für die skalierte Produktion.

Folge uns
  • LinkedIn
  • Facebook
  • Instagram
  • Twitter
Support
  • Discord
  • E-Mail
  • Systemstatus
  • Partner
Videomodelle
  • Seedance 2.5 Flash Text To Video
  • Seedance 2.5 Flash
  • Seedance 2.5 Flash Reference to Video
  • Wan 3.0
  • MiniMax H3 Fast
  • Wan 2.5
  • Alle Modelle anzeigen →
Bildmodelle
  • Seedream 5.5
  • Seedream 5.5 Edit
  • Seedream 5.5 Layer Decomposition
  • Wan 2.6 Image to Image
  • Nano Banana Pro
  • Seedream 5.0 Pro
  • Alle Modelle anzeigen →
Rechtliches
  • Nutzungsbedingungen
  • Datenschutzrichtlinie
  • Cookie-Richtlinie
RunComfy
Urheberrecht 2026 RunComfy. Alle Rechte vorbehalten.

RunComfy ist die führende ComfyUI Plattform, die ComfyUI online Umgebung und Services bietet, zusammen mit ComfyUI Workflows mit atemberaubenden Visualisierungen. RunComfy bietet auch AI Models, Künstlern ermöglichen, die neuesten AI-Tools zu nutzen, um unglaubliche Kunst zu schaffen.
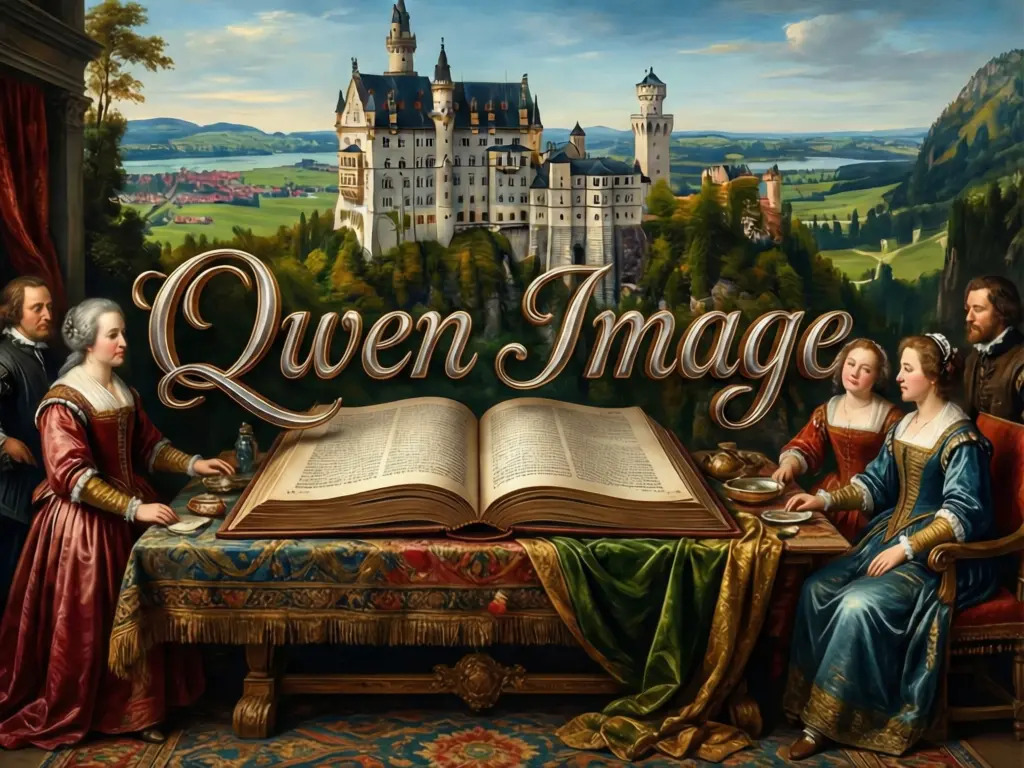
Beispiele für Qwen Image 2512