

P-H3-Image ComfyUI Workflow: 8 MP Text zu Bild in acht Schritten#
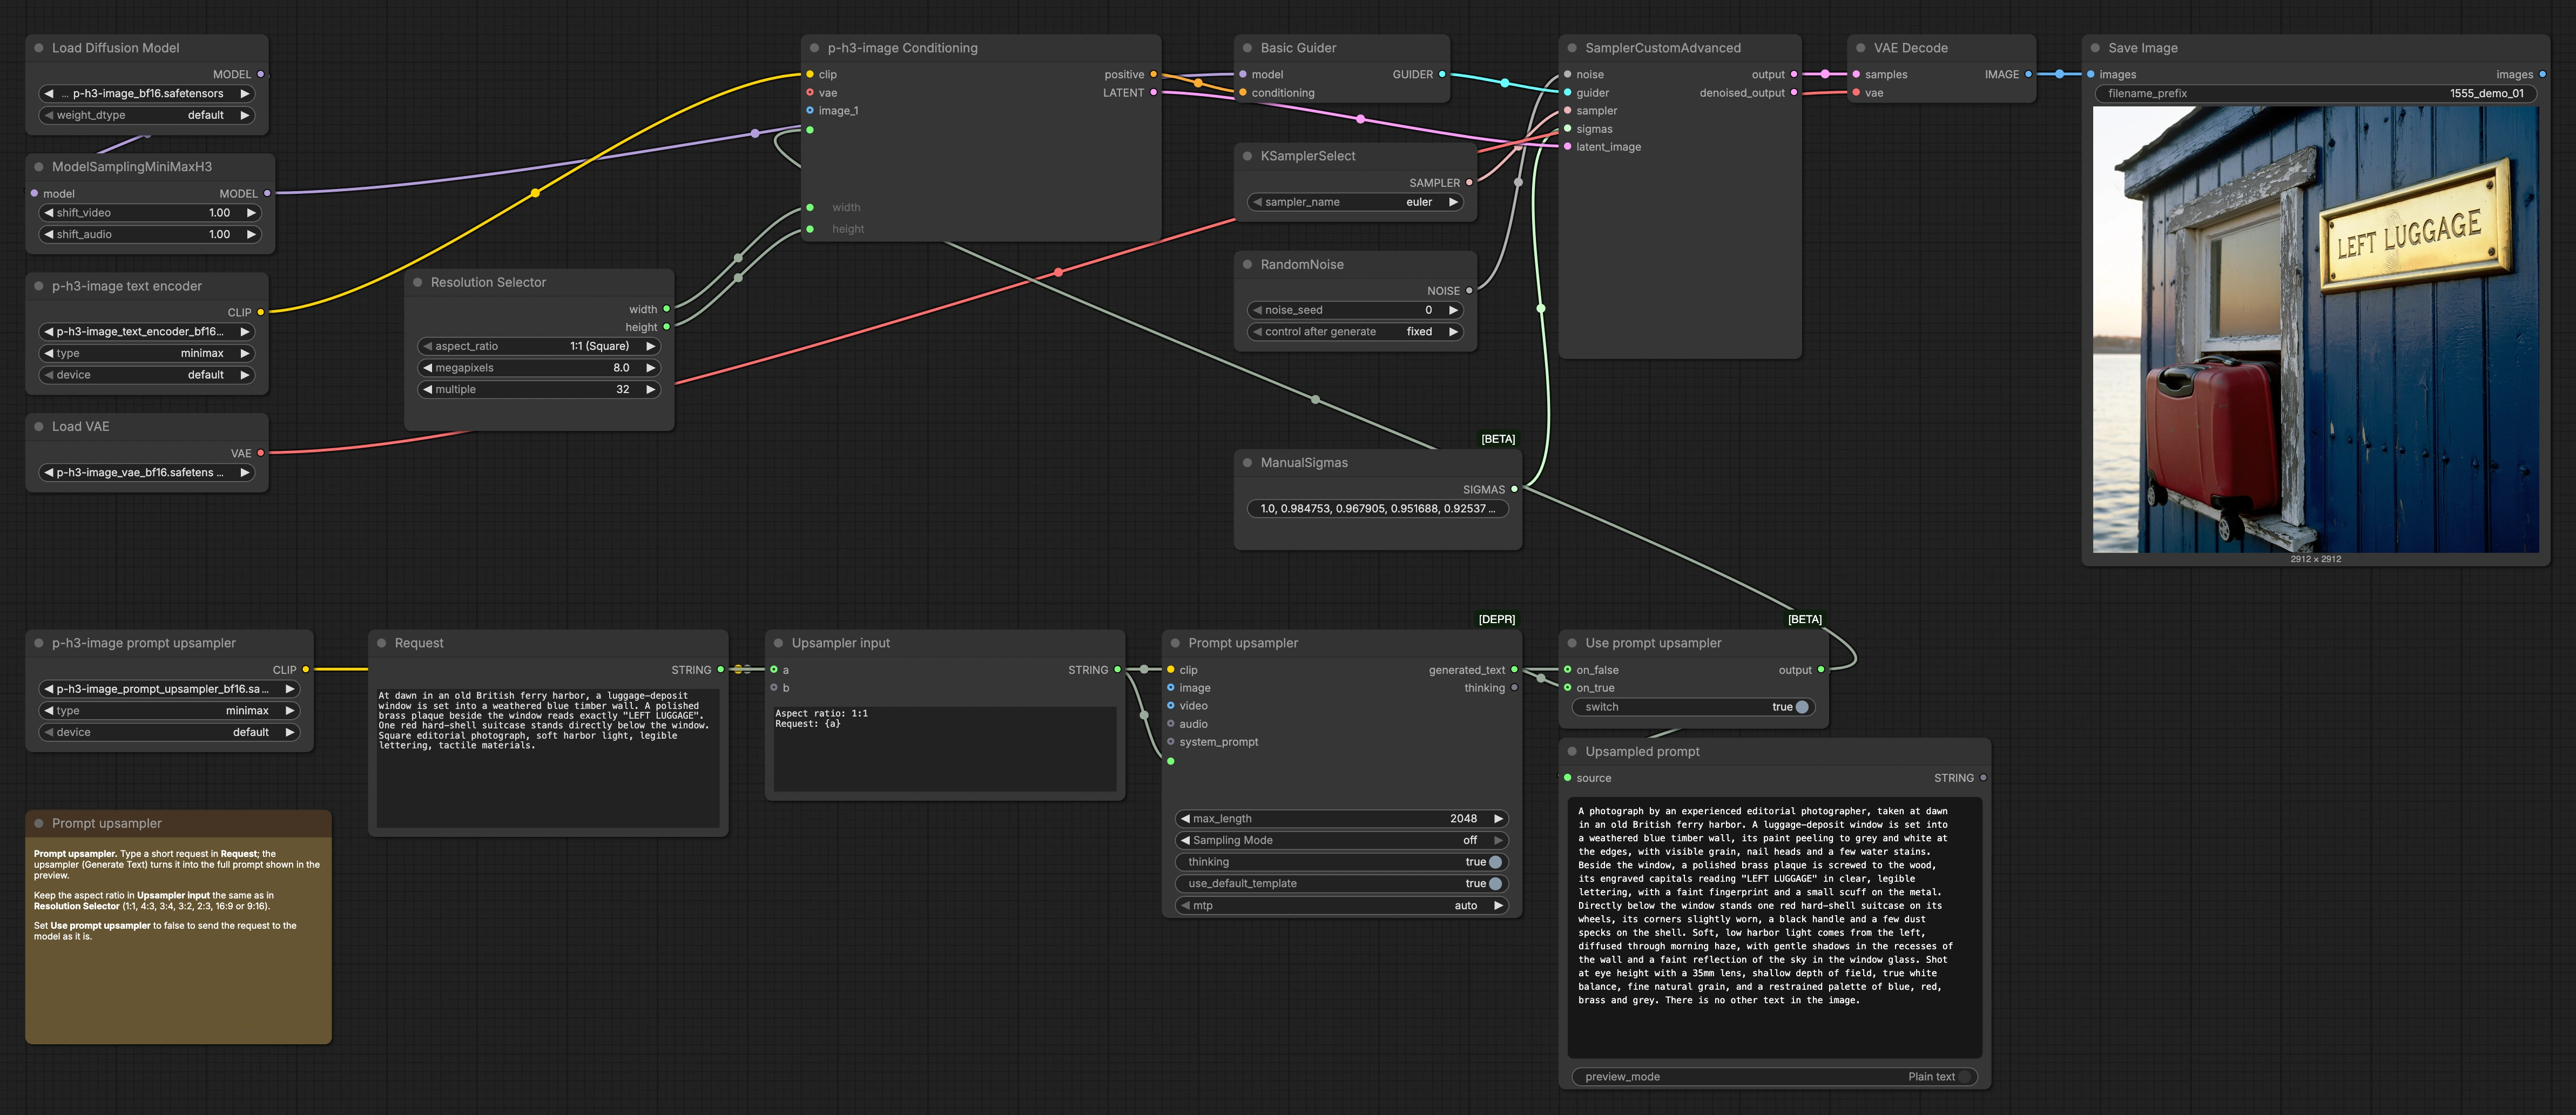
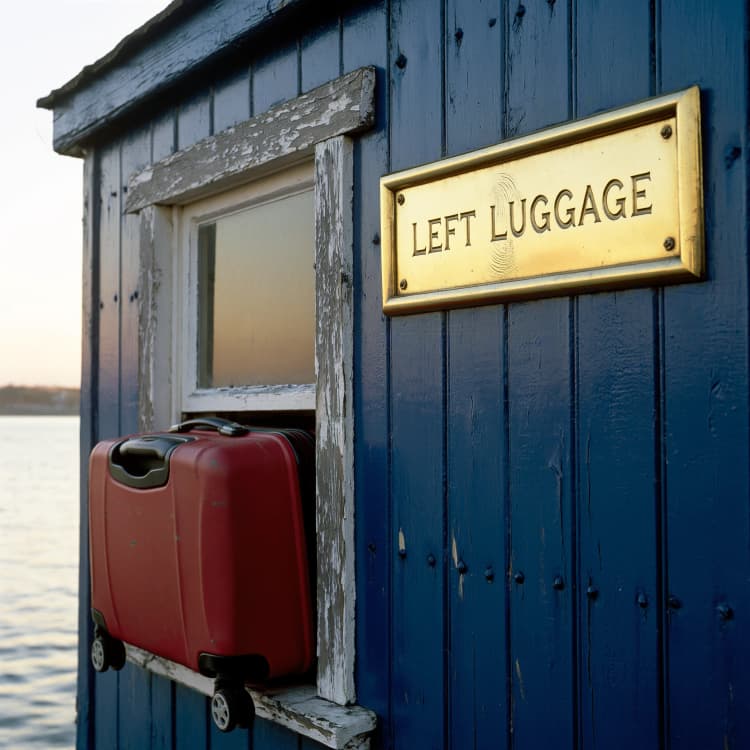
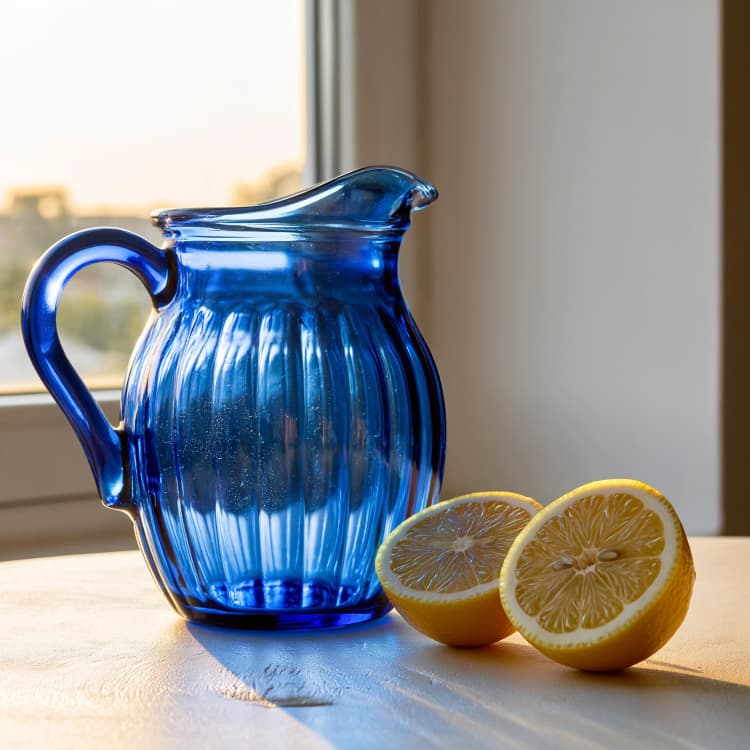
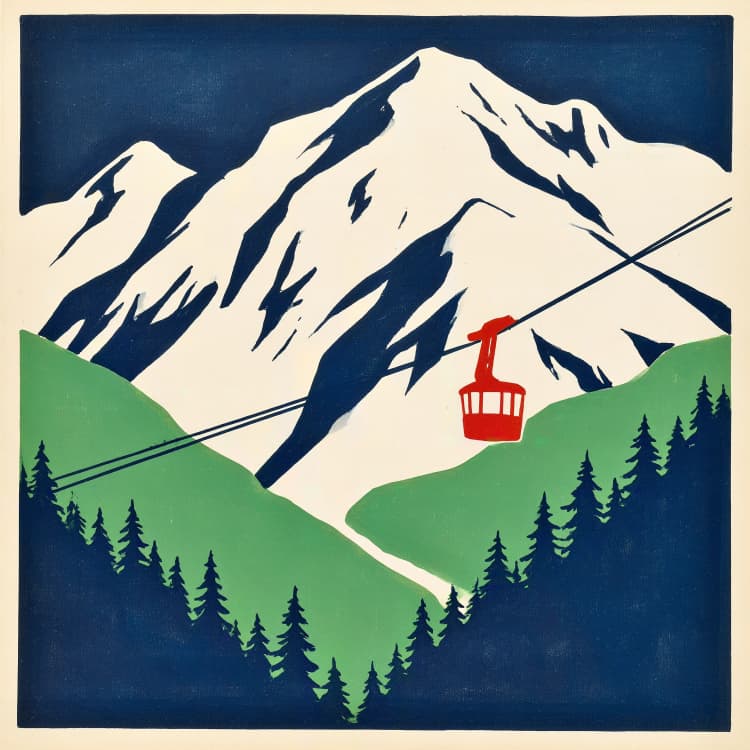
Dieser P-H3-Image ComfyUI Workflow verwandelt eine kurze Szenenbeschreibung in ein hochwertiges 8-Megapixel-Bild in nur acht Abtastschritten. Es enthält einen optionalen Eingabeaufforderungs-Upsampler, der Ihre Anfrage in eine vollere, stilbewusste Eingabeaufforderung erweitert und Ihnen den endgültigen Text vor dem Rendering zeigt.
Verwenden Sie es, wenn Sie schnelle, große Bilder mit sauberer Komposition und konsistenten Details wünschen. Sie können die automatische Erweiterung für Komfort eingeschaltet lassen oder sie ausschalten, um Ihre eigene Formulierung direkt an das Modell zu senden. Der Workflow speichert Bilder mit einem vorhersehbaren Dateinamenpräfix, sodass Chargen organisiert bleiben.
Wichtige Modelle im Comfyui P-H3-Image ComfyUI Workflow#
- P-H3-Image UNet (bf16). Das Diffusions-Backbone, das latente Bilder entrauscht. Es ist der Kern-Generator, der während der Abtastung verwendet wird. Model file
- P-H3-Image Text Encoder (bf16). Codiert die endgültige Eingabeaufforderung in Einbettungen, die das UNet leiten. Dies ist die Schnittstelle zwischen Text und Bild. Model file
- P-H3-Image Prompt Upsampler (bf16). Erweitert kurze Anfragen in reichere, constraint-bewusste Eingabeaufforderungen. Es verbessert die Spezifität und Kohärenz, während Ihr Kernanliegen beibehalten wird. Model file
- P-H3-Image VAE (bf16). Dekodiert das endgültige Latente in ein hochauflösendes RGB-Bild mit originalgetreuen Farben und Texturen. Model file
Alle Assets sind im Hugging Face Repository PrunaAI/P-H3-Image-Comfy verfügbar.
Verwendung des Comfyui P-H3-Image ComfyUI Workflows#
Dieser Workflow folgt einem klaren Pfad: eine Eingabeaufforderung verfassen oder erweitern, Auflösung wählen, Konditionierung und das startende Latente aufbauen, acht Abtastschritte ausführen, dann dekodieren und das Bild speichern.
Eingabeaufforderung verfassen und erweitern#
Schreiben Sie eine kurze Beschreibung in Request (#16). Der Text wird mit Aspekt-Anleitung in Upsampler input (#17) umhüllt und an Prompt upsampler (#18) gesendet, um eine längere, produktionsreife Eingabeaufforderung zu erzeugen. Schalten Sie Use prompt upsampler (#19) um, zwischen Ihrem ursprünglichen Text und der erweiterten Version zu wählen. Der endgültige Text, der das Modell leiten wird, wird in Upsampled prompt (#15) vorab angezeigt, damit Sie vor dem Rendering schnelle Anpassungen vornehmen können.
Auflösung wählen#
Wählen Sie das Seitenverhältnis und die Zielpixel in ResolutionSelector (#20); standardmäßig sind es 8 Megapixel und gängige Verhältnisse wie 1:1, 3:2, 2:3, 4:3, 3:4, 16:9 und 9:16. Dies definiert Breite und Höhe, die zu Vielfachen von 32 für effiziente Abtastung ausgerichtet sind. Halten Sie den im Upsampler input verwendeten Verhältnis-String konsistent mit der hier getroffenen Auswahl, damit die Erweiterung zu Ihrer Leinwand passt. Die gewählte Größe wird zur Konditionierung und latenten Initialisierung weitergeleitet.
Konditionierungs- und latente Einrichtung#
p-h3-image text encoder (CLIP) lädt den Text-Encoder und PH3ImageConditioning (#26) konvertiert die endgültige Eingabeaufforderung plus Ihre gewählte Breite und Höhe in Konditionierung und eine latente Vorlage. Das UNet wird von UNETLoader (#22) geladen. Eine kleine Anpassung in MiniMaxH3SigmaShift (#23) bereitet das Modell auf den H3-Zeitplan vor, sodass der nachfolgende Sampler effizient bei niedriger Schrittzahl läuft. Diese Teile bieten den Guider, das startende Latente und einen für das Modell konfigurierten Zeitplan.
Abtastung#
KSamplerSelect (#8) wählt den Sampler-Algorithmus, und ManualSigmas (#6) liefert einen kompakten Sigma-Zeitplan für acht Schritte. RandomNoise (#9) setzt den Prozess in Gang, um reproduzierbare oder unterschiedliche Ergebnisse zu erzielen. BasicGuider (#7) kombiniert das UNet und die Textkonditionierung, und SamplerCustomAdvanced (#10) führt die acht Entrauschungsiterationen über das von PH3ImageConditioning (#26) bereitgestellte Latente aus. Die Standard-Euler-Strategie ist auf Geschwindigkeit und Stabilität bei 8 MP abgestimmt.
Dekodieren und speichern#
VAEDecode (#11) konvertiert das endgültige Latente in ein Bild, wobei feine Farb- und Materialhinweise erhalten bleiben. SaveImage (#12) schreibt die Datei mit dem Präfix p-h3-image, um die Ausgaben dieses P-H3-Image ComfyUI Workflows leicht nachzuverfolgen.
Wichtige Knoten im Comfyui P-H3-Image ComfyUI Workflow#
Prompt upsampler (#18)#
Erweitert Ihre kurze Anfrage in eine detaillierte Eingabeaufforderung, die Komposition, Beleuchtung und Inhaltsbeschränkungen durchsetzt. Verwenden Sie es, wenn Sie aus kurzen Eingaben konsistente Klarheit wünschen; schalten Sie es aus, um Ihre eigene vollständige Eingabeaufforderung zu schreiben. Wenn die Ausgaben zu wortreich werden, vereinfachen Sie Ihre ursprüngliche Anfrage und behalten Sie nur das Wesentliche bei.
Use prompt upsampler (#19)#
Ein einfaches Tor, das entweder die erweiterte Eingabeaufforderung oder Ihren ursprünglichen Text in das Modell leitet. Schalten Sie es aus, wenn Sie die volle Kontrolle über die Formulierung wünschen oder um das Grundverhalten zu testen. Schalten Sie es ein, um die Ideengenerierung zu beschleunigen und den Aufwand für die Eingabeaufforderungsgestaltung zu reduzieren.
ResolutionSelector (#20)#
Setzt das Seitenverhältnis und die Gesamtpixel, standardmäßig auf 8 MP für große, druckfreundliche Ausgaben. Halten Sie das Verhältnis mit dem in Upsampler input (#17) eingebetteten String abgestimmt für beste Übereinstimmung zwischen Eingabeaufforderung und Leinwand. Erhöhen Sie die Pixel für mehr Details, wenn Ihr GPU-Speicher dies zulässt, oder reduzieren Sie sie für schnellere Vorschauen.
PH3ImageConditioning (#26)#
Erstellt die positive Konditionierung und initialisiert ein Latentes mit der exakten Breite und Höhe, die Sie ausgewählt haben. Stellen Sie sicher, dass die hier ankommende Eingabeaufforderung final ist, da dies der Sampler folgen wird. Änderungen der Größe oder des Textes hier beeinflussen sowohl die Komposition als auch die Dichte der Details weiter unten.
MiniMaxH3SigmaShift (#23)#
Passt den Sigma-Zeitplan für die H3-Style-Abtastung an, sodass acht Schritte bei hoher Auflösung stabil bleiben. Lassen Sie es für Standardläufe eingeschaltet; deaktivieren oder ändern Sie es nur, wenn Sie mit benutzerdefinierten Zeitplänen experimentieren. Es arbeitet im Einklang mit ManualSigmas (#6) und Ihrer Sampler-Wahl.
ManualSigmas (#6) und KSamplerSelect (#8)#
Diese beiden steuern, wie das Entrauschen abläuft. Behalten Sie den Acht-Schritt-Zeitplan für schnelle, hochauflösende Ergebnisse bei; erhöhen Sie die Schritte nur, wenn Sie zusätzliche Mikrotextur oder sehr feine Typografie benötigen. Sie können alternative Sampler ausprobieren, um einen anderen Kompromiss zwischen Schärfe und Glätte zu erzielen.
RandomNoise (#9)#
Legt den Seed fest, der die Variation antreibt. Sperren Sie den Seed, um ein Ergebnis genau zu reproduzieren; ändern Sie ihn, um neue Kompositionen mit derselben Eingabeaufforderung und Einstellung zu erkunden.
Optionale Extras#
- Halten Sie Eingabeaufforderungen konkret. Kurze, spezifische Nomen und Verben funktionieren am besten mit dem Upsampler.
- Für konsistente Layouts geben Sie Aspekt und Schlüsselelemente im ersten Satz Ihrer Anfrage an.
- Um Variationen zu erkunden, fixieren Sie den Seed und ändern Sie ein Element nach dem anderen: Tageszeit, Linse oder Material.
- Verwenden Sie die
Upsampled promptVorschau, um den endgültigen Text in Ihre Notizen zu kopieren oder ihn über Szenen hinweg wiederzuverwenden.
Danksagungen#
Dieser Workflow implementiert und baut auf den folgenden Arbeiten und Ressourcen auf. Wir danken PrunaAI herzlich für P-H3-Image-Comfy und für den ComfyUI Text-zu-Bild-Workflow p-h3-image_text_to_image.json für ihre Beiträge und Pflege. Für autoritative Details beziehen Sie sich bitte auf die Originaldokumentation und die unten verlinkten Repositories.
Ressourcen#
- PrunaAI/P-H3-Image-Comfy
- Hugging Face: PrunaAI/P-H3-Image-Comfy
- PrunaAI/p-h3-image_text_to_image.json (ComfyUI workflow)
- Hugging Face: workflows/p-h3-image_text_to_image.json
Hinweis: Die Nutzung der referenzierten Modelle, Datensätze und Codes unterliegt den jeweiligen Lizenzen und Bedingungen der Autoren und Betreuer.