chrono-edit/lora
根據必填文字指令編輯一張必填圖片,並可設定提示詞擴寫、兩種輸出解析度、種子和輸出格式。
| Parameter | Type | Default/Range | 說明 |
|---|---|---|---|
| image_url | string | Required | 輸入圖片的 URL。 |
| prompt | string | Optional | 對圖層結構和圖像內容的引導。 |
| negative_prompt | string | Optional | 需要排除的元素。 |
| num_layers | integer | Default: 4; Range: 1-10 | 需要產生的 RGBA 圖層數量。 |
| num_inference_steps | integer | Default: 28; Range: 1-50 | 推論步數。 |
| guidance_scale | float | Default: 5; Range: 1-20 | 結果遵循 prompt 的程度。 |
| seed | integer | Default: 0 | 用於重現結果的固定隨機種子。 |
| output_format | string | Options: png, webp; Default: png | 輸出圖像格式;需要保留透明度時建議使用 png。 |
RunComfy API 與瀏覽器介面使用相同欄位。image_url 為必填,prompt 和 negative_prompt 為選填控制項。回應會傳回產生的圖層素材,可用於編輯器或自動化流程。
如需編輯平面圖像中的局部區域,可使用 Qwen-Image-Edit-2509。
根據必填文字指令編輯一張必填圖片,並可設定提示詞擴寫、兩種輸出解析度、種子和輸出格式。
使用 Wan 2.2 Plus 依提示詞生成圖像,並設定尺寸、隨機種子與提示詞擴充。

針對創作者內容、社交貼文和產品變體進行基於參考的快速圖像編輯。

Qwen Image 3.0 Pro:生產級文字到影像生成

根據文字指令編輯或轉換 1–10 張參考圖片,並精確設定尺寸、背景、品質、輸入保真度與輸出格式。

依提示詞生成 1 張圖片,並設定寬高比、解析度、格式與回傳方式。
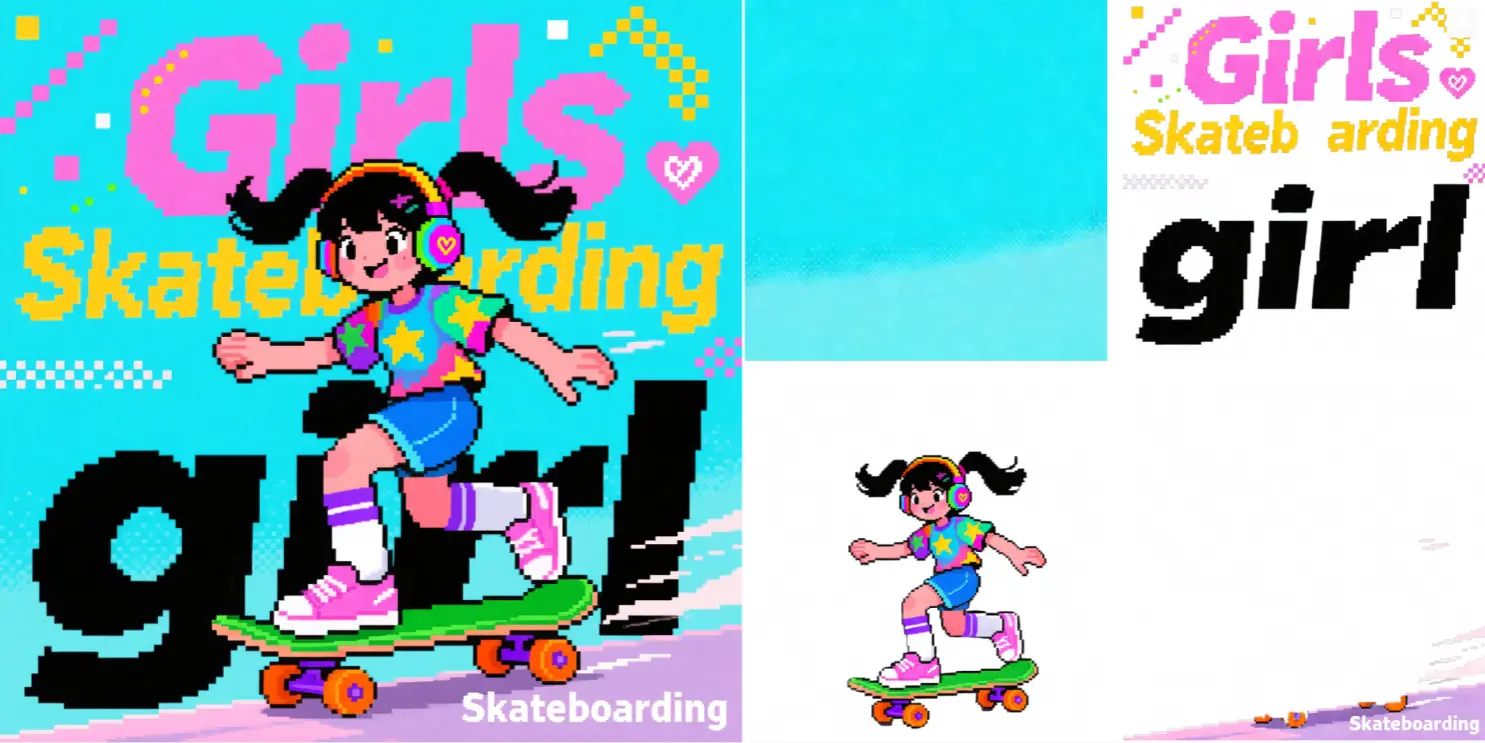
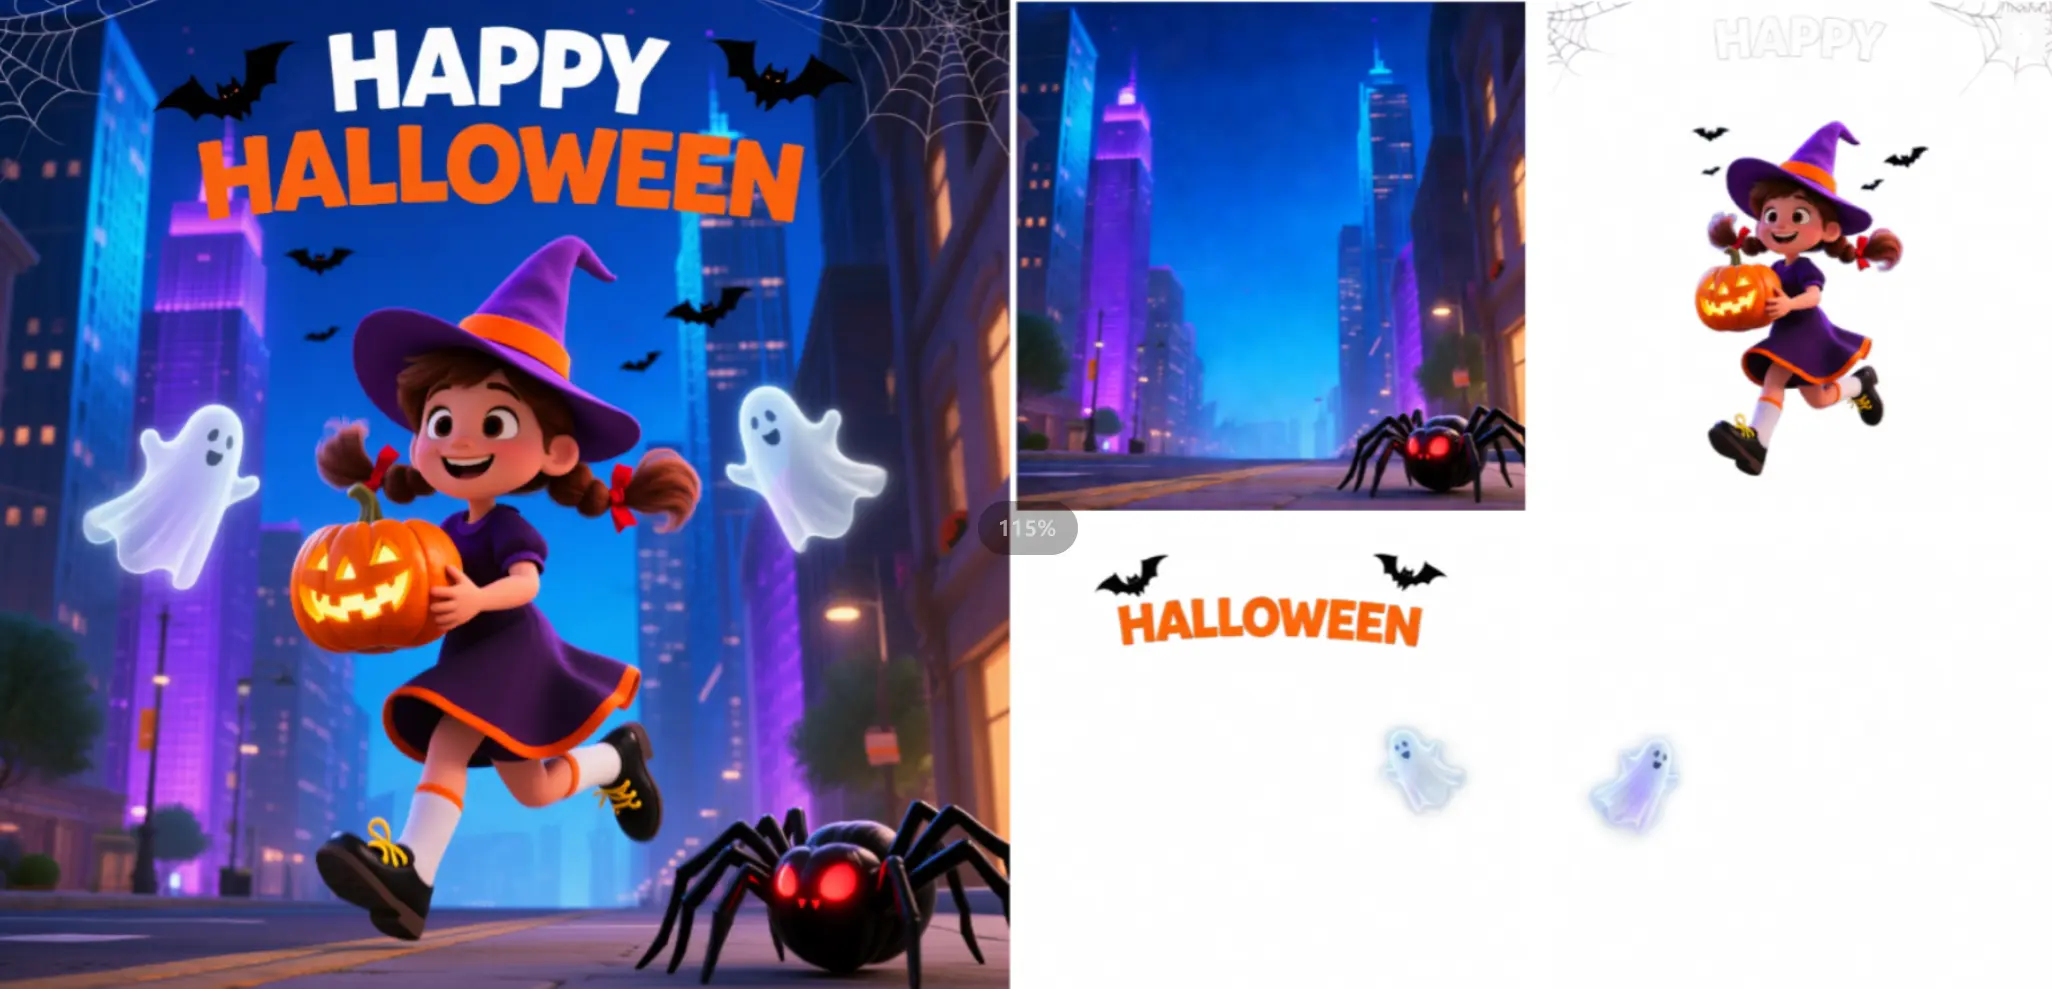
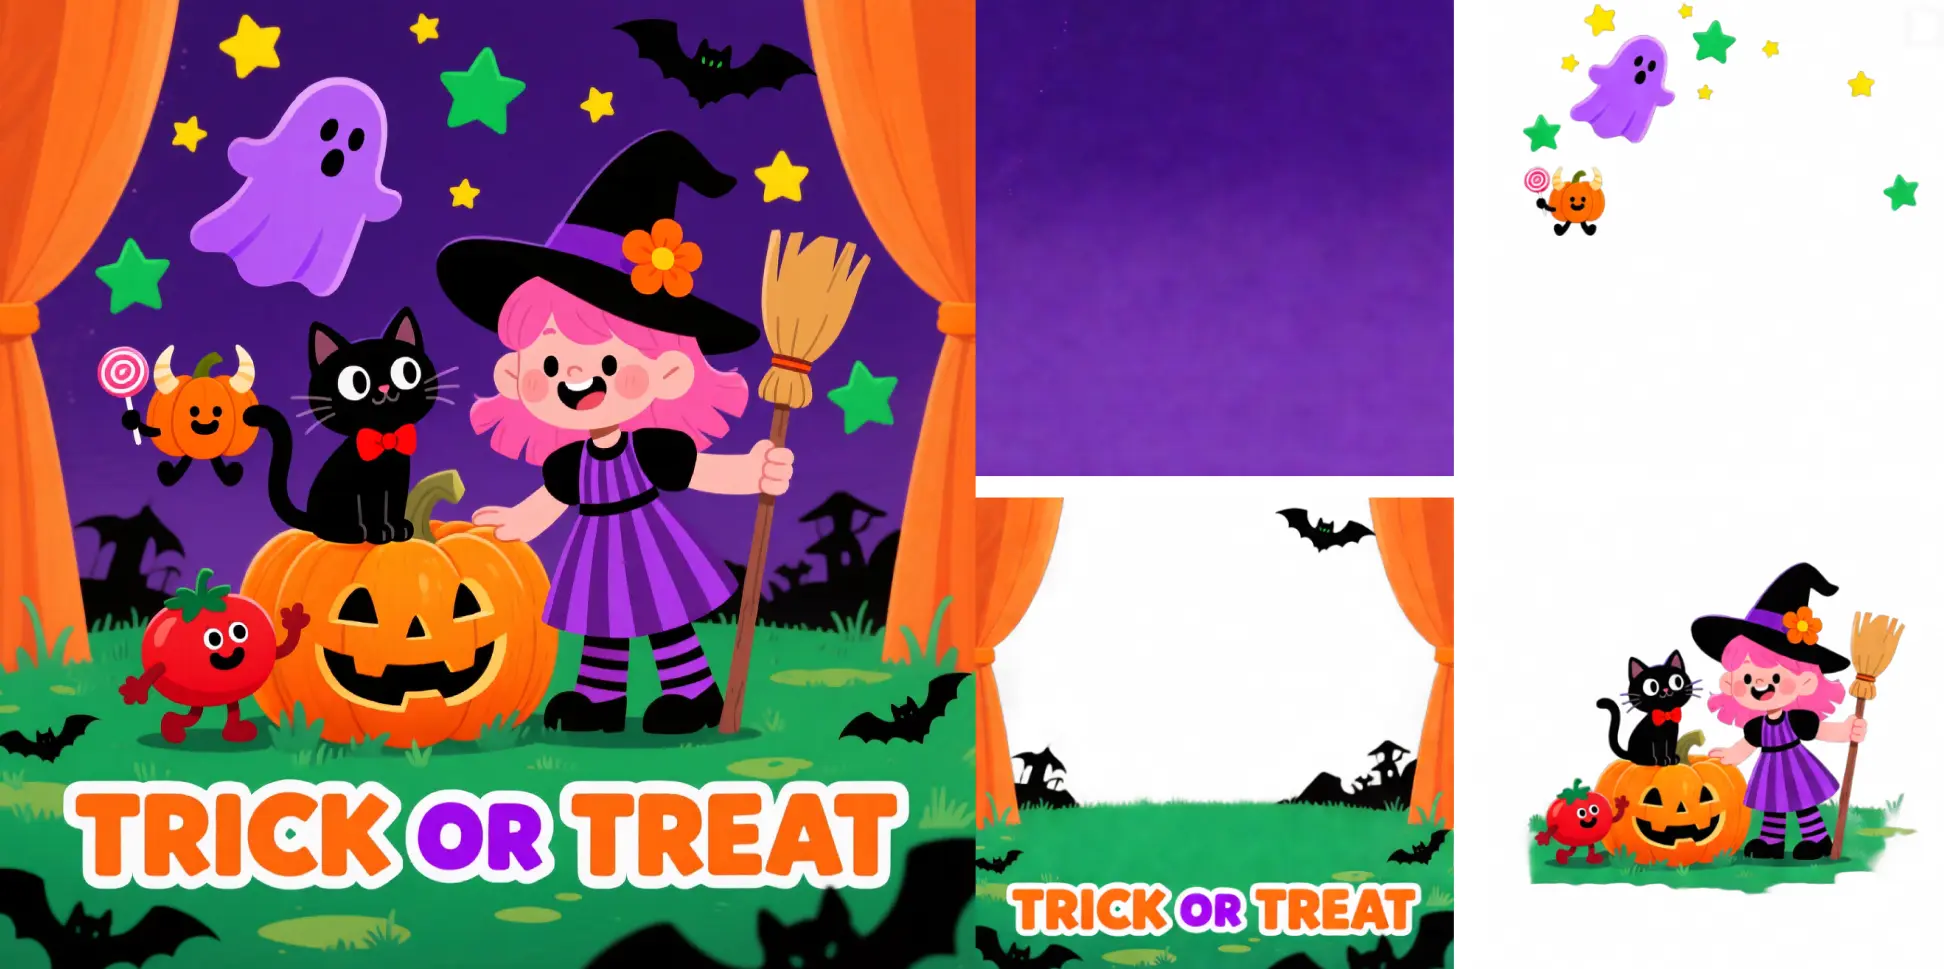
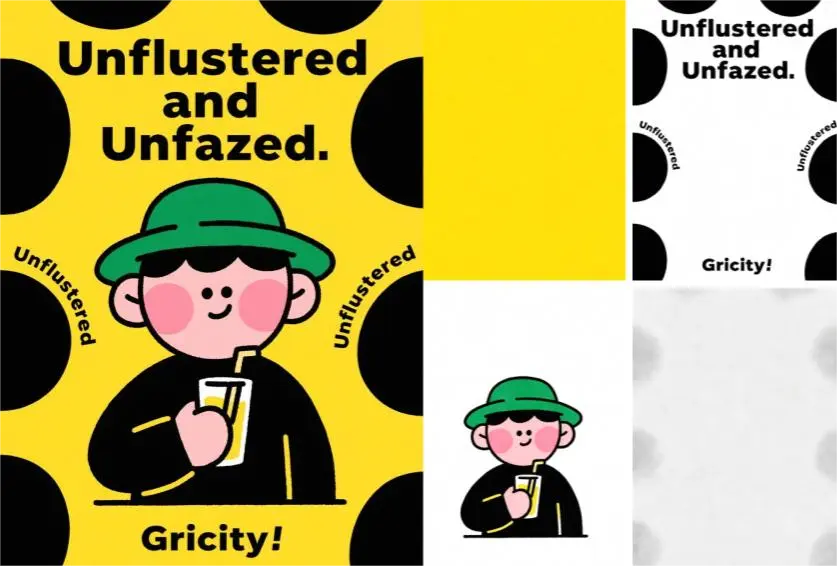
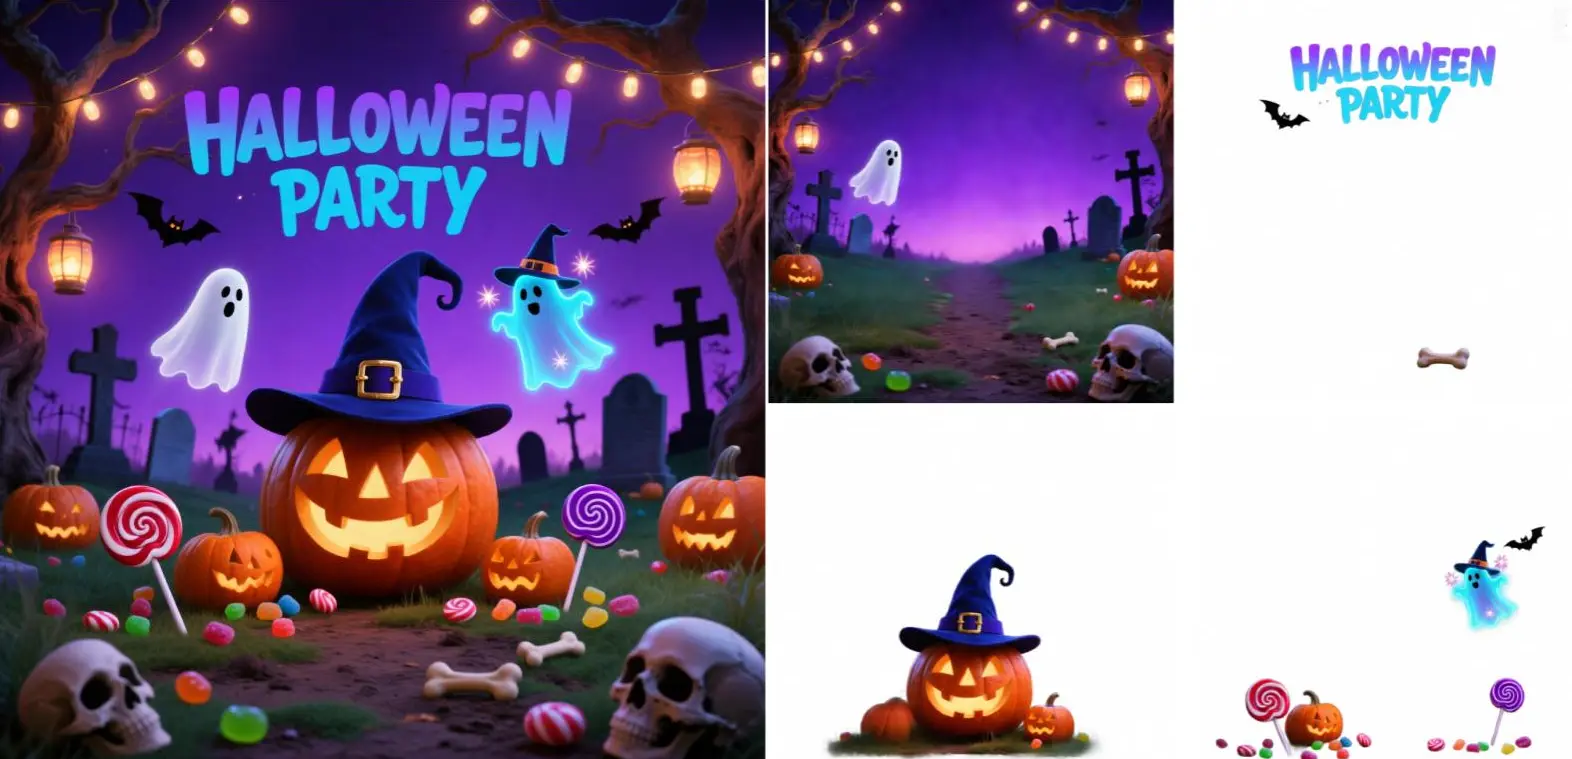
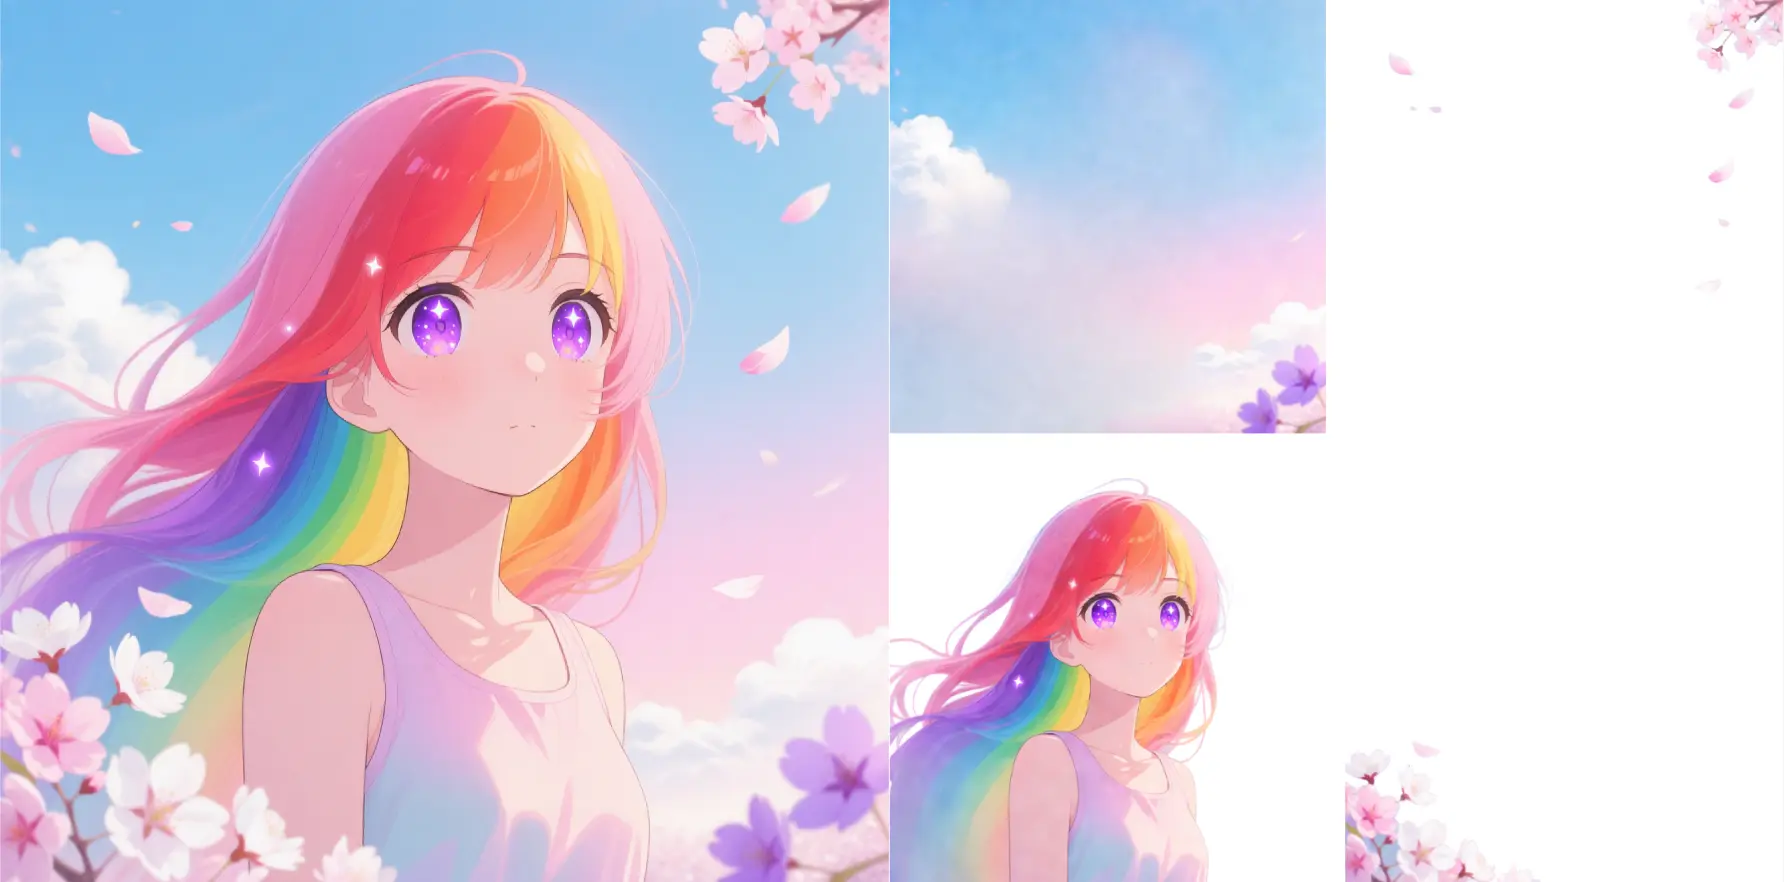
它會把一張輸入圖像分解成多個語意獨立的 RGBA 圖層。每個圖層都保留透明度,可分別移動、改色、編輯或合成。
此模型採用 Apache-2.0 授權條款,可依條款商用。你仍需擁有輸入圖片的合法使用權,並遵守內容所涉及的第三方智慧財產權。
num_layers 範圍為 1-10,num_inference_steps 為 1-50,guidance_scale 為 1-20。端點沒有開放解析度設定或提示詞 token 上限。
目前 schema 沒有這些輸入項目。端點必須提供一個 image_url,並可選用 prompt 和 negative_prompt 引導圖層分解。
先在 RunComfy 瀏覽器介面中測試參數,再透過此模型的 RunComfy API 端點使用相同欄位。image_url 為必填,其他已公開控制項可視需要加入。
已發布的模型說明採用帶有 Layer3D RoPE 位置嵌入的 VLD-MMDiT 主幹,用於在圖層間共享上下文,同時保持語意元素分離。
它的 RGBA-VAE 在共享潛在空間中表示 RGB 與 RGBA 資料,有助於為各語意元件產生一致的 Alpha 資訊,方便後續編輯與合成。
它可以把包含文字的區域分到可編輯圖層,但文字準確度仍會隨輸入與設定而變化。重要排版在投入製作前應仔細檢查。
常見用途包括物件隔離、品牌素材調整、UI 元件擷取、背景替換、版面原型、動畫準備和 VFX 合成。
Qwen Image Edit 修改平面圖像中的選定區域;Qwen Image Layered 則把圖像分解成多個 RGBA 圖層,更適合反覆進行圖層級編輯與合成。
RunComfy 是首選的 ComfyUI 平台,提供 ComfyUI 在線 環境和服務,以及 ComfyUI 工作流程 具有驚豔的視覺效果。 RunComfy還提供 AI Models, 幫助藝術家利用最新的AI工具創作出令人驚艷的藝術作品。