logo
RunComfy
  • ComfyUI
  • 訓練器
  • 模型
  • MCP新
  • 定價
  • Seedance 2.5火爆
  • Seedream 5.5新

依模型瀏覽工作流

火爆MiniMax H3根據文字、影像或參考生成含音訊影片火爆Qwen Image 2.1生成影像,並依參考編輯照片Wan文字或影像生成影片,動作遷移FLUX影像生成、編輯與角色變體LTX文字或影像生成音畫同步影片Qwen Image Edit用文字與參考圖編輯照片Krea 2影像生成、風格遷移與參考編輯Z-Image根據文字快速生成人像與概念圖

熱門與最新工作流

新MiniMax H3 Character Swap V1.5替換影片角色,保留原音訊新P-H3-Image Reference Edit依參考圖編輯照片火爆MiniMax H3 Image-to-Video一張圖生成電影感影片,音畫同步火爆LTX 2.5 Image-to-Video一幀生成清晰影片,音畫同步火爆MiniMax H3 Character Swap (SAM3)替換影片角色,並跟隨原動作Qwen Image 2.1 Multi-Image Editing最多 10 張參考圖合成精準場景FLUX Klein Face Swap自然逼真的換臉SeedVR2 Video Upscaler清晰流暢的影片超解析
查看更多工作流

訓練模型

新MOSS-Image Base影像生成,新支援新FLUX.3 Klein影像生成,新支援火爆Krea 2訓練最多的影像模型火爆Krea 2 Turbo少步數影像生成火爆Qwen Image 2.1影像生成與編輯Z-Image Turbo快速生成人像與概念圖MiniMax H3音畫同步影片

訓練與部署

入門指南用 Ostris AI Toolkit 完成第一個訓練任務資料集上傳與管理訓練資料集推論在 Playground 或透過 API 執行訓練好的模型部署將訓練好的模型部署為專屬端點
訓練更多模型

影像模型

新GPT Image 2.6省 5% · 精細文生圖,支援 GIF 與 SVG,最高 4K新Seedream 5.5省 10% · 文生圖,最高 2K,支援透明 PNG新MiniMax H3 Image省 10% · 文字或參考圖生成靜幀,最高 4K新FLUX 3 Image Klein省 10% · 文字或參考圖生成靜幀,768 至 4K火爆Seedream 5.0 Pro省 20% · 參考圖編輯,支援多語言文字火爆Seedream 4.5省 20% · 寫實級編輯,保持品牌一致火爆Wan 2.6 Image依指令編輯影像Nano Banana Pro省 77% · 從草圖生成精準的 2K 至 4K 影像

視頻模型

新Seedance 2.5 Flash省 34% · Text, image, or reference to video新Kling 4.0省 9% · 將靜態圖轉為 3 至 30 秒影片火爆Wan 3.0 Prime省 13% · 根據參考影片快速生成火爆Seedance 2.5省 35% · 更長、更連貫的電影感影片火爆Wan 3.0根據影像、影片與音訊參考生成火爆MiniMax H3將首幀轉為 5 至 15 秒影片Wan 2.5省 10% · 流暢動作,原生音訊FLUX 3 Max根據文字、靜態圖或關鍵影格生成
查看更多模型

API

Serverless (ComfyUI)將 ComfyUI 工作流程部署為無伺服器端點。Serverless (LoRA)將 LoRA 部署為無伺服器端點。Model API按需運行託管模型,無需部署。Trainer API透過 API 訓練、管理和取得 LoRA。CLIRun RunComfy models from your terminal.
模型
探索
所有模型
資源庫
生成記錄
模型 API
API 文檔
API 金鑰
帳戶
使用情況

Qwen Image 3.0:在模型和 API 上使用排版實現文字到圖像 |運行舒適 | Models and API | RunComfy

qwen/qwen-image-3.0/text-to-image

Qwen Image 3.0 將文字提示轉換為詳細的靜態影像,具有很強的提示依從性、清晰的排版、可選擇的 1k 或 2k 輸出、長寬比控制、提示擴展和基於種子的再現性。

描述主題、設定、風格以及您想要呈現的任何確切文字。將措詞放在引號中以逐字呈現。
輸出細節層。選擇 1k 以獲得更快的草稿,或選擇 2k 以獲得最終的、可列印的細節。兩者的價格相同。
生成影像的長寬比。
讓模型在生成之前用額外的細節豐富簡短的提示。當提示已經準確時關閉。
用於再現性的隨機種子。每次運行使用 -1 作為隨機種子。
Idle
The rate is $0.028 per image.

Qwen Image 3.0簡介

Qwen Image 3.0 是 Qwen 最新的文字到影像模型,專為清晰的提示一致性、細粒度的文字渲染和靈活的輸出大小而建構。

Qwen Image 3.0 將繁瑣的升級程序和手動佈局修復換成了一台可靠的生成器,可幫助設計師、行銷人員和開發人員更快地交付海報、產品照片和版式藝術。

對於開發人員來說,RunComfy 上的 Qwen Image 3.0 既可以在瀏覽器中使用,也可以透過 HTTP API 使用,因此您無需自行託管或擴充模型。

非常適合:印刷海報和封面|產品和電子商務圖像 |資訊圖表和編輯佈局

Qwen / Qwen 圖像 3.0 文字轉圖像#


Qwen Image 3.0 是 Qwen 的文字到影像模型,可將書面提示轉換為高細節靜態影像。它經過調整,可實現準確的提示跟隨、乾淨的排版和照片紋理,因此只需一個描述就可以產生完成的海報、廣告框架或編輯視覺效果。


底層Qwen Image 3.0模型也支援影像編輯(image-to-image);本頁重點介紹文字到影像模式。


亮點#


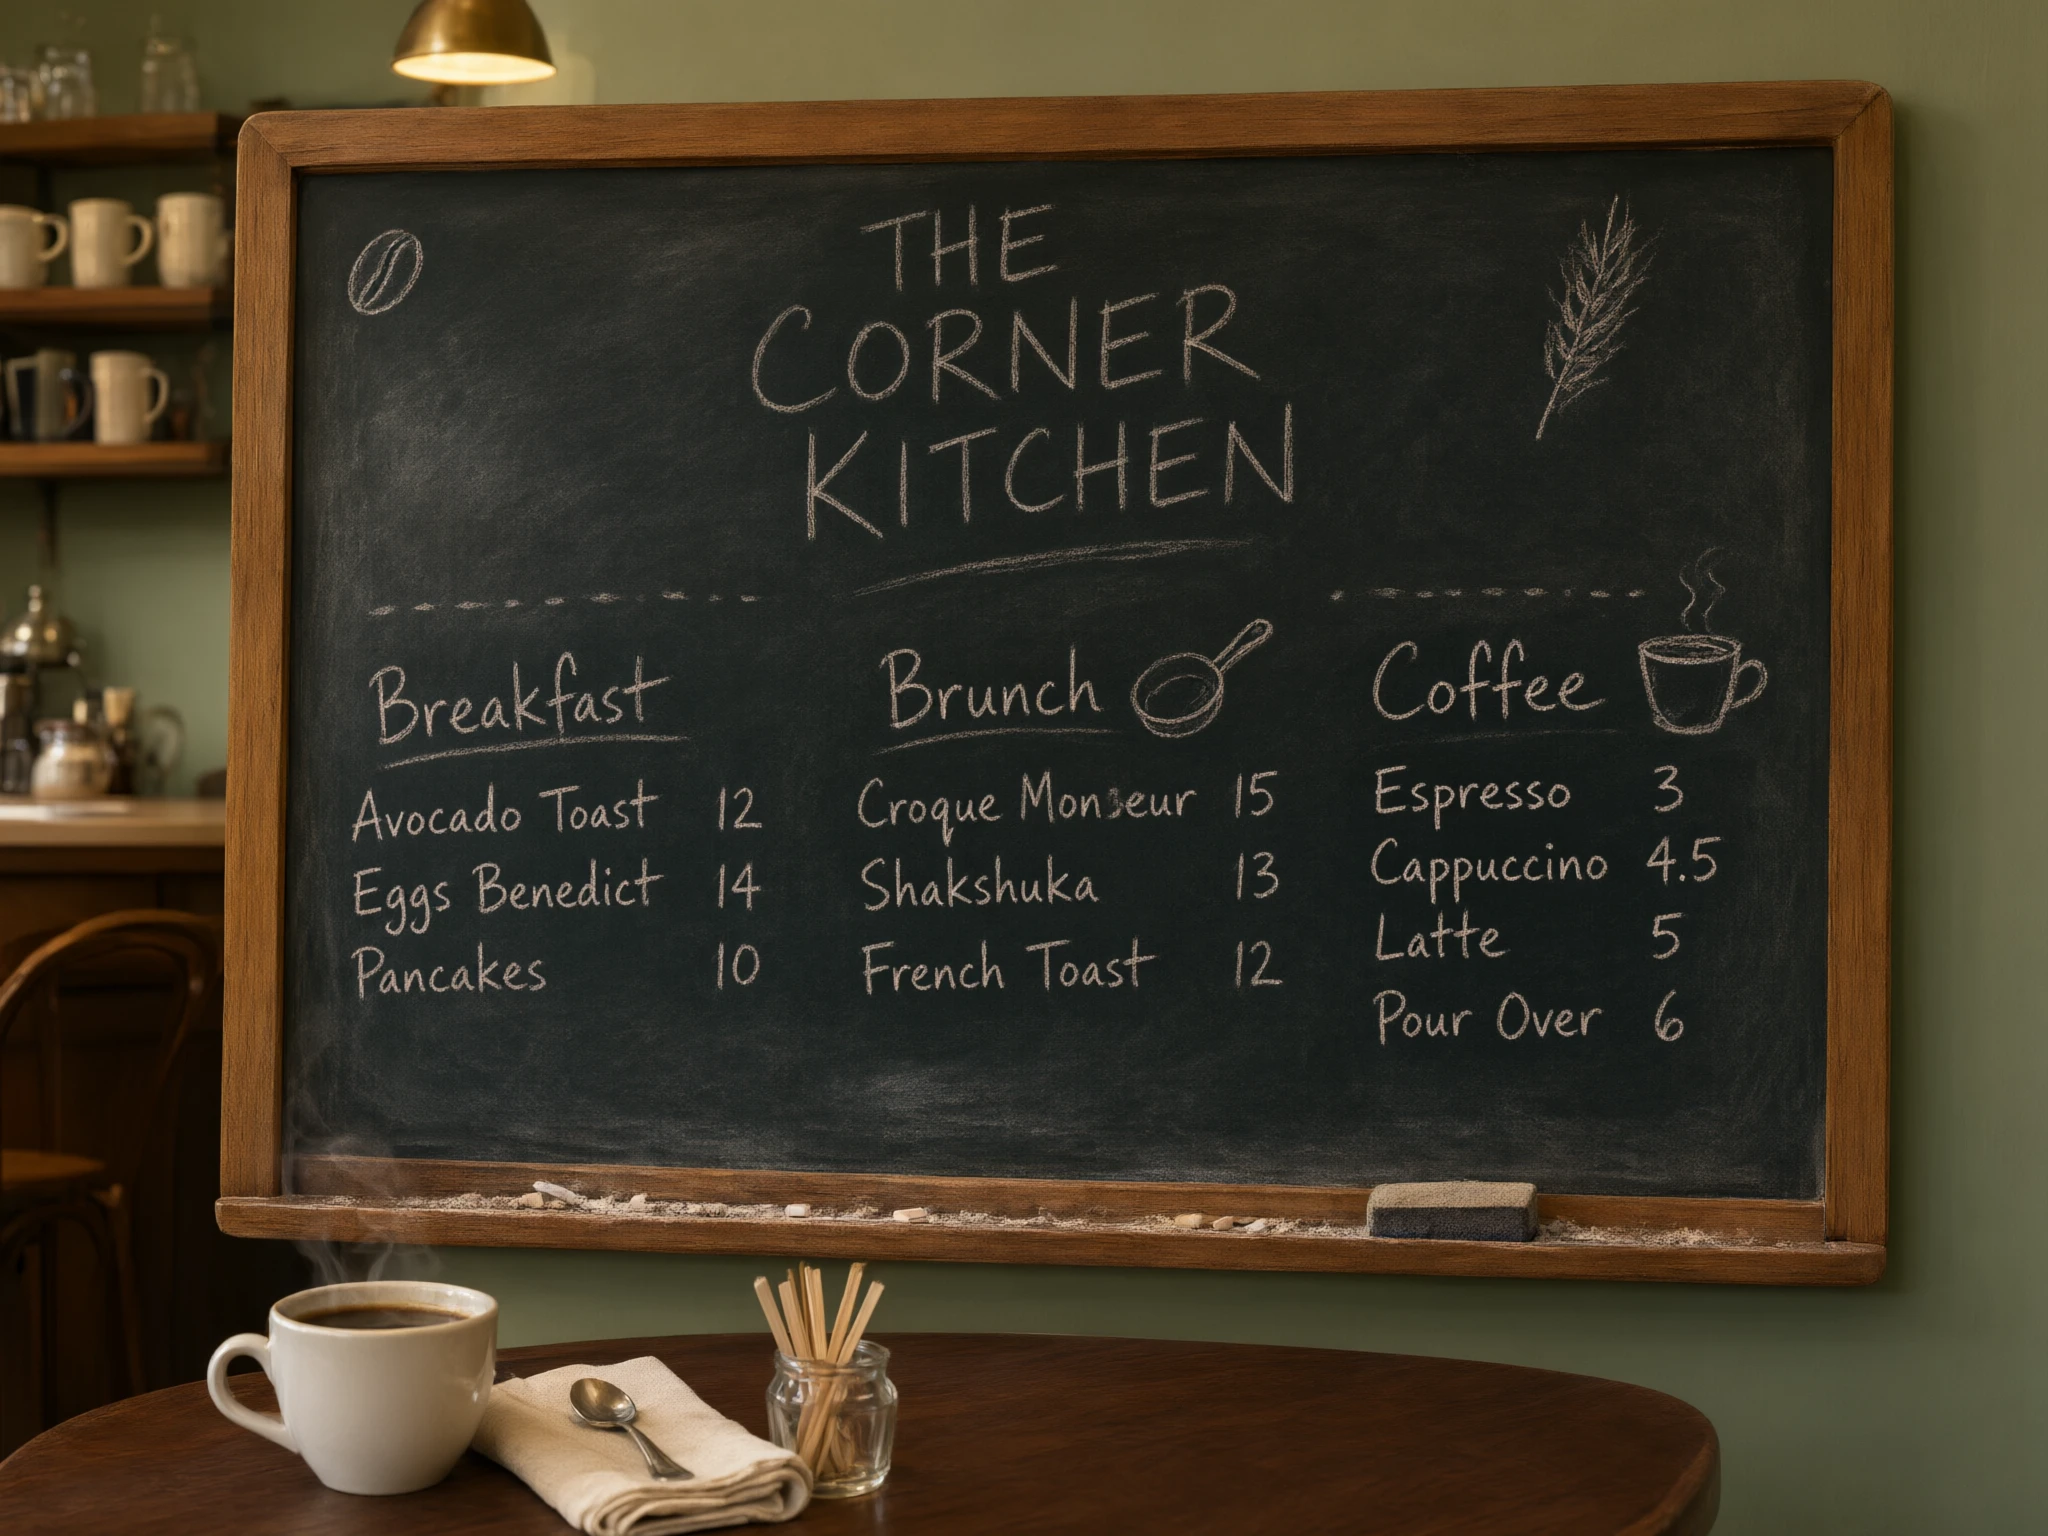
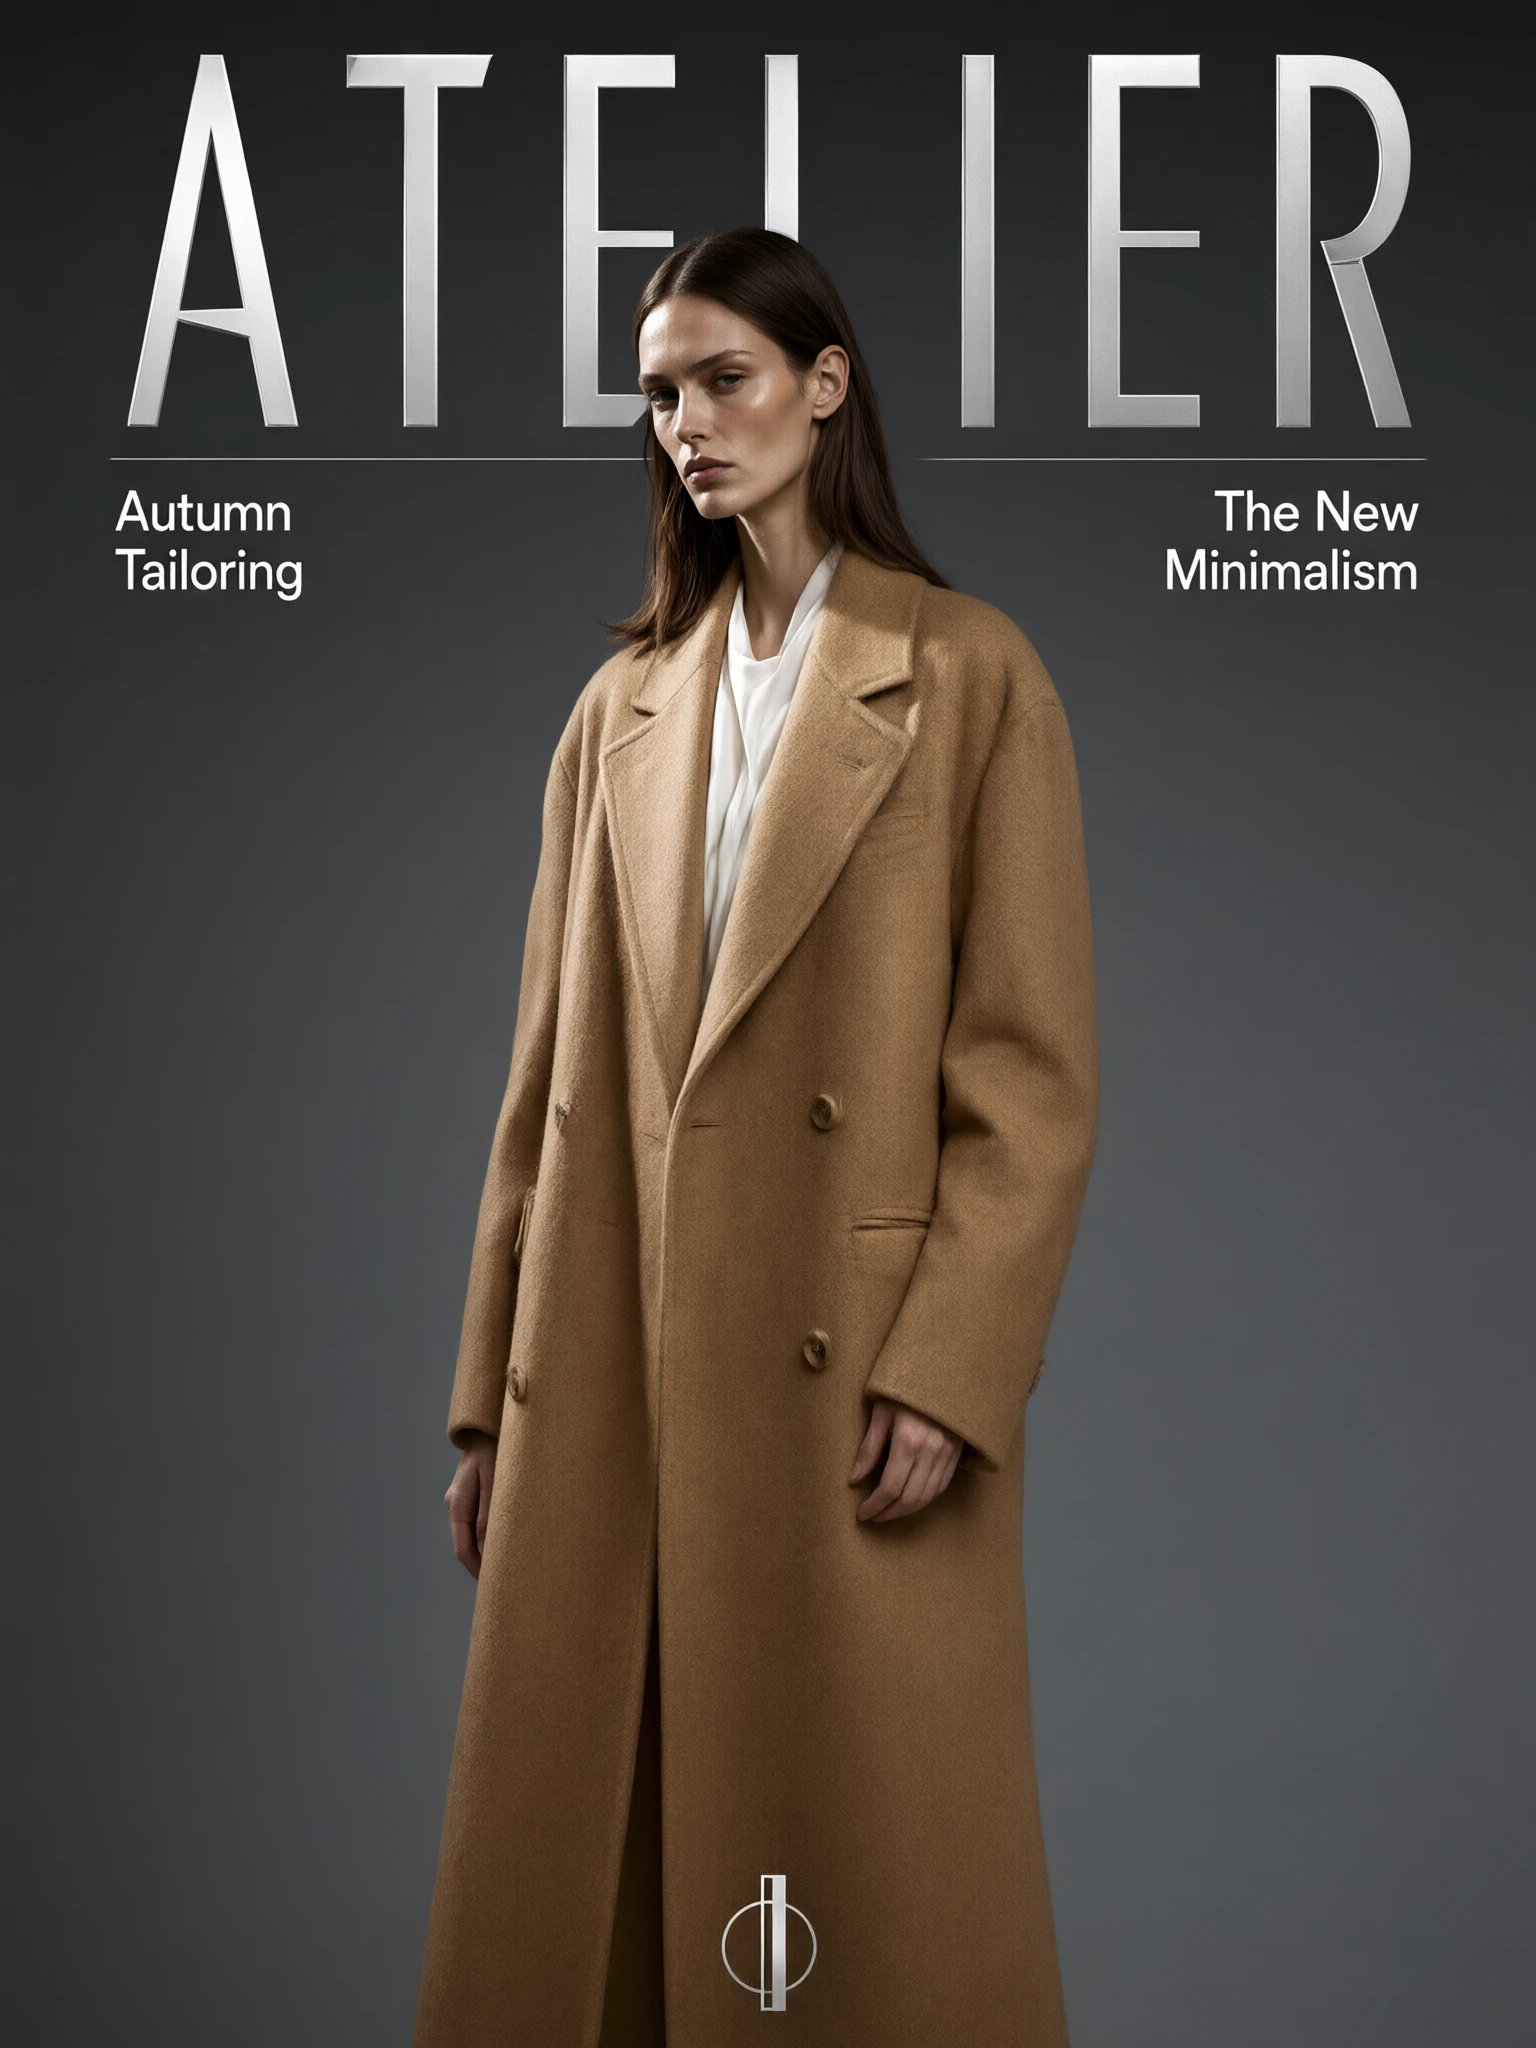
  • 清晰的文字渲染: Qwen Image 3.0 以異常的準確性放置標題、說明文字和小標籤,包括多語言類型 — 方便用於海報、選單和包裝模型。
  • 強大的提示依從性: Qwen Image 3.0 根據您的要求提供命名物件、空間關係和風格提示,從而縮短重新滾動週期。
  • 靈活的輸出大小: 選擇 1k 或 2k 層和寬高比; Qwen Image 3.0 為框架進行合成,而不是裁剪到框架中。
  • 提示擴展: 可選的重寫在生成之前豐富了簡短的提示細節,同時固定的種子保持了外觀的可重複性。
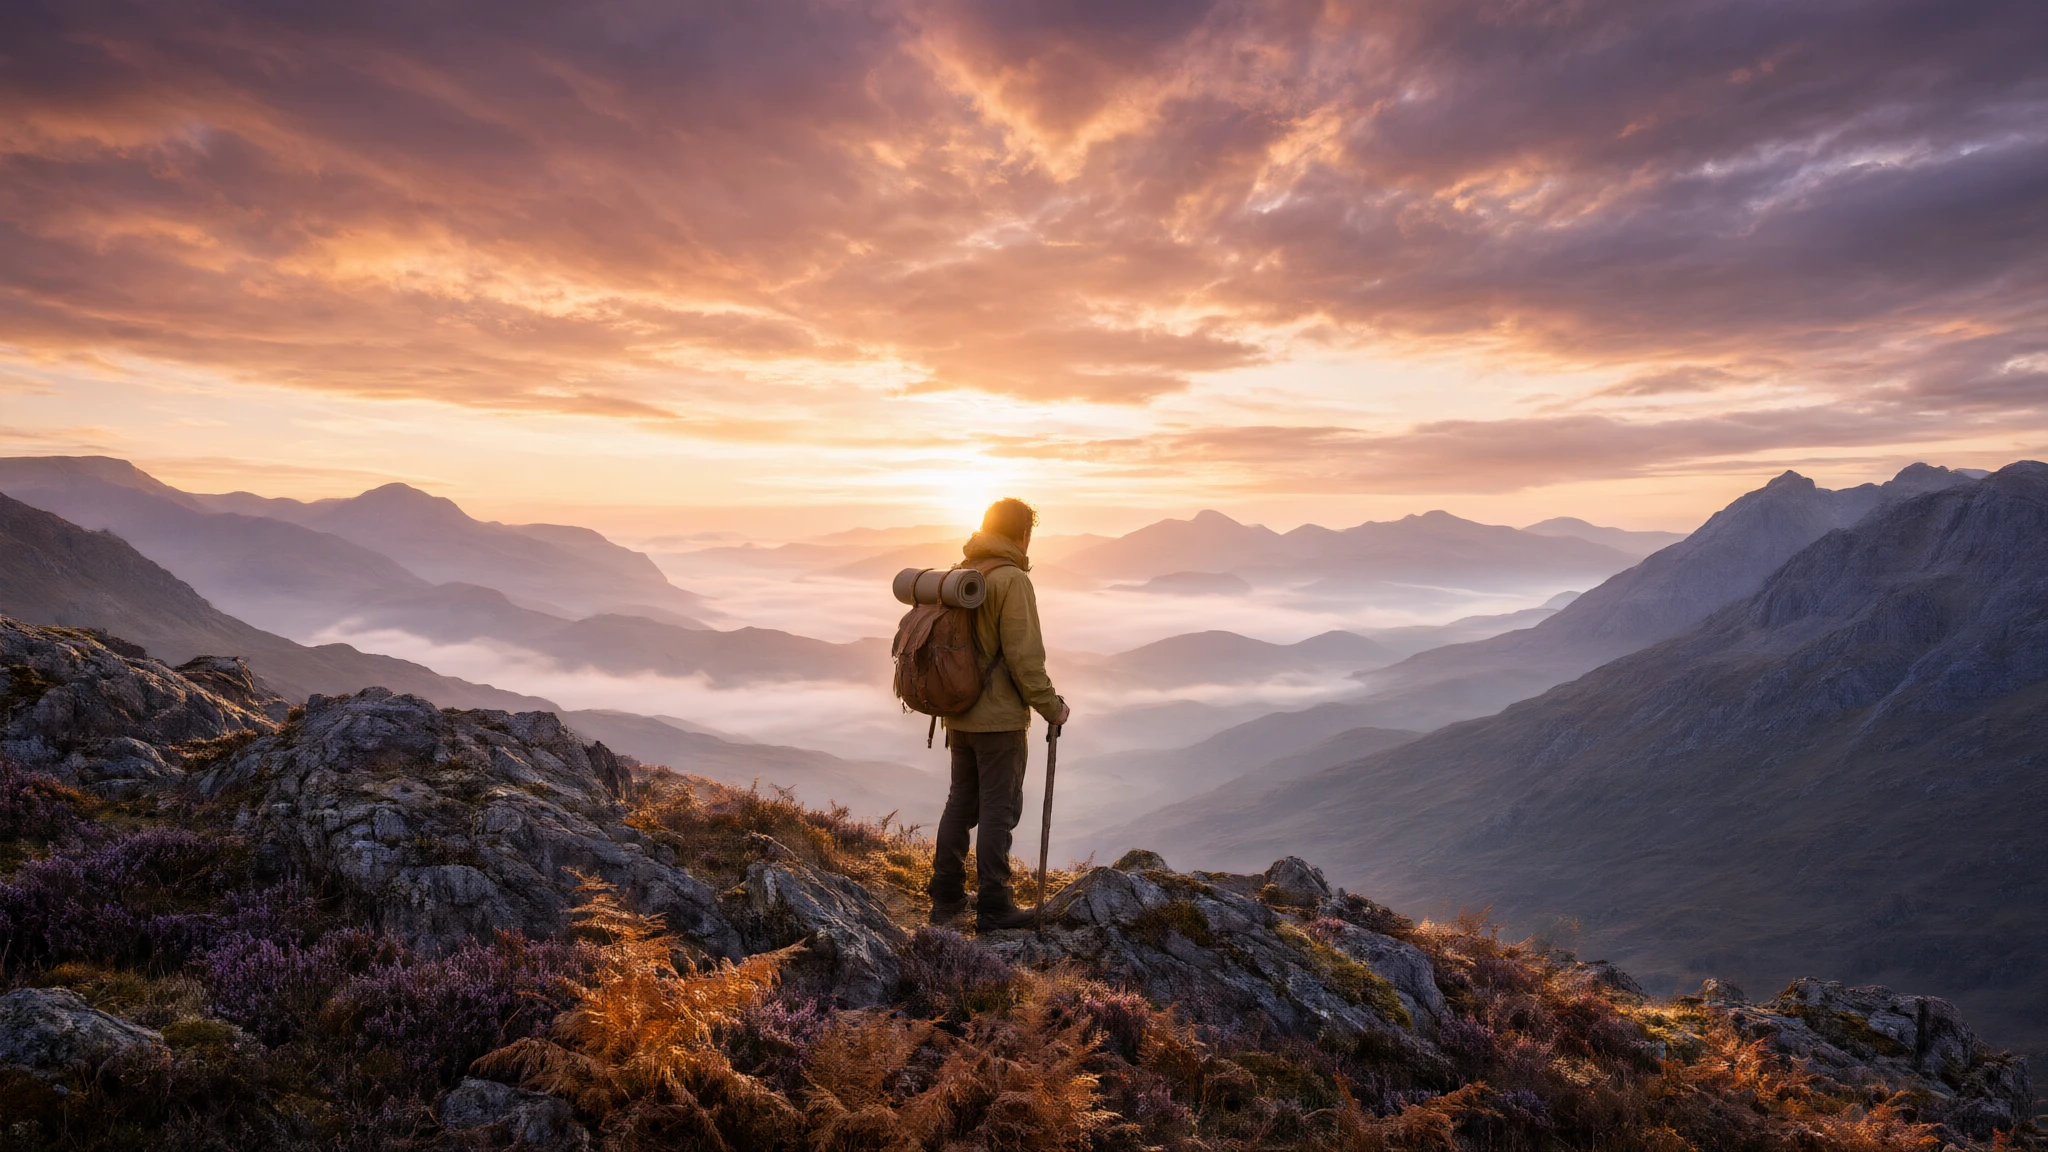
  • 攝影細節: 使用 Qwen Image 3.0,皮膚、織物、金屬和燈光都受到嚴格審查,因此結果看起來像是完成的而不是粗略的。

參數#


參數必填類型預設範圍/選項說明
提示*是 (*)字串海報提示範例最多約 4,500 個代幣描述主題、背景、風格和任何確切的文字。引用措詞以逐字呈現。
決議沒有字串2k1k、2k細節層。 「1k」用於快速草稿,「2k」用於最終列印就緒的細節。兩種方式價格都一樣。
縱橫比沒有字串1:11:1、16:9、9:16、4:3、3:4將框架與您的展示位置相匹配:方形用於提要,「16:9」用於橫幅,「9:16」用於故事。
啟用提示擴充沒有布林真實「真」、「假」在生成之前用細節豐富簡短的提示。當提示已經準確時關閉。
種子沒有整數-1-1 或 0–2147483647修復種子以重現結果;使用“-1”表示新的變化。

  • 必填欄位。

價格#


RunComfy 上的 Qwen Image 3.0 採統一價計費:每張圖 $0.028,1k 與 2k 檔位同價。批量 1–4 張時,總費用為 圖片數量 × $0.028。


如何使用#


  1. 編寫一個提示,命名主題、設定、樣式以及您希望 Qwen Image 3.0 渲染的任何確切文字。
  2. 選擇「1k」圖層用於快速草稿,或選擇「2k」圖層用於最終、可列印的細節。
  3. 選擇與您的展示位置相符的寬高比 - “1:1”用於社交,“16:9”用於橫幅,“9:16”用於故事。
  4. 對於簡短的提示,請保持提示擴充功能處於開啟狀態,或當提示已經準確時將其關閉。
  5. 設定種子以重現外觀,或將其保留為“-1”以獲得新的變化。
  6. 使用 Qwen Image 3.0 生成,檢查文字和構圖,然後一次調整一項指令。

提示和參考提示#


  • 將準確的措詞放在引號中,以便 Qwen Image 3.0 逐字呈現,例如一個標誌上寫著「OPEN」。
  • 以主題為主導,然後添加背景、燈光和鏡頭語言以獲得攝影效果。
  • 為海報的版面命名 - 標題、副標題以及每個區塊應放置的位置。
  • 添加簡短的負方向(「無浮水印,無額外文字」)以保持框架乾淨。
  • 對固定種子進行小的編輯迭代,而不是重寫整個提示。
  • 在完善措詞之前選擇長寬比,因為它會改變適合框架的內容。

Qwen 圖像 3.0 文字到圖像與其他模型的比較#


  • 根據公開訊息,Qwen Image 3.0 在密集、清晰的文字和結構化佈局方面比許多通用圖像模型更強。
  • 與快速的「渦輪」產生器相比,Qwen Image 3.0 犧牲了一點速度,換取了更嚴格的提示依從性和更清晰的排版。
  • 對於沒有文字的純照片級真實肖像,較輕的模型可能就足夠了,但 Qwen Image 3.0 在一次傳遞中保持類型和場景的連貫性。

更多模型可供嘗試#


如果 Qwen Image 3.0 不是正確的起點,請比較 RunComfy 上的以下選項:


  • Nano Banana Pro — 用於參考指導編輯和多圖像混合。
  • Flux 系列生成器 — 用於風格化藝術指導和快速迭代。
  • 表意文字樣式模型 - 用於類似標誌的文字和海報排版。
  • Seedream 風格的模型 — 適用於高解析度攝影場景。

官方資源#


-Qwen:https://qwen.ai/

  • Qwen 部落格 — Qwen Image 3.0:https://qwen.ai/blog?id=qwen-image-3.0

相關模型

ideogram-v2/generate

使用 6 種風格和 11 種長寬比,產生包含文字設計的視覺圖片。

wan-2-2/text-to-image

使用 Wan 2.2 Plus 依提示詞生成圖像,並設定尺寸、隨機種子與提示詞擴充。

flux-1-kontext/pro/text-to-image

高精準 AI 文字轉圖像工具,支援細節調整與靈活創作。

flux-2/flash/edit

Flux 2 Flash Edit 可依照明確的文字指令編輯最多 4 張參考圖,並精確控制尺寸和輸出格式。

z-image/turbo/controlnet/lora

根據一張控制圖片產生新圖,支援最多 3 個 LoRA、4 種預處理模式、分階段 ControlNet 控制及 1–8 個推理步。

flux-2/max/text-to-image

根據文字提示建立新圖片,可選擇 6 個固定尺寸預設、隨機種子以及 JPEG 或 PNG 輸出。

常見問題

Qwen Image 3.0 最擅長的文字轉圖像工作是什麼?

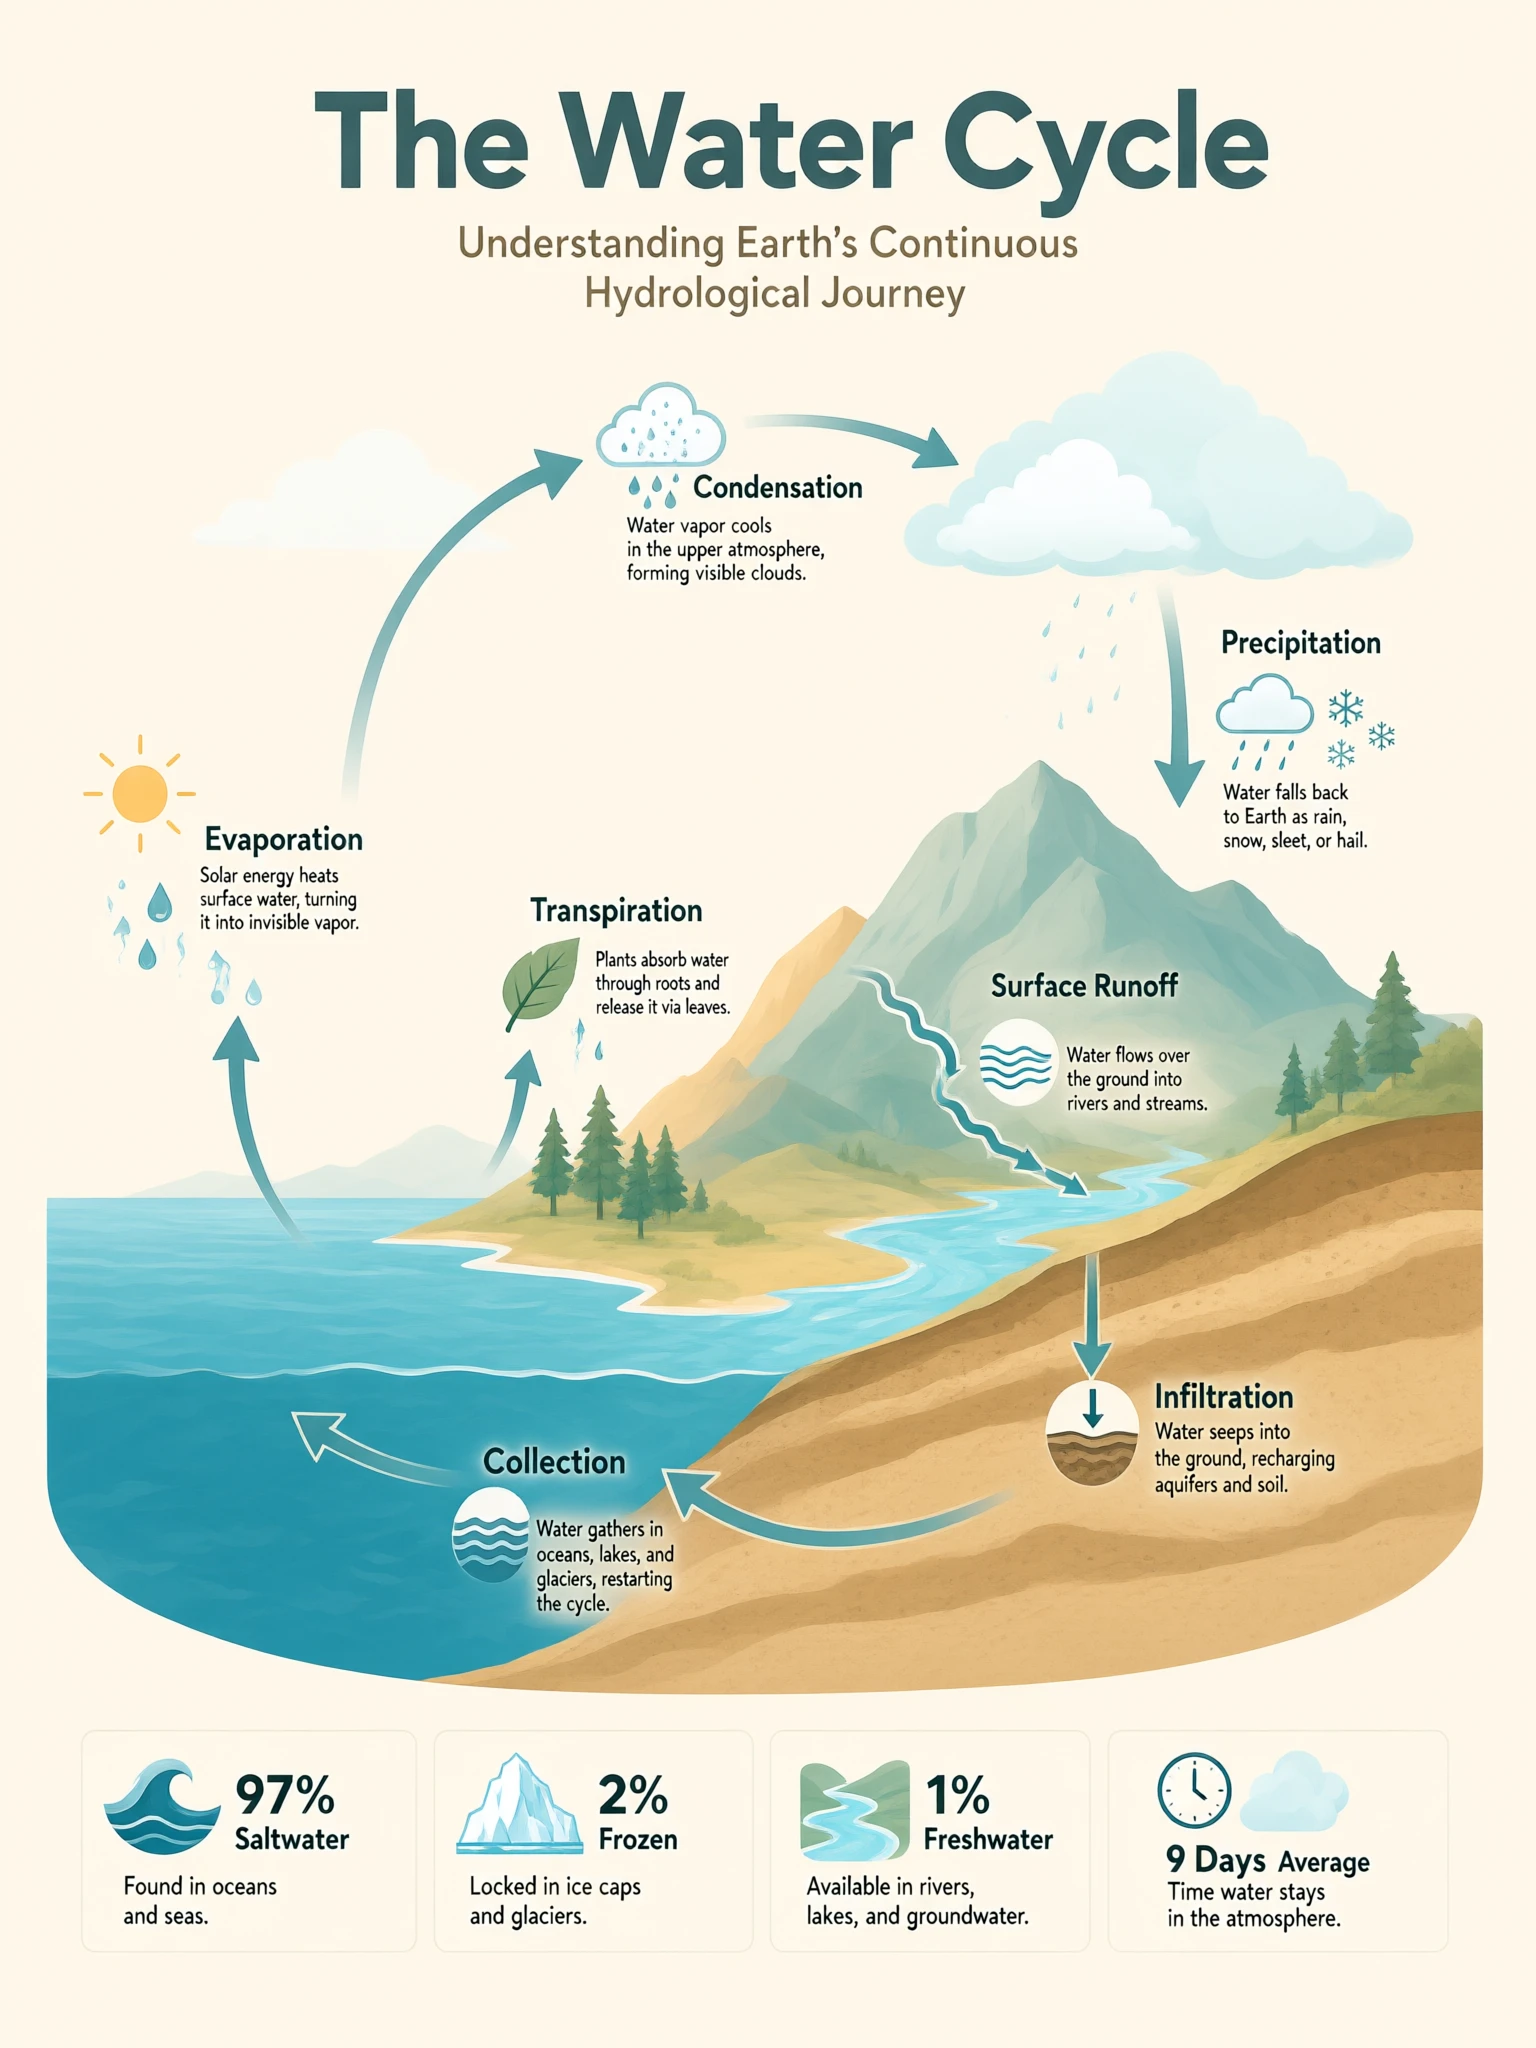
Qwen Image 3.0 擅長將清晰的主題與可讀的文本相結合的提示,例如海報、雜誌封面、菜單和資訊圖表。它嚴格遵循佈局和排版說明,同時保持攝影細節完整,因此單一提示通常會產生最終的靜態影像。

Qwen Image 3.0 如何渲染影像內的文字和排版?

Qwen Image 3.0 經過調整,可精確放置標題、說明文字和小標籤,包括多語言類型。將準確的措詞放在提示中的引號中,以便模型逐字呈現它,並命名每個文字區塊應位於最乾淨佈局的位置。

Qwen Image 3.0可以同時處理攝影場景和平面設計嗎?

是的。 Qwen Image 3.0 可產生逼真的肖像、產品照片和風景,以及社論封面和標籤圖表等設計密集的框架。它的目的是使場景和任何圖像上的文字在一次傳遞中保持一致,而不是單獨處理它們。

Qwen Image 3.0 在 RunComfy 上支援哪些解析度和寬高比?

此 Qwen Image 3.0 文字到圖像頁面提供 1k 或 2k 細節圖層以及 1:1、16:9、9:16、4:3 和 3:4 的長寬比。選擇 1k 進行快速草稿,選擇 2k 進行列印準備的細節;檢查目前的 RunComfy 參數面板以取得確切的選項。

Qwen Image 3.0支援即時擴充和種子嗎?

Qwen Image 3.0 包括一個可選的提示擴展設置,可在生成之前用額外的細節豐富簡短的提示。您也可以設定固定種子來重現結果,或使用 -1 在每次運行中獲得新的變更。

底層的 Qwen Image 3.0 模型是否僅限於文字到影像?

更廣泛的 Qwen Image 3.0 模型還支援圖像編輯(圖像到圖像),但此頁面僅公開文字到圖像模式。這裡單獨使用提示;參考影像編輯是透過單獨的工作流程處理的。

開發者可以透過RunComfy API使用Qwen Image 3.0嗎?

是的。在 RunComfy 模型 UI 中對提示進行原型設計,然後透過 RunComfy HTTP API 使用相同的自動化參數呼叫相同的 Qwen Image 3.0 模型。您不需要自己託管或擴展模型,相同的輸入會產生可比較的結果。

在 RunComfy 上使用 Qwen Image 3.0 產生需要多少錢?

生成會消耗 usd 或點數,Qwen Image 3.0 在 1k 與 2k 檔位均按統一價每張 $0.028 計費。批量時總費用為圖片數量 × 該單價;新使用者通常會獲得一定的免費試用額度。

關注我們
  • 領英
  • Facebook
  • Instagram
  • Twitter
支持
  • Discord
  • 電子郵件
  • 系統狀態
  • 附屬
視頻模型
  • Seedance 2.5 Flash Text To Video
  • Seedance 2.5 Flash
  • Seedance 2.5 Flash Reference to Video
  • Wan 3.0
  • MiniMax H3 Fast
  • Wan 2.5
  • 查看所有模型 →
影像模型
  • Seedream 5.5
  • Seedream 5.5 Edit
  • Seedream 5.5 Layer Decomposition
  • Wan 2.6 Image to Image
  • Nano Banana Pro
  • Seedream 5.0 Pro
  • 查看所有模型 →
法律
  • 服務條款
  • 隱私政策
  • Cookie 政策
RunComfy
版權 2026 RunComfy. 保留所有權利。

RunComfy 是首選的 ComfyUI 平台,提供 ComfyUI 在線 環境和服務,以及 ComfyUI 工作流程 具有驚豔的視覺效果。 RunComfy還提供 AI Models, 幫助藝術家利用最新的AI工具創作出令人驚艷的藝術作品。
Qwen Image 3.0 範例