

P-H3-Image ComfyUI 工作流程:8 MP 文字轉圖像,8 步驟完成#
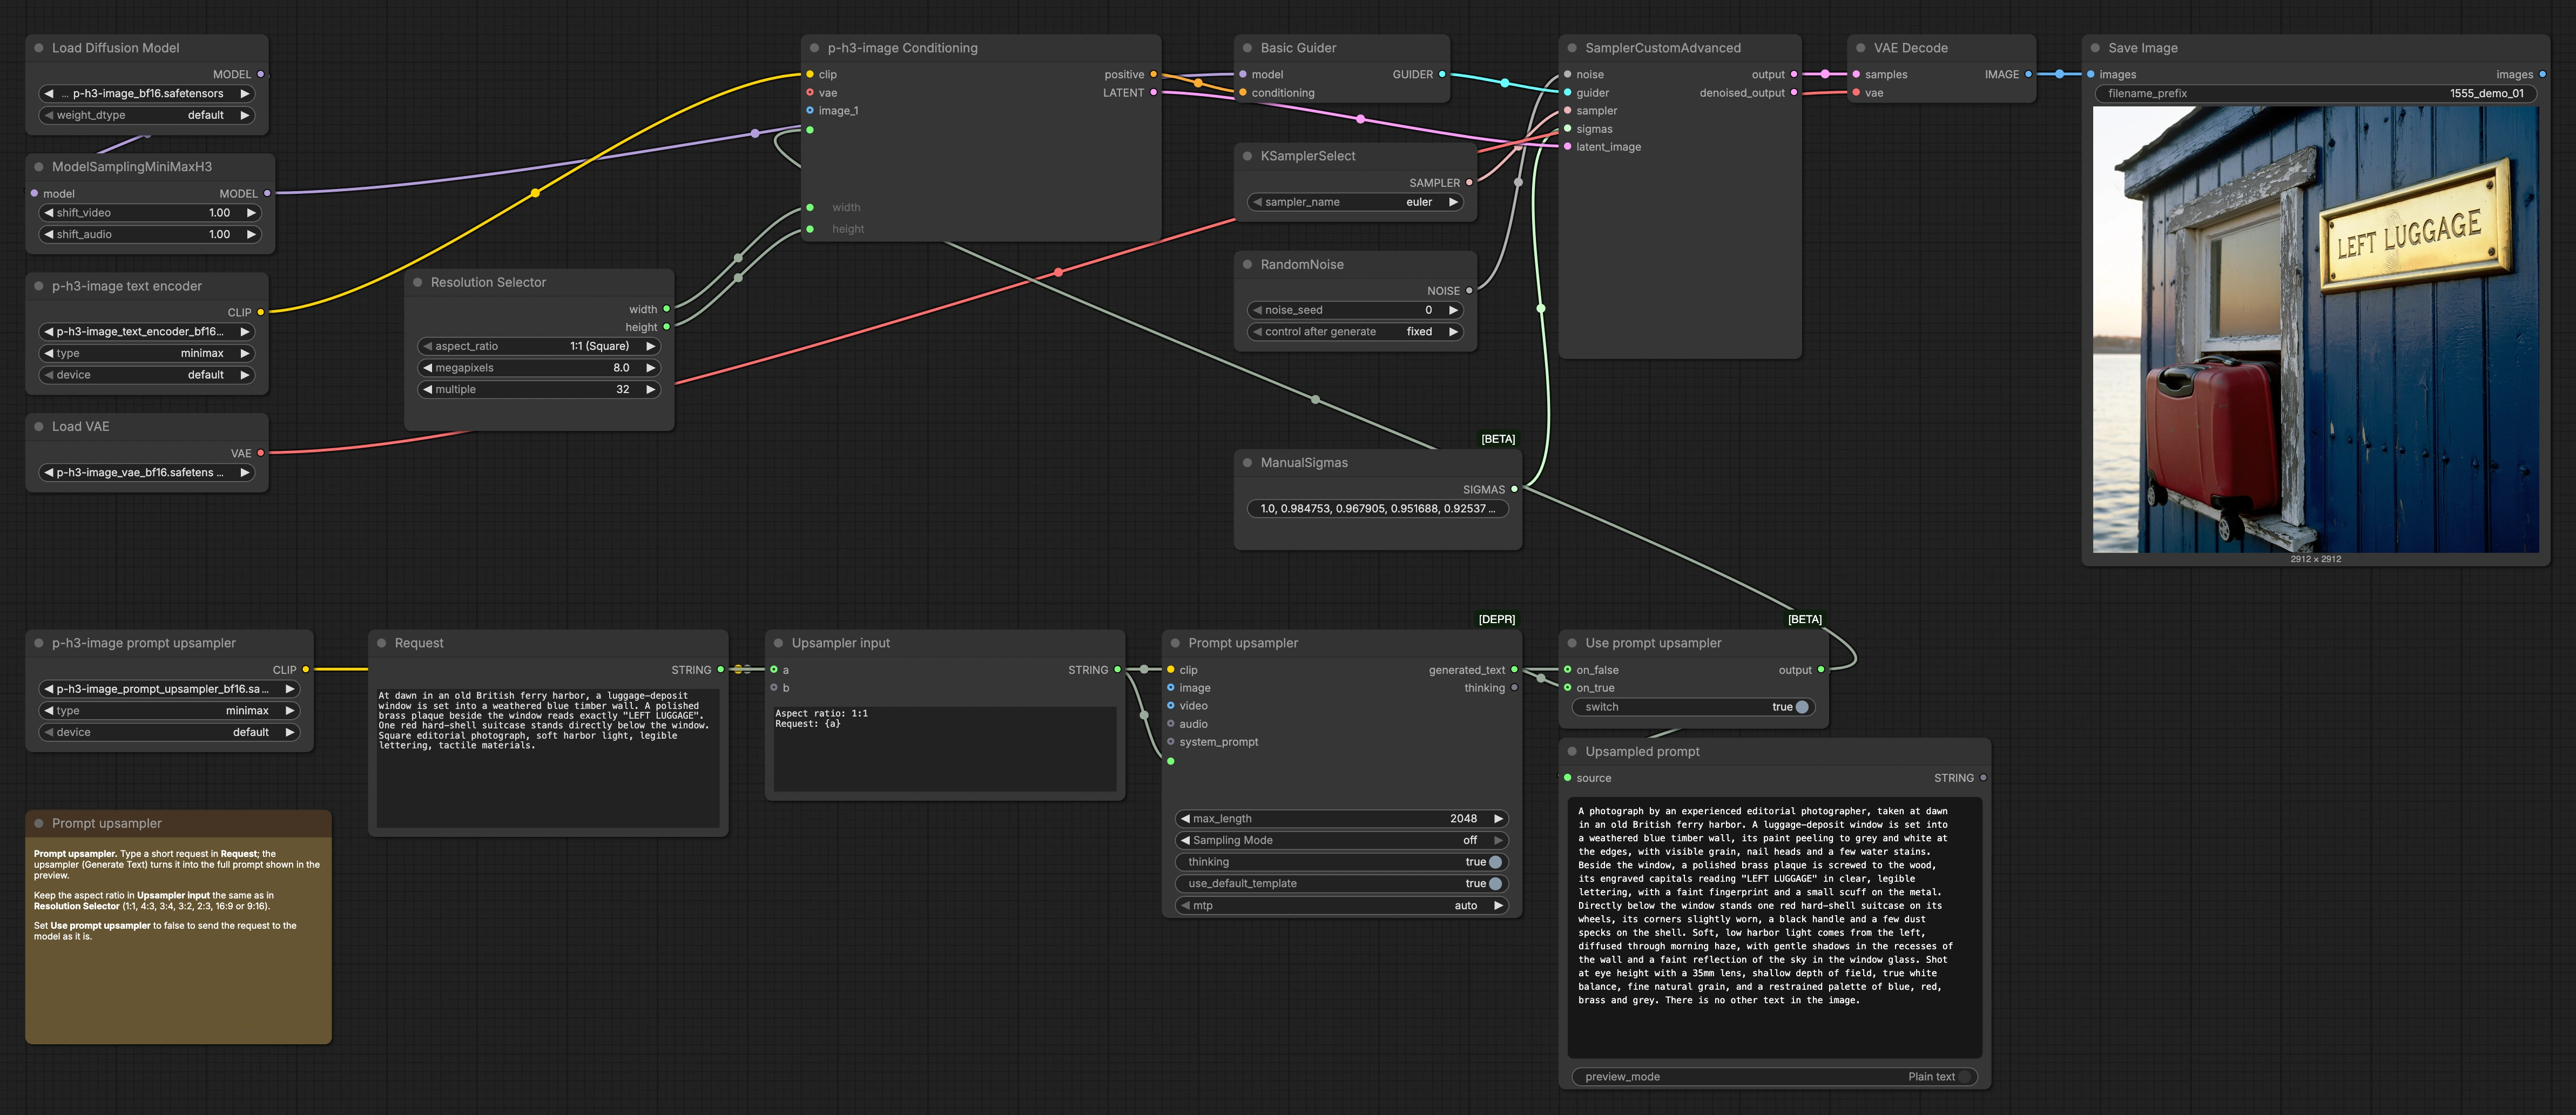
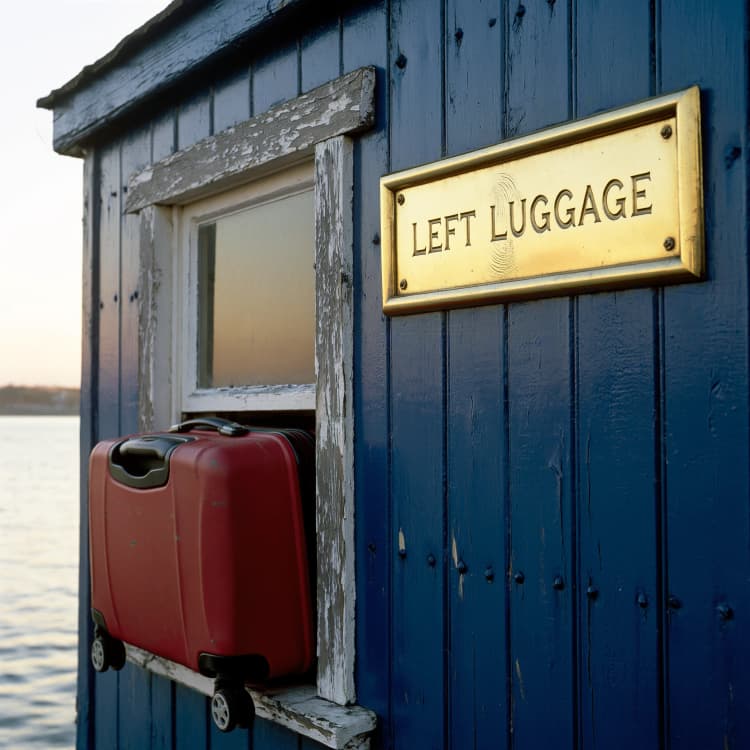
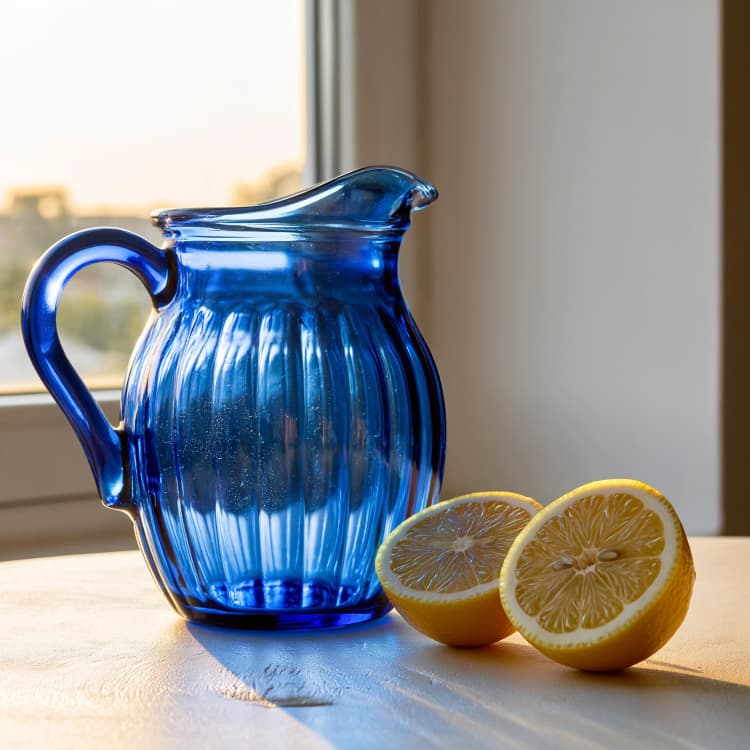
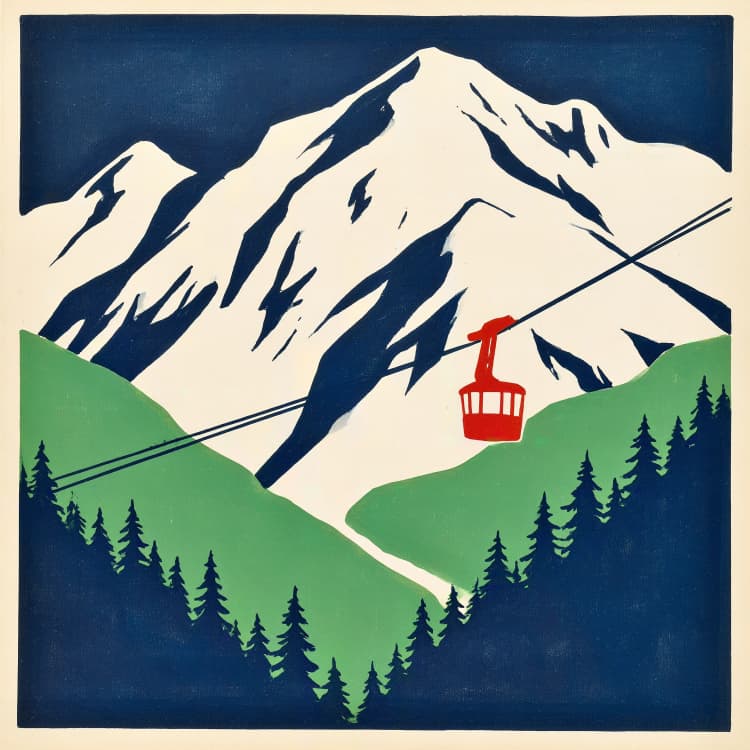
這個 P-H3-Image ComfyUI 工作流程將簡短的場景描述轉換為高質量的 8 百萬像素圖像,只需 8 個取樣步驟。它包括一個可選的提示上採樣器,將您的請求擴展為更完整且風格感知的提示,並在渲染前顯示最終文本。
當您需要快速、清晰構圖且細節一致的大圖時使用它。您可以為方便而保持自動擴展開啟或將其關閉以直接將您的措辭發送到模型。工作流程以可預測的檔名前綴儲存圖像,確保批次保持有序。
Comfyui P-H3-Image ComfyUI 工作流程中的關鍵模型#
- P-H3-Image UNet (bf16)。去噪潛在圖像的擴散骨幹。它是取樣期間使用的核心生成器。 Model file
- P-H3-Image Text Encoder (bf16)。將最終提示編碼為引導 UNet 的嵌入。這是文字與圖像之間的條件接口。 Model file
- P-H3-Image Prompt Upsampler (bf16)。將簡短的請求擴展為更豐富、約束感知的提示。它在保持核心意圖的同時提高了具體性和一致性。 Model file
- P-H3-Image VAE (bf16)。將最終潛在圖像解碼為全分辨率的 RGB 圖像,保持真實的顏色和紋理。 Model file
所有資產均在 Hugging Face 存儲庫 PrunaAI/P-H3-Image-Comfy 提供。
如何使用 Comfyui P-H3-Image ComfyUI 工作流程#
此工作流程遵循明確的路徑:創建或擴展提示,選擇分辨率,構建條件和起始潛在圖像,運行八個取樣步驟,然後解碼並保存圖像。
提示創作和擴展#
在 Request (#16) 中寫一個簡短的描述。文本在 Upsampler input (#17) 中包裹著方面指導,並發送到 Prompt upsampler (#18) 以生成一個更長的、適合生產的提示。切換 Use prompt upsampler (#19) 以選擇原始文本或擴展版本。最終將引導模型的文本在 Upsampled prompt (#15) 中預覽,以便在渲染前快速編輯。
選擇分辨率#
在 ResolutionSelector (#20) 中選擇長寬比和目標像素;默認為 8 百萬像素和常見比例,如 1:1、3:2、2:3、4:3、3:4、16:9 和 9:16。這定義了以 32 的倍數對齊的寬度和高度以提高取樣效率。保持在 Upsampler input 中使用的比例字符串與此處的選擇一致,以便擴展與您的畫布匹配。選擇的尺寸將轉發到條件和潛在初始化。
條件和潛在設置#
p-h3-image text encoder (CLIP) 加載文本編碼器,PH3ImageConditioning (#26) 將最終提示加上您選擇的寬度和高度轉換為條件和潛在模板。UNet 由 UNETLoader (#22) 加載。在 MiniMaxH3SigmaShift (#23) 中進行小調整,為 H3 調度準備模型,以便隨後的取樣器在低步數下高效運行。這些部分提供了引導器、起始潛在圖像和為模型配置的調度。
取樣#
KSamplerSelect (#8) 選擇取樣算法,ManualSigmas (#6) 提供八步的緊湊 sigma 調度。RandomNoise (#9) 為過程設置種子,以獲得可重現或不同的結果。BasicGuider (#7) 結合 UNet 和文本條件,SamplerCustomAdvanced (#10) 在由 PH3ImageConditioning (#26) 提供的潛在圖像上運行八次去噪迭代。默認的 Euler 策略調整為在 8 MP 下的速度和穩定性。
解碼和保存#
VAEDecode (#11) 將最終潛在圖像轉換為圖像,同時保留精細的顏色和材料線索。SaveImage (#12) 以前綴設置為 p-h3-image 寫入文件,方便跟踪來自此 P-H3-Image ComfyUI 工作流程的輸出。
Comfyui P-H3-Image ComfyUI 工作流程中的關鍵節點#
Prompt upsampler (#18)#
將您的簡短請求擴展為詳細提示,強調構圖、照明和內容約束。當您希望從簡短輸入中獲得一致的清晰度時使用它;關閉它以撰寫自己的完整提示。如果輸出過於冗長,請簡化您的原始請求,僅保留基本內容。
Use prompt upsampler (#19)#
一個簡單的門,將擴展提示或原始文本引導到模型中。當您想要完全控制措辭或測試基線行為時將其關閉。當您想加快構思並減少提示工程努力時將其打開。
ResolutionSelector (#20)#
設置長寬比和總像素,默認為 8 MP 以獲得大而適合打印的輸出。保持其比例與 Upsampler input (#17) 中嵌入的字符串一致,以獲得最佳提示到畫布的一致性。如果 GPU 記憶體允許,增加像素以獲得更多細節,或減少像素以加快預覽速度。
PH3ImageConditioning (#26)#
構建正條件並在您選擇的確切寬度和高度初始化潛在圖像。確保到達此處的提示是最終的,因為這是取樣器將遵循的內容。在此處更改大小或文本會影響下游的構圖和細節密度。
MiniMaxH3SigmaShift (#23)#
調整 sigma 調度以適應 H3 風格取樣,以便在高分辨率下八步保持穩定。保持其開啟以進行默認運行;僅在您試驗自定義調度時禁用或更改。它與 ManualSigmas (#6) 和您的取樣器選擇協同工作。
ManualSigmas (#6) 和 KSamplerSelect (#8)#
這兩者控制去噪的展開方式。保持八步調度以獲得快速、高分辨率的結果;僅在需要額外的微紋理或非常細緻的字體時增加步驟。您可以嘗試替代取樣器,以在清晰度和光滑度之間進行不同的權衡。
RandomNoise (#9)#
設置驅動變化的種子。鎖定種子以精確重現結果;更改它以使用相同的提示和設置探索新構圖。
可選附加項#
- 保持提示具體化。簡短且具體的名詞和動詞最適合上採樣器。
- 為了獲得一致的佈局,在請求的第一句中指定方面和關鍵對象。
- 若要探索變化,固定種子並逐一調整元素:時間、鏡頭或材質。
- 使用
Upsampled prompt預覽將最終文本複製到您的筆記中或在場景中重用。
致謝#
此工作流程實現並基於以下作品和資源。我們對 PrunaAI 的 P-H3-Image-Comfy 和 ComfyUI 文字轉圖像工作流程 p-h3-image_text_to_image.json 的貢獻和維護表示誠摯的感謝。有關權威詳情,請參閱下文鏈接的原始文檔和存儲庫。
資源#
- PrunaAI/P-H3-Image-Comfy
- Hugging Face: PrunaAI/P-H3-Image-Comfy
- PrunaAI/p-h3-image_text_to_image.json (ComfyUI workflow)
- Hugging Face: workflows/p-h3-image_text_to_image.json
注意:所引用的模型、數據集和代碼的使用需遵循其作者和維護者提供的相應許可和條款。