flux-2/flex/edit
通过提示词编辑 1–10 张图片,并调整尺寸、提示词扩展、引导强度、步数、随机种子和格式。
| Parameter | Type | Default/Range | 说明 |
|---|---|---|---|
| image_url | string | Required | 输入图片的 URL。 |
| prompt | string | Optional | 对图层结构和图像内容的引导。 |
| negative_prompt | string | Optional | 需要排除的元素。 |
| num_layers | integer | Default: 4; Range: 1-10 | 需要生成的 RGBA 图层数量。 |
| num_inference_steps | integer | Default: 28; Range: 1-50 | 推理步数。 |
| guidance_scale | float | Default: 5; Range: 1-20 | 结果遵循 prompt 的程度。 |
| seed | integer | Default: 0 | 用于复现结果的固定随机种子。 |
| output_format | string | Options: png, webp; Default: png | 输出图像格式;需要保留透明度时建议使用 png。 |
RunComfy API 与浏览器界面使用相同字段。image_url 为必填项,prompt 和 negative_prompt 为可选控制项。响应会返回生成的图层素材,可用于编辑器或自动化流程。
如需编辑平面图像中的局部区域,可使用 Qwen-Image-Edit-2509。
通过提示词编辑 1–10 张图片,并调整尺寸、提示词扩展、引导强度、步数、随机种子和格式。

仅通过文字生成图片,并可选择 2K、4K 或 9 个固定尺寸。

使用 Nano Banana 2 Edit 进行提示词驱动的图像编辑,支持多图输入,并可控制宽高比、分辨率、安全容忍度和输出选项。

结合原图、提示词和最多 3 个 LoRA 完成图片转换,推理步数可设为 1–8。

通过精细控制和可复现设置,快速生成准确的设计视觉。
使用 Wan 2.2 Plus 根据提示词生成图像,并设置尺寸、随机种子和提示词扩展。
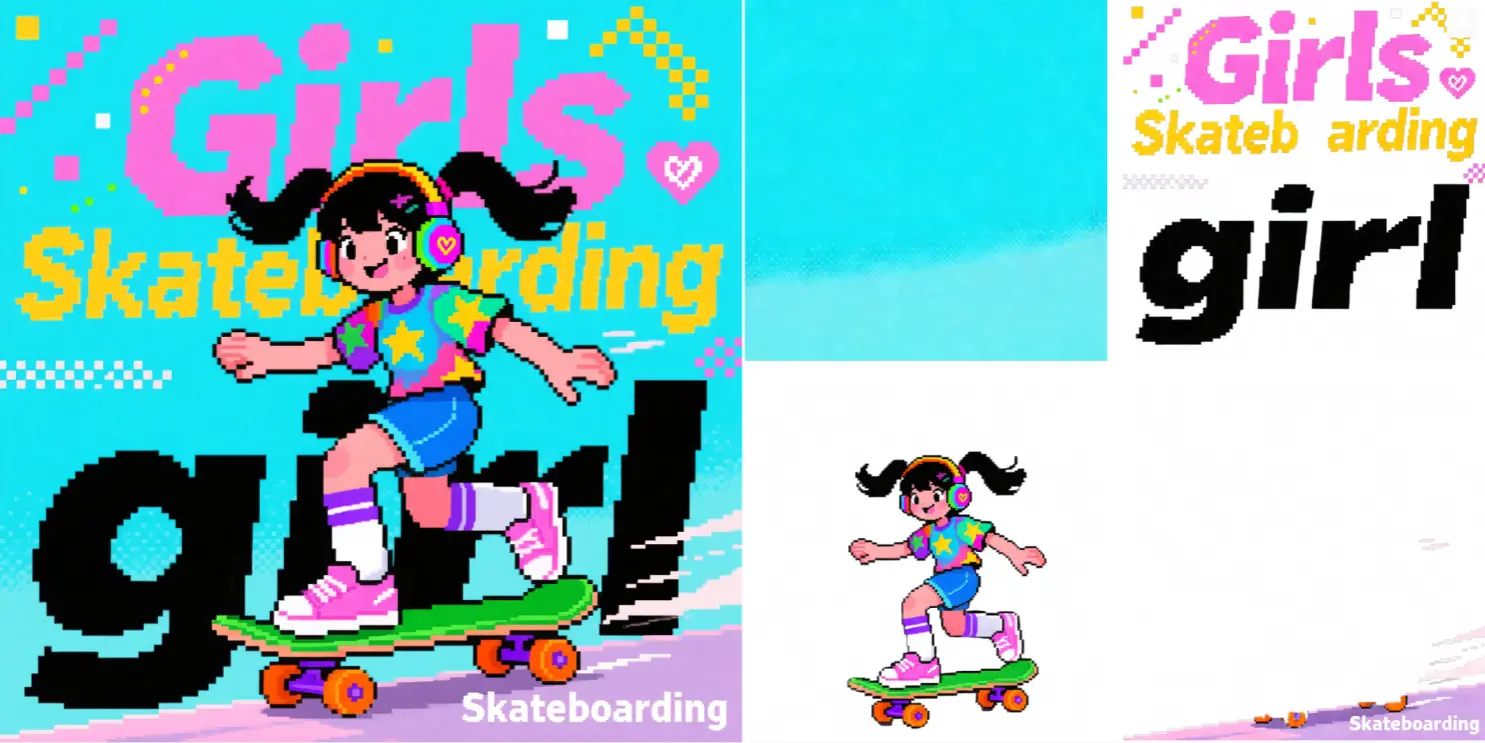
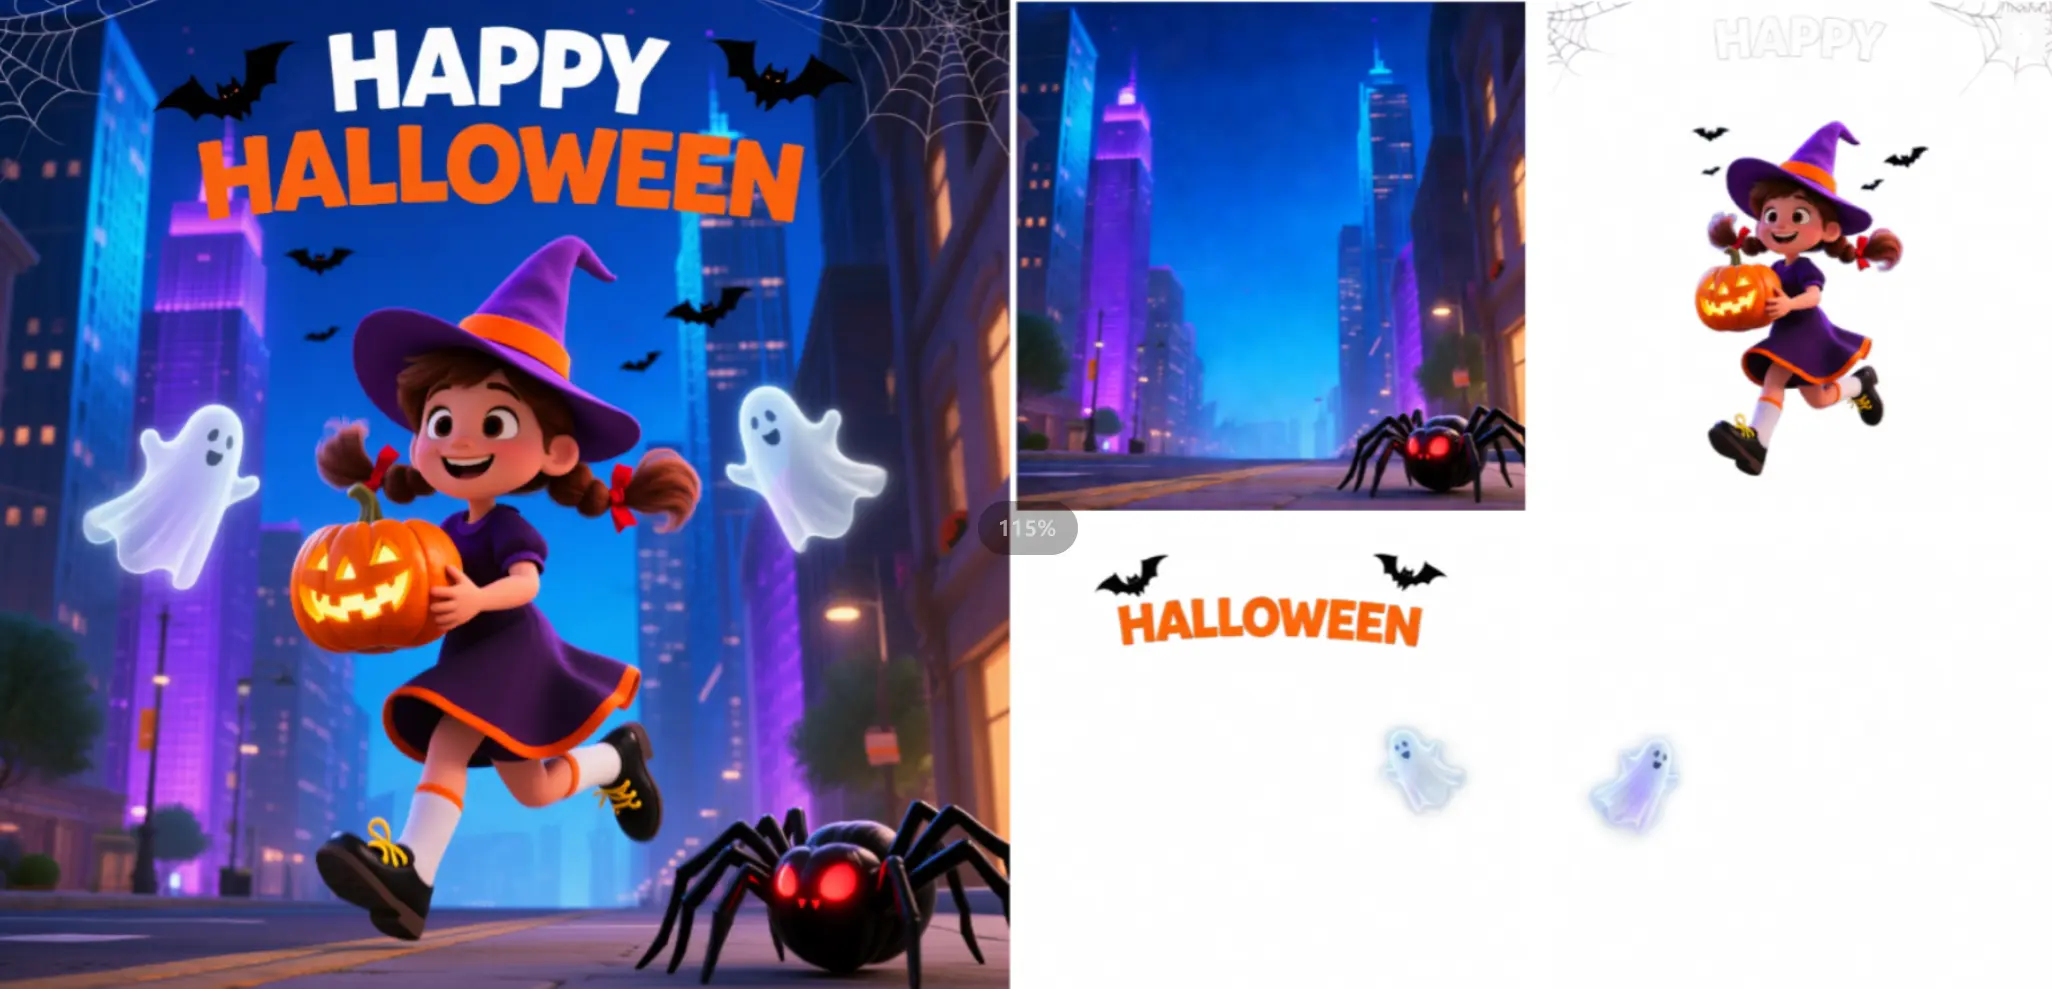
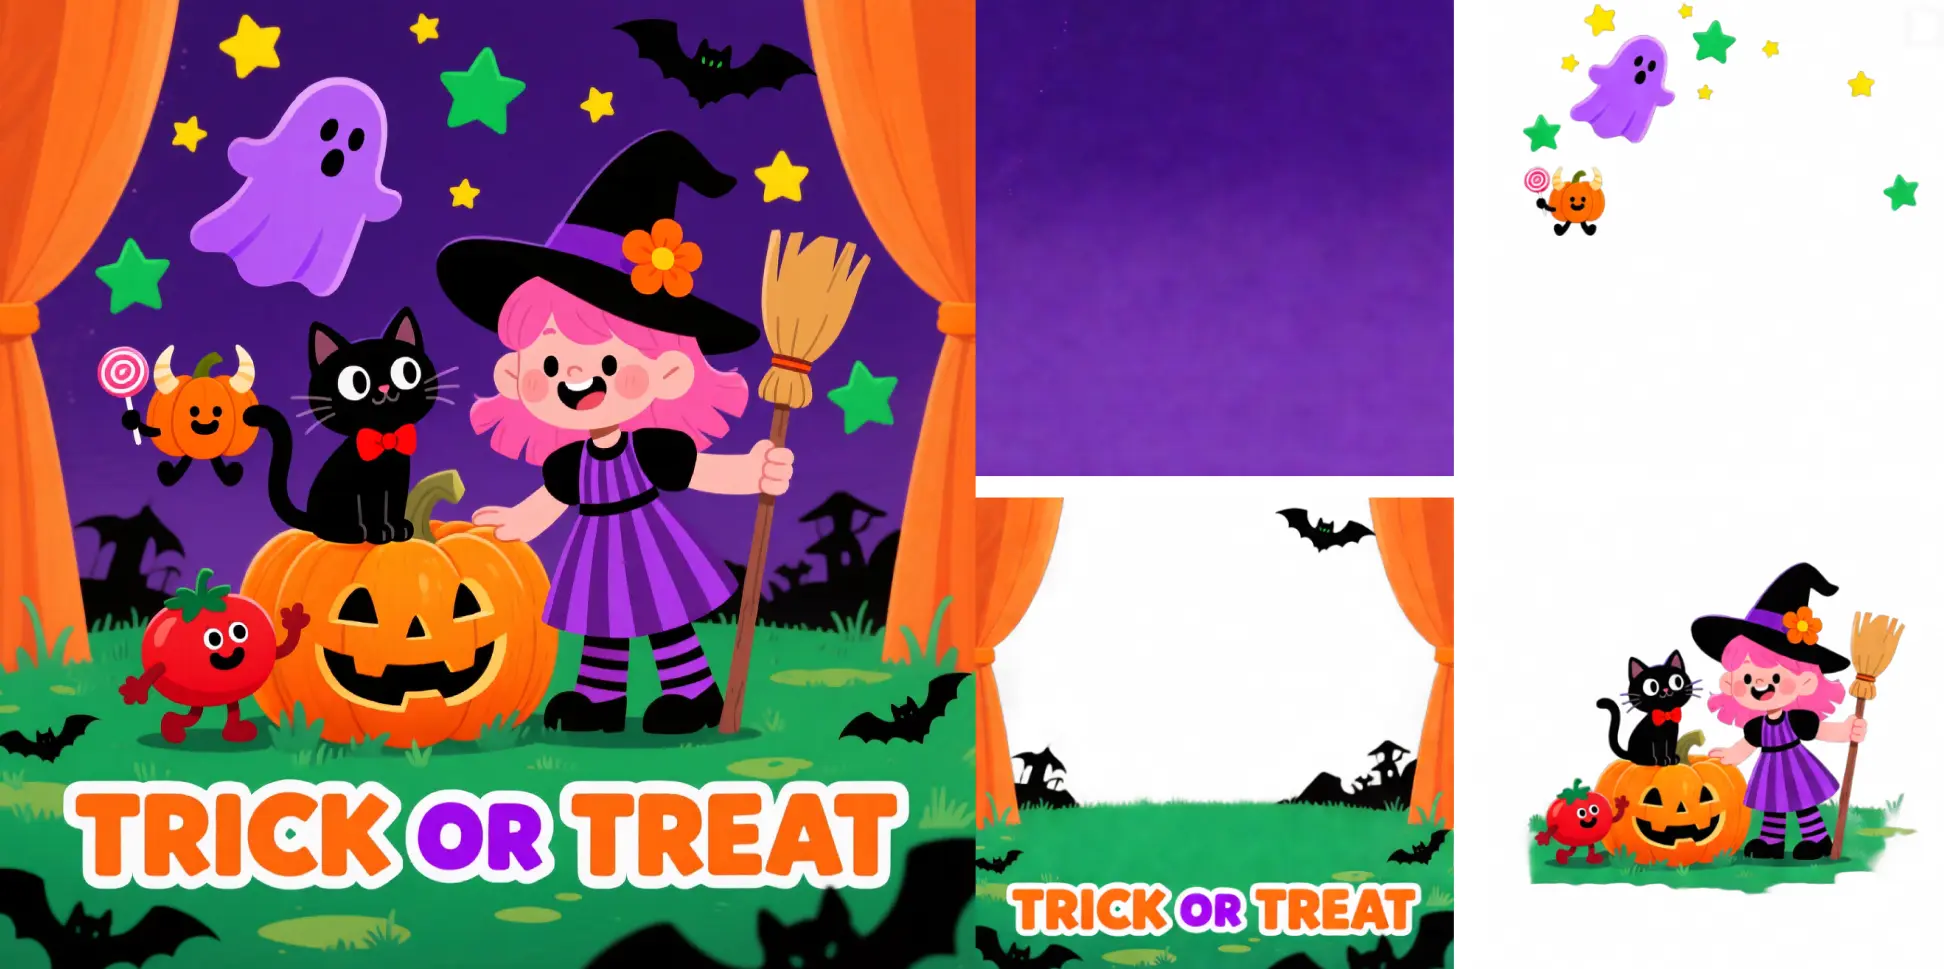
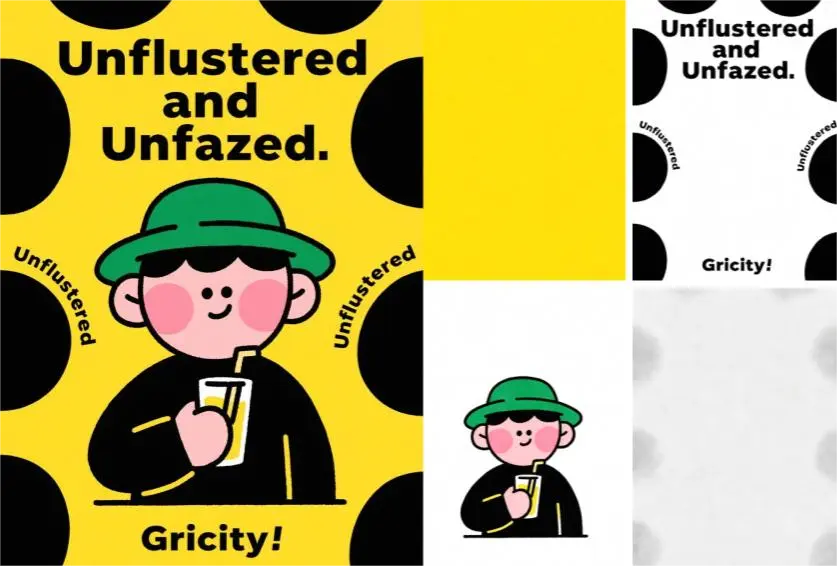
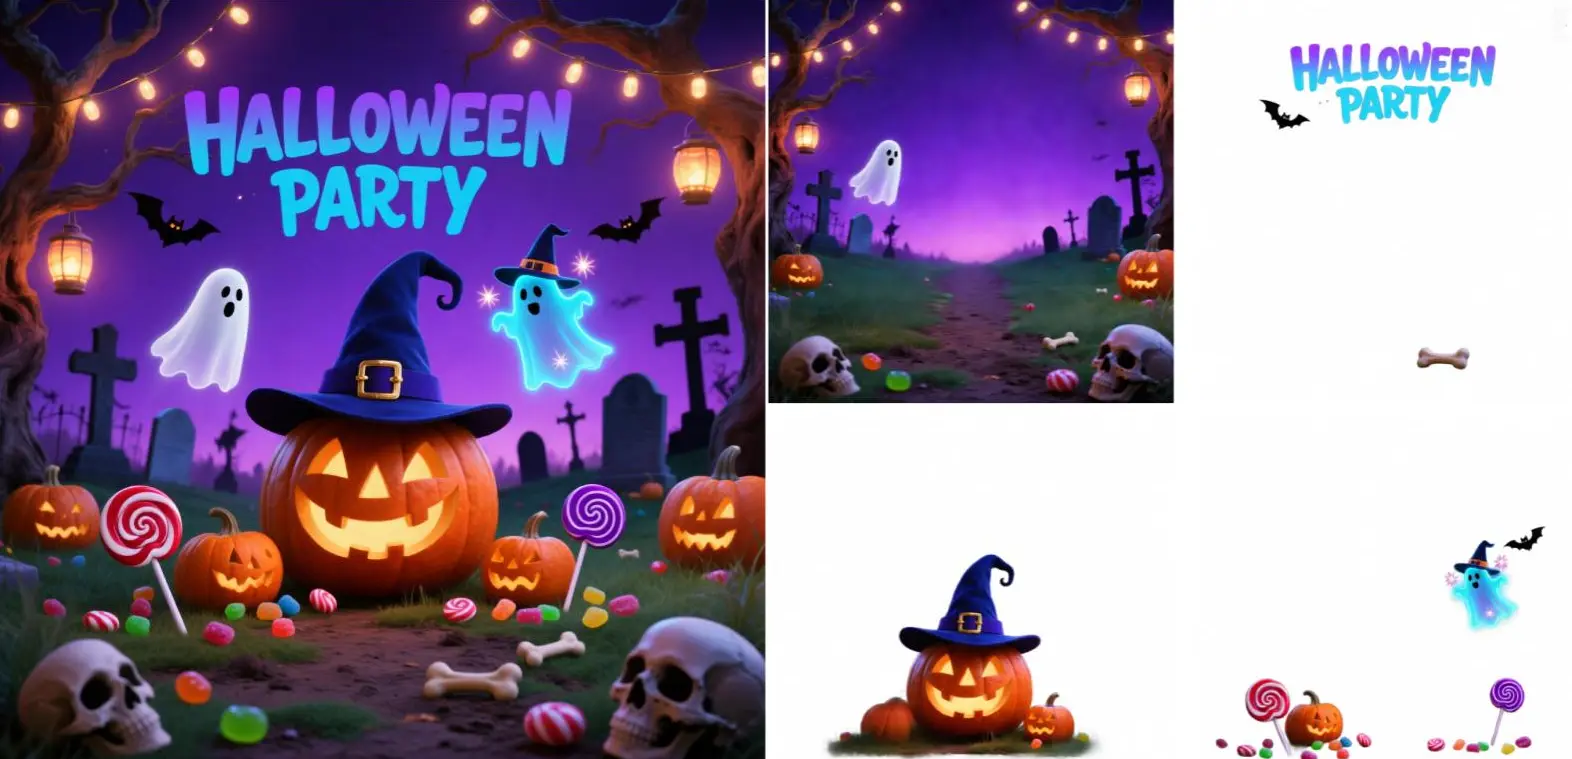
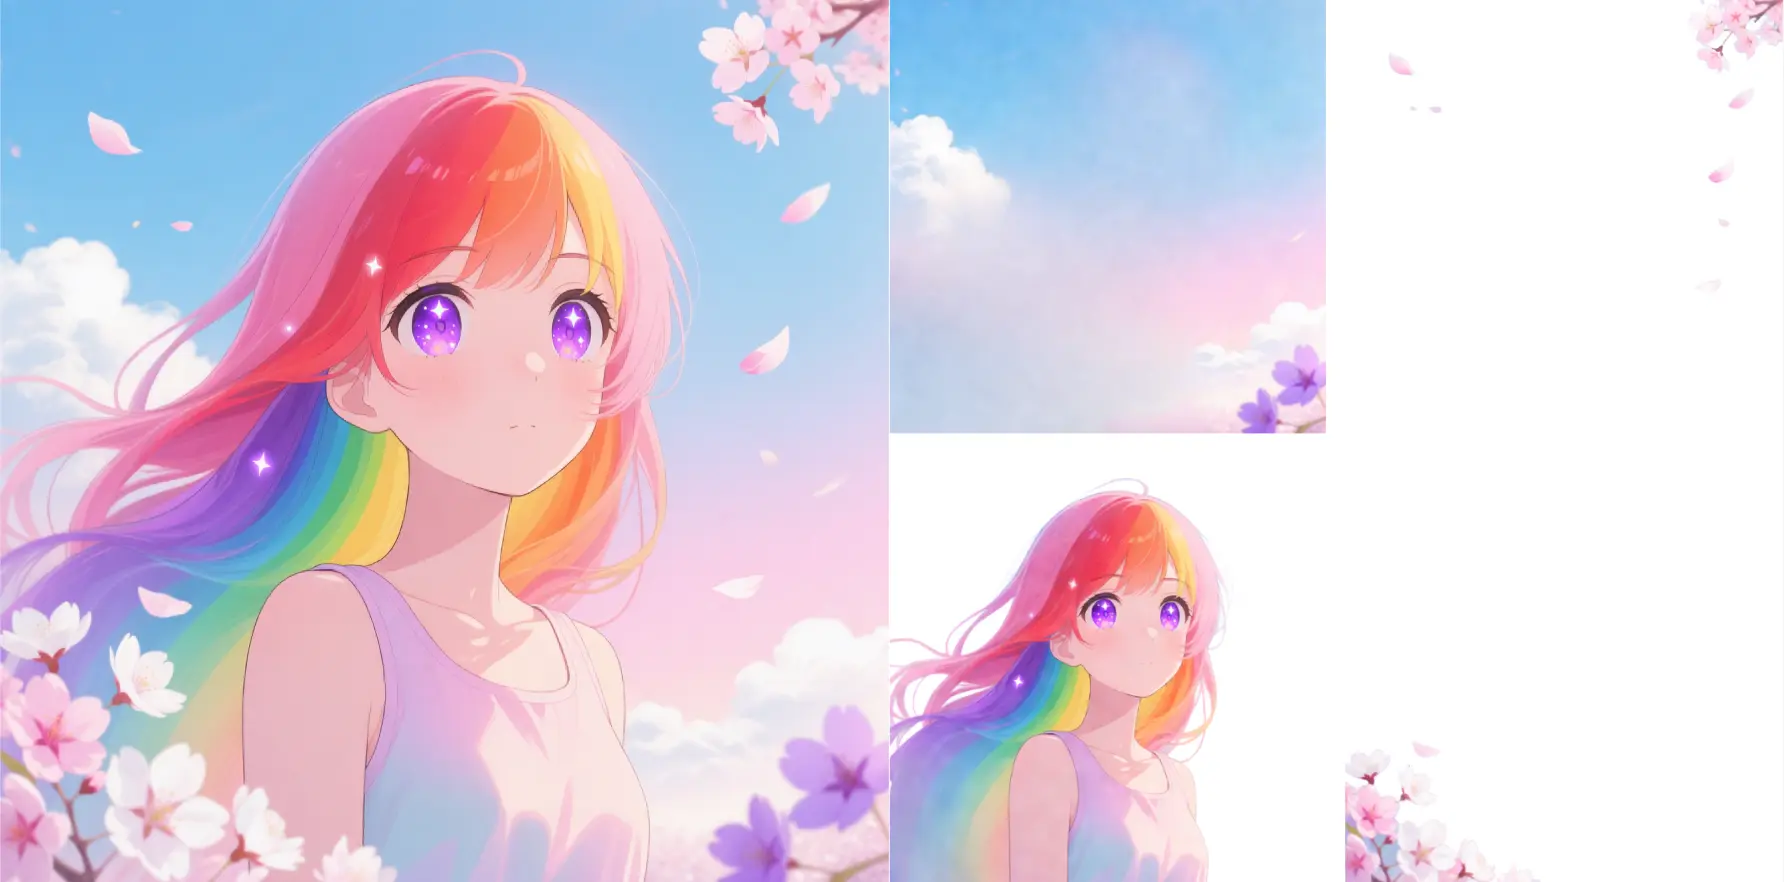
它会把一张输入图像分解为多个语义独立的 RGBA 图层。每个图层都保留透明度,可分别移动、改色、编辑或合成。
该模型采用 Apache-2.0 许可证,可按许可证条款商用。你仍需拥有输入图片的合法使用权,并遵守内容中涉及的第三方知识产权。
num_layers 范围为 1-10,num_inference_steps 为 1-50,guidance_scale 为 1-20。接口没有开放分辨率设置或提示词 token 上限。
当前 schema 没有这些输入项。接口必须提供一个 image_url,并可选用 prompt 和 negative_prompt 引导图层分解。
先在 RunComfy 浏览器界面中测试参数,再通过该模型的 RunComfy API 接口使用相同字段。image_url 为必填,其他已公开控制项可按需添加。
已发布的模型说明采用带有 Layer3D RoPE 位置嵌入的 VLD-MMDiT 主干,用于在图层间共享上下文,同时保持语义元素分离。
它的 RGBA-VAE 在共享潜在空间中表示 RGB 与 RGBA 数据,有助于为各语义组件生成一致的 Alpha 信息,便于后续编辑与合成。
它可以把包含文字的区域分到可编辑图层,但文字准确度仍会随输入与设置而变化。重要排版在投入生产前应仔细检查。
常见用途包括对象隔离、品牌素材调整、UI 组件提取、背景替换、布局原型、动画准备和 VFX 合成。
Qwen Image Edit 修改平面图像中的选定区域;Qwen Image Layered 则把图像分解为多个 RGBA 图层,更适合反复进行图层级编辑与合成。
RunComfy 是首选的 ComfyUI 平台,提供 ComfyUI 在线 环境和服务,以及 ComfyUI 工作流 具有惊艳的视觉效果。 RunComfy还提供 AI Models, 帮助艺术家利用最新的AI工具创作出令人惊叹的艺术作品。