logo
RunComfy
  • ComfyUI
  • 训练器
  • 模型
  • MCP新
  • 定价
  • Seedance 2.5火爆
  • Seedream 5.5新

按模型浏览工作流

火爆MiniMax H3根据文字、图像或参考生成带音频视频火爆Qwen Image 2.1生成图像,并按参考编辑照片Wan文字或图像生成视频,动作迁移FLUX图像生成、编辑与角色变体LTX文字或图像生成音画同步视频Qwen Image Edit用文字和参考图编辑照片Krea 2图像生成、风格迁移与参考编辑Z-Image根据文字快速生成人像和概念图

热门与最新工作流

新MiniMax H3 Character Swap V1.5替换视频角色,保留原音频新P-H3-Image Reference Edit按参考图编辑照片火爆MiniMax H3 Image-to-Video一张图生成电影感视频,音画同步火爆LTX 2.5 Image-to-Video一帧生成清晰视频,音画同步火爆MiniMax H3 Character Swap (SAM3)替换视频角色,并跟随原动作Qwen Image 2.1 Multi-Image Editing最多 10 张参考图合成精准场景FLUX Klein Face Swap自然逼真的换脸SeedVR2 Video Upscaler清晰流畅的视频超分
查看更多工作流

训练模型

新MOSS-Image Base图像生成,新支持新FLUX.3 Klein图像生成,新支持火爆Krea 2训练最多的图像模型火爆Krea 2 Turbo少步数图像生成火爆Qwen Image 2.1图像生成与编辑Z-Image Turbo快速生成人像和概念图MiniMax H3音画同步视频

训练与部署

入门指南用 Ostris AI Toolkit 完成第一个训练任务数据集上传和管理训练数据集推理在 Playground 或通过 API 运行训练好的模型部署将训练好的模型部署为专属端点
训练更多模型

图像模型

新GPT Image 2.6省 5% · 精细文生图,支持 GIF 和 SVG,最高 4K新Seedream 5.5省 10% · 文生图,最高 2K,支持透明 PNG新MiniMax H3 Image省 10% · 文字或参考图生成静帧,最高 4K新FLUX 3 Image Klein省 10% · 文字或参考图生成静帧,768 至 4K火爆Seedream 5.0 Pro省 20% · 参考图编辑,支持多语言文字火爆Seedream 4.5省 20% · 写实级编辑,保持品牌一致火爆Wan 2.6 Image按指令编辑图像Nano Banana Pro省 77% · 从草图生成精准的 2K 至 4K 图像

视频模型

新Seedance 2.5 Flash省 34% · Text, image, or reference to video新Kling 4.0省 9% · 将静态图转为 3 至 30 秒视频火爆Wan 3.0 Prime省 13% · 根据参考视频快速生成火爆Seedance 2.5省 35% · 更长、更连贯的电影感视频火爆Wan 3.0根据图像、视频和音频参考生成火爆MiniMax H3将首帧转为 5 至 15 秒视频Wan 2.5省 10% · 流畅动作,原生音频FLUX 3 Max根据文字、静态图或关键帧生成
查看更多模型

API

Serverless (ComfyUI)将 ComfyUI 工作流部署为无服务器端点。Serverless (LoRA)将 LoRA 部署为无服务器端点。Model API按需运行托管模型,无需部署。Trainer API通过 API 训练、管理和获取 LoRA。CLIRun RunComfy models from your terminal.
模型
探索
所有模型
资源库
生成记录
模型 API
API 文档
API 密钥
账户
使用情况

Kling O1 Standard Text To Video:文字生成视频 | RunComfy

kling/kling-video-o1/standard/text-to-video

根据文字提示词生成 5 秒或 10 秒视频,并从 `16:9`、`9:16`、`1:1` 中选择宽高比。

描述主体、动作、环境、镜头、光线和风格的文字提示词。
生成视频的宽高比:`16:9`、`9:16` 或 `1:1`。
生成视频的时长:5 秒或 10 秒。
Idle
The rate is $0.084 per second.

Kling O1 Standard Text To Video 简介

Kling O1 Standard Text To Video 根据必填文字提示词生成视频。你可以从 16:9、9:16、1:1 中选择 aspect_ratio,并将 duration 设为 5 秒或 10 秒。当前页面没有参考图、视频编辑或音频生成输入项。

Kling O1 Standard Text To Video 概览#


Kling O1 Standard Text To Video 直接根据必填的 prompt 生成视频。页面仅提供另外两个参数:aspect_ratio 和 duration。它不接收参考图或源视频,也没有视频编辑或音频生成输入项。


可用参数#


参数必填默认值/可选值说明
prompt是示例提示词描述主体、动作、环境、镜头、光线和风格。
aspect_ratio否默认 16:9;可选 16:9、9:16、1:1设置视频画面的宽高比。
duration否默认 5;可选 5、10设置视频时长,单位为秒。

推荐流程#


  1. 在 prompt 中先写清主体和主要动作。
  2. 按重要程度补充环境、景别、镜头运动、光线和视觉风格。
  3. 根据发布场景选择 aspect_ratio,并将 duration 设为 5 或 10。
  4. 先生成测试版本,保持提示词结构简洁,每次只调整一个细节。

使用提示#


  • 明确的动作动词和镜头方向,通常比堆叠模糊形容词更有效。
  • 当前 schema 没有分辨率、参考图、视频编辑、音频或输出格式参数。
  • 如果画面连续性很重要,请避免在同一提示词中安排过多相互依赖的动作。

示例提示词#


  • A dynamic shot of a cyclist racing through a rainy neon city at night, slow push-in, reflections on wet asphalt, moody rim light.
  • Cozy kitchen scene with a steaming cup on a wooden table, shallow depth of field, gentle camera pan left, morning soft light, aspect_ratio 16:9, duration 5.
  • Desert rover crossing dunes at golden hour, wide shot, tripod locked, dust trailing, realistic shadows, aspect_ratio 1:1, duration 10.
  • A puppy running across a sunlit park, handheld feel with slight sway, bright color grade, natural motion emphasized.
  • Futuristic drone flythrough of a glass atrium, parallax on balconies, smooth forward dolly, controlled highlights.

相关模型#


Kling O1 Standard 图生视频

相关模型

seedance-2.0-mini/text-to-video

快速、低成本的多镜头 AI 视频模型,原生支持音频和参考素材。

flux-3-max/keyframes-to-video

FLUX 3 Max Keyframes To Video 将最多十张静止图像连接成一个片段。

wan-2-2/lora/text-to-image

根据提示词生成图像,并设置 LoRA、图像尺寸、格式和随机种子。

seedance-2.5-flash/text-to-video

Seedance 2.5 Flash Text To Video 根据提示写了 480p 和 720p 片段。

runway-gen-4/turbo/image-to-video

精准匹配文本提示,生成动作真实、结构连贯的视频内容

Hailuo Video 01 Director

内置镜头运动指令与分镜模板,轻松实现高质量影视创作

常见问题

Kling O1 Standard Text To Video 是什么?

Kling O1 Standard Text To Video 根据必填的 prompt 生成视频。你可以从 16:9、9:16、1:1 中选择 aspect_ratio,并将 duration 设为 5 秒或 10 秒。

它与早期 Kling 版本有什么不同?

当前页面没有提供与早期 Kling 版本对比的架构、速度或质量数据。这里能够确认的是一个聚焦的文生视频工作流,以及宽高比和时长参数。

Kling O1 Standard Text To Video 如何计费?

RunComfy 采用积分系统。每次生成所需的实际积分以模型页面生成区域显示的信息为准,当前 schema 并未承诺永久免费额度。

哪些人适合使用 Kling O1 Standard Text To Video?

它适合希望把简洁场景描述转化为短视频概念、分镜草稿或营销素材的电影制作人、广告创作者、设计师和社交媒体创作者。

这个页面支持视频编辑或参考图吗?

不支持。当前文生视频页面没有图片、源视频或编辑输入项。如果需要由现有画面引导结果,请使用单独的图生视频或视频编辑模型。

可以期待怎样的输出质量和分辨率?

结果质量取决于提示词、画面构成和所选时长。当前 schema 没有分辨率参数,也未保证固定输出 480p、720p 或 1080p 视频。

在哪里可以使用 Kling O1 Standard Text To Video?

该模型由 RunComfy 托管,可直接通过模型页面使用,无需在本地安装或运行模型。

这个页面有哪些限制?

页面仅提供 prompt、aspect_ratio 和 duration。复杂或相互矛盾的动作可能难以准确呈现,建议优先写清主体、动作、镜头和场景。

Kling O1 Standard Text To Video 会同时生成声音吗?

当前 schema 没有音频参数,因此这个页面没有说明内置声音生成或 Kling-Foley 输出能力。

关注我们
  • 领英
  • Facebook
  • Instagram
  • Twitter
支持
  • Discord
  • 电子邮件
  • 系统状态
  • 附属
视频模型
  • Seedance 2.5 Flash Text To Video
  • Seedance 2.5 Flash
  • Seedance 2.5 Flash Reference to Video
  • Wan 3.0
  • MiniMax H3 Fast
  • Wan 2.5
  • 查看所有模型 →
图像模型
  • Seedream 5.5
  • Seedream 5.5 Edit
  • Seedream 5.5 Layer Decomposition
  • Wan 2.6 Image to Image
  • Nano Banana Pro
  • Seedream 5.0 Pro
  • 查看所有模型 →
法律
  • 服务条款
  • 隐私政策
  • Cookie 政策
RunComfy
版权 2026 RunComfy. 保留所有权利。

RunComfy 是首选的 ComfyUI 平台,提供 ComfyUI 在线 环境和服务,以及 ComfyUI 工作流 具有惊艳的视觉效果。 RunComfy还提供 AI Models, 帮助艺术家利用最新的AI工具创作出令人惊叹的艺术作品。
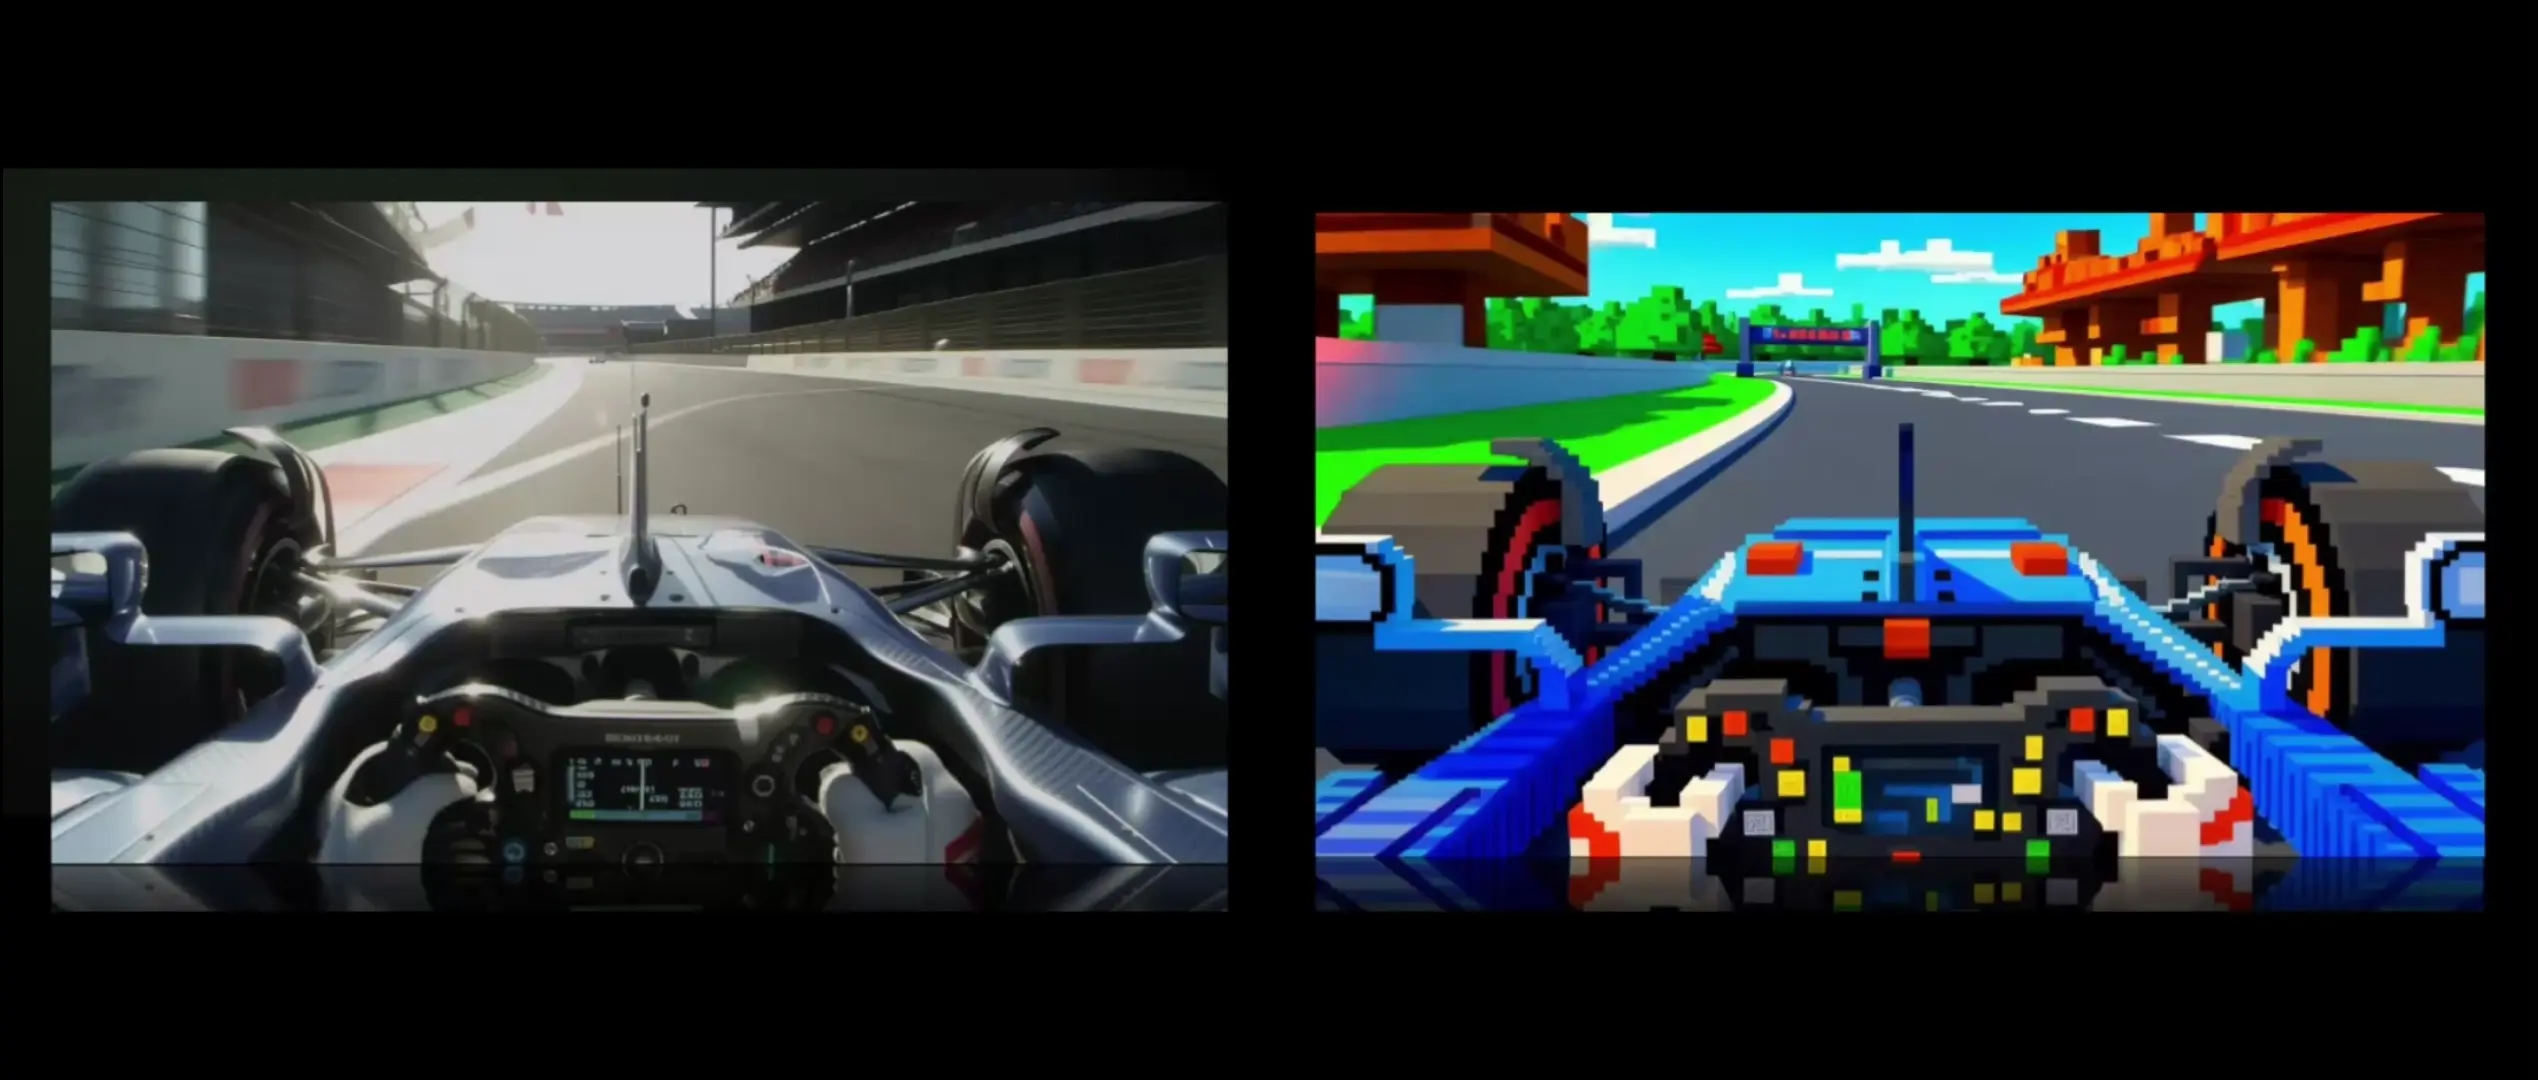
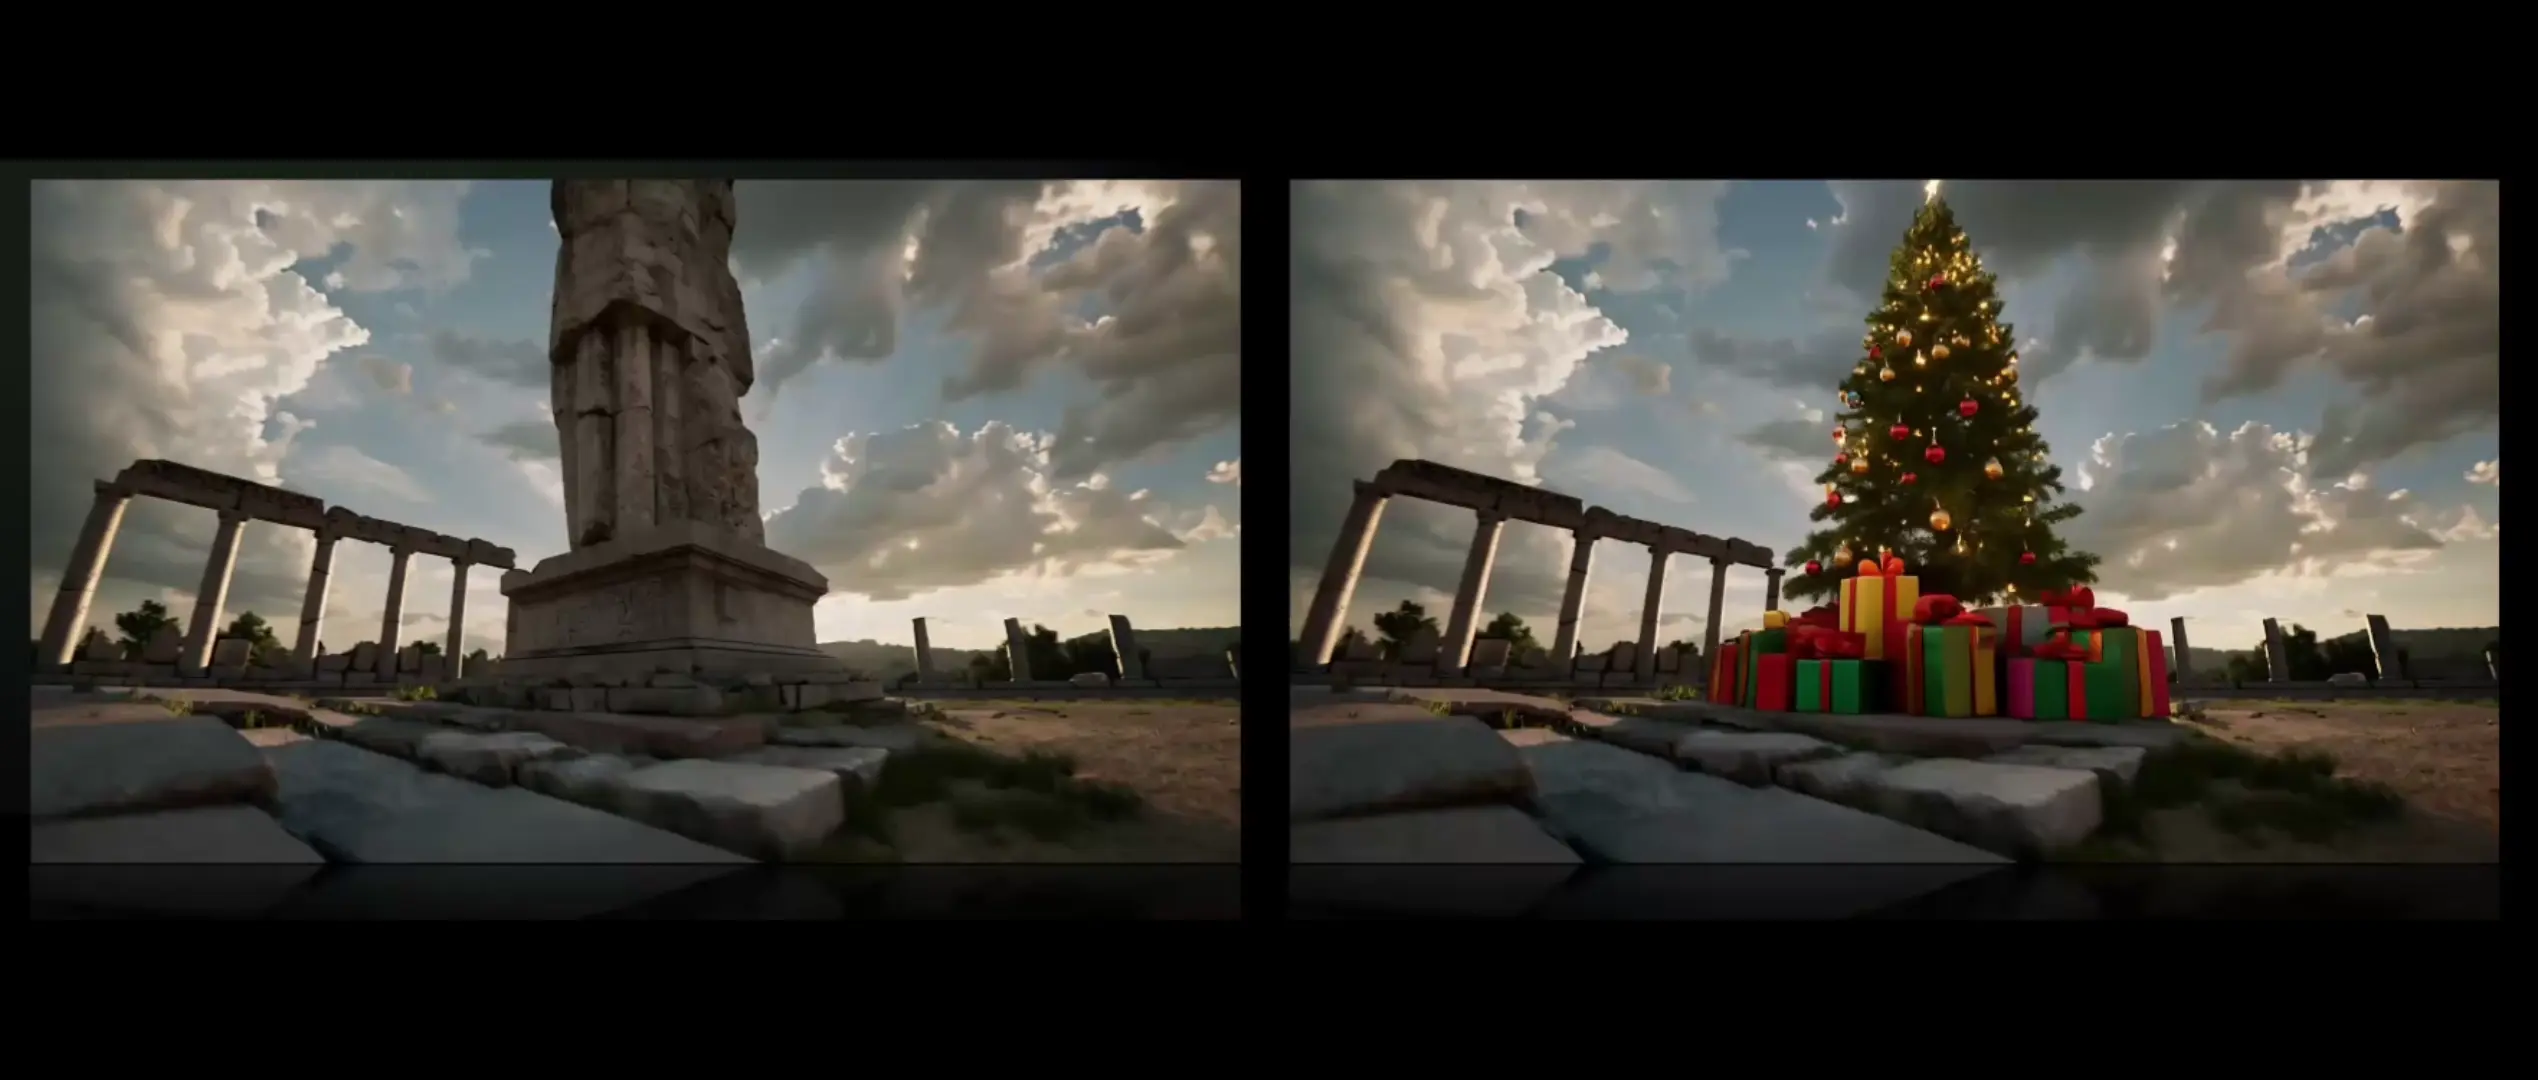
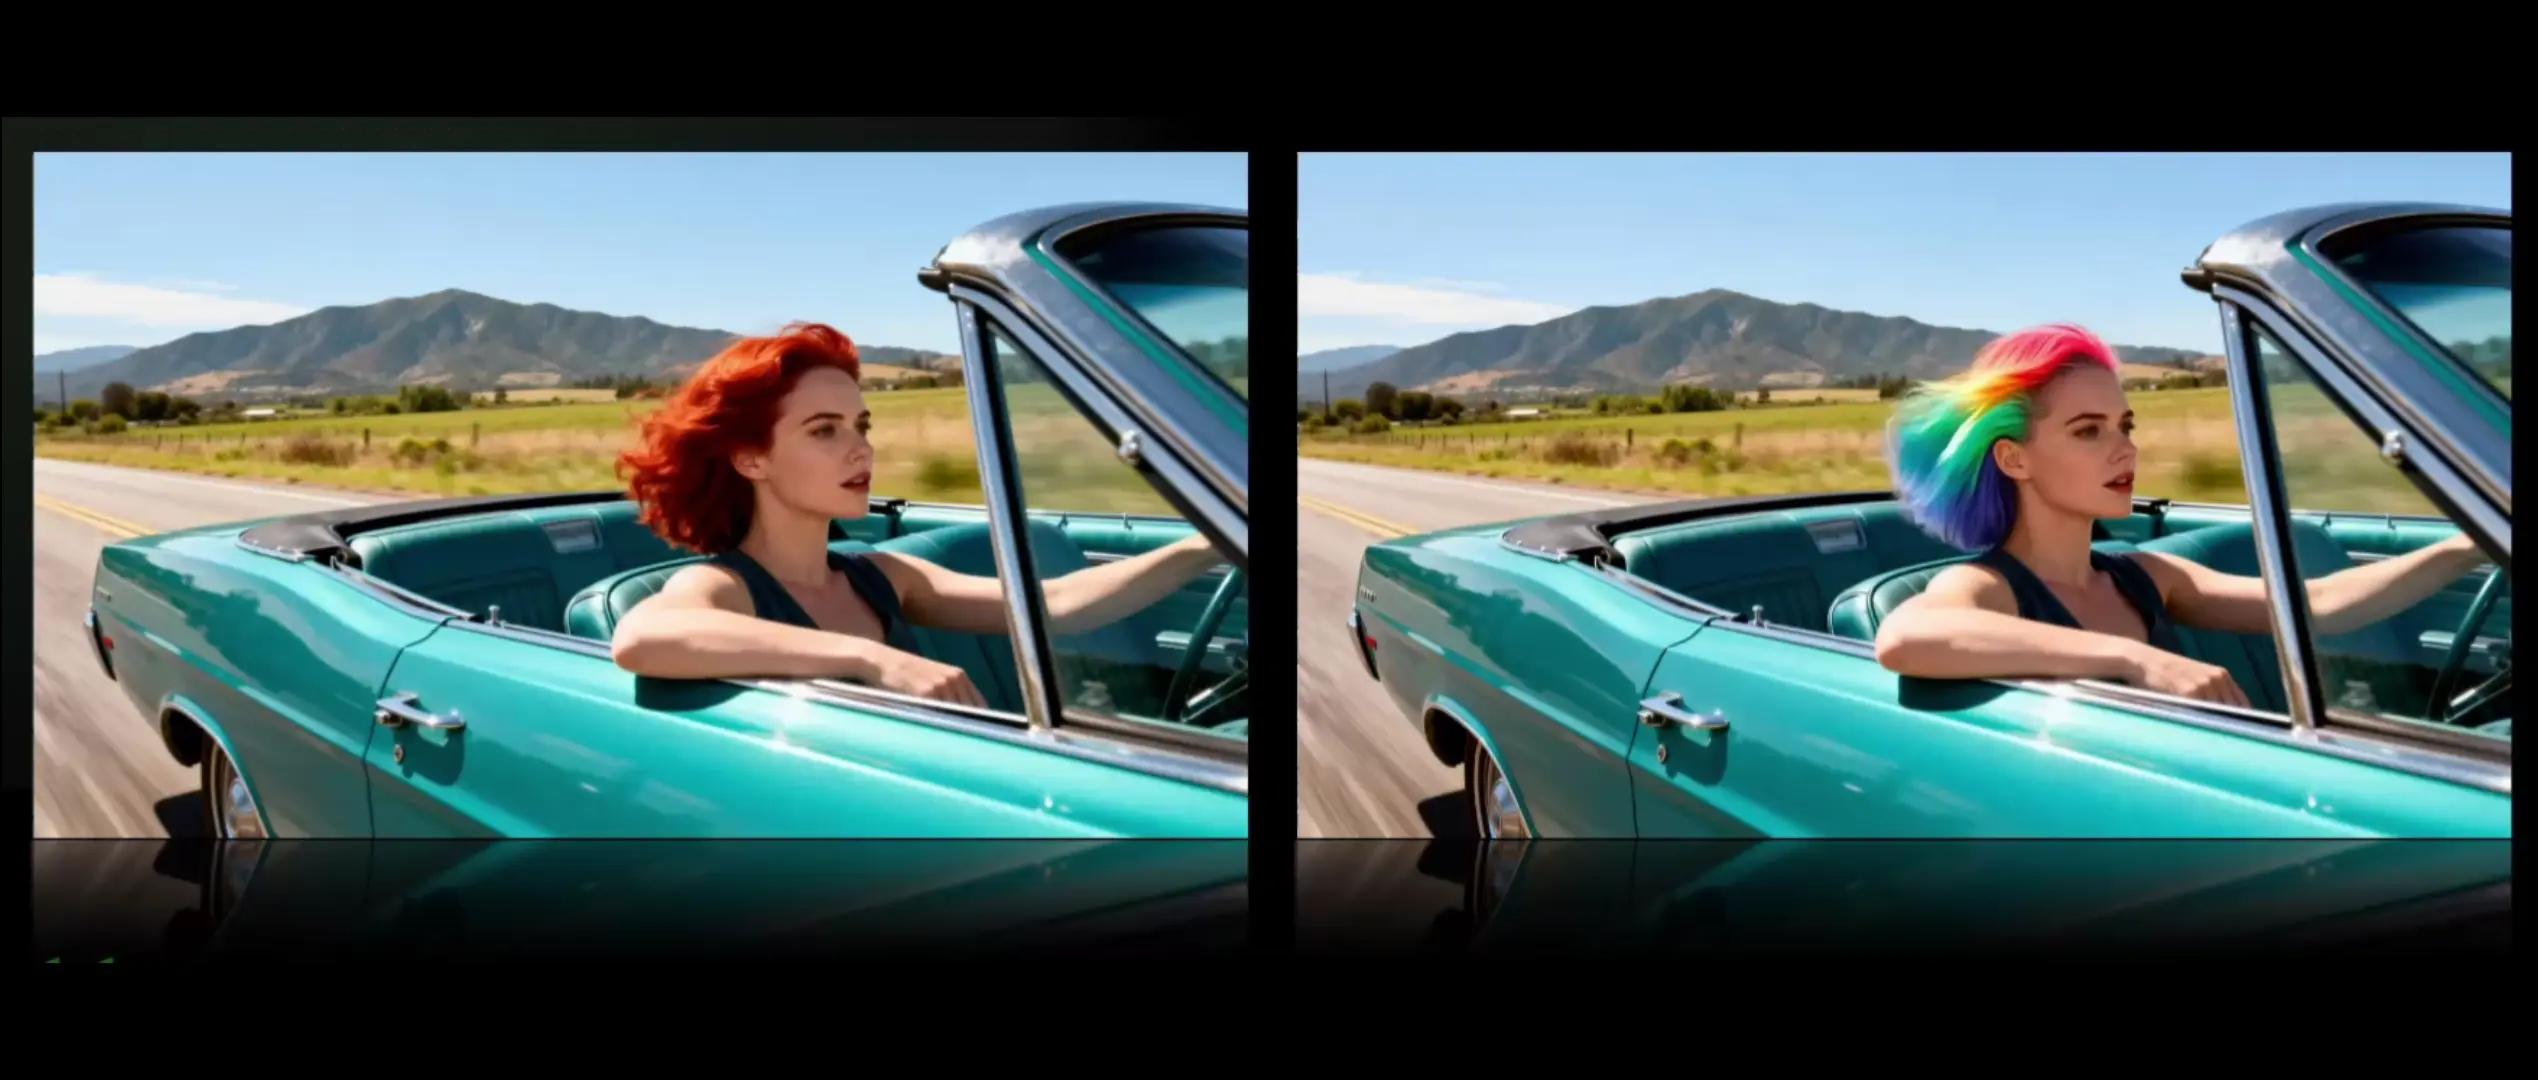
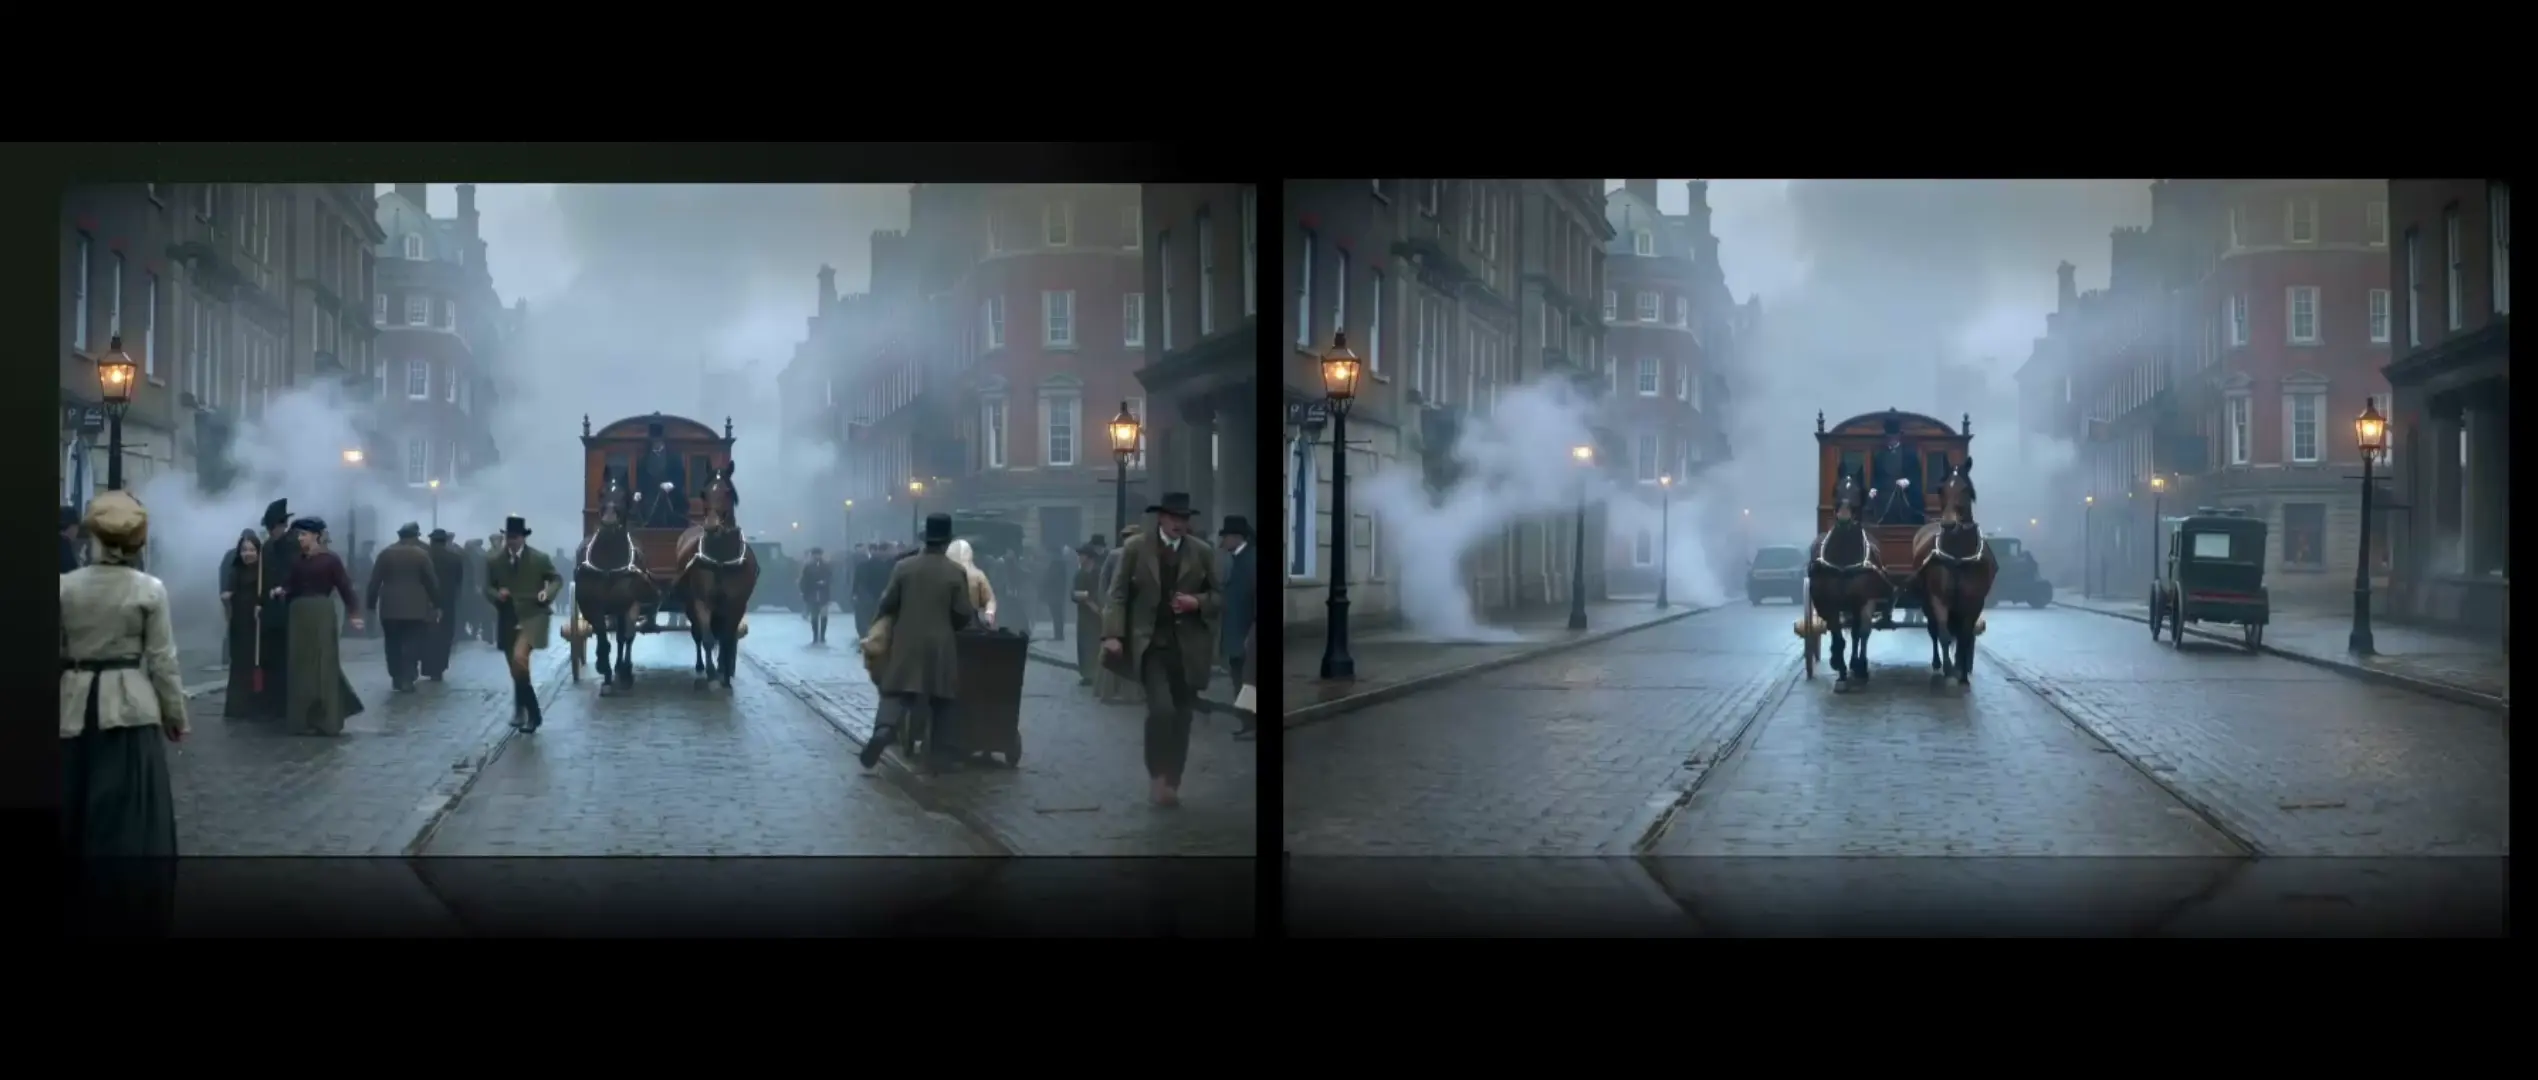
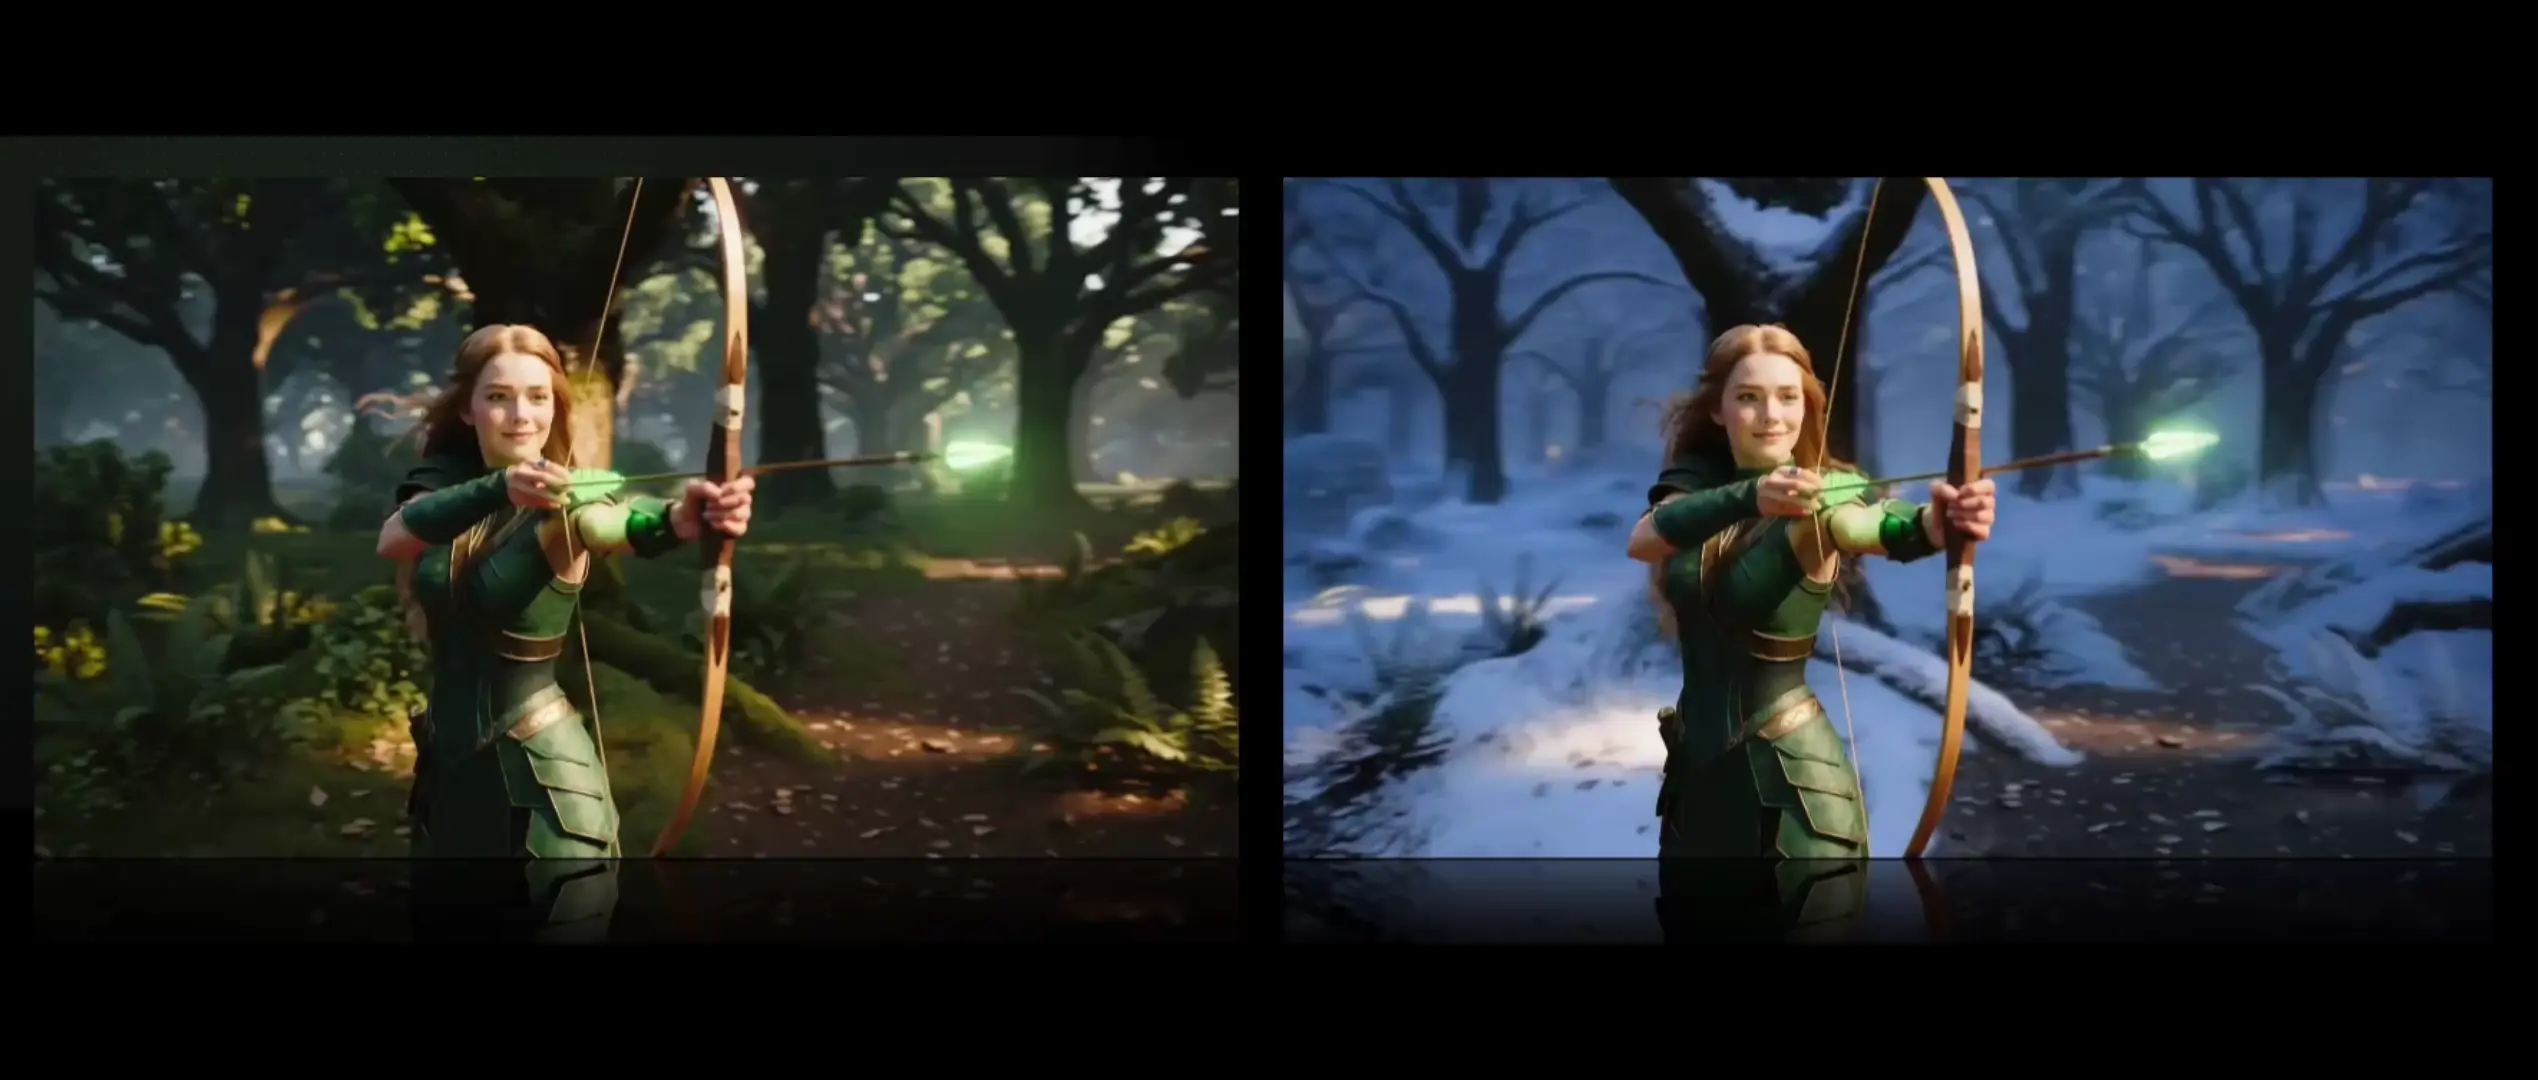
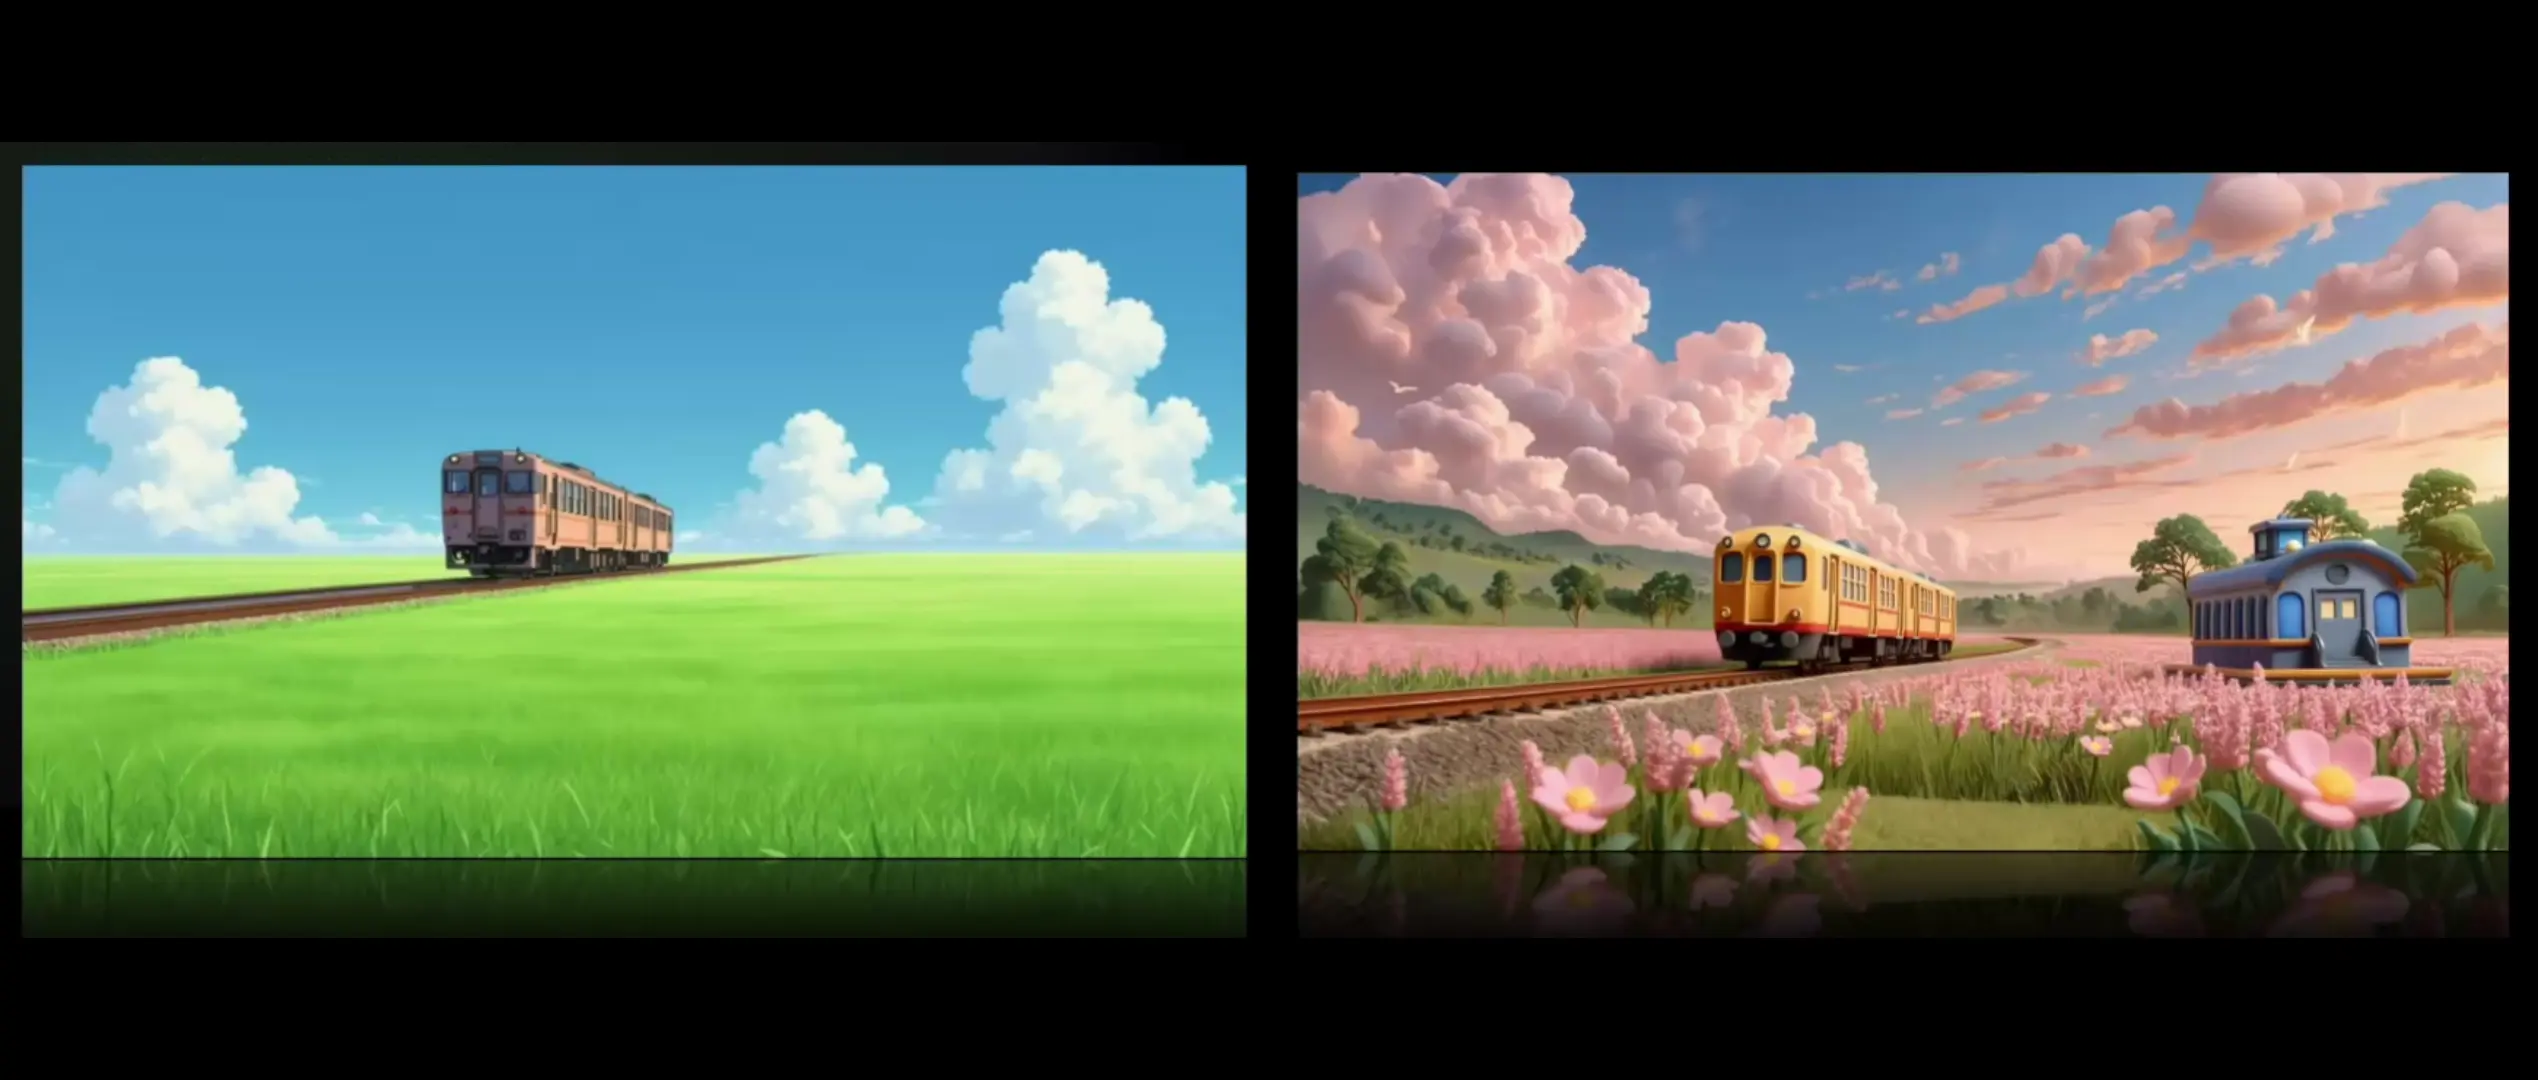
Kling O1 Standard Text To Video 生成示例

Video thumbnail
Loading...
Video thumbnail
Loading...
Video thumbnail
Loading...
Video thumbnail
Loading...
Video thumbnail
Loading...
Video thumbnail
Loading...