logo
RunComfy
  • ComfyUI
  • ТренерНовое
  • Модели
  • API
  • Цены
discord logo
МОДЕЛИ
Обзор
Все модели
БИБЛИОТЕКА
Генерации
API МОДЕЛЕЙ
Документация API
API-ключи
АККАУНТ
Использование

WAN 2.2 LoRA: текст в изображение, размер и формат | RunComfy

wan-ai/wan-2-2/lora/text-to-image

Преобразуйте текст в изображение и настройте LoRA, размер, формат и seed.

Опишите объект, действие, окружение, композицию и желаемое визуальное направление.
LoRA #1
URL или ID репозитория Hugging Face (owner/repo) с весами LoRA.
Выберите `high`, `low` или `both`; по умолчанию — `both`.
Интенсивность применения от 0 до 4; по умолчанию — 1.
Обязательный список максимум из 3 LoRA; путь может быть URL или ID репозитория Hugging Face.
Выберите один из 7 размеров, включая `Custom`; по умолчанию — `square_hd`.
Выберите `png` или `jpeg`; по умолчанию — `jpeg`.
Целочисленный seed от 10000 до 99999.
Idle
The rate is $0.05 per image.

WAN 2.2 LoRA: текст в изображение

На этой странице преобразования текста в изображение используются промпт и обязательный список максимум из 3 LoRA. Для каждого LoRA можно задать путь, цель (high, low или both) и интенсивность от 0 до 4.

Доступны размеры square_hd, square, portrait_4_3, portrait_16_9, landscape_4_3, landscape_16_9, Custom. Формат вывода — png или jpeg; также можно настроить seed от 10000 до 99999.

Похожие модели

seedance-2.5/reference-to-video/480p

Seedance 2.5 Ссылка 480p: черновой вариант видеоролика с несколькими ссылками по более низкой цене.

infinite-talk/fast/multi

Создавайте видео по двум аудиодорожкам и изображению и задавайте порядок реплик.

video-background-removal/fast/video-to-video

Удаляйте фон версией Fast и настраивайте кодек, уточнение краёв и тип объекта.

react-1

Создайте короткое исходное видео с необходимой звуковой дорожкой, затем управляйте эмоциями, редактируйте масштаб, поведение при несоответствии длительности и выразительность.

wan-2.7/text-to-video

Создавайте ролики в 1080p с несколькими референсами и управлением кадрами.

seedance-2.0-mini/video-to-video

Изменяйте исходный ролик по текстовому промпту и создавайте синхронизированный нативный звук.

Часто задаваемые вопросы

Что делает WAN 2.2 LoRA на этой странице?

Создает изображение по текстовому промпту и применяет выбранные LoRA.

Какие поля обязательны?

prompt и loras обязательны; список содержит не более 3 LoRA.

Какие настройки есть у каждого LoRA?

Путь, цель (high, low или both) и интенсивность от 0 до 4; значения по умолчанию — both и 1.

Какие размеры изображения доступны?

square_hd, square, portrait_4_3, portrait_16_9, landscape_4_3, landscape_16_9, Custom; по умолчанию — square_hd.

Для чего используется `Custom`?

Custom — один из доступных вариантов размера.

Какие форматы изображения доступны?

png и jpeg; по умолчанию — jpeg.

Каков диапазон seed?

seed — от 10000 до 99999; значение по умолчанию — 74965.

Подписывайтесь на нас
  • LinkedIn
  • Facebook
  • Instagram
  • Twitter
Поддержка
  • Discord
  • Email
  • Статус системы
  • партнёр
Модели видео
  • Kling 4.0 Image to Video
  • Kling 4.0 Reference to Video
  • Kling 4.0 Video Editing
  • Wan 3.0
  • Wan 2.5
  • MiniMax H3 Fast
  • Посмотреть все модели →
Модели изображений
  • Seedream 4.5
  • Seedream 5.0 Pro
  • Flux 2 Pro
  • Qwen Image Edit 2511 LoRA
  • seedream 4.0
  • Nano Banana Pro
  • Посмотреть все модели →
Юридическая информация
  • Условия обслуживания
  • Политика конфиденциальности
  • Политика в отношении файлов cookie
RunComfy
Авторское право 2026 RunComfy. Все права защищены.

RunComfy - ведущая ComfyUI платформа, предлагающая ComfyUI онлайн среду и услуги, а также рабочие процессы ComfyUI с потрясающей визуализацией. RunComfy также предоставляет AI Models, позволяя художникам использовать новейшие инструменты AI для создания невероятного искусства.
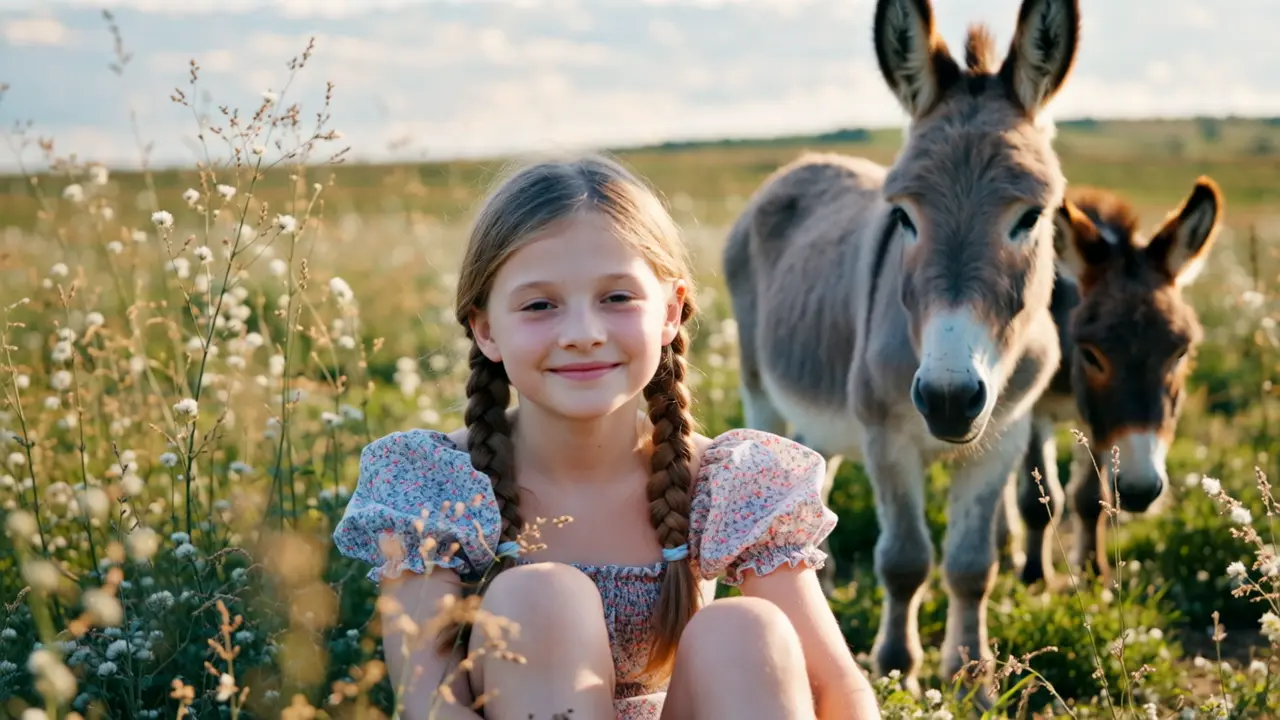
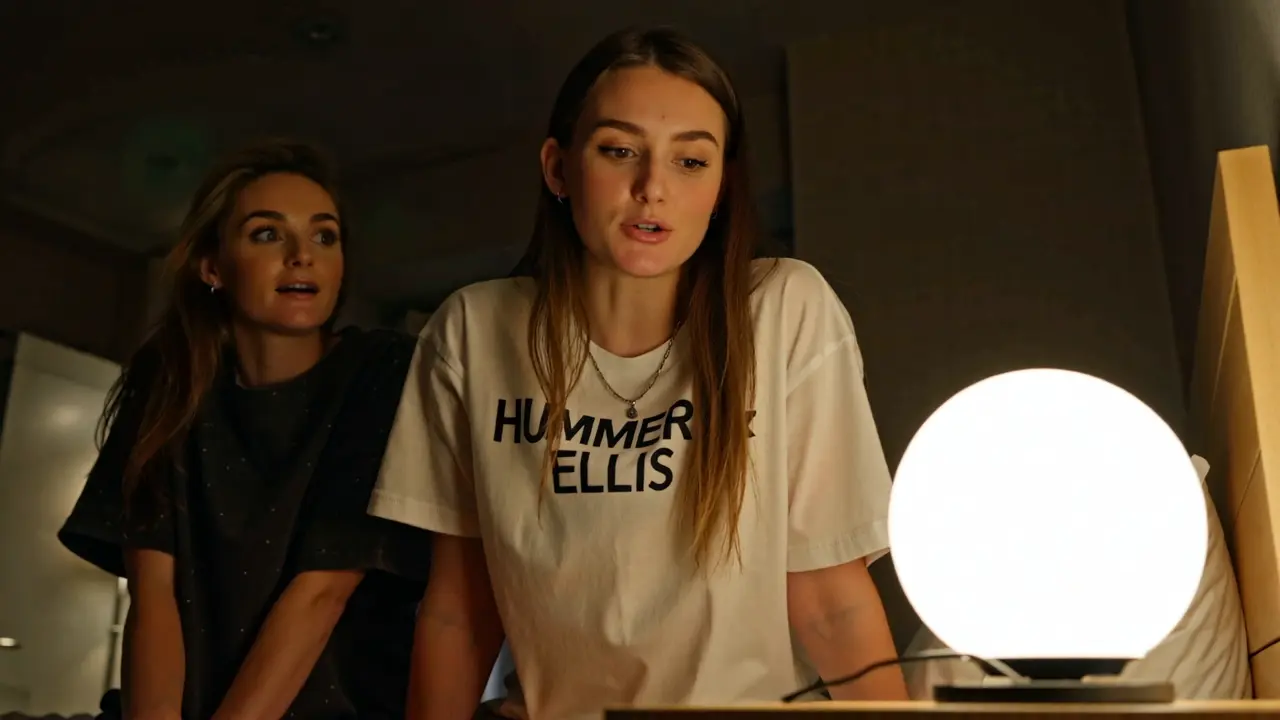
Примеры WAN 2.2 LoRA: текст в изображение