logo
RunComfy
  • ComfyUI
  • トレーナー
  • モデル
  • MCP新着
  • 価格
  • Seedance 2.5話題
  • Seedream 5.5新着

モデル別ワークフロー

話題MiniMax H3テキスト・画像・参照から音声付き動画話題Qwen Image 2.1画像生成と参照での写真編集Wanテキストや画像から動画、モーション転送FLUX画像生成・編集・キャラクターのバリエーションLTXテキストや画像から音声同期動画Qwen Image Editテキストと参照画像で写真編集Krea 2画像生成・スタイル転送・参照編集Z-Imageテキストから素早く人物や構想を生成

人気・新着ワークフロー

新着MiniMax H3 Character Swap V1.5動画の人物を差し替え、元の音声は保持新着P-H3-Image Reference Edit参照画像に沿って写真を編集話題MiniMax H3 Image-to-Video1 枚の画像から音声同期のシネマティック動画話題LTX 2.5 Image-to-Video1 フレームから音声同期の鮮明な動画話題MiniMax H3 Character Swap (SAM3)動きに合わせて動画の人物を差し替えQwen Image 2.1 Multi-Image Editing最大 10 枚の参照画像から精密なシーンFLUX Klein Face Swap自然でリアルな顔の入れ替えSeedVR2 Video Upscaler鮮明で滑らかな動画アップスケール
その他のワークフローを見る

モデルをトレーニング

新着MOSS-Image Base画像生成、新たに対応新着FLUX.3 Klein画像生成、新たに対応話題Krea 2最も多くトレーニングされた画像モデル話題Krea 2 Turbo少ステップで画像生成話題Qwen Image 2.1画像生成と編集Z-Image Turbo人物やコンセプト画像を素早く生成MiniMax H3音声同期の動画

トレーニングとデプロイ

はじめにOstris AI Toolkit で最初のトレーニングデータセットトレーニング用データセットのアップロードと管理推論学習済みモデルを Playground や API で実行デプロイメント学習済みモデルを専用エンドポイントで提供
その他のモデルをトレーニング

画像モデル

新着GPT Image 2.65% OFF · 精細なテキストから画像生成、GIF・SVG 対応、最大 4K新着Seedream 5.510% OFF · 最大2Kのテキストから画像生成、透過PNG対応新着MiniMax H3 Image10% OFF · テキストまたは参照画像から、最大4Kの静止画新着FLUX 3 Image Klein10% OFF · テキストまたは参照画像から、768〜4Kの静止画話題Seedream 5.0 Pro41% OFF · 参照画像での編集、多言語テキスト対応話題Seedream 4.520% OFF · ブランドの一貫性を保つフォトリアルな編集話題Wan 2.6 Image指示ベースの画像編集Nano Banana Pro77% OFF · スケッチから精密な 2K〜4K ビジュアル

ビデオモデル

新着Seedance 2.5 Flash34% OFF · Text, image, or reference to video新着Kling 4.010% OFF · 静止画を 3〜30 秒の動画に話題Wan 3.0 Prime13% OFF · 参照動画からすばやく生成話題Seedance 2.536% OFF · より長く一貫性の高いシネマティック動画話題Wan 3.0画像・動画・音声の参照から生成話題MiniMax H3最初のフレームを 5〜15 秒の動画にWan 2.510% OFF · 滑らかな動きとネイティブ音声FLUX 3 Maxテキスト・静止画・キーフレームから生成
その他のモデルを見る

API

Serverless (ComfyUI)ComfyUIワークフローをサーバーレスエンドポイントとしてデプロイ。Serverless (LoRA)LoRAをサーバーレスエンドポイントとしてデプロイ。Model APIデプロイ不要でホストされたモデルをオンデマンドで実行。Trainer APIAPI で LoRA のトレーニング、管理、取得を行います。CLIRun RunComfy models from your terminal.
モデル
探索
すべてのモデル
ライブラリ
生成履歴
モデルAPI
APIドキュメント
APIキー
アカウント
使用量

Wan 2.7 Text-to-Image:AI画像をオンライン生成 | Models・API | RunComfy

wan-ai/wan-2.7/text-to-image

WAN 2.7は、中国語・英語のプロンプト、ネガティブプロンプト、サイズプリセット、1回最大5枚の出力、再現用シードに対応した高品質な画像生成モデルです。RunComfyでは1枚約0.03米ドルです。セーフティチェックも設定できます。

生成したい画像を説明するテキストプロンプトです。中国語と英語に対応します。
生成画像から除外したい内容です。最大500文字。
出力サイズのプリセットです。対応環境では、プリセット文字列の代わりにカスタムの`{width, height}`オブジェクトを送信できます。
生成する画像の最大枚数(1~5枚)。デフォルトは1枚です。
結果を再現するためのランダムシード(0~2147483647)。
Idle
The rate is $0.03 per image.

Wan 2.7テキスト画像生成の概要

AlibabaのWan 2.7テキスト画像生成は、実制作向けの静止画に適しています。プロンプトへの高い忠実度、中国語と英語の指示、image_sizeによる実用的なサイズ指定が特長です。RunComfyではprompt、negative_prompt、image_size、max_images、seedを設定できます。Wan 2.7ファミリーは、構図を論理的に組み立て、指示を正確に反映したい場面に向いています。enable_safety_checkerでセーフティチェックも設定できます。

最適な用途:マーケティング画像 | コンセプトアート | SNS用クロップ | Pro版で仕上げる前のレイアウト検討

Wan 2.7テキスト画像生成#


概要#


RunComfyのWan 2.7 Text-to-Imageは、中国語または英語のプロンプトを静止画に変換します。プロンプトを正確に理解し、細部まで描写することを重視しています。最大解像度と固定上限は、RunComfyの現在の提供仕様に準じます。


レスポンスフィールド#


正常に完了したリクエストでは、images配列に1~5枚の画像、任意のモデル生成テキストgenerated_text、およびseedが返されます。


主な機能#


  • バイリンガル プロンプト: 英語と中国語がサポートされています。
  • 否定的なプロンプト: 不要な要素を避けるための最大 500 文字。
  • image_size プリセット: square_hd、square、ポートレートおよびランドスケープ 4:3 および 16:9。 {width, height} オブジェクトは高度な統合でサポートされる場合があります。
  • バッチ探索: max_images 1 ~ 5 1 つのジョブのバリエーション。
  • 再現性: 任意の整数seed(範囲:[0, 2147483647])。
  • 安全性: enable_safety_checker は入力と出力を管理します (デフォルトはオン)。

パラメータ#

パラメータ必須型デフォルト範囲 / 選択肢説明
prompt*はいstring——主な被写体、スタイル、構図
negative_promptいいえstring""最大500文字除外したい内容
image_sizeいいえstringsquare_hdenum presets出力の比率・サイズ
max_imagesいいえinteger11–5生成する画像枚数
seedいいえinteger—0–2147483647結果の再現
enable_safety_checkerいいえbooleantrueon / off入出力の安全性チェック

料金#

課金単位料金
生成画像1枚あたり0.03米ドル

料金は、1 回のリクエスト内の画像の数 (max_images) に応じて変わります。


使い方#


  1. 被写体、環境、照明、レンズ、スタイルなどの構造化されたプロンプトを作成します。
  2. 抑制したい具体的な内容に対してのみ、短い negative_prompt を追加します。
  3. 配信のアスペクト比に一致するサイズのプリセットを選択します。
  4. バリエーションを調べるときは、max_imagesを 1 より大きく設定します。プロンプト編集を比較するためにseedを固定したままにします。
  5. 送信して繰り返します。構図がずれている場合は、カメラのボキャブラリーを引き締めてください。

プロンプトのヒント#


  • 主人公の被写体を最初に示し、次に照明とマテリアルを配置します。
  • 一致するプリセットを使用していない場合は、アスペクトのニーズを明示的に指定します。
  • 反復の場合、一度に 1 つのディメンション (プロンプト、シード、サイズ) を変更します。

関連するWan 2.7モデル#


  • RunComfy の Wan 2.7 Text-to-Image Pro — より忠実度の高い層。
  • RunComfy の Wan 2.7 Image Edit — 参照主導の編集。
  • Wan 2.7 Text-to-Video — RunComfy のモーション ワークフロー。

関連モデル

wan-2-5/text-to-image

2000文字未満の必須プロンプトから画像を生成します。任意のネガティブプロンプトを追加し、13種類の出力サイズから選択できます。

wan-2-6/image-to-image

Wan 2.6 Image-to-Image:シームレスなビジュアル編集とスケーラブルなスタイル適応のための指示ベースAI

seedream-5.5/edit

最大十枚の参照画像を1つの 1K、1.5K、または 2K の静止画に編集します。

gpt-image-2.5/sunburst/text-to-image

高精度のテキストから画像への変換により、洗練されたプロダクショングレードのビジュアルが実現します。

ideogram-v3/remix

Ideogram 3でプロンプトに沿って画像をリミックスし、画像の重み、アスペクト比などを設定します。

flux-2/max/edit

選択可能なサイズのプリセット、シード、JPEG または PNG 出力を使用して、テキストの指示から 1 ~ 10 個の参照画像を編集します。

よくある質問

RunComfy で Wan 2.7 のテキストから画像への変換を強化するものは何ですか?

RunComfyは、Alibabaのモデルファミリーに含まれるWan 2.7 Text-to-Imageを統合しています。ドキュメントで定義されたprompt、negative_prompt、image_size、max_images、seed、enable_safety_checkerが、このモデル用の推論サービスに送信されます。

Wan 2.7 のテキストから画像への RunComfy の画像あたりのコストはいくらですか?

RunComfyの料金は、生成画像1枚あたり0.03米ドルです。max_imagesを2以上にすると、タスクが実際に返した画像枚数に応じて合計料金が増えます。

Wan 2.7 のテキストから画像への変換は中国語プロンプトを対応していますか?

はい。RunComfyのモデル画面では、中国語または英語でプロンプトを入力できます。

1 つの Wan 2.7 テキストから画像へのリクエストで何枚の画像を生成できますか?

このモデルのmax_imagesには、1~5の整数を指定します。

Wan 2.7 テキストから画像への変換と Wan 2.7 Pro からのテキストから画像への変換を使用する必要がありますか?

どちらも同じパラメータ名を使用します。標準版は低価格で、下書きやすばやい反復に適しています。Pro版は画像単価が高い代わりに、より高精細な仕上がりを狙えます。アイデア探索には標準版、最終的なキービジュアルにはPro版がおすすめです。

`image_size`プリセットを使わず、幅と高さを自由に指定できますか?

このモデル画面では、標準の連携で入力を安定して扱えるよう、string型のプリセットを使用します。高度な構成やAPIのみの利用では、カスタムの{width, height}オブジェクトを使える場合があります。任意の寸法に依存する前に、RunComfyワークスペースの設定で対応状況を確認してください。

フォローする
  • LinkedIn
  • Facebook
  • Instagram
  • Twitter
サポート
  • Discord
  • メール
  • システムステータス
  • アフィリエイト
ビデオモデル
  • Seedance 2.5 Flash Text To Video
  • Seedance 2.5 Flash
  • Seedance 2.5 Flash Reference to Video
  • Wan 3.0
  • MiniMax H3 Fast
  • Wan 2.5
  • すべてのモデルを見る →
画像モデル
  • Seedream 5.5
  • Seedream 5.5 Edit
  • Seedream 5.5 Layer Decomposition
  • Wan 2.6 Image to Image
  • Nano Banana Pro
  • Seedream 5.0 Pro
  • すべてのモデルを見る →
法的情報
  • 利用規約
  • プライバシーポリシー
  • Cookieポリシー
RunComfy
著作権 2026 RunComfy. All Rights Reserved.

RunComfyは最高の ComfyUI プラットフォームです。次のものを提供しています: ComfyUIオンライン 環境とサービス、および ComfyUIワークフロー 魅力的なビジュアルが特徴です。 RunComfyはまた提供します AI Models, アーティストが最新のAIツールを活用して素晴らしいアートを作成できるようにする。
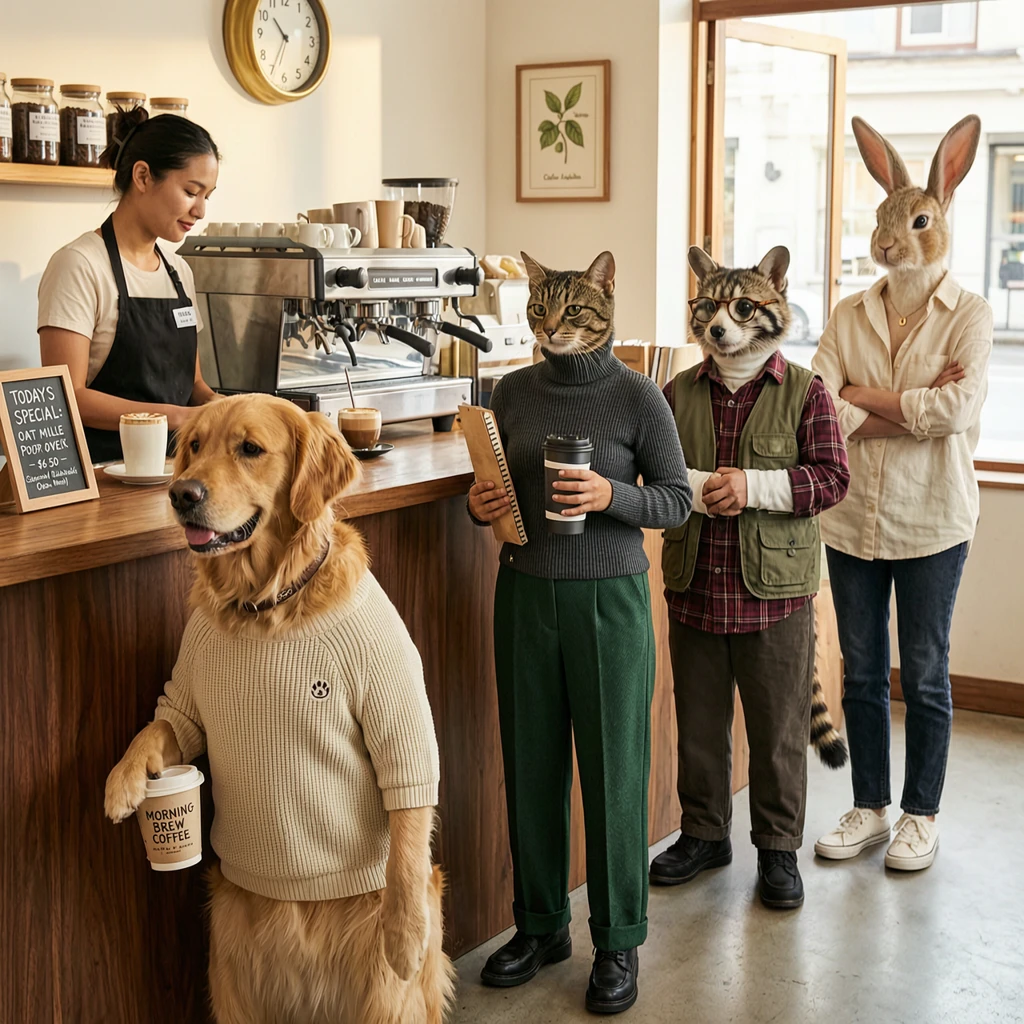
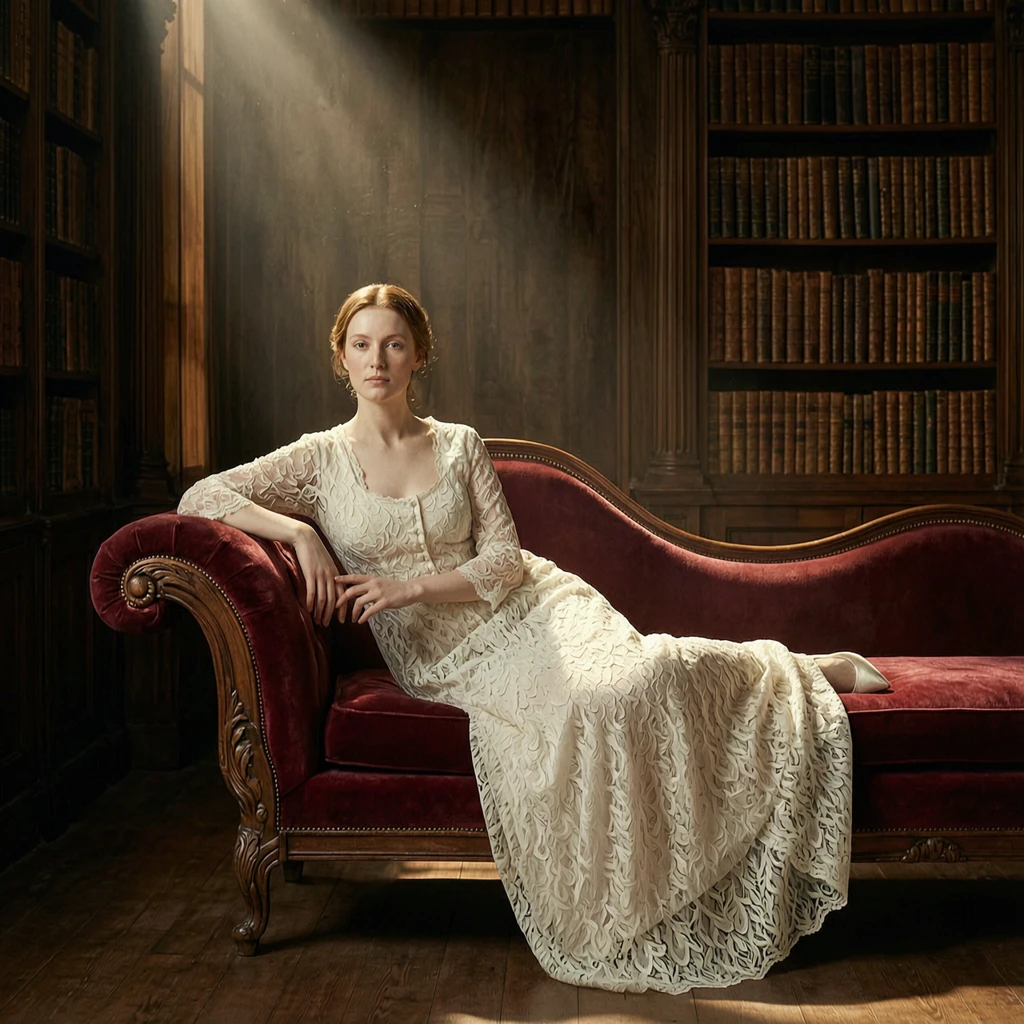
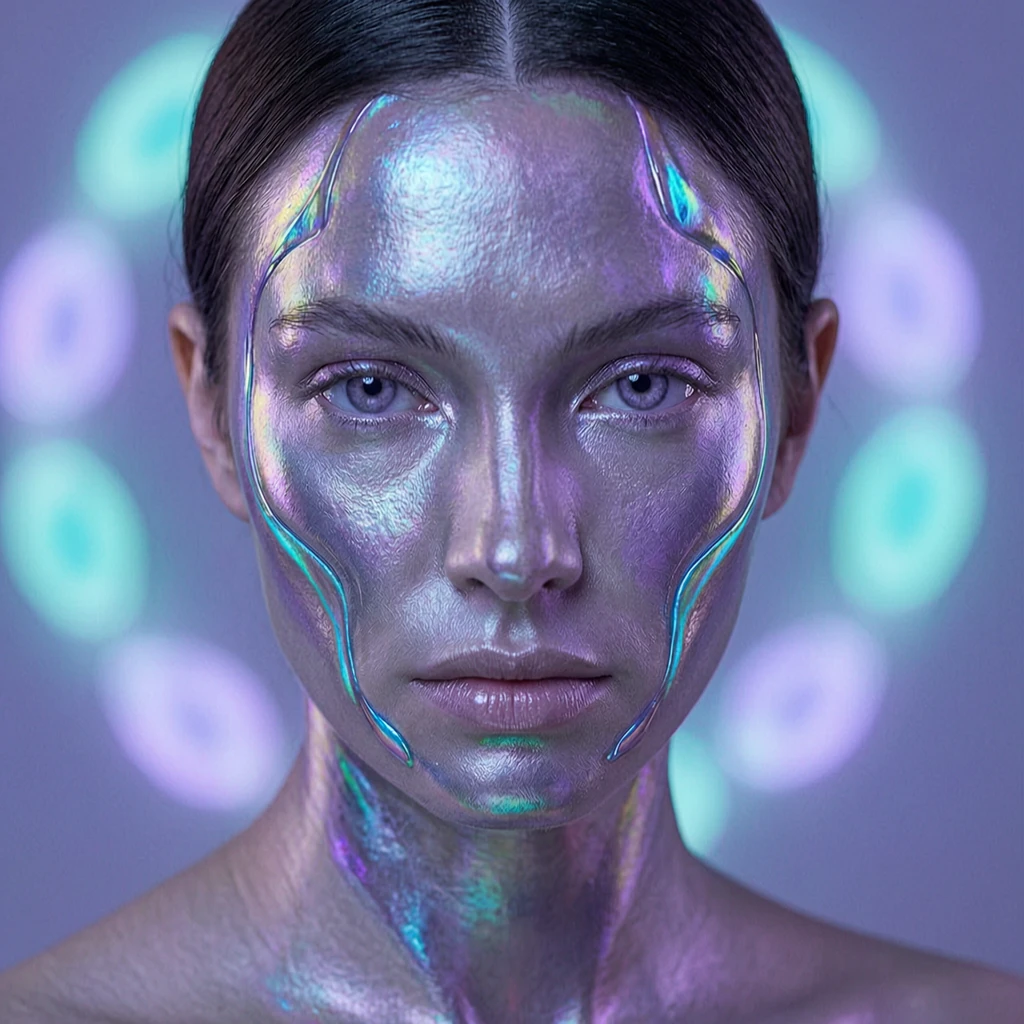
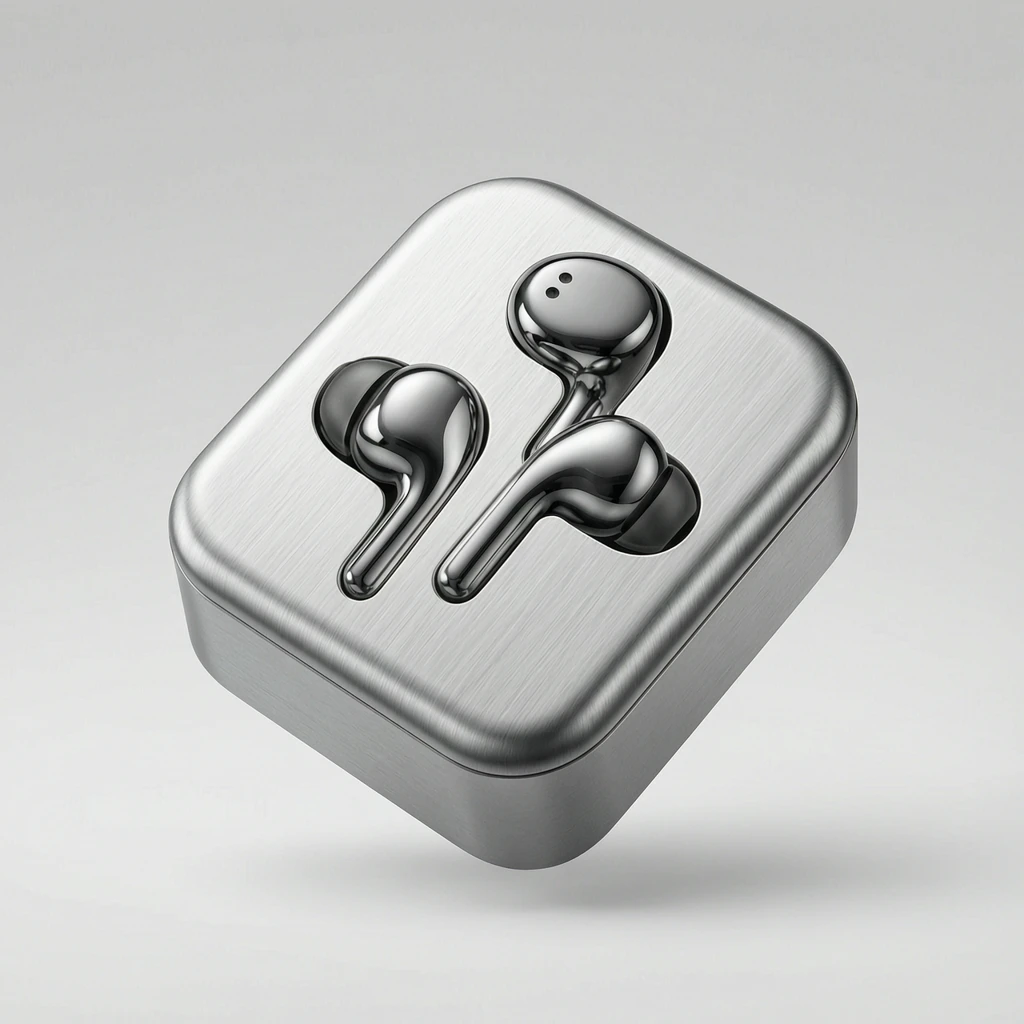
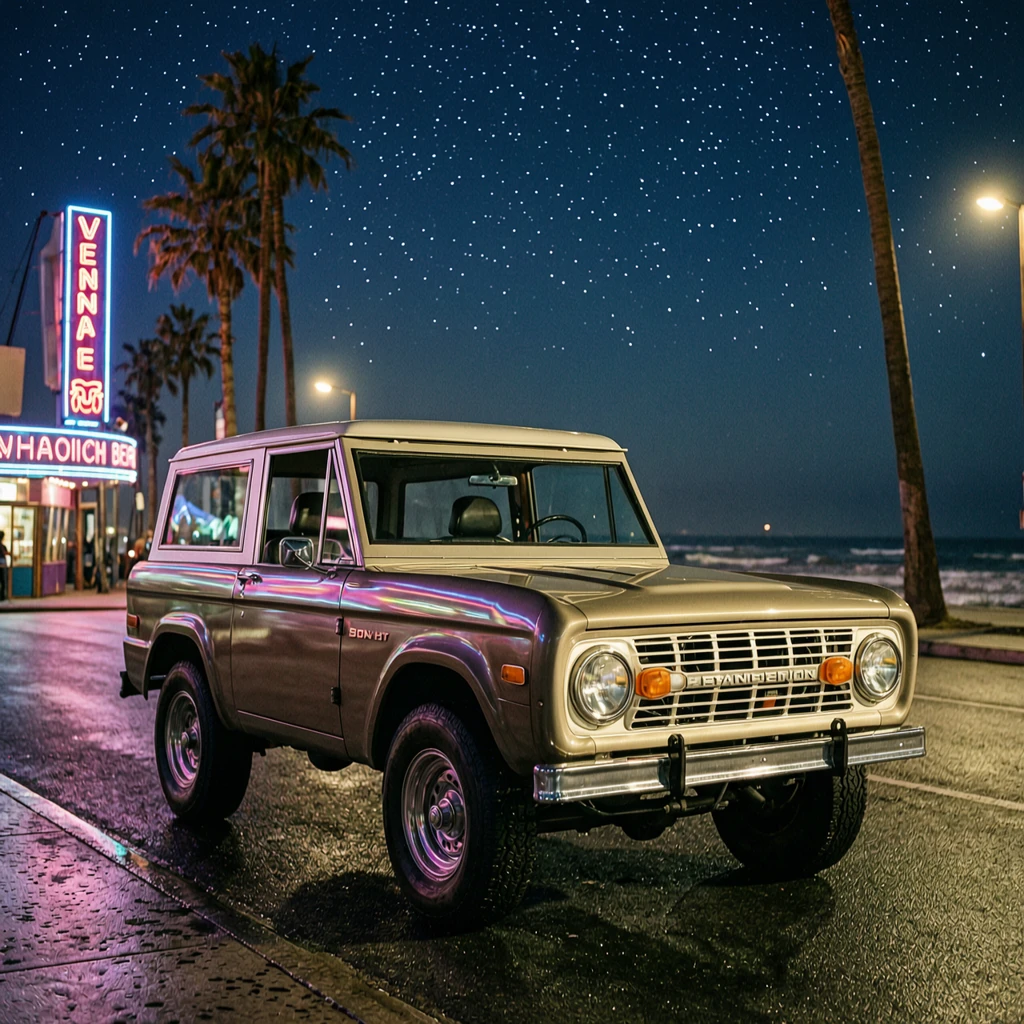
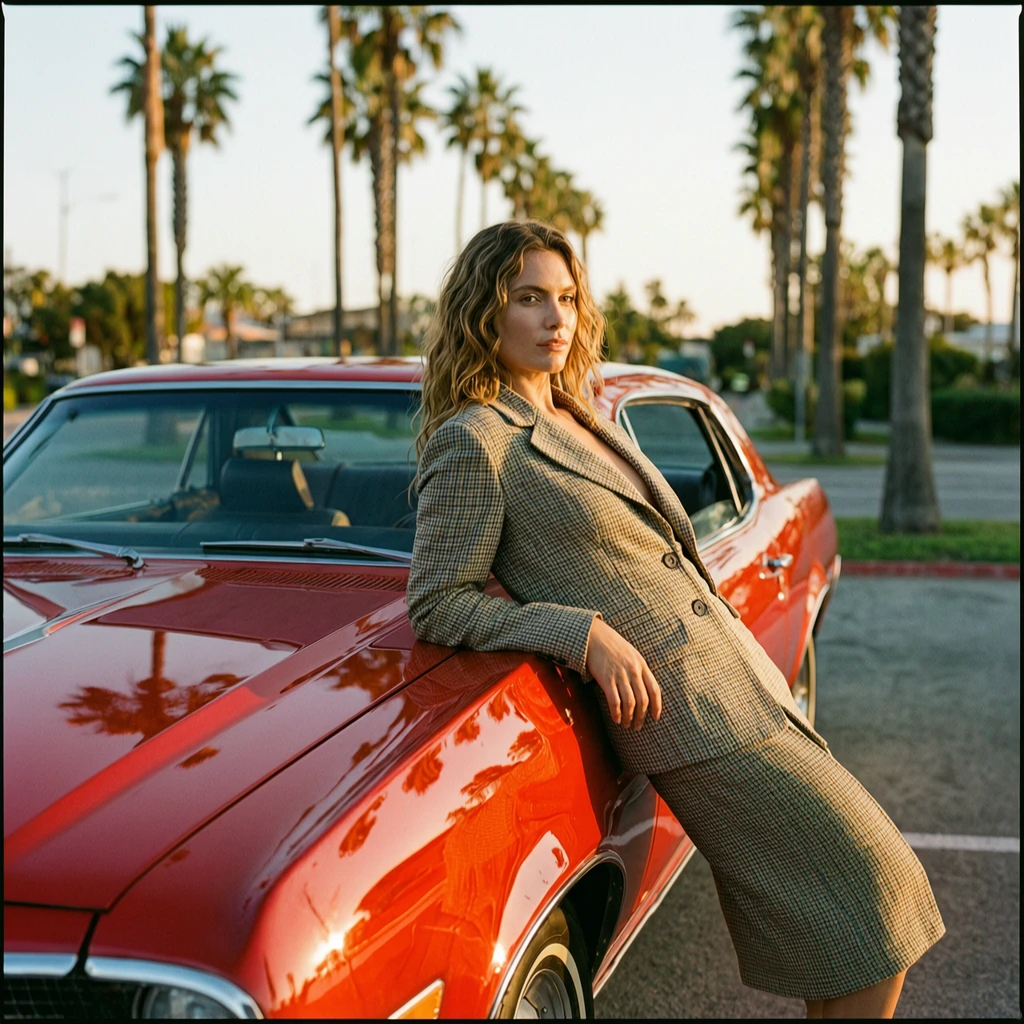
Wan 2.7テキスト画像生成の例