logo
RunComfy
  • ComfyUI
  • トレーナー
  • モデル
  • MCP新着
  • 価格
  • Seedance 2.5話題
  • Seedream 5.5新着

モデル別ワークフロー

話題MiniMax H3テキスト・画像・参照から音声付き動画話題Qwen Image 2.1画像生成と参照での写真編集Wanテキストや画像から動画、モーション転送FLUX画像生成・編集・キャラクターのバリエーションLTXテキストや画像から音声同期動画Qwen Image Editテキストと参照画像で写真編集Krea 2画像生成・スタイル転送・参照編集Z-Imageテキストから素早く人物や構想を生成

人気・新着ワークフロー

新着MiniMax H3 Character Swap V1.5動画の人物を差し替え、元の音声は保持新着P-H3-Image Reference Edit参照画像に沿って写真を編集話題MiniMax H3 Image-to-Video1 枚の画像から音声同期のシネマティック動画話題LTX 2.5 Image-to-Video1 フレームから音声同期の鮮明な動画話題MiniMax H3 Character Swap (SAM3)動きに合わせて動画の人物を差し替えQwen Image 2.1 Multi-Image Editing最大 10 枚の参照画像から精密なシーンFLUX Klein Face Swap自然でリアルな顔の入れ替えSeedVR2 Video Upscaler鮮明で滑らかな動画アップスケール
その他のワークフローを見る

モデルをトレーニング

新着MOSS-Image Base画像生成、新たに対応新着FLUX.3 Klein画像生成、新たに対応話題Krea 2最も多くトレーニングされた画像モデル話題Krea 2 Turbo少ステップで画像生成話題Qwen Image 2.1画像生成と編集Z-Image Turbo人物やコンセプト画像を素早く生成MiniMax H3音声同期の動画

トレーニングとデプロイ

はじめにOstris AI Toolkit で最初のトレーニングデータセットトレーニング用データセットのアップロードと管理推論学習済みモデルを Playground や API で実行デプロイメント学習済みモデルを専用エンドポイントで提供
その他のモデルをトレーニング

画像モデル

新着GPT Image 2.65% OFF · 精細なテキストから画像生成、GIF・SVG 対応、最大 4K新着Seedream 5.510% OFF · 最大2Kのテキストから画像生成、透過PNG対応新着MiniMax H3 Image10% OFF · テキストまたは参照画像から、最大4Kの静止画新着FLUX 3 Image Klein10% OFF · テキストまたは参照画像から、768〜4Kの静止画話題Seedream 5.0 Pro20% OFF · 参照画像での編集、多言語テキスト対応話題Seedream 4.520% OFF · ブランドの一貫性を保つフォトリアルな編集話題Wan 2.6 Image指示ベースの画像編集Nano Banana Pro77% OFF · スケッチから精密な 2K〜4K ビジュアル

ビデオモデル

新着Seedance 2.5 Flash34% OFF · Text, image, or reference to video新着Kling 4.09% OFF · 静止画を 3〜30 秒の動画に話題Wan 3.0 Prime13% OFF · 参照動画からすばやく生成話題Seedance 2.535% OFF · より長く一貫性の高いシネマティック動画話題Wan 3.0画像・動画・音声の参照から生成話題MiniMax H3最初のフレームを 5〜15 秒の動画にWan 2.510% OFF · 滑らかな動きとネイティブ音声FLUX 3 Maxテキスト・静止画・キーフレームから生成
その他のモデルを見る

API

Serverless (ComfyUI)ComfyUIワークフローをサーバーレスエンドポイントとしてデプロイ。Serverless (LoRA)LoRAをサーバーレスエンドポイントとしてデプロイ。Model APIデプロイ不要でホストされたモデルをオンデマンドで実行。Trainer APIAPI で LoRA のトレーニング、管理、取得を行います。CLIRun RunComfy models from your terminal.
モデル
探索
すべてのモデル
ライブラリ
生成履歴
モデルAPI
APIドキュメント
APIキー
アカウント
使用量

Qwen Image 3.0: モデルと API でのタイポグラフィーによるテキストからイメージへの変換 |ランコンフィ | Models and API | RunComfy

qwen/qwen-image-3.0/text-to-image

Qwen Image 3.0 は、強力なプロンプト準拠、読みやすいタイポグラフィ、選択可能な 1k または 2k 出力、アスペクト比制御、プロンプト拡張、およびシードベースの再現性を備えたテキスト プロンプトを詳細な静止画に変換します。

件名、設定、スタイル、およびレンダリングしたい正確なテキストを説明します。言葉遣いを引用符で囲んでそのまま表現します。
出力詳細層。ドラフトを高速化するには 1k を、印刷可能な最終的な詳細には 2k を選択します。価格はどちらも同じです。
生成された画像のアスペクト比。
モデルを生成する前に、短いプロンプトに詳細を追加して強化します。プロンプトがすでに正確である場合はオフにします。
再現性を高めるためのランダムシード。各実行のランダム シードには -1 を使用します。
Idle
The rate is $0.028 per image.

Qwen Image 3.0 の概要

Qwen Image 3.0 は、Qwen の最新のテキストから画像へのモデルであり、迅速な遵守、きめ細かいテキスト レンダリング、および柔軟な出力サイズ設定を目的として構築されています。

Qwen Image 3.0 は、面倒なアップスケーラーと手動のレイアウト修正を 1 つの信頼できるジェネレーターと交換することで、デザイナー、マーケティング担当者、開発者がポスター、製品ショット、タイポグラフィ アートをより迅速に出荷できるように支援します。

開発者にとって、RunComfy の Qwen Image 3.0 はブラウザーと HTTP API 経由の両方で使用できるため、モデルを自分でホストしたりスケールしたりする必要はありません。

最適な用途: タイポグラフィーのポスターとカバー |製品および電子商取引の画像 |インフォグラフィックスとエディトリアルレイアウト

Qwen / Qwen Image 3.0 テキストから画像へ#


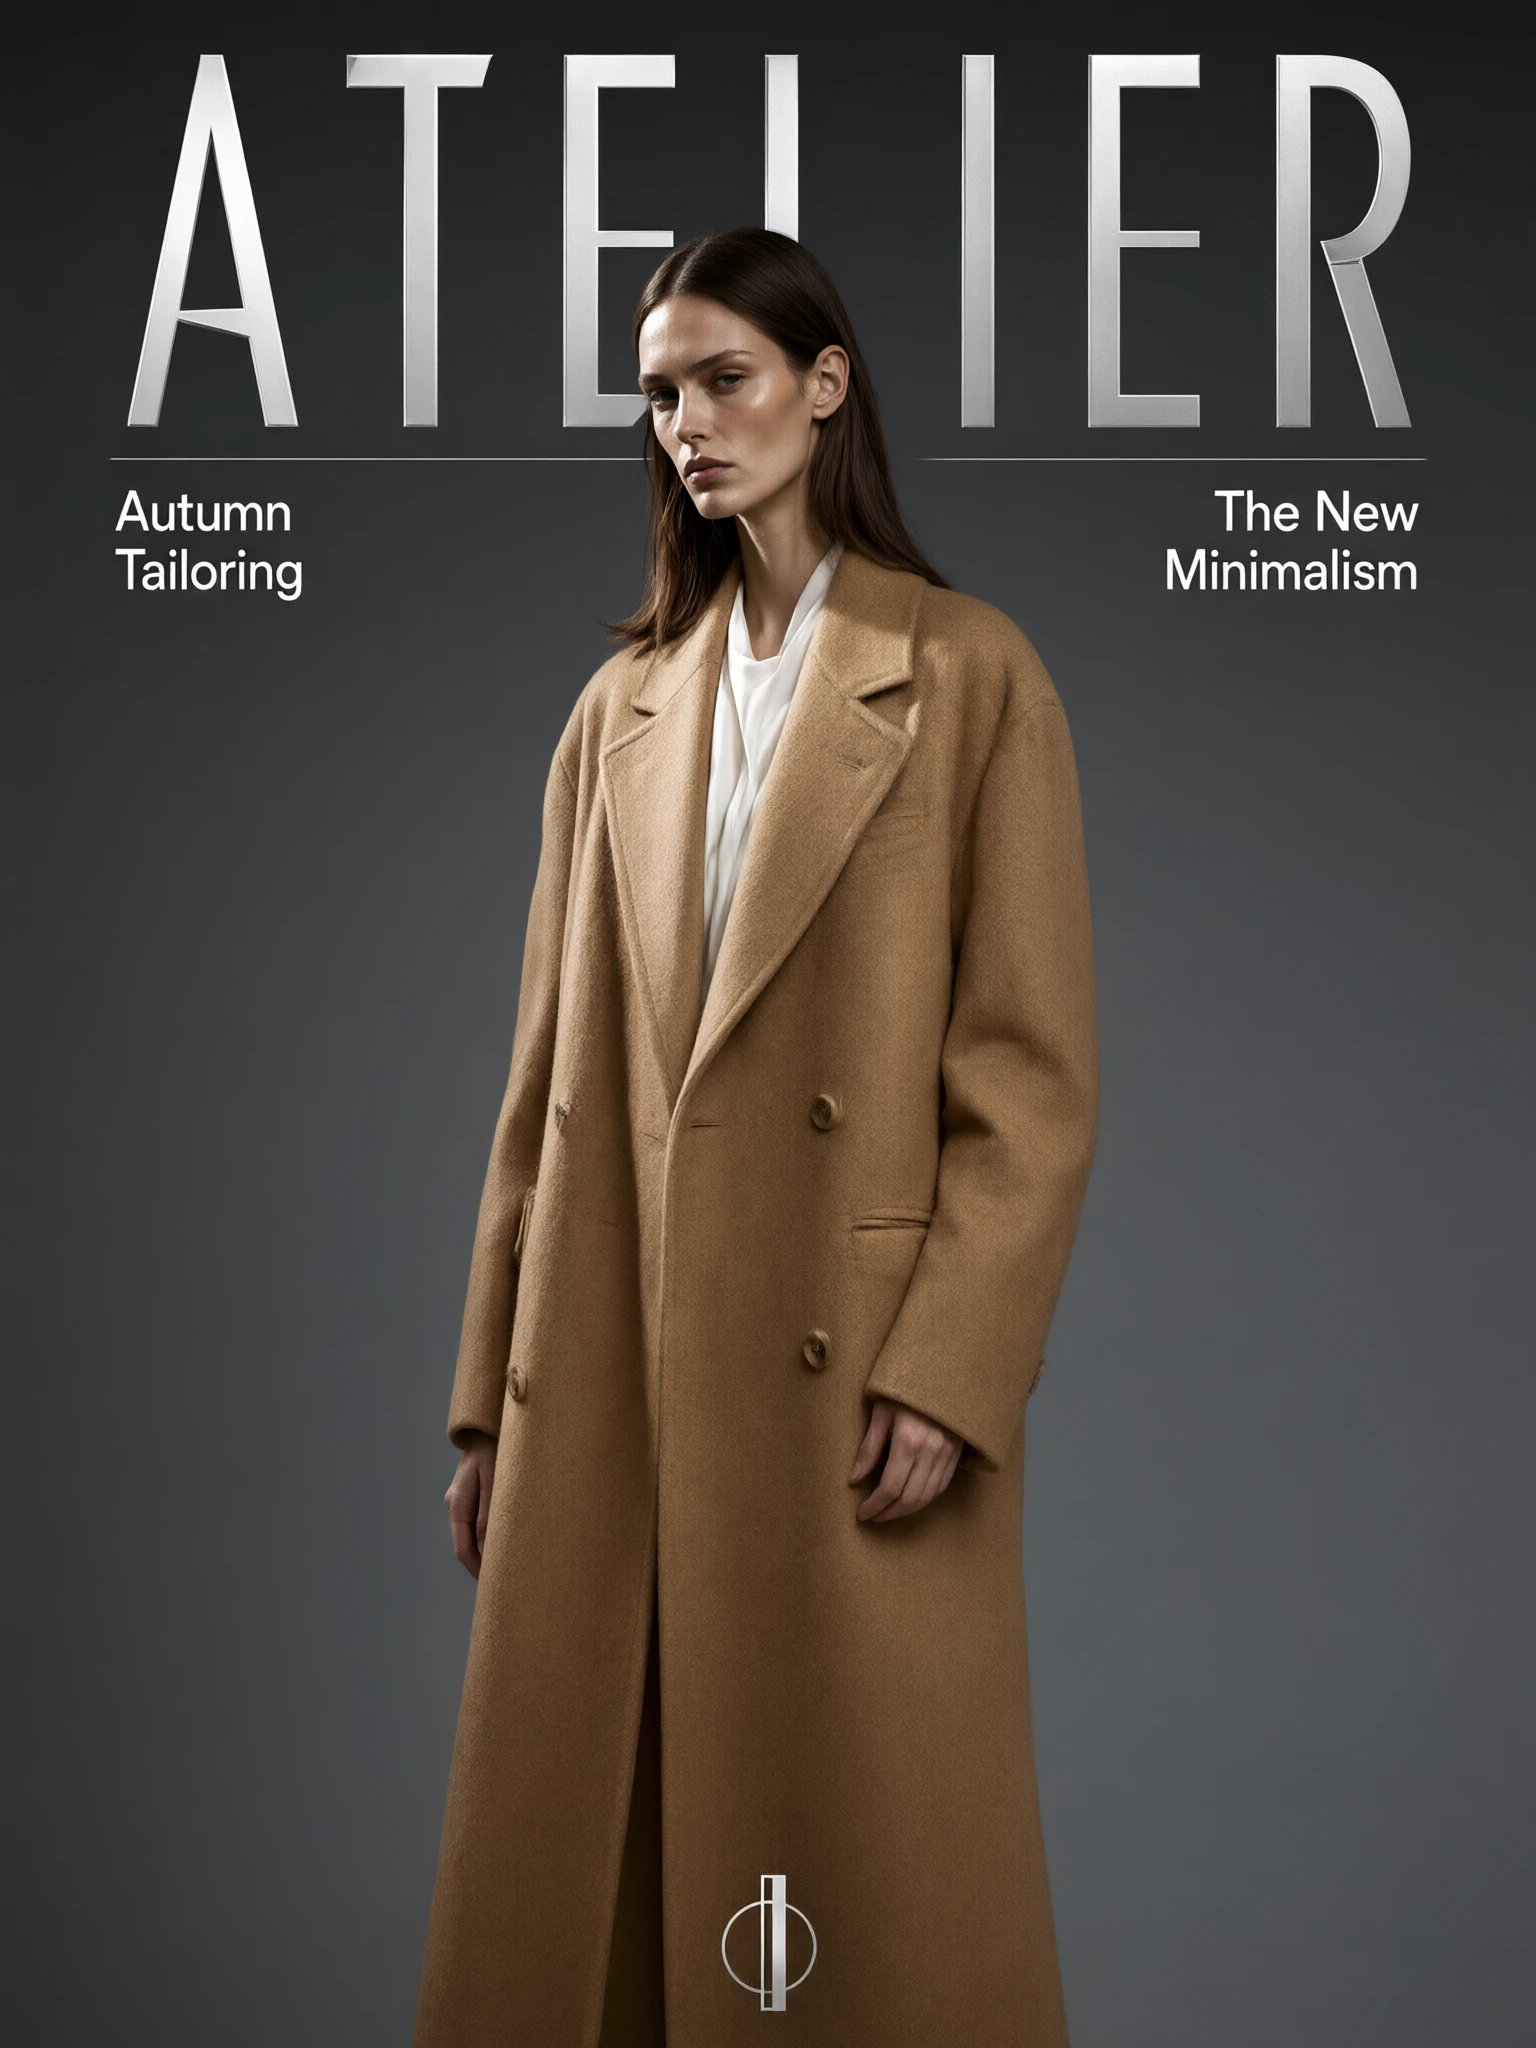
Qwen Image 3.0 は、書かれたプロンプトを高精細な静止画に変換する、Qwen のテキストから画像へのモデルです。正確なプロンプトフォロー、クリーンなタイポグラフィー、写真の質感を考慮して調整されているため、1 つの説明で完成したポスター、広告フレーム、またはエディトリアルビジュアルが得られます。


基礎となる Qwen Image 3.0 モデルは、画像編集 (画像から画像へ) もサポートしています。このページでは、テキストから画像へのモードに焦点を当てます。


ハイライト#


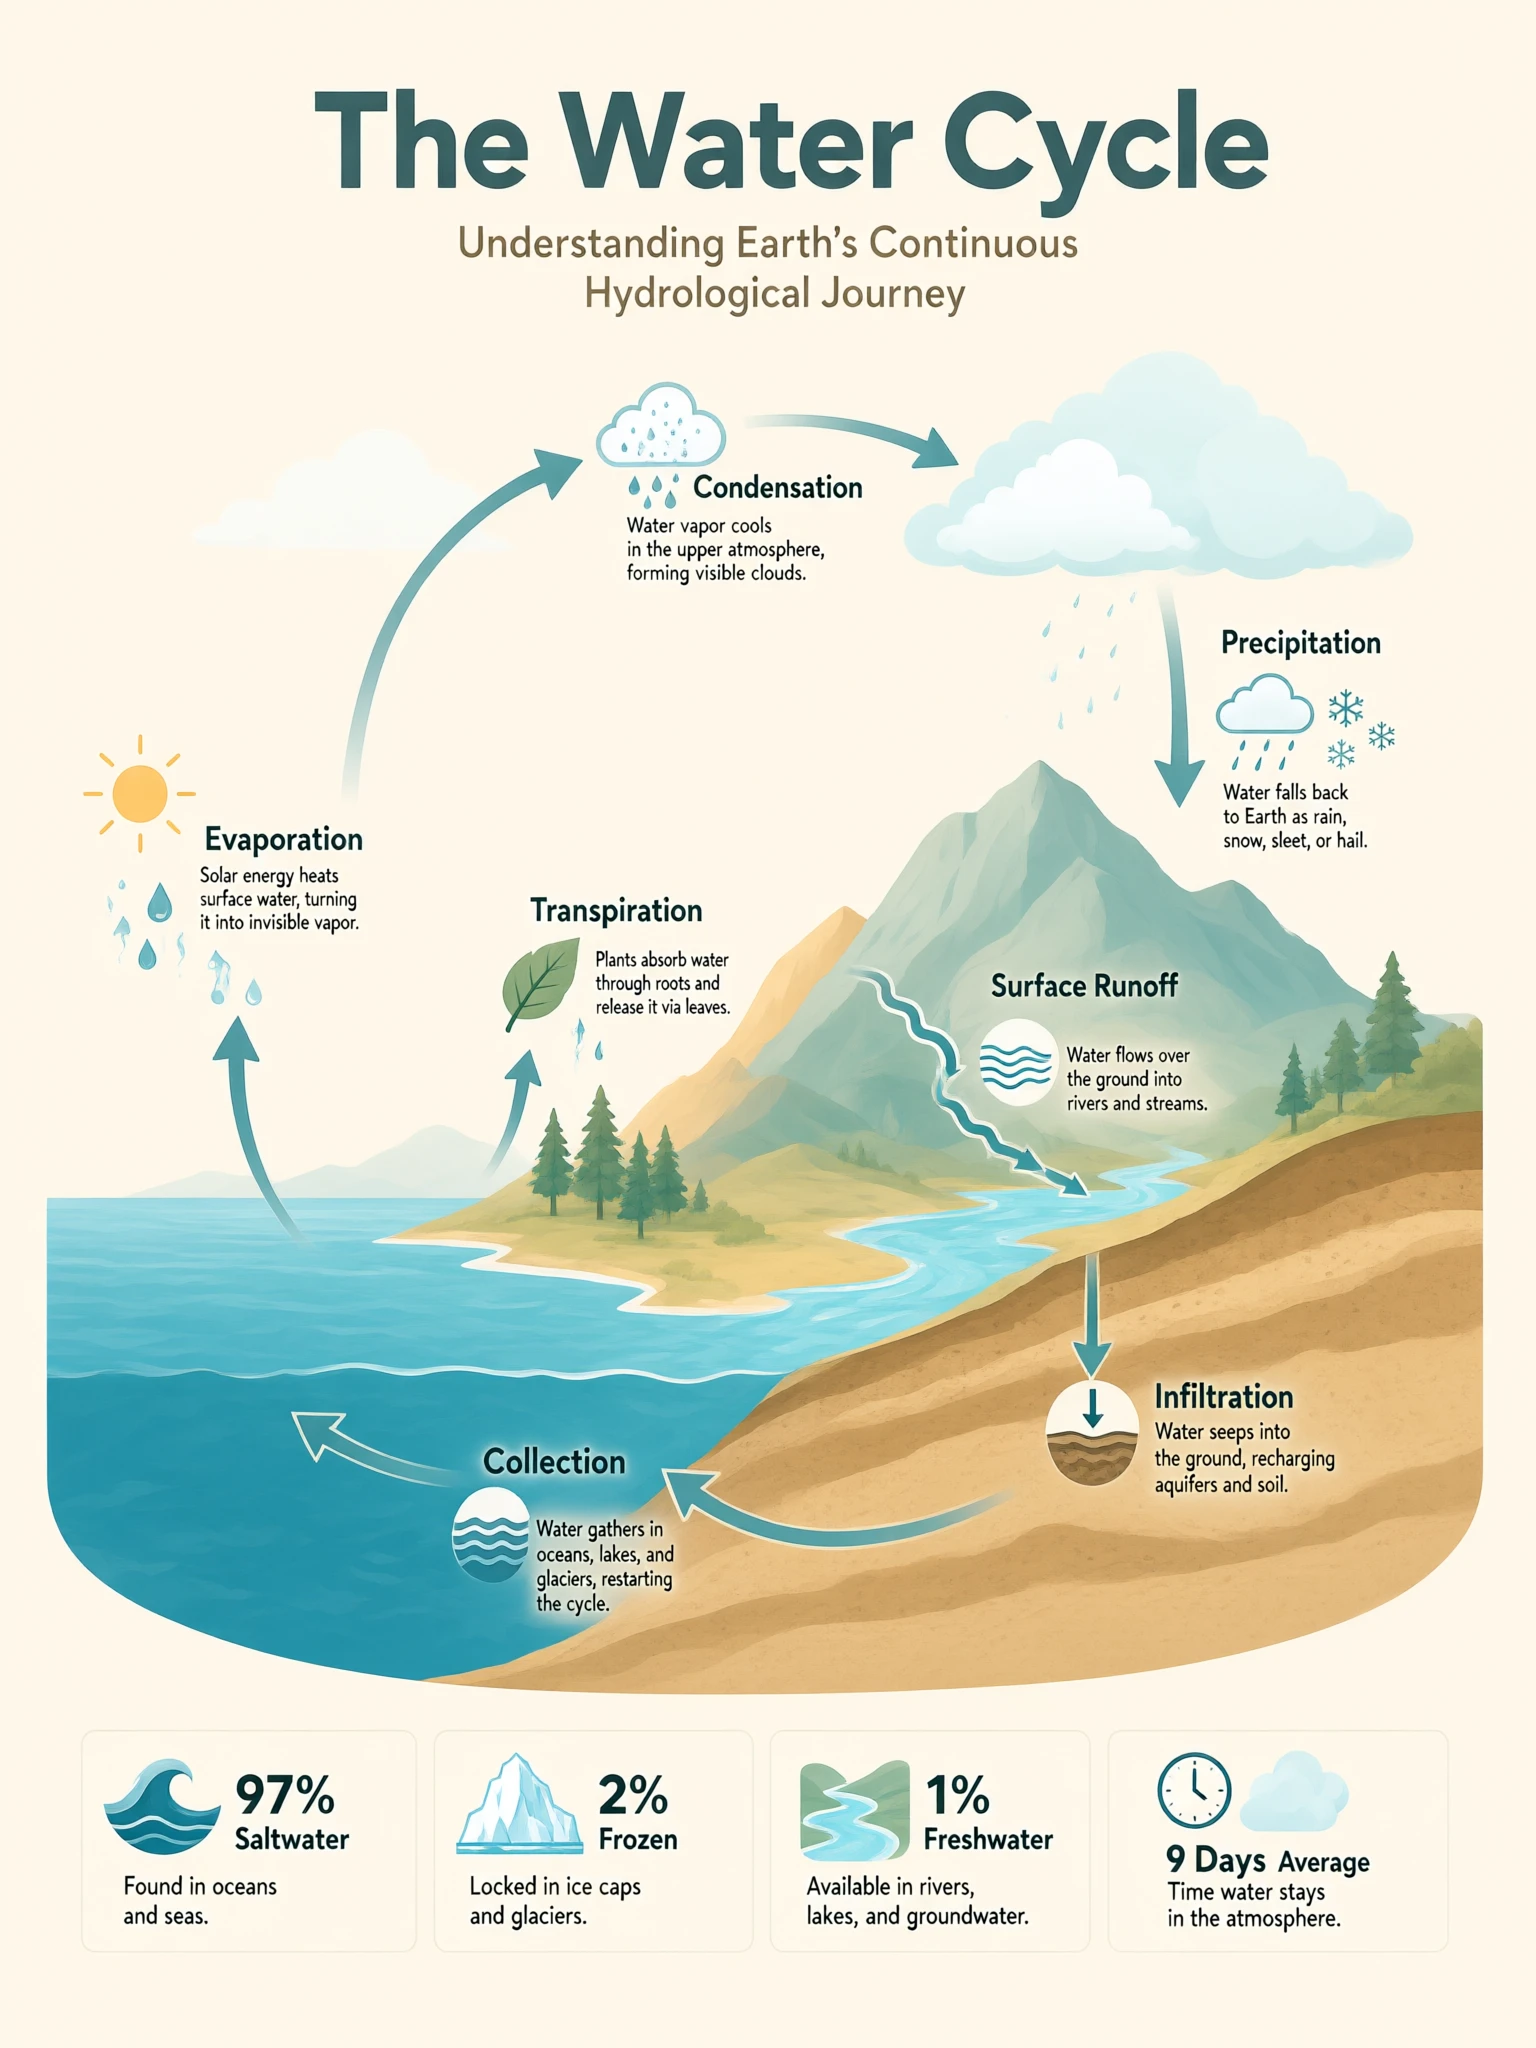
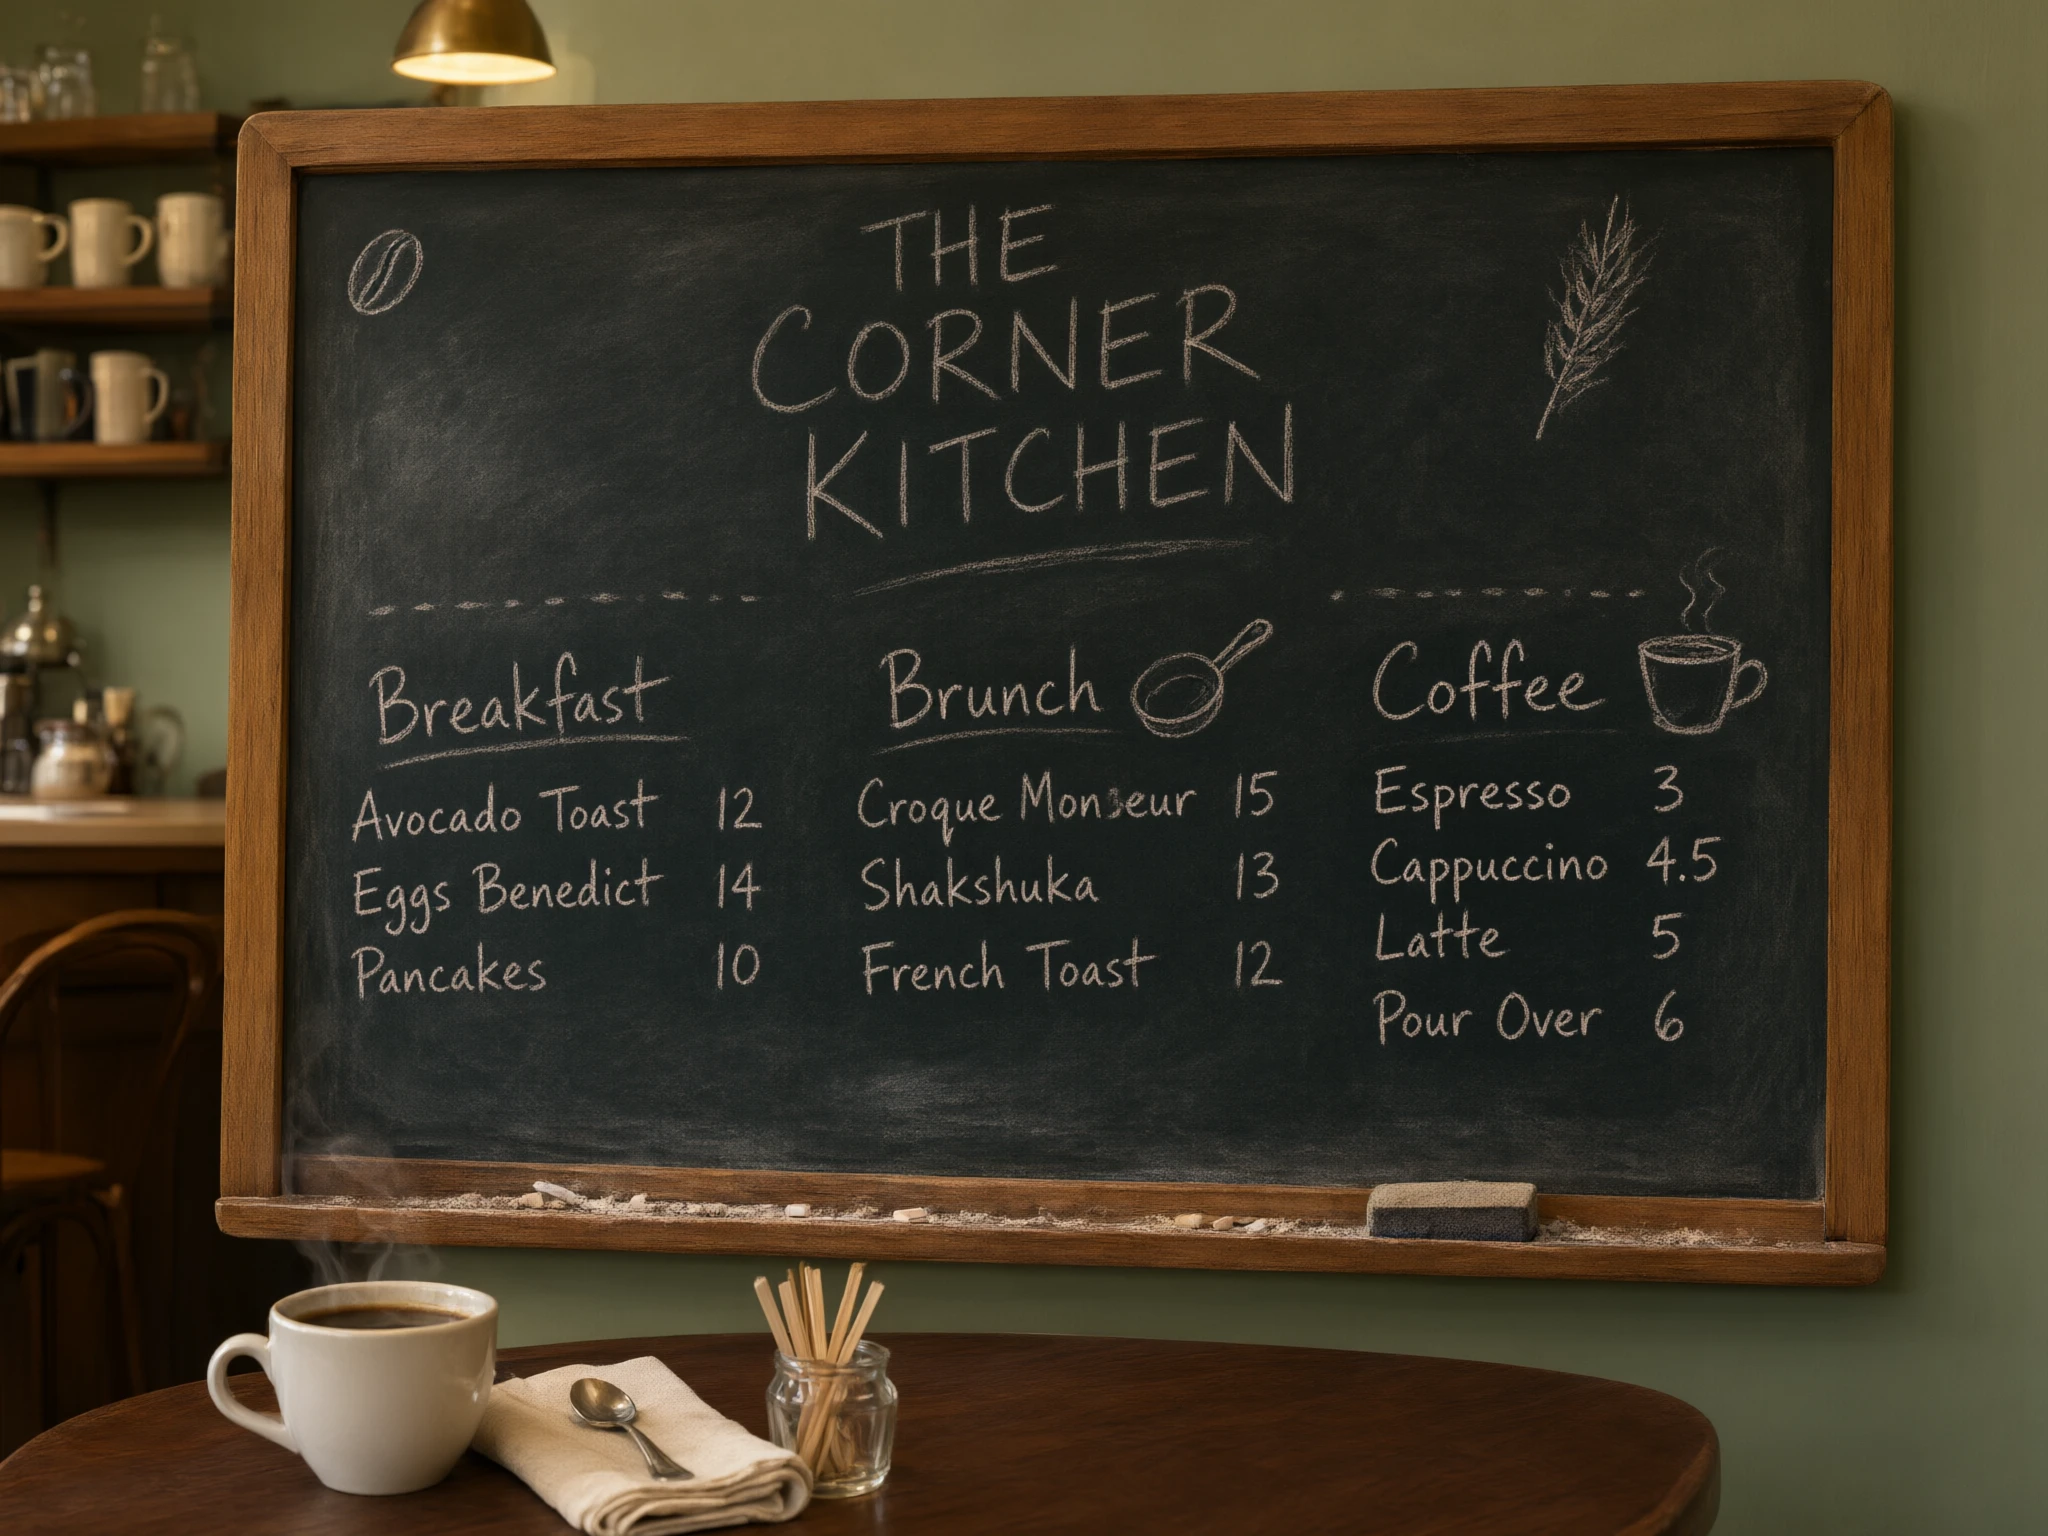
  • 読みやすいテキスト レンダリング: Qwen Image 3.0 は、多言語タイプを含む見出し、キャプション、小さなラベルを異常な精度で配置します。ポスター、メニュー、パッケージのモックアップに便利です。
  • 強力なプロンプト順守: Qwen Image 3.0 は、名前付きオブジェクト、空間関係、スタイル キューを希望どおりに配置し、リロール サイクルを短縮します。
  • 柔軟な出力サイズ設定: 1k または 2k 層とアスペクト比を選択します。 Qwen Image 3.0 は、フレームを切り取るのではなく、フレームに合わせて合成します。
  • プロンプト拡張: オプションの書き換えにより、生成前に短いプロンプトに詳細を追加し、固定シードにより外観の再現性を維持します。
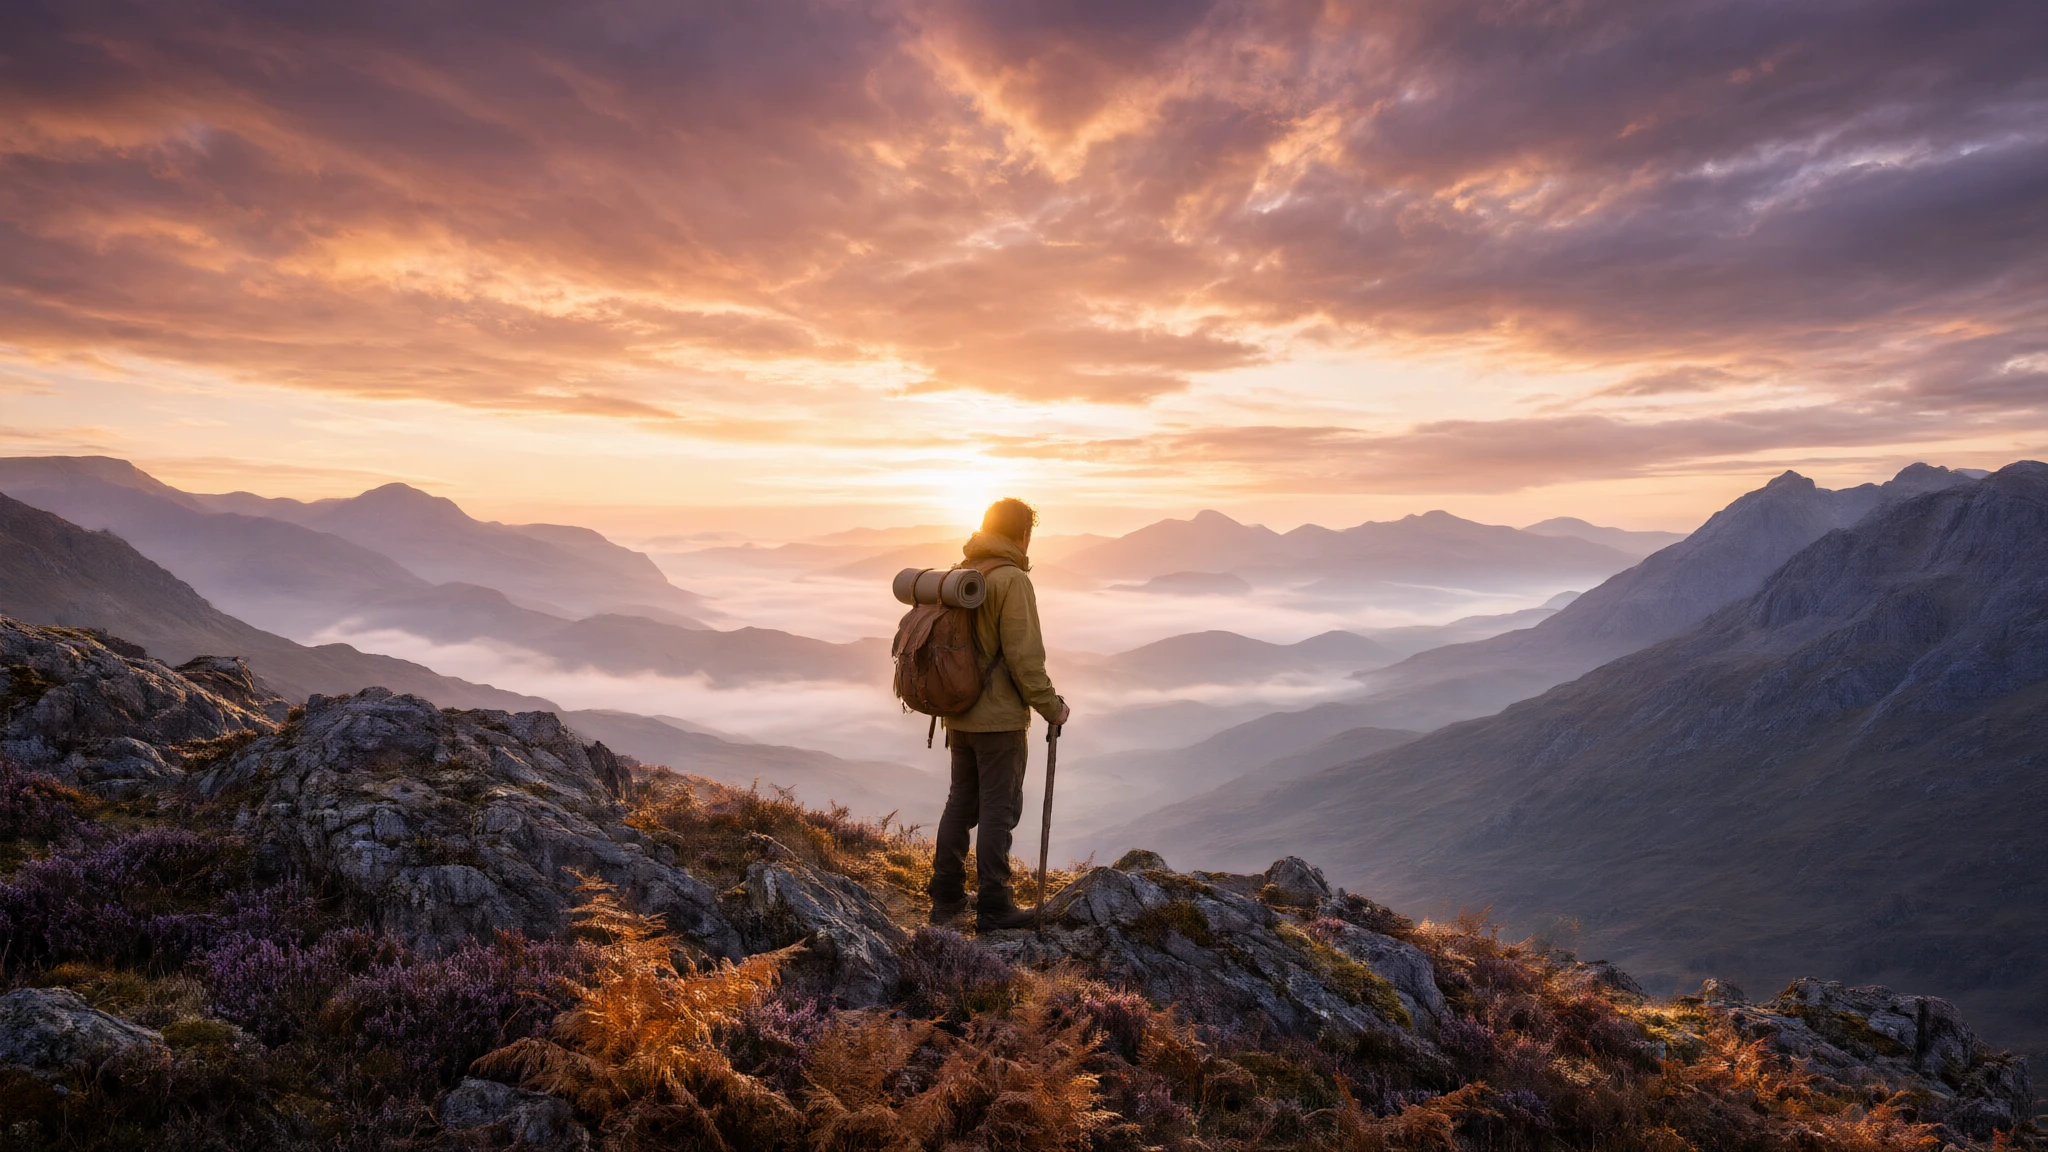
  • 写真の詳細: Qwen Image 3.0 では、皮膚、布地、金属、照明が精査に耐えられるため、結果は大ざっぱではなく完成したものとして認識されます。

パラメータ#


パラメータ必須タイプデフォルト範囲/オプション説明
プロンプト*はい (*)文字列ポスタープロンプトの例最大 ~4,500 トークン件名、設定、スタイル、および正確なテキストを説明します。文言を引用してそのまま表現します。
解像度いいえ文字列2k1k、2k詳細層。簡単なドラフトの場合は「1k」、印刷可能な最終的な詳細の場合は「2k」です。どちらでも同じ価格です。
アスペクト比いいえ文字列1:11:1、16:9、9:16、4:3、3:4フレームを配置に合わせます。フィードの場合は正方形、バナーの場合は「16:9」、ストーリーの場合は「9:16」です。
enable_prompt_expansionいいえブール値本当true、false生成する前に、短いプロンプトに詳細を追加します。プロンプトがすでに正確である場合はオフにします。
シードいいえ整数-1-1 または 0 – 2147483647シードを修正して結果を再現します。新しいバリエーションには -1 を使用します。

  • 必須フィールドです。

料金#


RunComfy 上の Qwen Image 3.0 は、1k / 2k いずれのティアでも一律 画像あたり $0.028 で課金されます。1–4 枚のバッチでは、合計は 画像数 × $0.028 です。


使用方法#


  1. 件名、設定、スタイル、および Qwen Image 3.0 でレンダリングしたい正確なテキストを指定するプロンプトを作成します。
  2. 簡単なドラフトの場合は「1k」層を選択し、最終的な印刷可能な詳細の場合は「2k」層を選択します。
  3. 配置に一致するアスペクト比を選択します。ソーシャルの場合は「1:1」、バナーの場合は「16:9」、ストーリーの場合は「9:16」です。
  4. 短い概要の場合はプロンプト展開をオンのままにし、プロンプトがすでに正確である場合はオフに切り替えます。
  5. シードを設定して外観を再現するか、新しいバリエーションのためにシードを「-1」のままにします。
  6. Qwen Image 3.0 で生成し、テキストと構成を確認して、一度に 1 つの命令を調整します。

プロンプトとリファレンスのヒント#


  • Qwen Image 3.0 がそのまま表現できるように、正確な表現を引用符で囲みます。 「OPEN」と書かれた看板。
  • 被写体を中心に、設定、照明、レンズ言語を加えて写真の外観を整えます。
  • ポスターのレイアウトに名前を付けます。見出し、小見出し、各ブロックが配置される場所を指定します。
  • フレームをきれいに保つために、短い負の方向 (「透かしなし、余分なテキストなし」) を追加します。
  • プロンプト全体を書き直すのではなく、固定シードで小さな編集を繰り返します。
  • フレームに収まるものが変わるため、文言を修正する前にアスペクト比を選択してください。

Qwen Image 3.0 Text To Image と他のモデルとの比較#


  • 公開されている情報に基づくと、Qwen Image 3.0 は、多くの一般的な画像モデルよりも高密度で読みやすいテキストと構造化されたレイアウトに優れています。
  • 高速な「ターボ」ジェネレーターに対して、Qwen Image 3.0 は、速度を少し犠牲にして、より厳密なプロンプト遵守とよりクリーンなタイポグラフィーを実現します。
  • テキストのない単純なフォトリアルなポートレートの場合は、明るいモデルで十分かもしれませんが、Qwen Image 3.0 は 1 回のパスでタイプとシーンの一貫性を保ちます。

さらに試してみたいモデル#


Qwen Image 3.0 が適切な開始点ではない場合は、RunComfy で次のオプションを比較してください。


  • Nano Banana Pro — リファレンスに基づいた編集と複数画像のブレンド用。
  • Flux ファミリ ジェネレーター — 様式化されたアート ディレクションと高速なイテレーションを実現します。
  • 表意文字スタイルのモデル — ロゴのようなテキストやポスターのタイポグラフィー用。
  • Seedream スタイルのモデル — 高解像度の写真シーン用。

公式リソース#


  • クウェン:https://qwen.ai/
  • Qwen ブログ — Qwen Image 3.0: https://qwen.ai/blog?id=qwen-image-3.0

関連モデル

nano-banana-2-lite/text-to-image

固定1K解像度で、テキストから画像を高速・低コストに生成します。

seedream-4-0/edit-sequential

連続性とスタイルを保ちながら画像を自然に変換できるクリエイティブAIツール。

qwen-image/qwen-image-edit-2511

構図や形状を保ちながら、被写体の一貫性も維持できる高精度な画像編集モデルです。

gpt-image-2.5/flare/edit

クリエイターのコンテンツ、ソーシャル投稿、製品バリエーションのリファレンスベースの画像編集を高速に実行します。

seedream-4-5/sequential

テキストから最大15枚の画像シリーズを生成し、11種類の解像度から選択できます。

flux-2/max/edit

選択可能なサイズのプリセット、シード、JPEG または PNG 出力を使用して、テキストの指示から 1 ~ 10 個の参照画像を編集します。

よくある質問

Qwen Image 3.0 は、テキストから画像への変換に最適な機能は何ですか?

Qwen Image 3.0 は、ポスター、雑誌の表紙、メニュー、インフォグラフィックなど、明確な主題と読みやすいテキストを組み合わせたプロンプトに優れています。写真のディテールをそのままにしながら、レイアウトとタイポグラフィーの指示に厳密に従っているため、多くの場合、1 回のプロンプトで完成した見栄えの静止画が完成します。

Qwen Image 3.0 は画像内のテキストとタイポグラフィをどのようにレンダリングしますか?

Qwen Image 3.0 は、多言語タイプを含め、見出し、キャプション、小さなラベルを正確に配置するように調整されています。プロンプト内で正確な文言を引用符で囲み、モデルがそれをそのままレンダリングし、最もきれいなレイアウトを実現するために各テキスト ブロックが配置される場所に名前を付けます。

Qwen Image 3.0 は写真シーンとグラフィック デザインの両方を処理できますか?

はい。 Qwen Image 3.0 は、リアルなポートレート、製品ショット、風景だけでなく、エディトリアル カバーやラベル付き図などのデザイン性の高いフレームも生成します。シーンと画像上のテキストを別々に扱うのではなく、1 回のパスで一貫した状態に保つことを目的としています。

Qwen Image 3.0 は RunComfy でどの解像度とアスペクト比をサポートしていますか?

この Qwen Image 3.0 のテキストから画像へのページでは、1k または 2k の詳細層と 1:1、16:9、9:16、4:3、および 3:4 のアスペクト比が提供されます。簡単なドラフトには 1k を選択し、印刷可能な詳細には 2k を選択します。正確なオプションについては、現在の RunComfy パラメータ パネルを確認してください。

Qwen Image 3.0 はプロンプト拡張とシードをサポートしていますか?

Qwen Image 3.0 には、生成前に短いプロンプトを詳細で強化するオプションのプロンプト拡張設定が含まれています。固定シードを設定して結果を再現したり、-1 を使用して実行ごとに新しいバリエーションを取得したりすることもできます。

基礎となる Qwen Image 3.0 モデルはテキストから画像への変換に限定されていますか?

より広範な Qwen Image 3.0 モデルは画像編集 (画像から画像へ) もサポートしていますが、このページではテキストから画像へのモードのみを公開しています。ここではプロンプトを単独で使用します。参照画像の編集は、別のワークフローを通じて処理されます。

開発者は RunComfy API を通じて Qwen Image 3.0 を使用できますか?

はい。 RunComfy モデル UI でプロンプトのプロトタイプを作成し、自動化用に同じパラメーターを使用して RunComfy HTTP API 経由で同じ Qwen Image 3.0 モデルを呼び出します。モデルを自分でホストしたりスケーリングしたりする必要はなく、同じ入力で同等の結果が生成されます。

RunComfy で Qwen Image 3.0 を使用して生成するにはいくらかかりますか?

生成には usd またはクレジットが消費され、Qwen Image 3.0 は 1k / 2k いずれのティアでも画像あたり一律 $0.028 です。バッチの合計はその単価 × 枚数です。新規ユーザーには通常、無料トライアル分が付与されます。

フォローする
  • LinkedIn
  • Facebook
  • Instagram
  • Twitter
サポート
  • Discord
  • メール
  • システムステータス
  • アフィリエイト
ビデオモデル
  • Seedance 2.5 Flash Text To Video
  • Seedance 2.5 Flash
  • Seedance 2.5 Flash Reference to Video
  • Wan 3.0
  • MiniMax H3 Fast
  • Wan 2.5
  • すべてのモデルを見る →
画像モデル
  • Seedream 5.5
  • Seedream 5.5 Edit
  • Seedream 5.5 Layer Decomposition
  • Wan 2.6 Image to Image
  • Nano Banana Pro
  • Seedream 5.0 Pro
  • すべてのモデルを見る →
法的情報
  • 利用規約
  • プライバシーポリシー
  • Cookieポリシー
RunComfy
著作権 2026 RunComfy. All Rights Reserved.

RunComfyは最高の ComfyUI プラットフォームです。次のものを提供しています: ComfyUIオンライン 環境とサービス、および ComfyUIワークフロー 魅力的なビジュアルが特徴です。 RunComfyはまた提供します AI Models, アーティストが最新のAIツールを活用して素晴らしいアートを作成できるようにする。
Qwen Image 3.0 の例