seedance-2.5/image-to-video/1080p
Seedance 2.5 1080p: Anima gli still in video 1080p nitido e naturale
LTX 2 Fast Text-to-Video genera un video da un prompt testuale. Scegli valori supportati per duration, resolution e fps; aspect_ratio accetta solo 16:9, mentre generate_audio controlla la generazione dell’audio. Per un altro flusso da testo a video, consulta LTX 2 Pro Text-to-Video.
Genera un video 16:9 da un prompt testuale, scegliendo durata, risoluzione, frame rate e audio facoltativo.
Descrivi nel prompt scena, soggetto, azione, ripresa, stile visivo e audio desiderato, quindi scegli i parametri di output supportati.
| Parametro | Tipo | Valore predefinito/Intervallo | Descrizione |
|---|---|---|---|
| prompt | string | Required; example prefilled | Descrizione testuale di scena, soggetto, azione, ripresa, stile visivo e audio desiderato. |
| duration | integer | 6, 8, 10, 12, 14, 16, 18, or 20; default: 6 | Durata del video in secondi. Valori ammessi: 6, 8, 10, 12, 14, 16, 18 e 20. |
| generate_audio | boolean | default: true | Indica se generare l’audio insieme al video. Valore predefinito: true. |
prompt è obbligatorio. Se duration supera 10 secondi (12, 14, 16, 18, 20), resolution deve essere 1080p e fps deve essere 25.
prompt.aspect_ratio su 16:9.duration, resolution e fps, rispettando il vincolo per le durate lunghe.generate_audio su false se non desideri generare audio.Il video generato può poi essere usato come sorgente nel flusso separato LTX 2 Retake Video. Consulta quella pagina per gli input e le regole applicabili.
Lo schema non garantisce velocità di rendering fissa, latenza, vantaggi qualitativi o diritti d’uso. Consulta le condizioni correnti del prodotto e del fornitore prima dell’uso in produzione.
La tariffa è di 0,045 $ al secondo.
Seedance 2.5 1080p: Anima gli still in video 1080p nitido e naturale

Anima un’immagine iniziale tramite testo e configura formato, risoluzione, durata, stile, audio e clip multiple.

Seedance 2.5 1080p Text to video: dal prompt al clip cinematografico 1080p
Animare un'immagine di riferimento richiesta da un prompt richiesto. Controlla le dimensioni dell'output, il conteggio dei fotogrammi, la velocità di riproduzione, il seed, i passaggi, la guida e lo spostamento del campionamento.

Animare un primo fotogramma obbligatorio da un prompt testuale, facoltativamente guidando la fine con un'immagine dell'ultimo fotogramma.
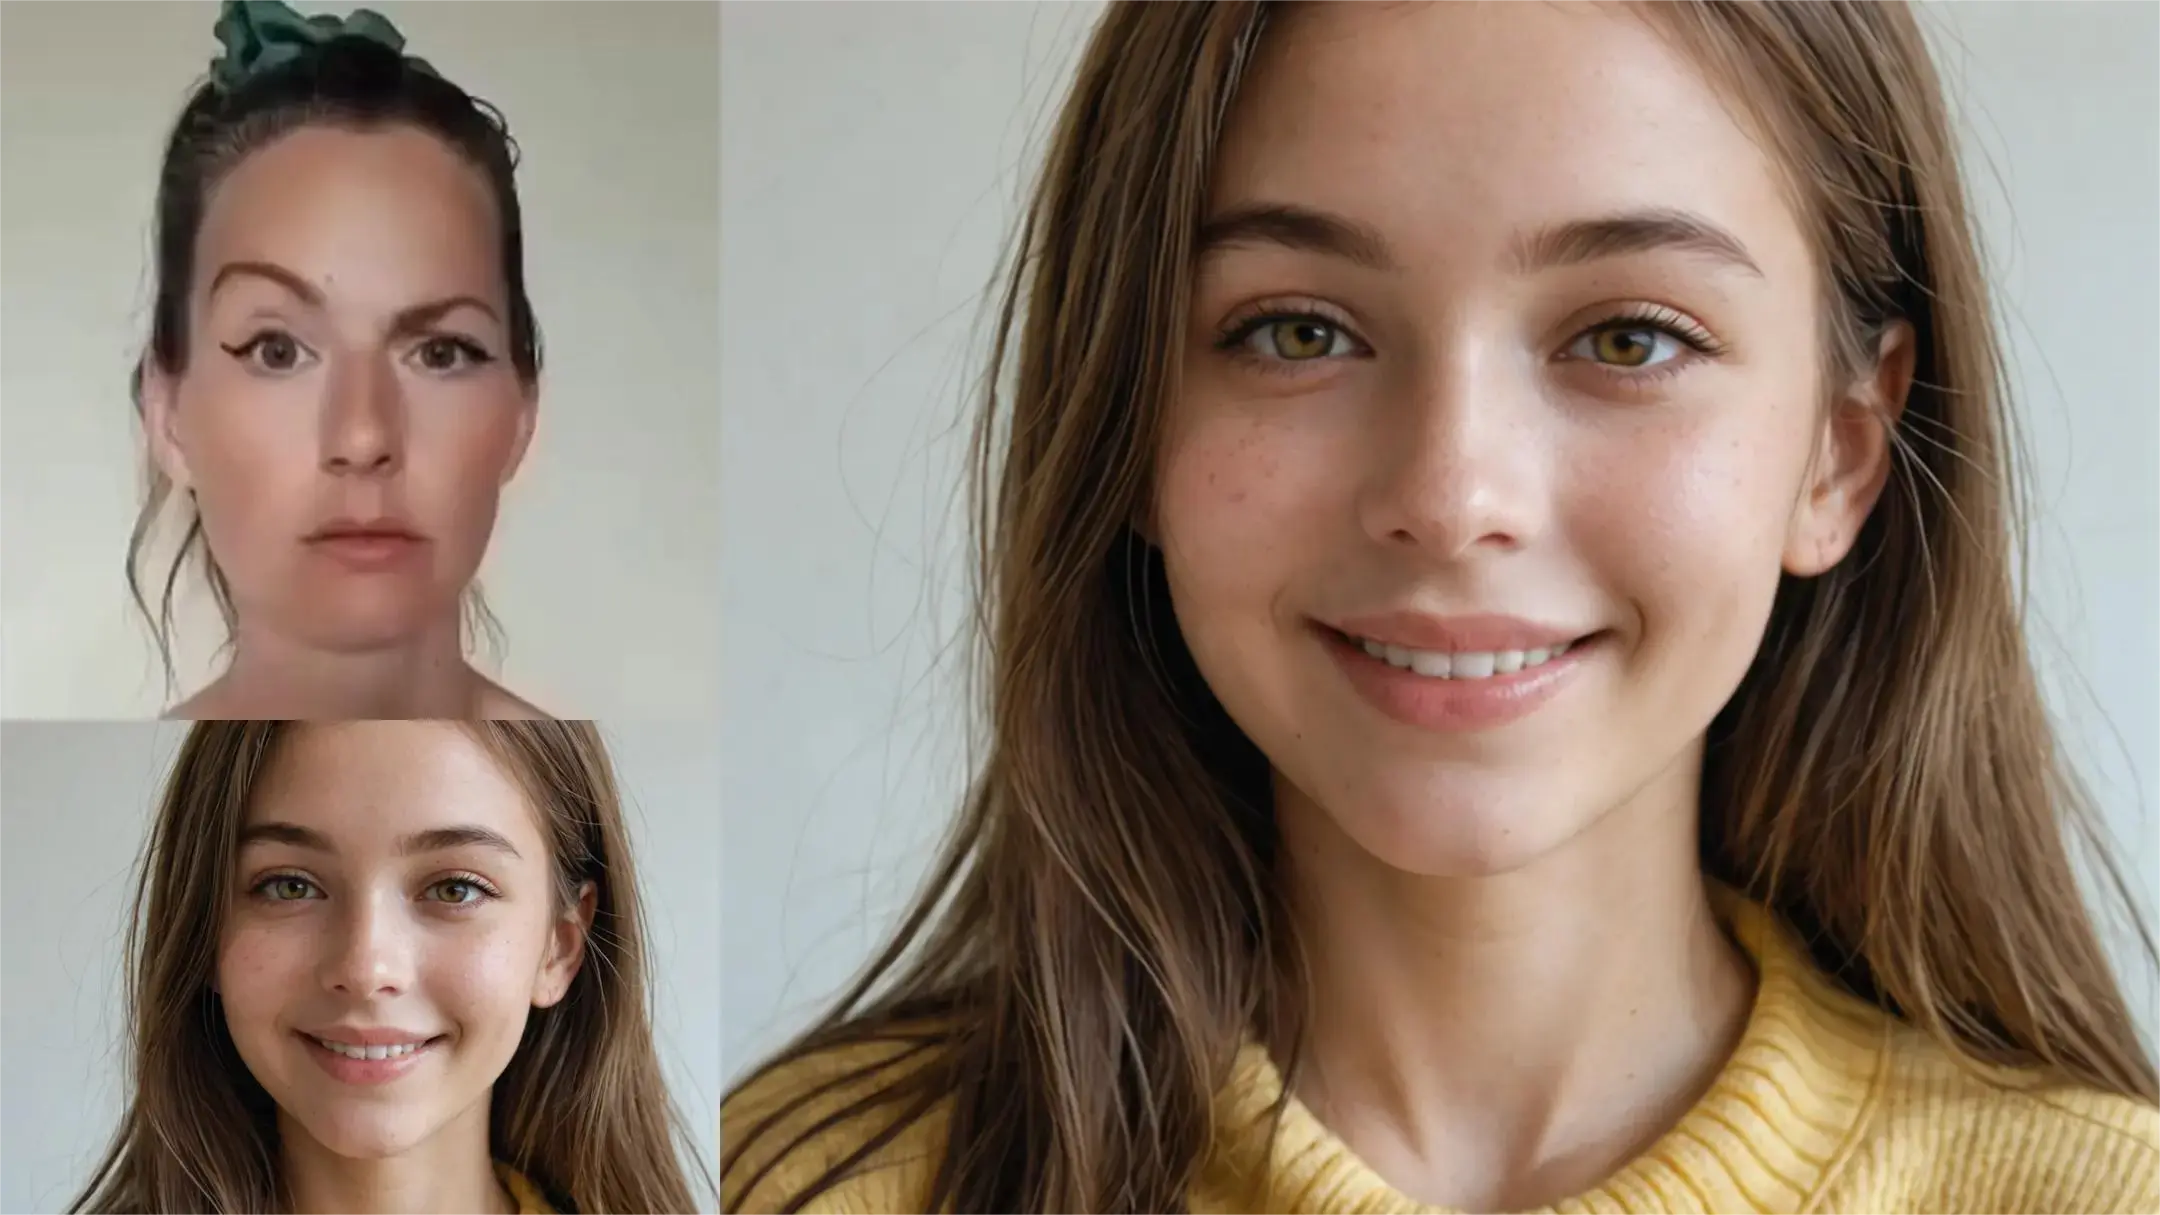
Trasforma un ritratto e un video di riferimento in un'animazione espressiva guidata da un prompt di testo richiesto.
L'unico campo obbligatorio è prompt. Usalo per descrivere la scena, il soggetto, l'azione, il comportamento della telecamera, lo stile visivo e qualsiasi audio che desideri venga generato dal modello.
duration può essere impostato su 6, 8, 10, 12, 14, 16, 18 o 20 secondi.
Queste durate sono disponibili. L'output resta a 1080p.
generate_audio è un valore booleano con valore predefinito true. Impostalo su false se non vuoi generare l’audio.
Questa pagina non presenta classifiche verificate di velocità, latenza o qualità. Come alternativa, consulta Pro Text-to-Video e confronta i due modelli con prompt e impostazioni rappresentativi.
Puoi usare una clip generata come materiale sorgente per il flusso di lavoro separato Retake Video. Rispetta i campi, gli intervalli e i valori enumerati indicati nella pagina collegata.
La tariffa è di 0,045 $ al secondo.
RunComfy è la piattaforma principale ComfyUI che offre ComfyUI online ambiente e servizi, insieme a workflow di ComfyUI con visuali mozzafiato. RunComfy offre anche AI Models, consentire agli artisti di sfruttare gli ultimi strumenti di AI per creare arte incredibile.