minimax-h3-fast/reference-to-video
MiniMax H3 Fast: video da un clip e fino a quattro immagini
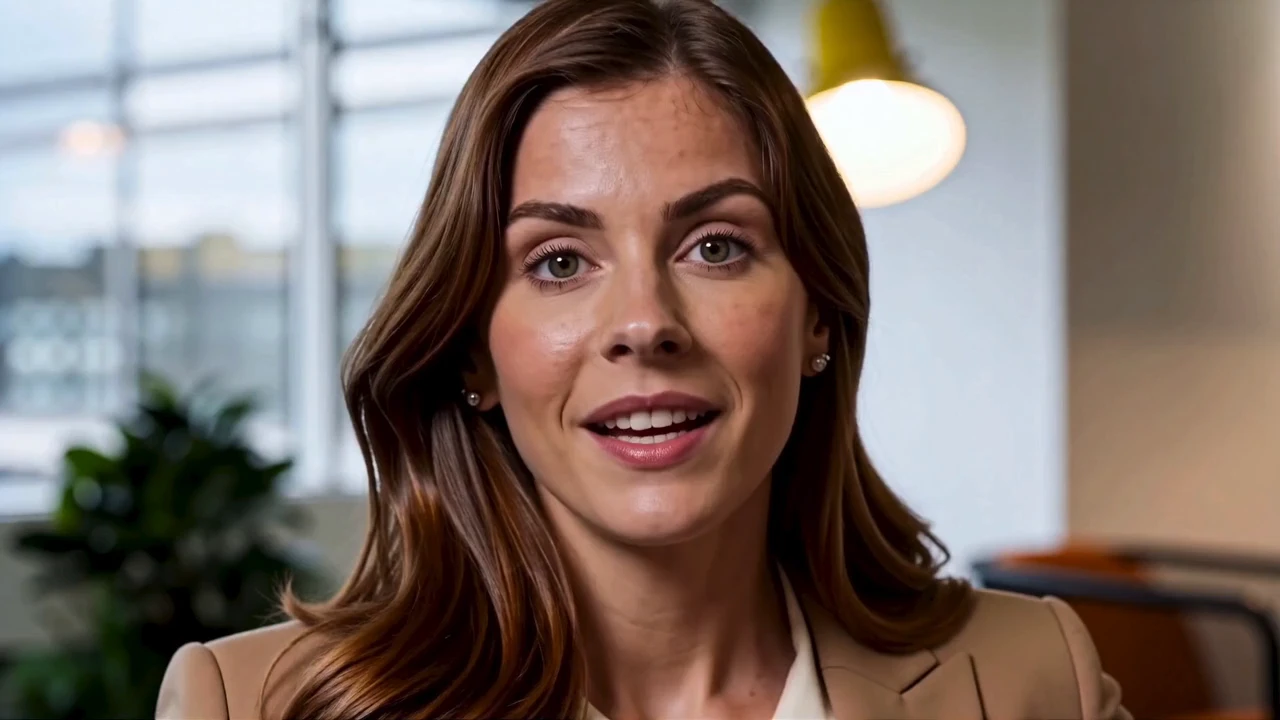
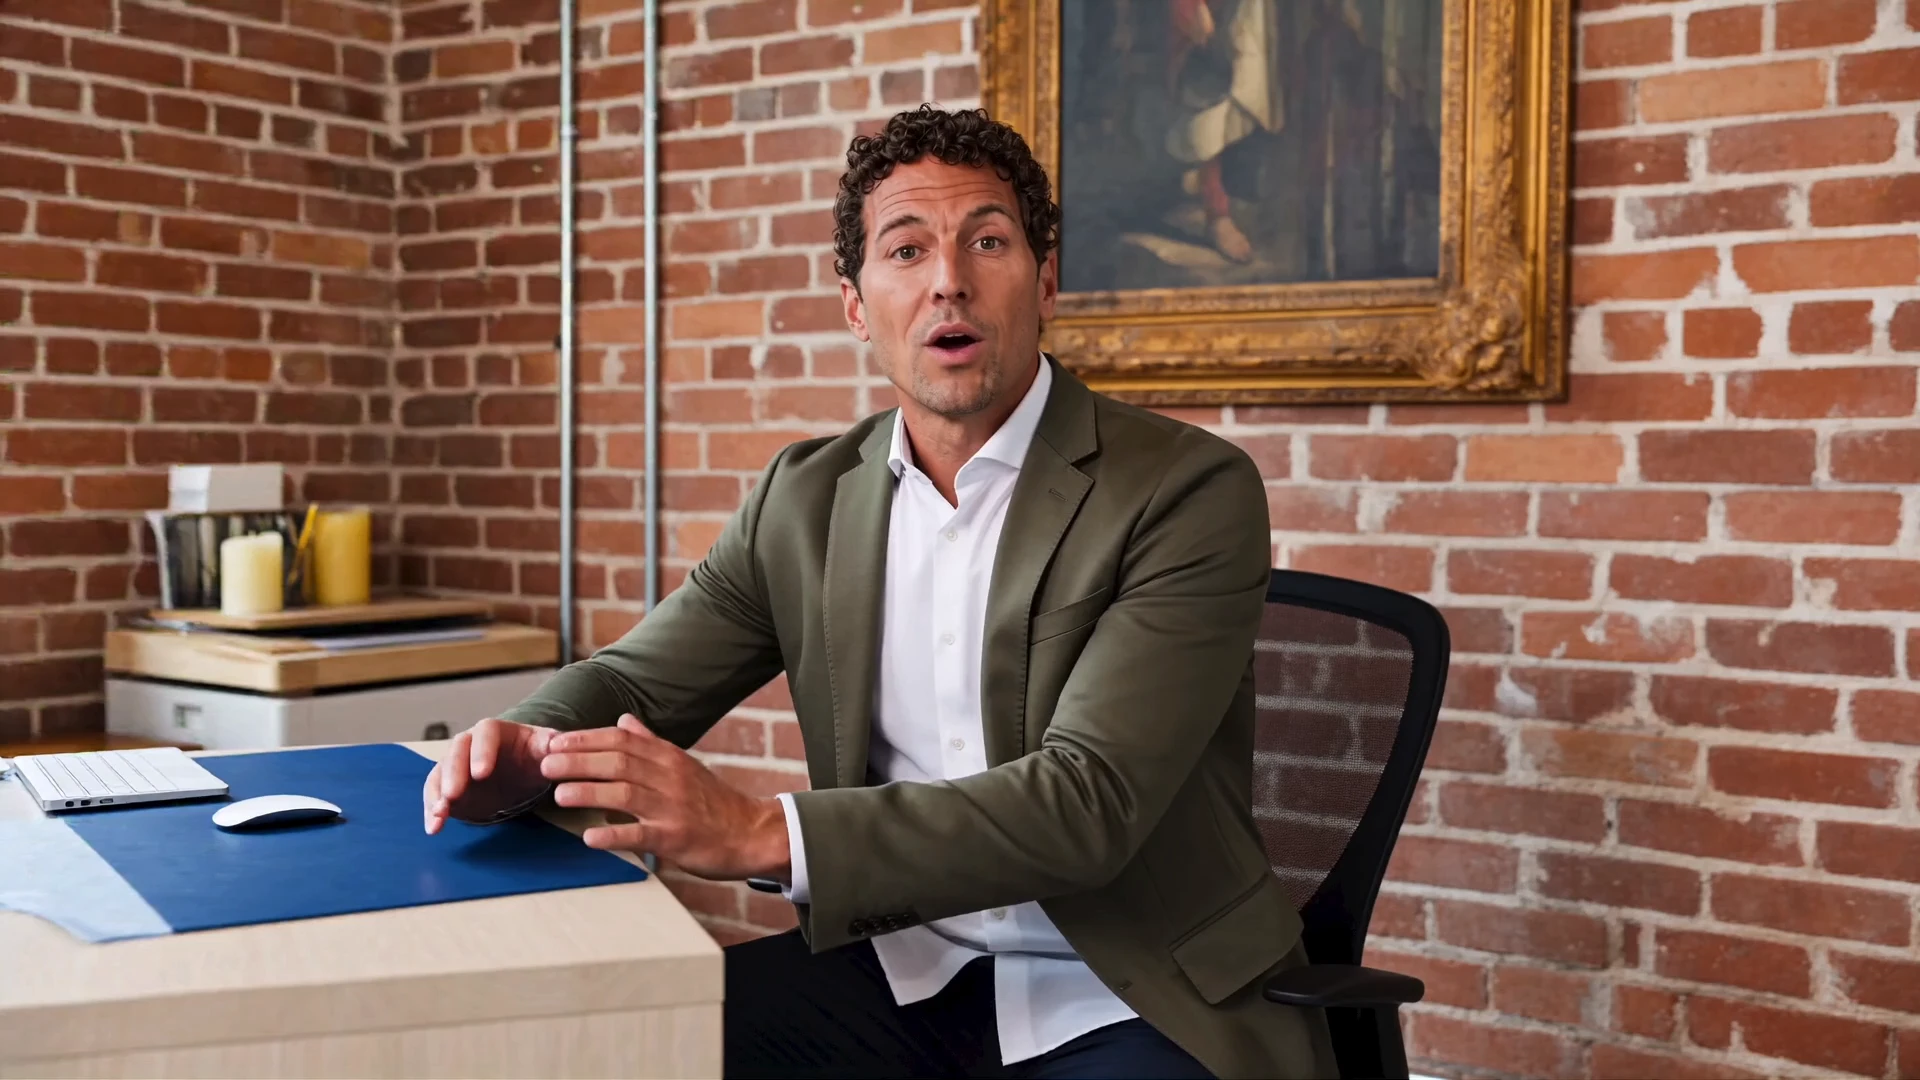
Avatar V Text To Video di HeyGen trasforma una sceneggiatura e uno sguardo pubblico in una clip con sincronizzazione labiale a $ 0,07 al secondo.
Scambiare un presentatore filmato con una performance guidata da una sceneggiatura è adatto a professionisti del marketing, formatori e fondatori.
Per gli sviluppatori, Avatar V su RunComfy può essere utilizzato sia nel browser che tramite un'API HTTP, quindi non è necessario ospitare o ridimensionare il modello manualmente.
Ideale per: Host di prodotti | Introduzioni delle lezioni | Aggiornamenti del fondatore.
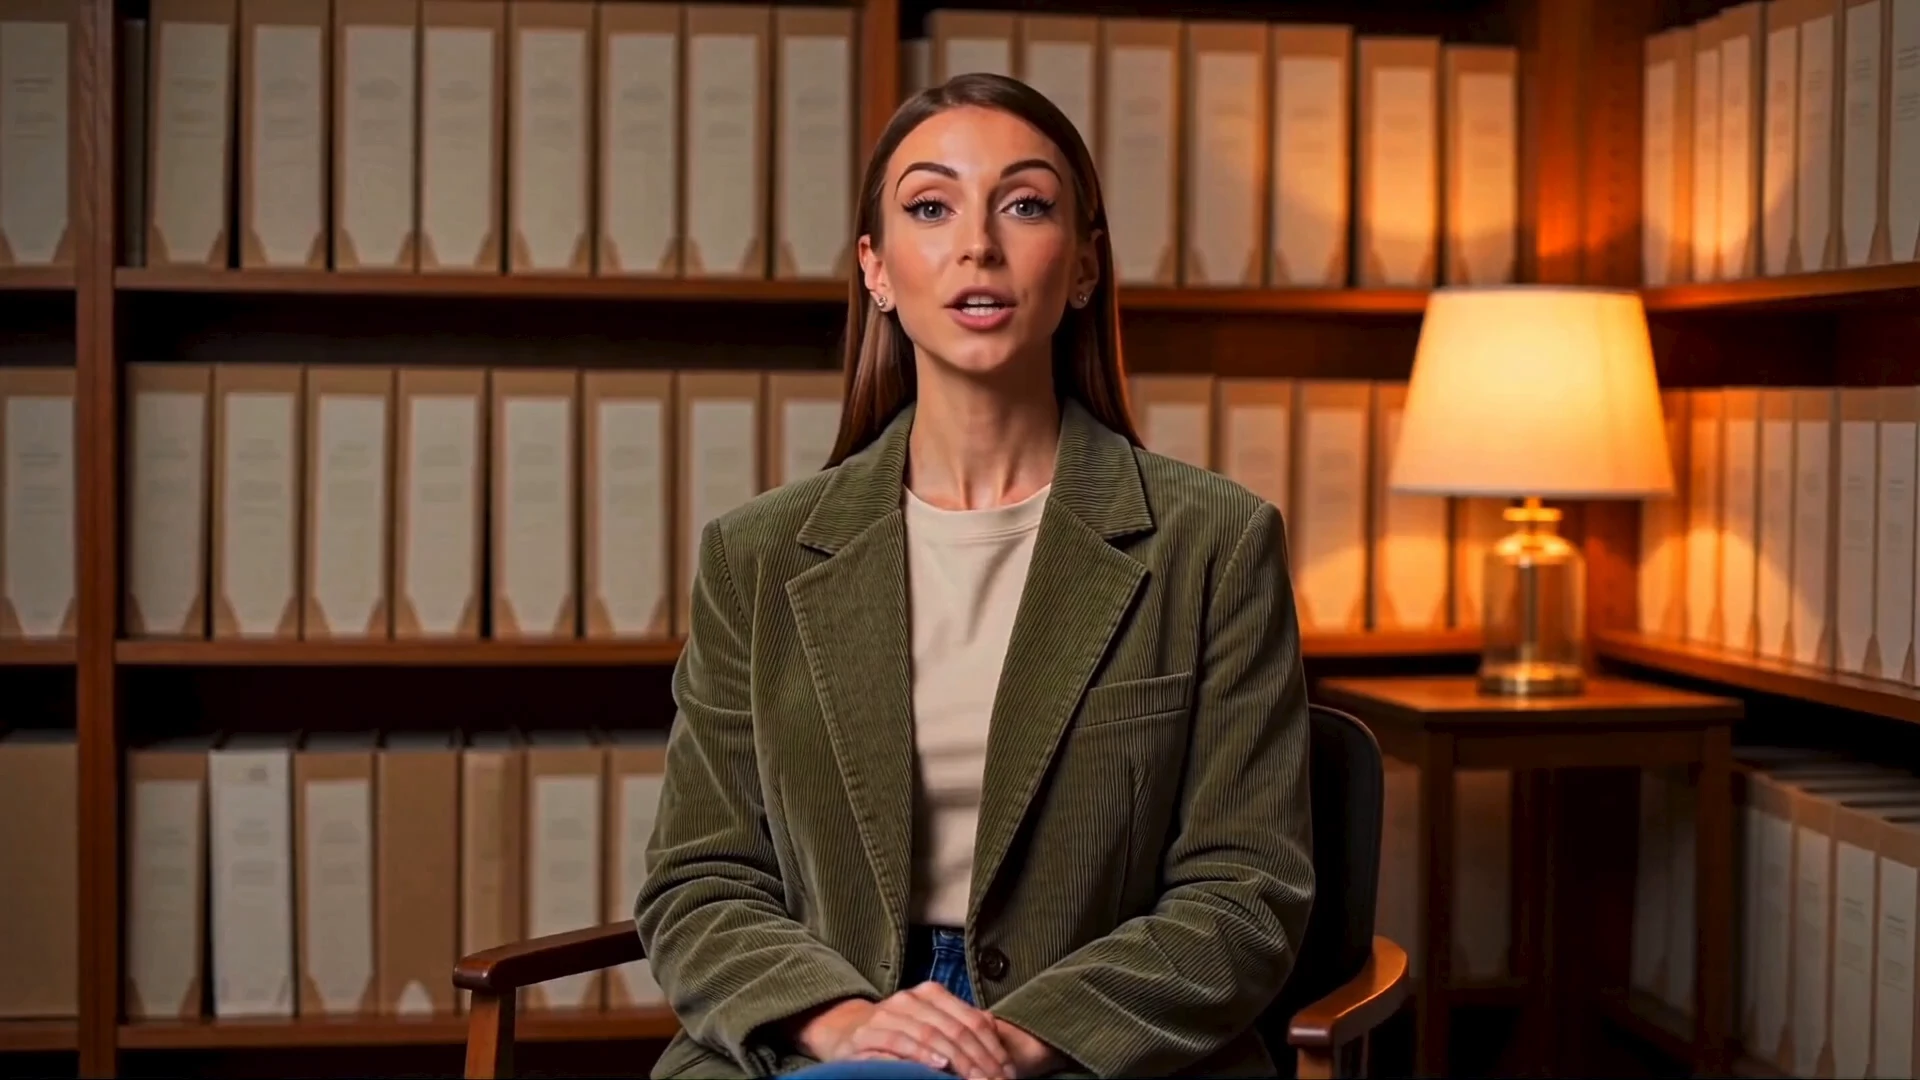
Un ritratto mostra un volto. La frase che digiti deve diventare una performance. Avatar V ripete con la bocca la frase e aggiunge un piccolo cenno del capo o una mano più tranquilla quando lo chiedi.
| Vantaggio | Cosa ottieni |
|---|---|
| Discorso guidato da script | La bocca segue le parole che invii. |
| Un look riutilizzabile | Una persona pubblica può trasportare un'intera serie di clip Avatar V. |
| Mozione facoltativa | Una breve nota può richiedere un cenno del capo. Saltalo e la linea Avatar V conduce ancora. |
| Tariffa unica | 720p e 1080p condividono lo stesso prezzo al secondo. |
Scegli una voce in questa pagina. Non carichi una registrazione. Le indicazioni della telecamera non ricostruiranno la stanza Avatar V, perché l'aspetto ha già il suo set.
Su RunComfy, prova una riga nell'interfaccia utente del modello, quindi ripeti lo stesso aspetto, voce e script tramite l'API HTTP.
avatar_id, voice_id, script, Resolution e facoltativo motion_prompt.Questi sono gli unici controlli in questa pagina.
| Parametro | Obbligatorio | Digitare | Predefinito | Gamma / Opzioni | Descrizione |
|---|---|---|---|---|---|
avatar_id* | Sì (*) | Stringa | Elisa | Otto look pubblici | Persona davanti alla telecamera. |
voice_id* | Sì (*) | Stringa | Aspetto della partita | Aspetto della partita, o otto voci | Voce per la sceneggiatura. |
copione* | Sì (*) | Stringa | Linea del mercato portuale | Fino a 5000 caratteri | Parole per parlare. La lunghezza imposta la clip. |
risoluzione | No | Stringa | 1080p | 720p, 1080p | Dimensioni del telaio. Stessa tariffa al secondo. |
prompt_movimento | No | Stringa | Vuoto | Breve testo | Cenno o nota a mano facoltativa. |
Non esiste un dispositivo di scorrimento della durata. La linea parlata imposta la lunghezza.
Avatar V fattura $ 0,07 al secondo del clip finito. Entrambe le dimensioni del frame utilizzano tale velocità.
| Lunghezza clip | Prezzo |
|---|---|
| 5 | $ 0,35 |
| 10 | $ 0,70 |
| 20 anni | $ 1,40 |
| Anni '30 | $ 2,10 |
Uno script più lungo costa di più solo perché il video è più lungo. Lo sguardo e la voce non aggiungono alcun compenso.
script. Non descrivere la stanza lì.MiniMax H3 Fast: video da un clip e fino a quattro immagini
Movimenti realistici, regia dinamica e controllo dello stile.

Trasforma scene scritte in clip cinematografiche con audio nativo opzionale.

Genera un video di 5 o 8 secondi da un prompt obbligatorio, con prompt negativo facoltativo, quattro dimensioni di output precise e controllo del seed.

Genera un video 16:9 da un prompt testuale, scegliendo durata, risoluzione, frame rate e audio facoltativo.

Trasforma immagini statiche in clip animate fluide con controllo dell'audio.
Avatar V trasforma una sceneggiatura scritta e uno sguardo pubblico in una clip parlante con sincronizzazione labiale. La bocca segue le parole che invii e una nota di movimento opzionale può richiedere un cenno del capo o una mano più calma. Si adatta agli host dei prodotti, alle introduzioni delle lezioni e ai brevi aggiornamenti dei fondatori.
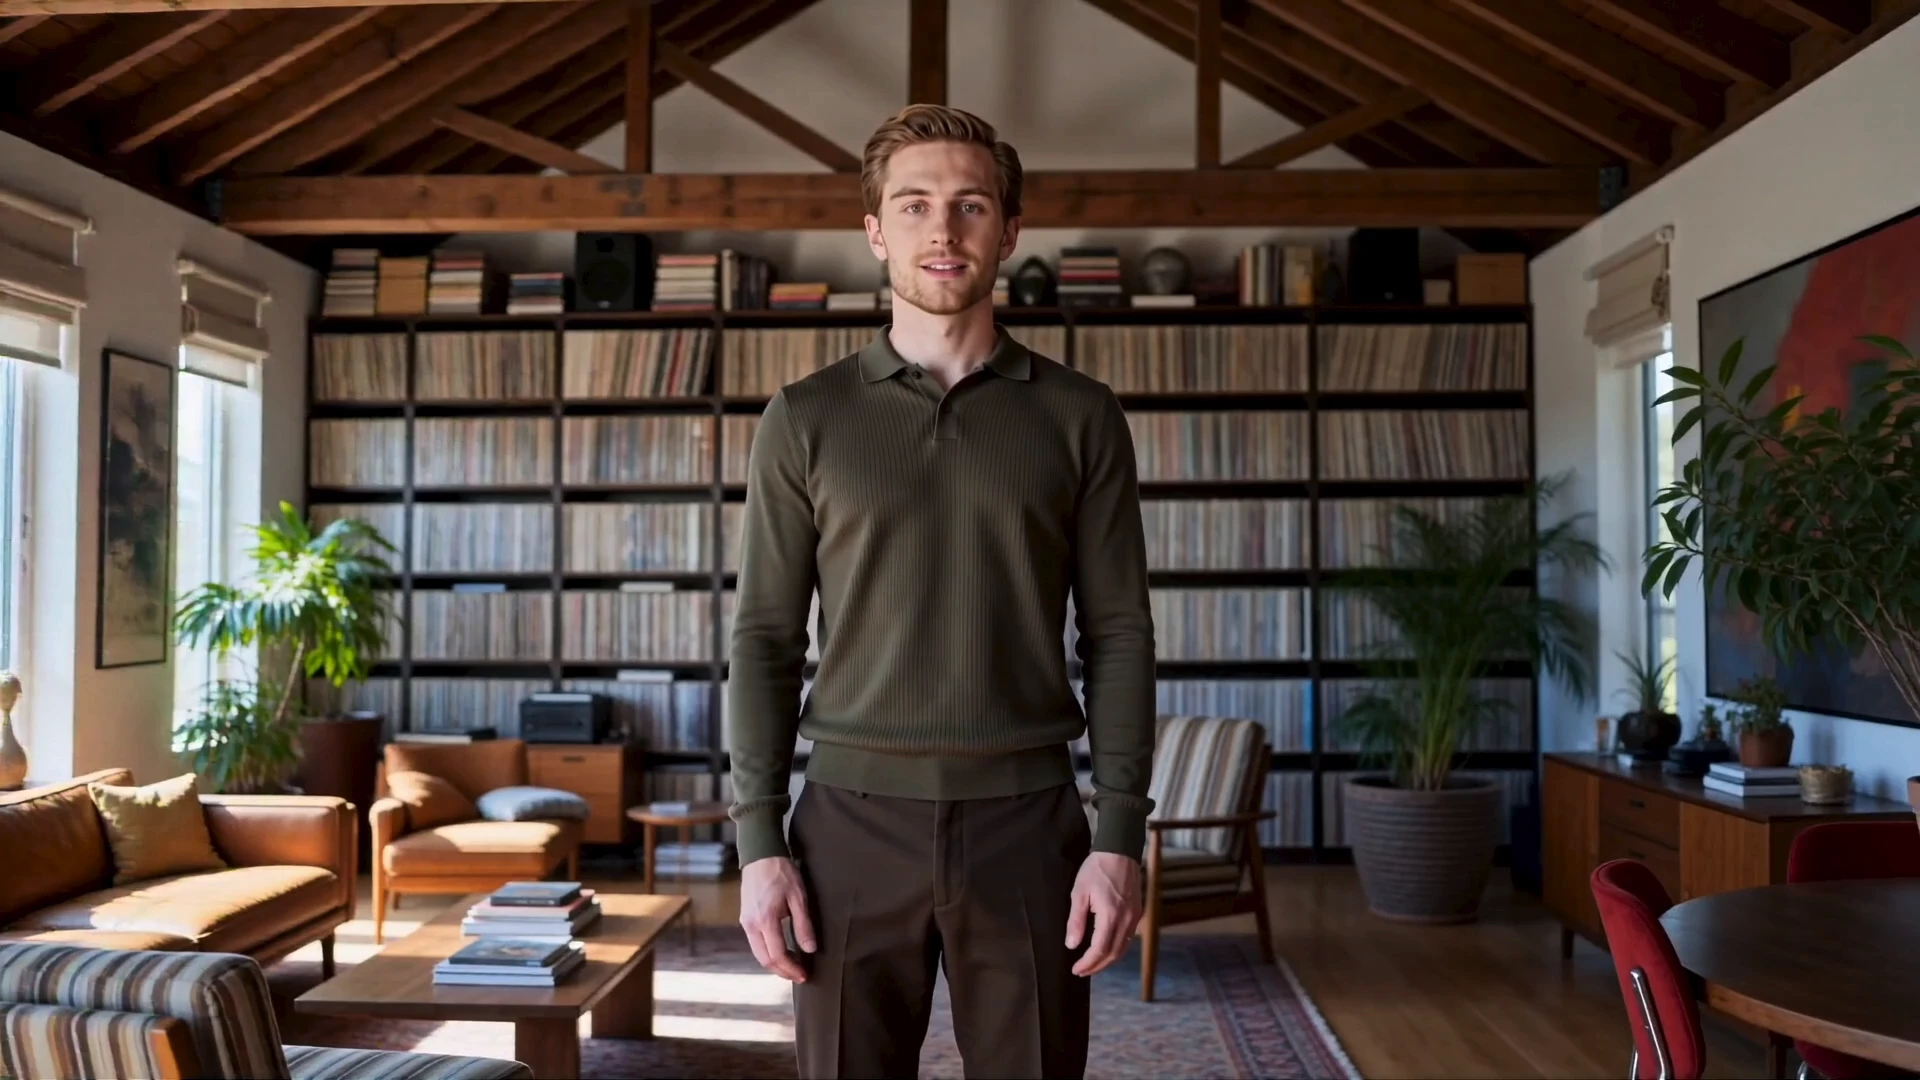
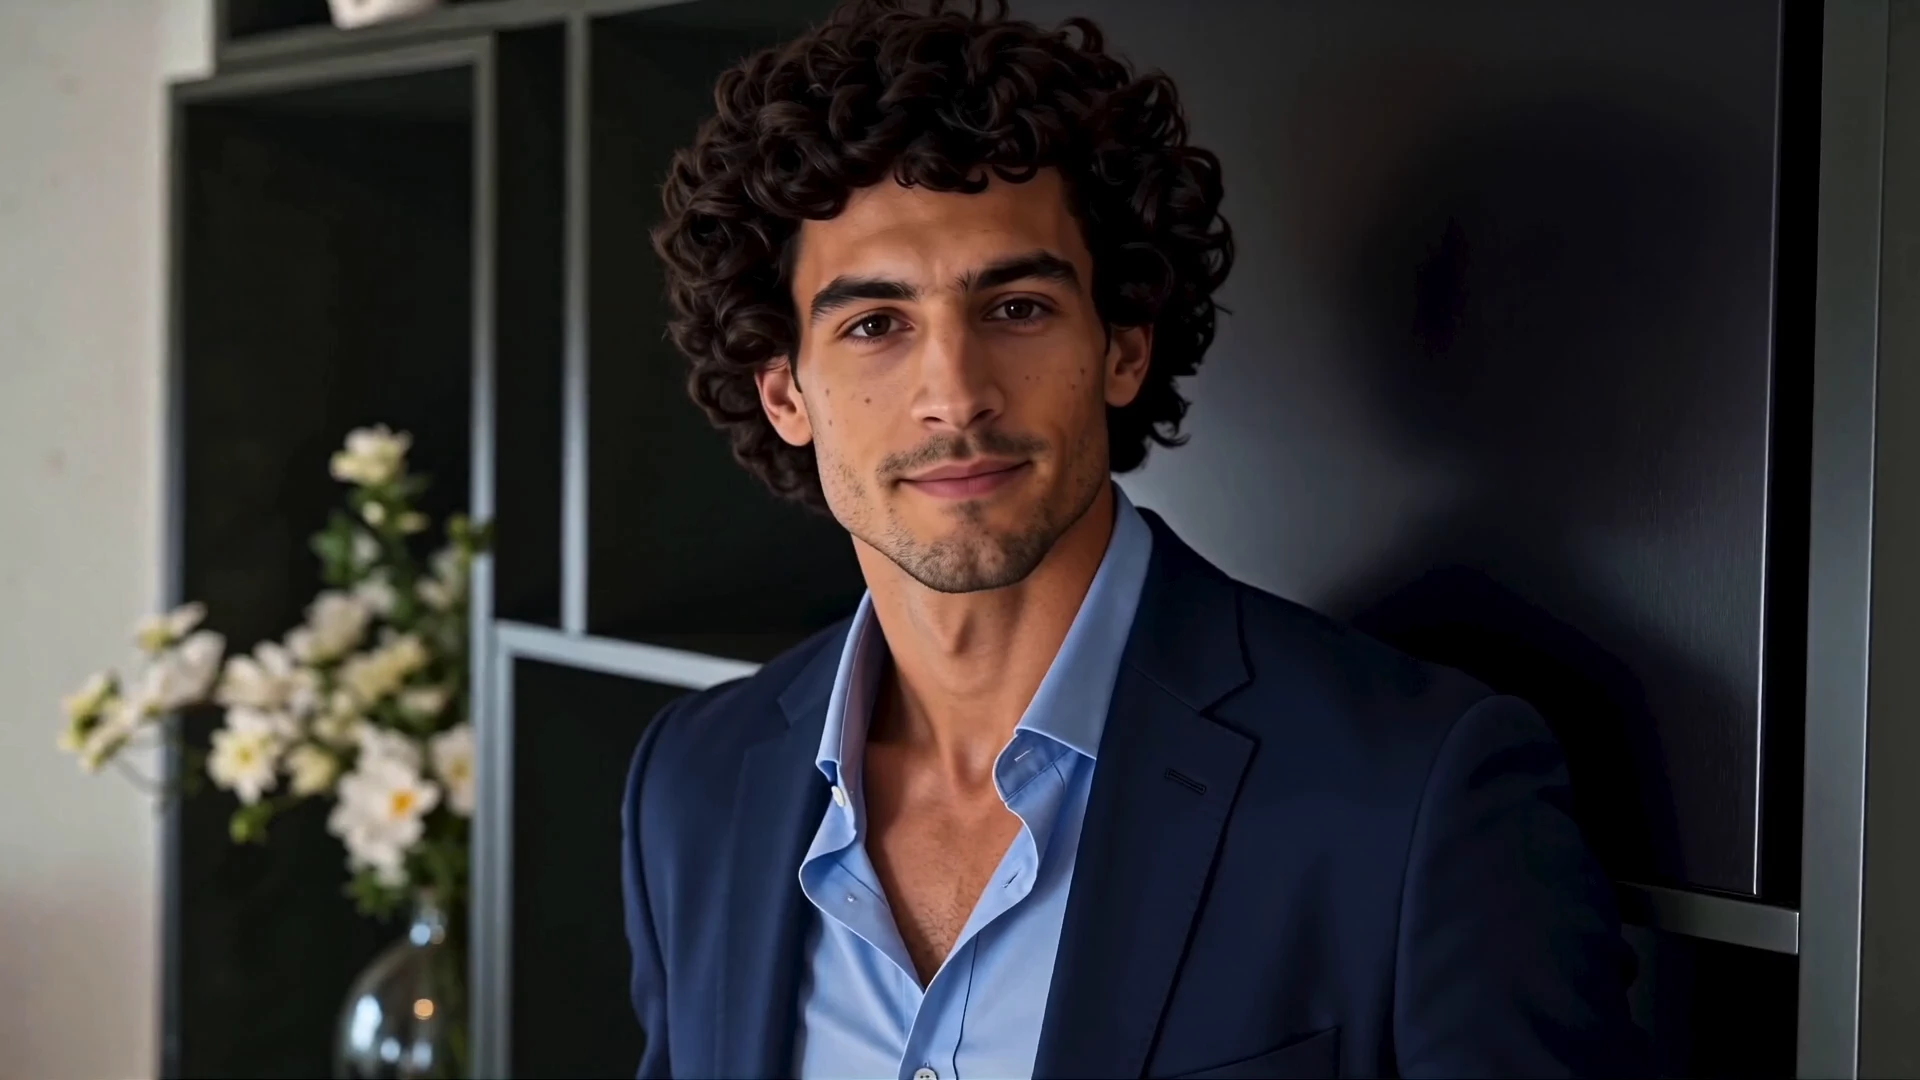
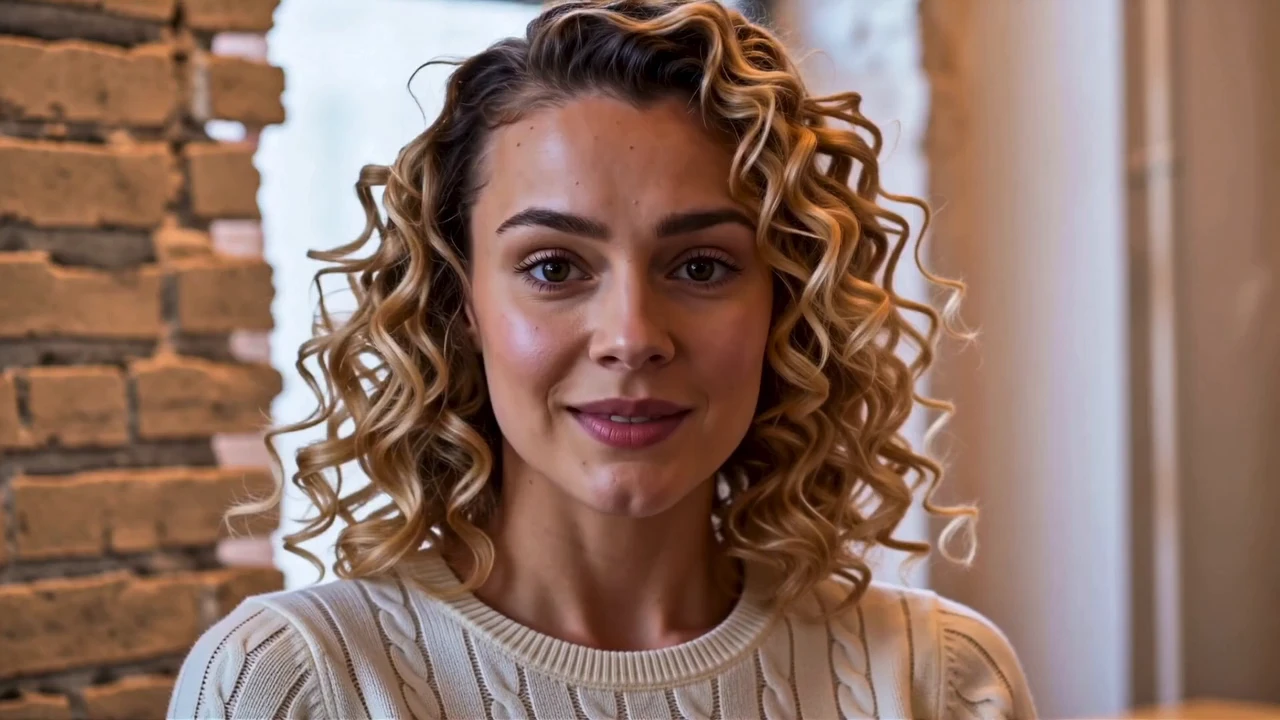
Avatar V offre otto sguardi pubblici, ciascuno con una voce accoppiata, più otto voci pubbliche con nome. Scegli Aspetto corrispondente per mantenere la voce che appartiene alla persona selezionata oppure scegli una voce con nome quando desideri una lettura diversa. Non caricare una registrazione su questa pagina.
Avatar V accetta uno script fino a 5000 caratteri e la riga parlata imposta la lunghezza. Non esiste un dispositivo di scorrimento della durata. Uno script più lungo costa di più solo perché il video finito è più lungo.
No. Avatar V fattura $ 0,07 al secondo della clip finita sia a 720p che a 1080p. Lo sguardo e la voce non aggiungono un compenso a parte. Leggi la riga una volta se desideri una lunghezza approssimativa prima di generare.
Utilizza la nota di movimento Avatar V per un piccolo gesto, ad esempio un cenno o una mano aperta. Stati d'animo opposti nella stessa nota si combattono. Lascialo vuoto quando vuoi che vengano pronunciate solo le parole.
Avatar V ha bisogno di uno sguardo pubblico, di una voce e di una sceneggiatura. La risoluzione è 720p o 1080p. La nota di movimento è facoltativa e lo script non deve superare i 5000 caratteri. Questi aspetti non sono uno strumento per i titoli, quindi aggiungi le didascalie in seguito.
SÌ. Crea il prototipo di Avatar V in Playground Web UI, quindi invia lo stesso aspetto, voce, script, risoluzione e nota di movimento opzionale tramite l'API RunComfy. L'API utilizza lo stesso modello. Non promette un turnaround fisso o una concorrenza illimitata.
Avatar V costa $ 0,07 al secondo del video finito. Una clip di 10 secondi costa $ 0,70 e una clip di 30 secondi costa $ 2,10. Le generazioni consumano crediti in USD e i nuovi conti in genere iniziano con un bilancio di prova.
RunComfy è la piattaforma principale ComfyUI che offre ComfyUI online ambiente e servizi, insieme a workflow di ComfyUI con visuali mozzafiato. RunComfy offre anche AI Models, consentire agli artisti di sfruttare gli ultimi strumenti di AI per creare arte incredibile.