logo
RunComfy
  • ComfyUI
  • EntraîneurNouveau
  • Modèles
  • API
  • Tarification
discord logo
MODÈLES
Explorer
Tous les modèles
BIBLIOTHÈQUE
Générations
APIS DE MODÈLES
Documentation API
Clés API
COMPTE
Utilisation

Z Image Turbo LoRA : texte vers image avec 3 LoRA | RunComfy

tongyi-mai/z-image/turbo/text-to-image/lora

Transformez un texte en image et combinez jusqu’à trois LoRA avec des poids distincts.

LoRA #1
URL ou ID de dépôt HuggingFace (propriétaire/repo) des poids LoRA.
Intensité d’application du modèle LoRA.
Liste des LoRA à appliquer (maximum 3).
La largeur de l'image générée en pixels. Chaque dimension doit être comprise entre 256 et 1 536.
La hauteur de l'image générée en pixels. Chaque dimension doit être comprise entre 256 et 1 536.
Seed de la génération. La valeur -1 utilise un seed aléatoire.
Idle
The rate is $0.011 per image.

Présentation de Z Image Turbo LoRA

Z Image Turbo LoRA génère une image à partir d’un prompt et peut appliquer jusqu’à trois adaptateurs LoRA. Chaque adaptateur est renseigné par une URL ou l’identifiant d’un dépôt HuggingFace et possède son propre réglage scale. La largeur, la hauteur et le seed se configurent également pour chaque exécution.

Z Image Turbo LoRA sur X

Réglages disponibles#

  • Prompt : prompt est la seule entrée obligatoire.
  • LoRA : loras est facultatif et accepte au maximum trois éléments. path reçoit une URL ou l’identifiant d’un dépôt HuggingFace ; scale va de 0 à 4 et vaut 1 par défaut.
  • Dimensions : width et height vont chacun de 256 à 1536 pixels. Leurs valeurs par défaut sont 1024 × 1536.
  • Seed : seed va de -1 à 2147483647. La valeur par défaut -1 choisit un seed aléatoire.

Méthode conseillée#

  1. Décrivez le sujet, la scène et le style dans prompt.
  2. Ajoutez d’abord un LoRA compatible et reprenez ses mots déclencheurs dans le prompt s’il en exige.
  3. Commencez avec scale à 1, puis ajustez progressivement.
  4. Réglez width et height selon le cadrage souhaité.
  5. Gardez seed à -1 pour de nouvelles variantes ou fixez une valeur pour comparer des réglages.

Si plusieurs adaptateurs se contrarient, testez-les séparément puis réduisez leurs valeurs scale respectives.


Modèles associés#

  • Z Image Turbo Text to Image
  • Z Image Turbo ControlNet

Modèles associés

wan-2.7/pro/text-to-image

WAN 2.7 Pro text-to-image produit des images fixes très détaillées pour l’impression et le grand format. Il reprend les commandes de la version Standard, accepte les prompts bilingues et génère jusqu’à cinq images par exécution.

gemini-3-pro-image-preview/text-to-image

Générez 1 à 4 images à partir d’un prompt obligatoire, avec 10 rapports d’aspect, une résolution 1K, 2K ou 4K, trois formats de fichier et un retour synchrone facultatif.

nano-banana-2.1/edit

Modifications d'image guidées par des instructions à partir de jusqu'à 10 références, sur 1K, 2K ou 4K.

ideogram-v3/text-to-image

Générez des images depuis un texte avec Ideogram 3.0 et contrôlez le format, la vitesse, la palette et le style.

seedream-4-0/edit

Modifiez ou combinez 1 à 10 images JPEG ou PNG requises avec une invite requise. Choisissez `1K`, `2K`, `4K` ou l'un des huit préréglages de résolution fixe.

gpt-image-2.6/flare/text-to-image

Conversion texte-image rapide avec texte lisible dans l'image, GIF et SVG, jusqu'à 4K.

Questions Fréquemment Posées

Quelles dimensions et combien de LoRA le modèle accepte-t-il ?

La largeur et la hauteur sont réglables de 256 à 1536 pixels. Une exécution peut appliquer jusqu’à trois adaptateurs LoRA.

Comment configurer un adaptateur LoRA ?

Indiquez une URL ou l’identifiant d’un dépôt HuggingFace dans path. scale règle son intensité de 0 à 4 et vaut 1 par défaut. seed vaut -1 par défaut, ce qui choisit un seed aléatoire.

Que faire si plusieurs LoRA donnent un résultat confus ?

Testez d’abord chaque adaptateur seul, utilisez les mots déclencheurs indiqués par sa documentation, puis réduisez les valeurs scale individuelles lorsque vous les combinez.

Suivez-nous
  • LinkedIn
  • Facebook
  • Instagram
  • Twitter
Support
  • Discord
  • Email
  • État du système
  • affilié
Modèles vidéo
  • Kling 4.0 Image to Video
  • Kling 4.0 Reference to Video
  • Kling 4.0 Video Editing
  • Wan 3.0
  • Wan 2.5
  • MiniMax H3 Fast
  • Voir tous les modèles →
Modèles d'images
  • Seedream 4.5
  • Seedream 5.0 Pro
  • Flux 2 Pro
  • Qwen Image Edit 2511 LoRA
  • seedream 4.0
  • Nano Banana Pro
  • Voir tous les modèles →
Légal
  • Conditions d'utilisation
  • Politique de confidentialité
  • Politique relative aux cookies
RunComfy
Droits d'auteur 2026 RunComfy. Tous droits réservés.

RunComfy est la première ComfyUI plateforme, offrant des ComfyUI en ligne environnement et services, ainsi que des workflows ComfyUI proposant des visuels époustouflants. RunComfy propose également AI Models, permettant aux artistes d'utiliser les derniers outils d'IA pour créer des œuvres d'art incroyables.

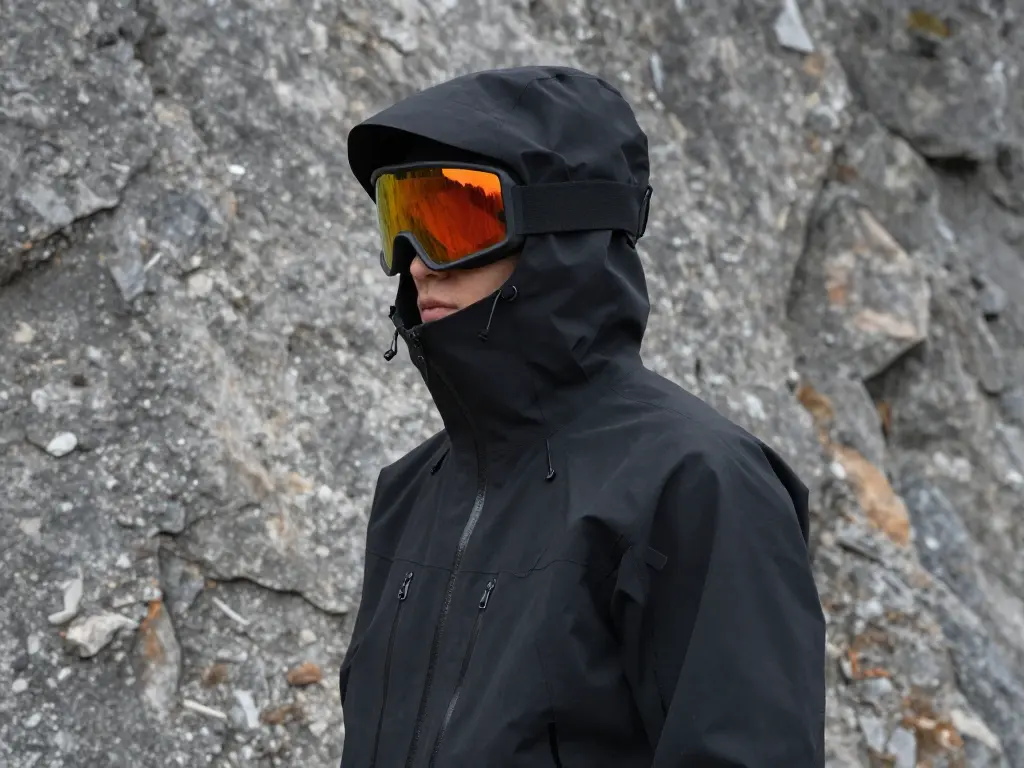
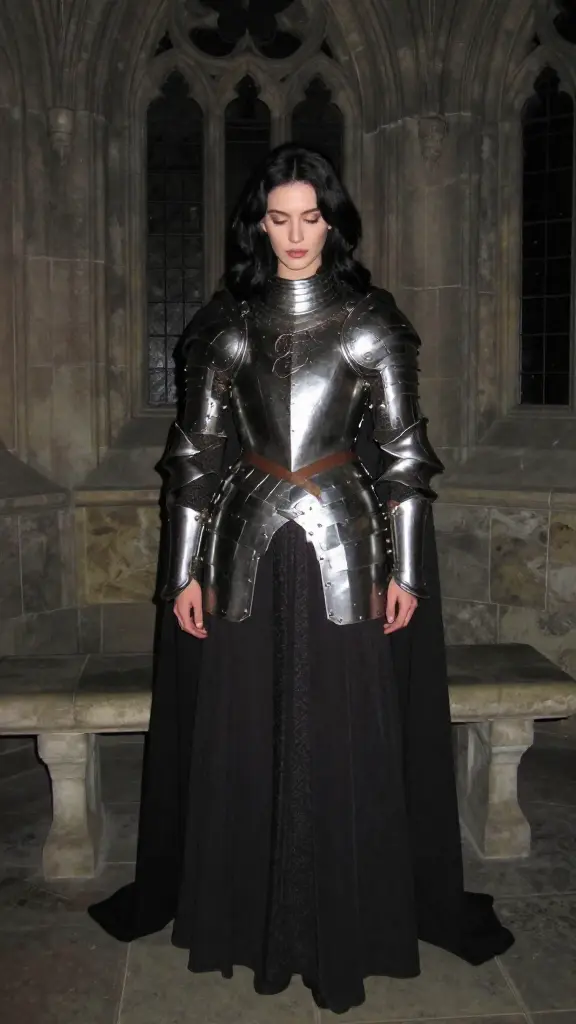
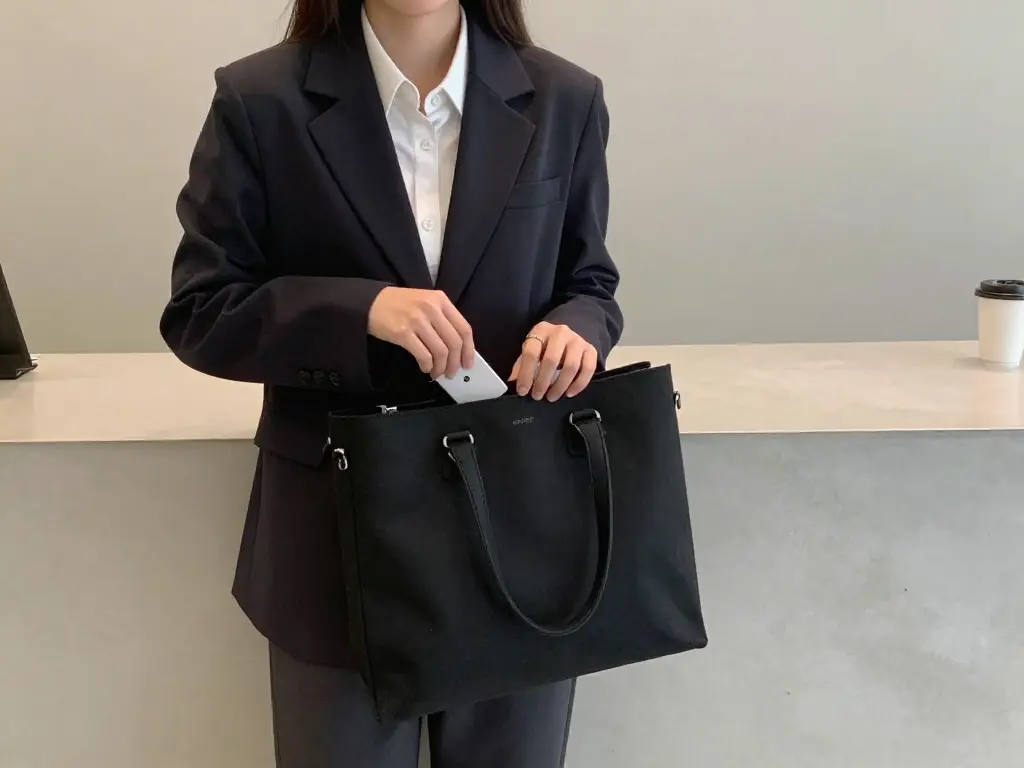
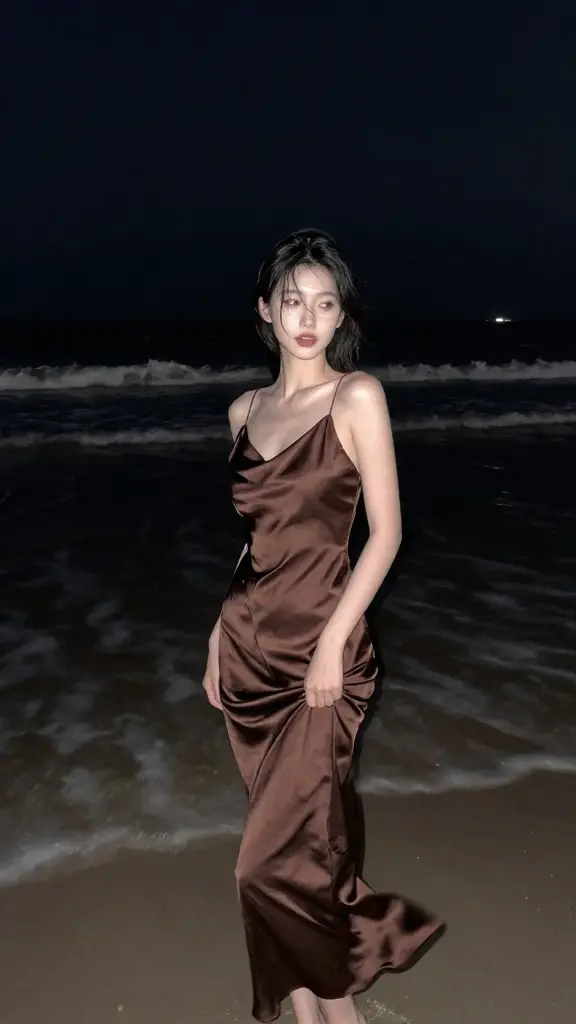
Exemples réalisés avec Z Image Turbo LoRA