logo
RunComfy
  • ComfyUI
  • Trainer
  • Modelle
  • MCPNeu
  • Preise
  • Seedance 2.5Hot
  • Seedream 5.5Neu

Workflows nach Modell

HotMiniMax H3Video mit Audio aus Text, Bildern oder ReferenzenHotQwen Image 2.1Bilder erstellen und Fotos mit Referenzen bearbeitenWanVideo aus Text oder Bildern, BewegungsübertragungFLUXBilderzeugung, Bearbeitung und CharaktervariantenLTXVideo mit synchronem Audio aus Text oder BildernQwen Image EditFotobearbeitung mit Text- und BildreferenzenKrea 2Bilderzeugung, Stiltransfer und ReferenzbearbeitungZ-ImageSchnelle Porträts und Konzepte aus Text

Beliebte & neue Workflows

NeuMiniMax H3 Character Swap V1.5Videofiguren tauschen, Originalton behaltenNeuP-H3-Image Reference EditFoto anhand eines Referenzbilds bearbeitenHotMiniMax H3 Image-to-VideoEin Bild zu Kinovideo mit synchronem AudioHotLTX 2.5 Image-to-VideoEin Frame zu scharfem Video mit synchronem AudioHotMiniMax H3 Character Swap (SAM3)Videofiguren tauschen, Bewegung beibehaltenQwen Image 2.1 Multi-Image EditingPräzise Szenen aus bis zu 10 ReferenzbildernFLUX Klein Face SwapNatürlicher, lebensechter GesichtstauschSeedVR2 Video UpscalerScharfes, flüssiges Video-Upscaling
Weitere Workflows ansehen

Modell trainieren

NeuMOSS-Image BaseBilderzeugung, neu unterstütztNeuFLUX.3 KleinBilderzeugung, neu unterstütztHotKrea 2Das meisttrainierte BildmodellHotKrea 2 TurboBilderzeugung mit wenigen SchrittenHotQwen Image 2.1Bilderzeugung und -bearbeitungZ-Image TurboSchnelle Porträts und KonzeptbilderMiniMax H3Video mit synchronem Audio

Trainieren & Bereitstellen

Erste SchritteIhr erster Trainingsjob mit Ostris AI ToolkitDatensätzeTrainingsdatensätze hochladen und verwaltenInferenzTrainierte Modelle im Playground oder per API nutzenBereitstellungenTrainierte Modelle als dedizierte Endpunkte bereitstellen
Weitere Modelle trainieren

Bildmodelle

NeuGPT Image 2.65 % Rabatt · Detailliertes Text-zu-Bild, GIF und SVG, bis 4KNeuSeedream 5.510 % Rabatt · Text-zu-Bild bis 2K, mit transparenten PNGsNeuMiniMax H3 Image10 % Rabatt · Text oder Referenzen zu einem Standbild bis 4KNeuFLUX 3 Image Klein10 % Rabatt · Text oder Referenzen zu einem Standbild von 768 bis 4KHotSeedream 5.0 Pro41 % Rabatt · Referenzbasierte Bearbeitung mit mehrsprachigem TextHotSeedream 4.520 % Rabatt · Fotorealistische Bearbeitung mit MarkenkonsistenzHotWan 2.6 ImageBildbearbeitung per AnweisungNano Banana Pro77 % Rabatt · Präzise 2K- bis 4K-Bilder aus Skizzen

Videomodelle

NeuSeedance 2.5 Flash34 % Rabatt · Text, image, or reference to videoNeuKling 4.010 % Rabatt · Standbild zu einem 3- bis 30-s-Clip animierenHotWan 3.0 Prime13 % Rabatt · Schnelle Clips aus ReferenzvideosHotSeedance 2.536 % Rabatt · Längere, konsistentere KinovideosHotWan 3.0Clips aus Bild-, Video- und AudioreferenzenHotMiniMax H3Ersten Frame zu einem 5- bis 15-s-Clip animierenWan 2.510 % Rabatt · Flüssige Bewegung mit nativem AudioFLUX 3 MaxClips aus Text, Standbild oder Keyframes
Weitere Modelle ansehen

API

Serverless (ComfyUI)ComfyUI-Workflows als serverlose Endpunkte bereitstellen.Serverless (LoRA)LoRAs als serverlose Endpunkte bereitstellen.Model APIGehostete Modelle bei Bedarf ohne Deployment ausführen.Trainer APILoRAs per API trainieren, verwalten und abrufen.CLIRun RunComfy models from your terminal.
MODELLE
Erkunden
Alle Modelle
BIBLIOTHEK
Generierungen
MODELL-APIS
API-Dokumentation
API-Schlüssel
KONTO
Nutzung

Wan 2.7 Text-to-Image: AI-Bilder online generieren | Models und API | RunComfy

wan-ai/wan-2.7/text-to-image

Erstellen Sie mit WAN 2.7 hochwertige Bilder aus chinesischen oder englischen Prompts – mit negativem Prompt, Größenformaten, bis zu fünf Varianten pro Auftrag und reproduzierbaren Seeds. Preis: etwa 0,03 US-Dollar pro Bild auf RunComfy. Ein konfigurierbarer Sicherheitsfilter ist ebenfalls enthalten.

Text-Prompt, der das gewünschte Bild beschreibt. Unterstützt Chinesisch und Englisch.
Inhalte, die im generierten Bild vermieden werden sollen. Maximal 500 Zeichen.
Voreinstellung für die Ausgabegröße. Falls unterstützt, kann statt einer Voreinstellung ein benutzerdefiniertes `{width, height}`-Objekt gesendet werden.
Maximale Anzahl der zu generierenden Bilder (1–5). Standardwert: 1.
Zufalls-Seed für reproduzierbare Ergebnisse (0–2147483647).
Idle
The rate is $0.03 per image.

Wan 2.7 Text-to-Image im Überblick

Alibabas Wan 2.7 Text-to-Image ist auf produktionsreife Standbilder ausgelegt: präzise Prompt-Umsetzung, chinesische und englische Eingaben sowie praktische Größensteuerung über image_size. Auf RunComfy stehen prompt, negative_prompt, image_size, max_images und seed zur Verfügung. Die Wan-2.7-Familie eignet sich besonders für durchdachte Bildkompositionen und hohe Prompt-Treue. Der Sicherheitsfilter lässt sich über enable_safety_checker steuern.

Ideal für: Marketingmotive | Concept Art | Social-Media-Formate | schnelle Layouttests vor Pro-Renderings

Wan 2.7 Text-to-Image#


Überblick#


Wan 2.7 Text-to-Image auf RunComfy verwandelt chinesische oder englische Prompts in Standbilder. Das Modell legt Wert auf präzises Prompt-Verständnis und detailreiche Ergebnisse. Maximale Auflösung und feste Grenzwerte richten sich nach der aktuellen RunComfy-Bereitstellung.


Antwortfelder#


Jeder erfolgreiche Auftrag liefert ein bis fünf Bilder im Array images, optionalen Modelltext in generated_text und einen seed in der Antwort.


Hauptmerkmale#


  • Zweisprachige Eingabeaufforderungen: Englisch und Chinesisch werden unterstützt.
  • Negative Eingabeaufforderung: Bis zu 500 Zeichen, um unerwünschte Elemente zu vermeiden.
  • image_size-Voreinstellungen: square_hd, square, Hoch- und Querformat 4:3 und 16:9. Ein {width, height}-Objekt kann in erweiterten Integrationen unterstützt werden.
  • Batch-Exploration: max_images 1–5 für Variationen in einem Job.
  • Reproduzierbarkeit: Optionaler ganzzahliger seed im Bereich [0, 2147483647].
  • Sicherheit: enable_safety_checker moderiert Ein- und Ausgabe (Standardeinstellung).

Parameter#

ParameterErforderlichTypStandardBereich / OptionenBeschreibung
prompt*Jastring——Hauptmotiv, Stil und Komposition
negative_promptNeinstring""max. 500 ZeichenZu vermeidende Inhalte
image_sizeNeinstringsquare_hdenum presetsAusgabeformat bzw. -größe
max_imagesNeininteger11–5Anzahl der zu generierenden Bilder
seedNeininteger—0–2147483647Reproduzierbarkeit
enable_safety_checkerNeinbooleantrueon / offModeration von Ein- und Ausgabe

Preise#

AbrechnungPreis
Pro generiertem Bild0,03 US-Dollar

Die Gebühren richten sich nach der Anzahl der Bilder (max_images) in einer einzelnen Anfrage.


Verwendung#


  1. Schreiben Sie eine strukturierte Aufforderung: Thema, Umgebung, Beleuchtung, Objektiv und Stil.
  2. Fügen Sie eine kurze negative_prompt nur für konkrete Dinge hinzu, die Sie unterdrücken möchten.
  3. Wählen Sie eine Größenvoreinstellung aus, die Ihrem Lieferseitenverhältnis entspricht.
  4. Stellen Sie max_images auf einen Wert größer als 1 ein, wenn Sie Variationen erkunden. Halten Sie seed fest, um Eingabeaufforderungsänderungen vergleichen zu können.
  5. Senden und iterieren. Verschärfen Sie das Vokabular der Kamera, wenn die Komposition abweicht.

Prompt-Tipps#


  • Beginnen Sie mit dem Heldenthema, dann mit Beleuchtung und Materialien.
  • Geben Sie Aspektanforderungen explizit an, wenn Sie keine passende Voreinstellung verwenden.
  • Ändern Sie für die Iteration jeweils eine Dimension (Eingabeaufforderung vs. Startwert vs. Größe).

Verwandte Wan-2.7-Modelle#


  • Wan 2.7 Text-to-Image Pro auf RunComfy – Stufe mit höherer Wiedergabetreue.
  • Wan 2.7 Image Edit auf RunComfy – referenzbasierte Bearbeitungen.
  • Wan 2.7 Text-to-Video – Bewegungsworkflows auf RunComfy.

Ähnliche Modelle

gpt-image-2/text-to-image

Markengerechte Visuals mit präzisem Text und Logos im Bild erzeugen.

flux-2/dev/edit

Bearbeiten Sie bis zu drei Quellbilder und steuern Sie Guidance-Stärke, Inferenzschritte, Bildanzahl, Prompt-Erweiterung, Größe, Seed und Format.

dreamina-4-0/edit

Erstelle 4K-Bilder mit präzisen Anpassungen und flexibler Stilsteuerung.

flux-3/text-to-image

FLUX 3 Image ist ein multimodales Bildmodell mit Referenzsteuerung und gut lesbarer Textdarstellung

wan-2-2/text-to-image

Erzeugen Sie mit Wan 2.2 Plus ein Bild aus einem Prompt und wählen Sie Größe, Seed und Prompt-Erweiterung.

flux-1-kontext/pro/text-to-image

Schnelles, präzises KI-Tool für kontextbasiertes Bilddesign.

Häufig gestellte Fragen

Was ermöglicht Wan 2.7 Text-to-Image auf RunComfy?

RunComfy integriert Wan 2.7 Text-to-Image aus Alibabas Modellfamilie. Die dokumentierten Felder prompt, negative_prompt, image_size, max_images, seed und enable_safety_checker werden an den für dieses Modell konfigurierten Inferenzdienst gesendet.

Wie viel kostet Wan 2.7 Text-to-Image pro Bild auf RunComfy?

Der RunComfy-Preis beträgt 0,03 US-Dollar pro generiertem Bild. Wenn Sie max_images auf einen Wert über 1 setzen, steigen die Gesamtkosten mit der Zahl der tatsächlich ausgegebenen Bilder.

Unterstützt Wan 2.7 Text-to-Image chinesische Eingabeaufforderungen?

Ja. In der RunComfy-Modelloberfläche können Sie Prompts auf Chinesisch oder Englisch eingeben.

Wie viele Bilder kann ich in einer Wan 2.7-Text-zu-Bild-Anfrage generieren?

max_images muss bei diesem Modell eine Ganzzahl zwischen 1 und 5 sein.

Sollte ich Wan 2.7 Text-to-Image oder Wan 2.7 Pro Text-to-Image verwenden?

Beide Varianten verwenden dieselben Parameternamen. Die Standardversion ist günstiger und eignet sich für Entwürfe und schnelle Iterationen; Pro zielt auf detailreichere Ergebnisse zu einem höheren Bildpreis. Nutzen Sie Standard zum Erkunden und Pro für finale Key Visuals.

Kann ich statt einer `image_size`-Voreinstellung eine benutzerdefinierte Breite und Höhe festlegen?

Diese Modelloberfläche verwendet String-Voreinstellungen, damit Eingaben zuverlässig über die Standardintegration zugeordnet werden. In erweiterten oder reinen API-Setups kann ein benutzerdefiniertes {width, height}-Objekt unterstützt werden. Prüfen Sie dies in den Einstellungen Ihres RunComfy-Workspace, bevor Sie beliebige Maße verwenden.

Folge uns
  • LinkedIn
  • Facebook
  • Instagram
  • Twitter
Support
  • Discord
  • E-Mail
  • Systemstatus
  • Partner
Videomodelle
  • Seedance 2.5 Flash Text To Video
  • Seedance 2.5 Flash
  • Seedance 2.5 Flash Reference to Video
  • Wan 3.0
  • MiniMax H3 Fast
  • Wan 2.5
  • Alle Modelle anzeigen →
Bildmodelle
  • Seedream 5.5
  • Seedream 5.5 Edit
  • Seedream 5.5 Layer Decomposition
  • Wan 2.6 Image to Image
  • Nano Banana Pro
  • Seedream 5.0 Pro
  • Alle Modelle anzeigen →
Rechtliches
  • Nutzungsbedingungen
  • Datenschutzrichtlinie
  • Cookie-Richtlinie
RunComfy
Urheberrecht 2026 RunComfy. Alle Rechte vorbehalten.

RunComfy ist die führende ComfyUI Plattform, die ComfyUI online Umgebung und Services bietet, zusammen mit ComfyUI Workflows mit atemberaubenden Visualisierungen. RunComfy bietet auch AI Models, Künstlern ermöglichen, die neuesten AI-Tools zu nutzen, um unglaubliche Kunst zu schaffen.
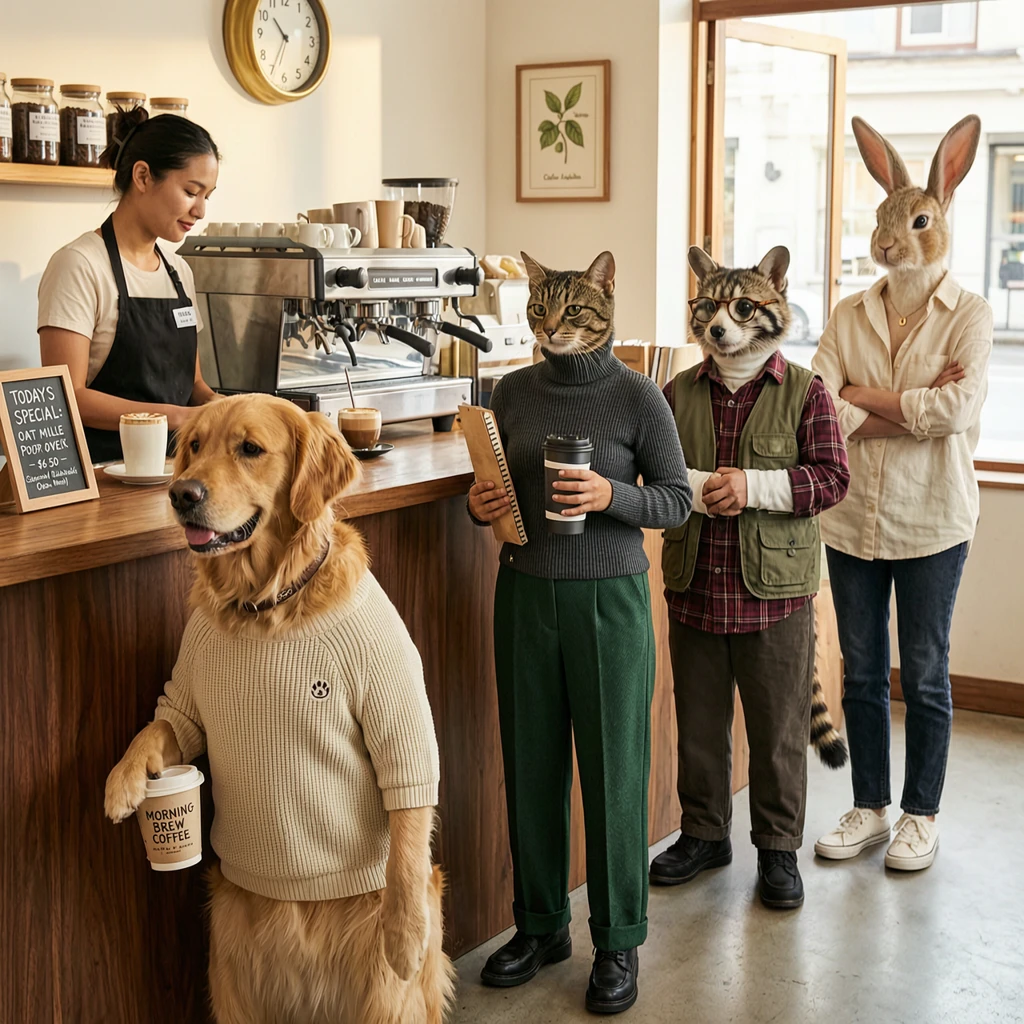
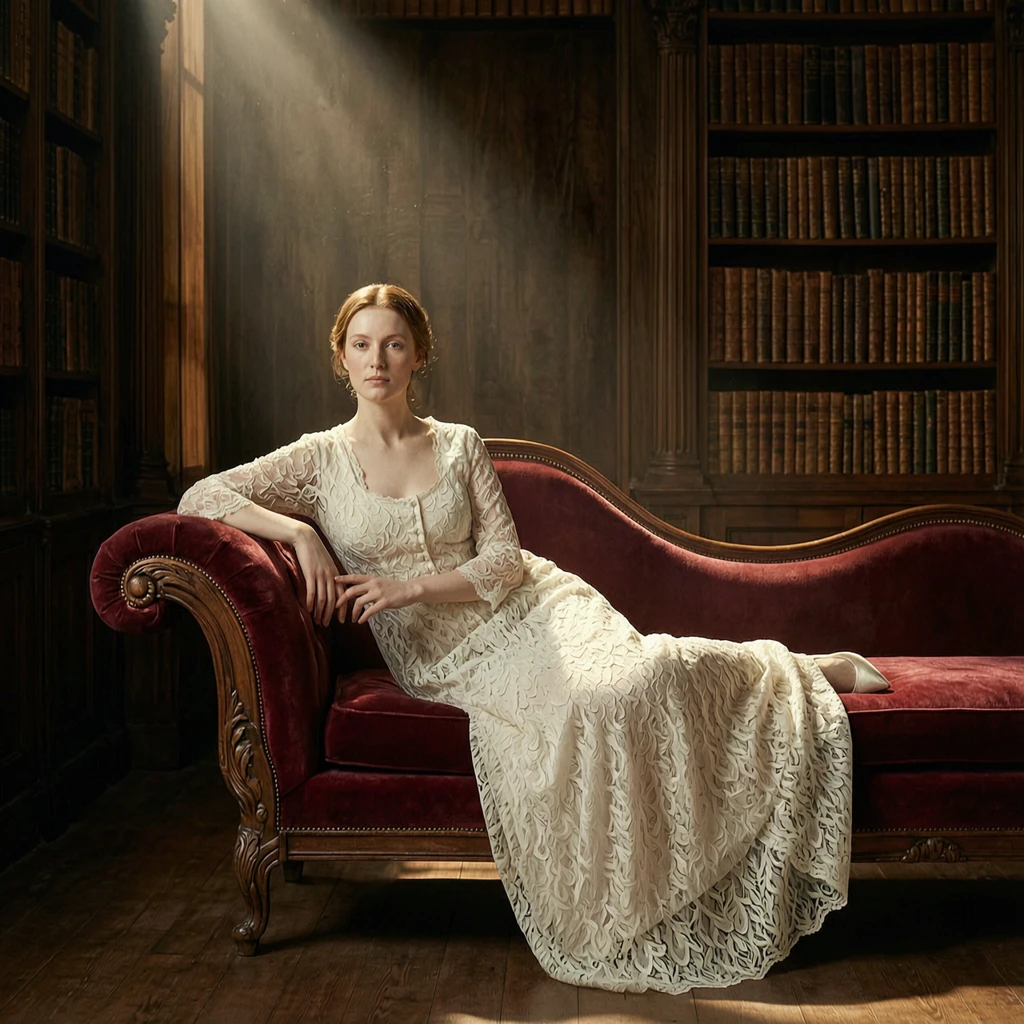
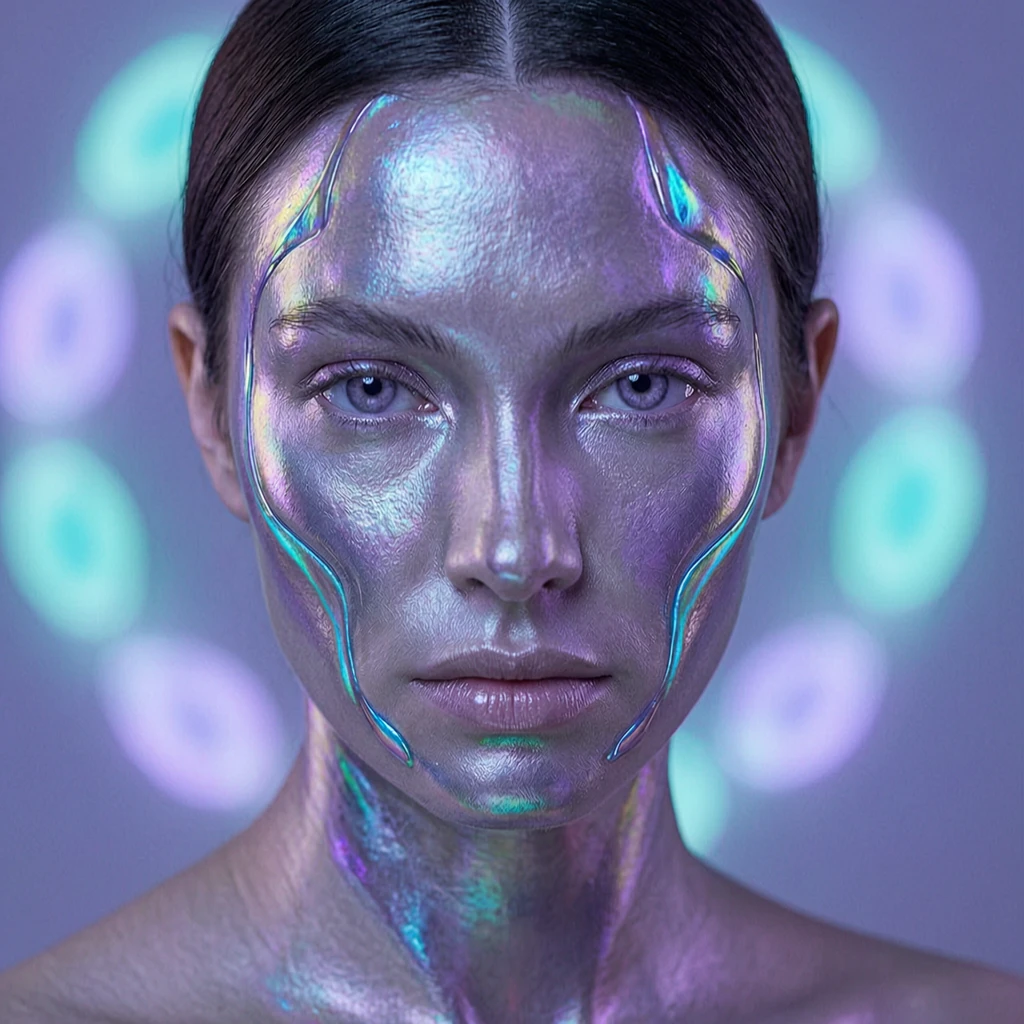
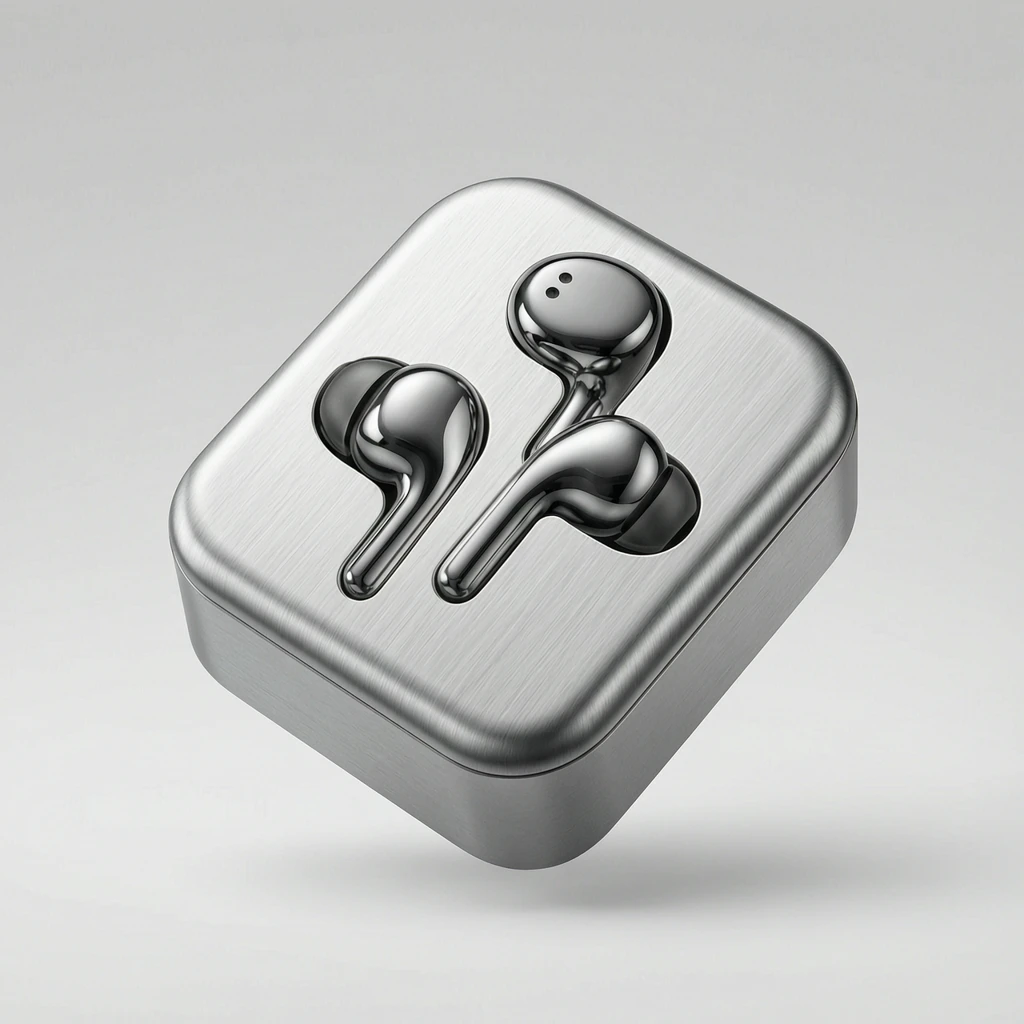
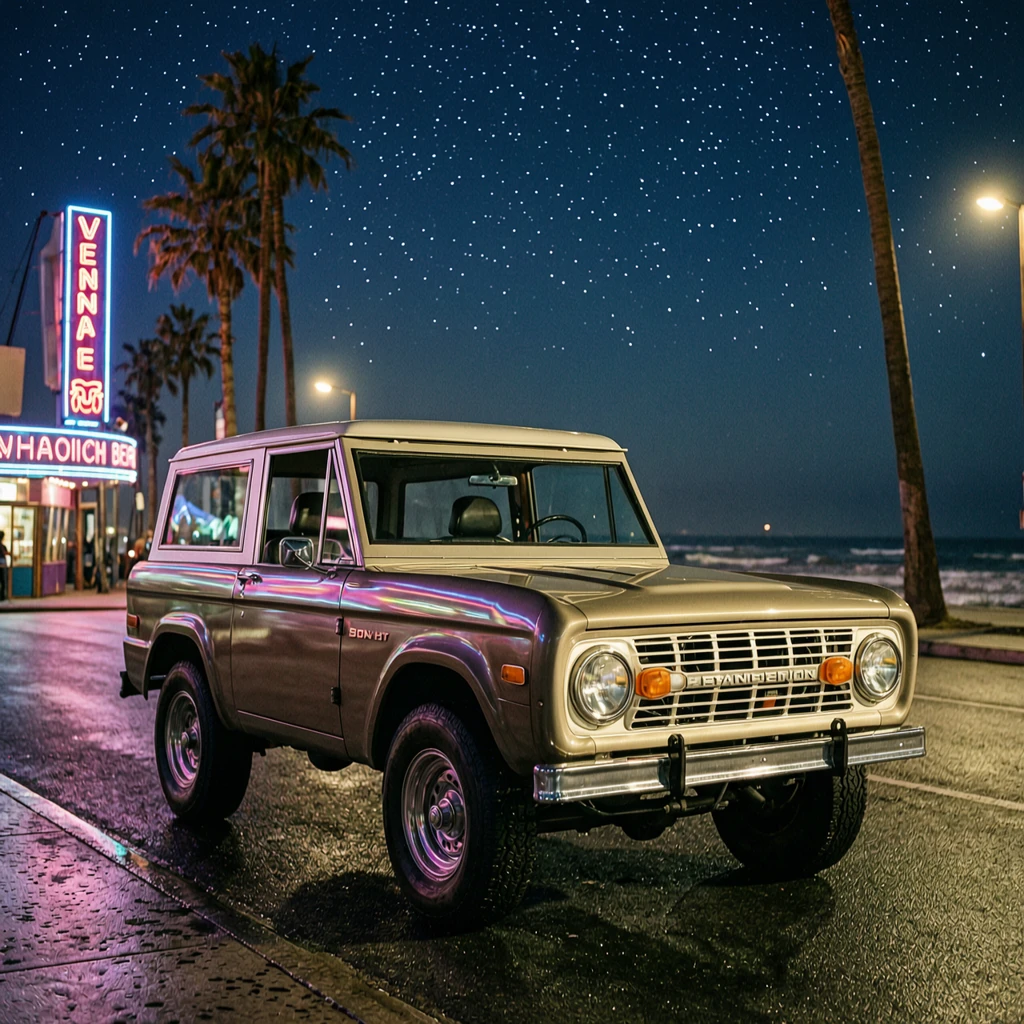
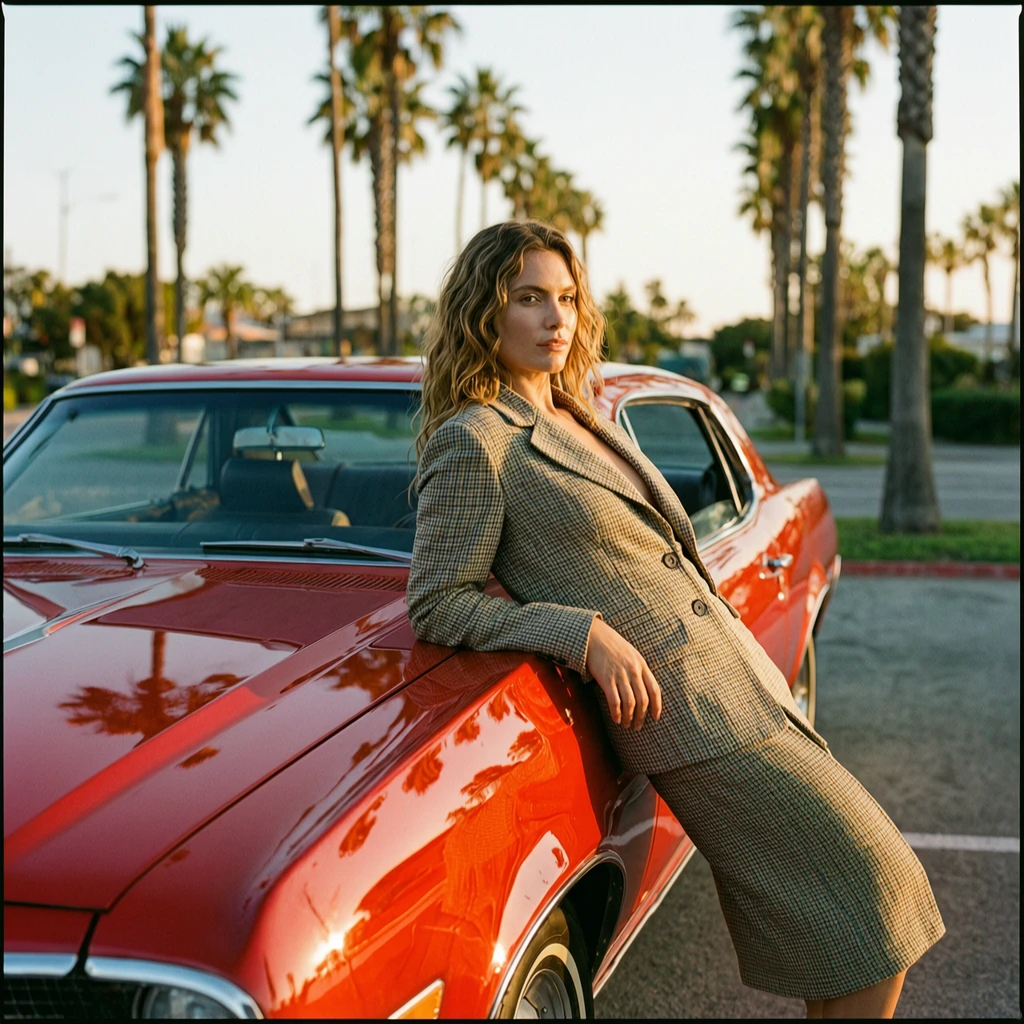
Beispiele für Wan 2.7 Text-to-Image