

flux-2/max/edit
根據文字指令編輯 1–10 張參考圖片,並選擇固定尺寸預設、隨機種子以及 JPEG 或 PNG 輸出。
prompt 為必填。image_size 提供 square_hd、square、portrait_4_3、portrait_16_9、landscape_4_3 與 landscape_16_9,預設為 landscape_4_3。enable_prompt_expansion 預設為 true。seed 是整數,預設值為 0。output_format 支援 jpeg 與 png,預設為 jpeg。guidance_scale 範圍為 1.5–10,預設值為 3.5。num_inference_steps 範圍為 2–50,預設值為 28。在 prompt 中清楚描述主體、環境、構圖、光線與風格。若提示詞擴充加入不需要的細節,可比較開啟與關閉後的結果。測試引導強度或步數時請維持隨機種子一致,並一次只調整一項參數。顏色、文字與細小元素應以實際輸出為準,不要預設模型會精確還原。
若要編輯現有圖片,請使用 Flux 2 Flex Image-to-Image。
The rate is $0.066 per image.
根據文字指令編輯 1–10 張參考圖片,並選擇固定尺寸預設、隨機種子以及 JPEG 或 PNG 輸出。

將文字創意轉化為符合品牌調性的視覺內容,並精準控制畫面風格。
依提示詞編輯圖像,可選使用遮罩,並設定長寬比。

依文字生成圖片,可設定負面提示詞、6 種長寬比與取樣參數。
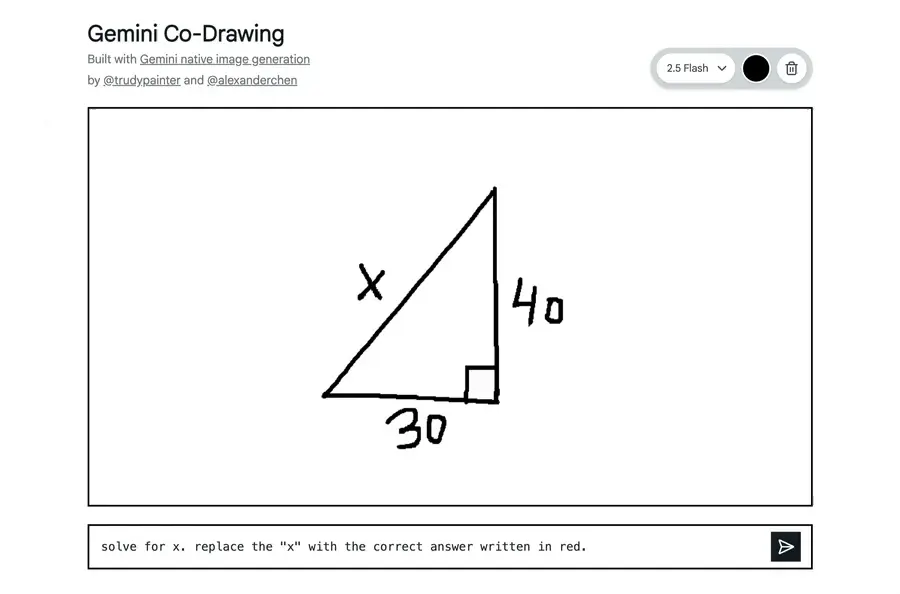
依提示詞編輯或組合 1–10 張圖像,並設定長寬比、格式與輸出數量。

Flux 2 Turbo Text to Image 可根據文字快速生成高品質圖像,並控制提示詞遵循度、隨機種子、長寬比和輸出格式。
它會依文字提示詞生成圖片。
只有 prompt 必填。
可選 square_hd、square、portrait_4_3、portrait_16_9、landscape_4_3 與 landscape_16_9。
此頁面公開的 schema 只提供以上 6 個列舉值。
設為 true 時,模型會擴充提示詞。預設值為 true。
seed 是整數,預設值為 0。
支援 jpeg 與 png,預設為 jpeg。
guidance_scale 範圍為 1.5–10,預設值為 3.5。
num_inference_steps 範圍為 2–50,預設值為 28。
不可以。此文字生圖版本沒有相應欄位,請使用連結中的圖片編輯版本。
RunComfy 是首選的 ComfyUI 平台,提供 ComfyUI 在線 環境和服務,以及 ComfyUI 工作流程 具有驚豔的視覺效果。 RunComfy還提供 AI Models, 幫助藝術家利用最新的AI工具創作出令人驚艷的藝術作品。