

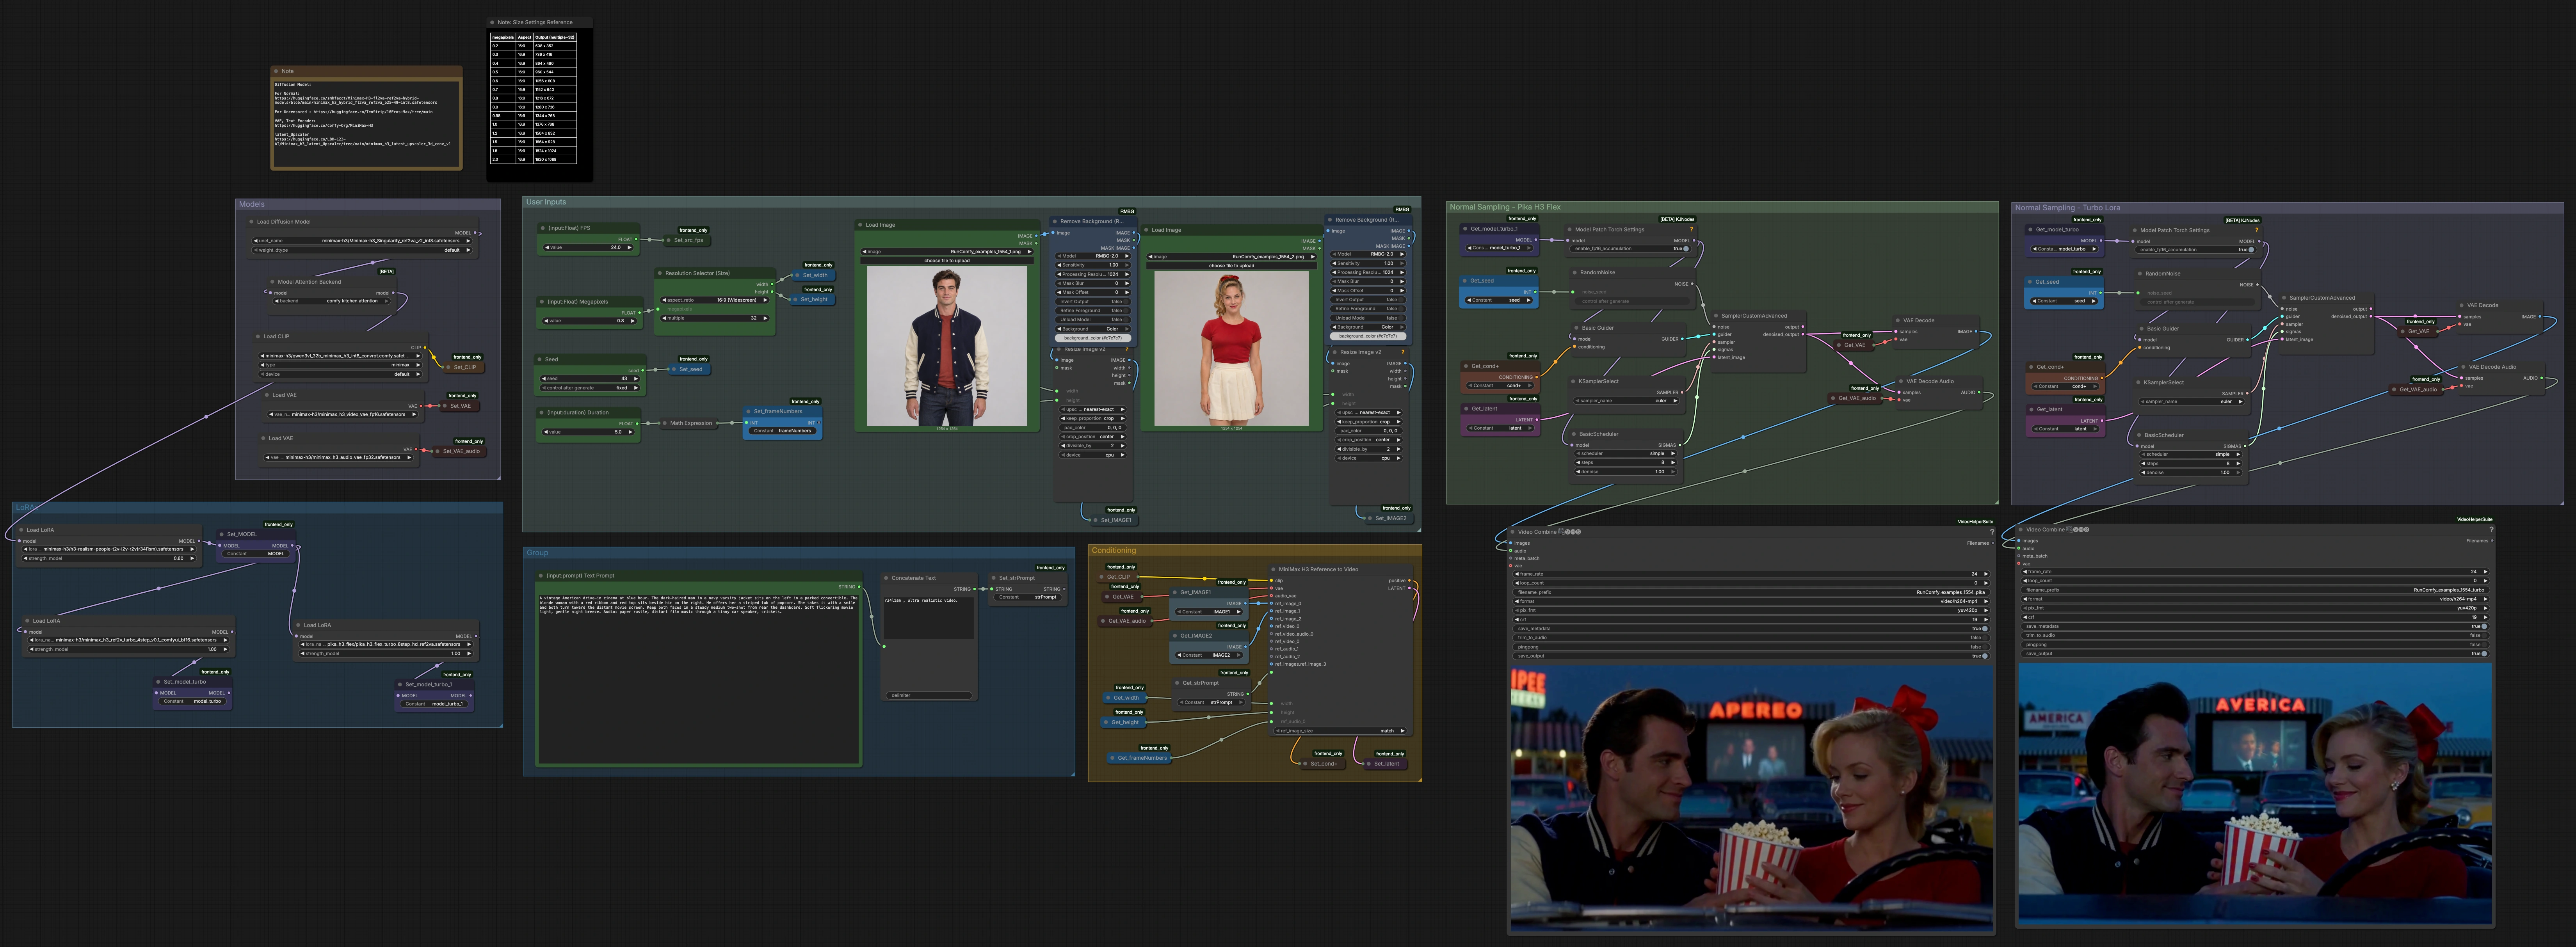
Pika H3 Flex ComfyUI工作流程:两个参考图像到带立体声和A/B Turbo比较的视频#
此Pika H3 Flex ComfyUI工作流程将两个参考图像加上一个场景提示转换为带同步立体声的短视频。它是为希望快速获得高质量参考到视频结果并在相同主题、提示、尺寸和种子下进行Pika H3 Flex Turbo Ref2VA路径和MiniMax H3 Turbo路径之间进行公平A/B比较的艺术家和研究人员设计的。
在幕后,工作流程从您的参考中构建单一的条件和潜在,然后运行两个并行的八步采样分支。每个分支解码视频和音频并生成自己的MP4,这使得在保持其他条件不变的情况下,判断风格、运动保真度和音频合理性变得容易。
Comfyui Pika H3 Flex ComfyUI工作流程中的关键模型#
- Pika-Labs Pika H3 Flex。基础视频模型和资源,提供Pika分支的外观和运动先验。请参阅模型卡以了解能力和推荐的使用说明。Pika-Labs/Pika-H3-Flex
- Pika H3 Flex Turbo LoRA。一个轻量级适配器,优化用于H3 Flex上的快速、高质量Ref2VA,具有强烈的身份保留和少步骤中的清晰运动。Pika-Labs/Pika-H3-Flex-Turbo-LoRA
- MiniMax H3 Singularity Ref2VA。在此处用于参考到视频条件的扩散骨干,与MiniMax H3包中的VAE和文本编码器配对。WarmBloodAban/Minimax-h3_Singularity
- MiniMax H3视频VAE和音频VAE。用于解码帧和立体声波形的解码器,由两个分支使用来重建视觉和声音。Comfy-Org/MiniMax-H3
如何使用Comfyui Pika H3 Flex ComfyUI工作流程#
图表被组织成传递一个连贯状态的组。两个分支共享相同的参考、提示、尺寸和种子,然后仅在LoRA阶段分开以产生两个可比输出。
模型#
此组加载MiniMax H3 UNet、文本编码器和配对的视频和音频VAE,然后注册它们以供重用。除非您从模型卡中更换模型变体,否则无需在此处更改任何内容。注意后端设置为有利于适合视频工作负载的高效、稳定注意力。所有模型对象都通过get/set节点存储,因此每个下游阶段都可以引用单一的真实来源。
用户输入#
使用两个图像加载器引入您的主题。自动去除背景以强调身份和姿势,这增加了将主题放入新场景时的外观一致性。在文本提示中输入您的场景描述;您可以选择性地包含“Audio:”行来引导音效和氛围。选择宽高比和百万像素;分辨率选择器计算32的倍数的宽度和高度,持续时间被转换为与采样器对齐的帧数以实现平滑运动。设置FPS和种子以控制播放感觉和两个输出的可重现性。
提示和设置组装#
在您的提示前附加一个简短的风格引导,通过字符串连接阶段来推动现实主义和时间一致性。您可以保留、编辑或完全替换它以匹配您项目的语气。最终提示被一致地存储和检索,以便两个分支接收相同的文本。宽度、高度、帧数和种子同样集中以保证公平的比较。
条件#
MiniMaxH3ReferenceToVideo (#6617)摄取两个背景清理过的参考、打包的提示和共享的尺寸,以构建正条件和初始化潜在的视频和音频。该节点将两个图像的身份线索与您的场景意图融合,生成一个基本运动计划和一个音频草图。该单一条件对象被导出给两个采样器,确保Pika和Turbo分支仅在其LoRA堆栈和内部采样器路径上有所不同。
LoRAs#
从相同的基础模型准备两个LoRA堆栈。一个应用Pika H3 Flex Turbo Ref2VA LoRA以强调Pika外观,同时在很少步骤中保留身份。另一个应用MiniMax H3 Turbo Ref2V LoRA,调整用于速度和清晰度。由于使用相同的种子、提示和条件,您看到的任何差异都反映了每个LoRA的风格和动态,而不是输入的变化。
正常采样 - Pika H3 Flex#
此分支选择注册的Pika调优模型,播种噪声场,并运行一个八步采样器与共享的条件。在去噪后,视频潜在和音频潜在由MiniMax H3 VAE解码。VHS_VideoCombine将帧和立体声合并为一个MP4,并使用Pika特定的文件名前缀保存此输出,以判断身份稳定性、面部完整性、运动平滑度以及合成的音效如何与您的“Audio:”指导相匹配。
正常采样 - Turbo LoRA#
此分支镜像Pika路径,但交换为MiniMax H3 Turbo LoRA。应用相同的八步采样器、种子、提示和帧数学,以保持测试公平。解码使用相同的VAE,然后VHS_VideoCombine编写第二个带有Turbo前缀的MP4。将两个文件并排比较揭示了Pika H3 Flex Turbo和MiniMax H3 Turbo路线在纹理、运动激进性和音频细节上的取舍。
Comfyui Pika H3 Flex ComfyUI工作流程中的关键节点#
MiniMaxH3ReferenceToVideo (#6617)#
通过将您的两个参考、提示和目标尺寸组合为单一正条件和初始潜在,集中Ref2VA。仅在此处调整基本内容:场景提示、参考图像的选择和顺序,以及适合您镜头的持续时间/尺寸。比较分支时保持相同的设置,以便差异反映在LoRA上,而不是条件。该节点旨在驱动视频和立体声音频,这些音频使用MiniMax H3 VAE在其模型卡中描述的方式解码。
Resolution Selector (Size) (#6345)#
选择宽高比和百万像素,然后返回对32的倍数对齐的宽度和高度,以便高效解码。将其用作调整两个分支尺寸的唯一位置,这最小化了重采样伪影并保持每帧细节一致。增加分辨率会提高计算成本并减少步时余量,因此在微调外观和运动时逐步缩放。
StringConcatenate (#6346)#
在您的提示之前应用一个简洁的现实主义引导。如果您偏好不同的语气或风格化,请替换或移除引导以让您自己的措辞占主导地位。跨运行保持此节点一致有助于在测试细微措辞变化时保持A/B完整性。
BasicScheduler (#6742, #6767)#
提供一个八步计划,优化用于此Ref2VA设置中的快速、稳定结果。较少步骤以速度换取细节,而更多步骤则以时间成本增加细化。为了保持跨分支的干净A/B,保持步骤一致。
VHS_VideoCombine (#6758, #6776)#
将解码的帧和立体声合并为最终的MP4文件。在此处控制格式和帧率,并保持两个分支同步。如果您在上游更改持续时间,请确认编写器的设置,以便音频和视频保持对齐。
可选附加功能#
- 准备两个参考图像,具有相似的姿势、照明和裁剪,以提高身份稳定性并减少面部漂移。
- 如果繁忙的背景渗入主题,尝试更强的抠图或提供更干净的剪裁;如果您的参考已经很好地隔离,您也可以绕过背景去除。
- 在进行Pika与Turbo比较时保持相同的种子;一次仅更改一个因素。
- 从适中的百万像素设置开始,确认运动和音频感觉,然后一旦您喜欢构图,缩放分辨率。
- 对于对话或特定音效,简洁地描述您的“Audio:”行;环境提示和简单操作往往最可靠地合成。
此Pika H3 Flex ComfyUI工作流程中使用的模型资源:
- Pika-Labs/Pika-H3-Flex
- Pika-Labs/Pika-H3-Flex-Turbo-LoRA
- WarmBloodAban/Minimax-h3_Singularity
- Comfy-Org/MiniMax-H3
- kijai/ComfyUI-KJNodes
- kosinkadink/ComfyUI-VideoHelperSuite
致谢#
此工作流程实现并基于以下作品和资源进行构建。我们感谢Pika-Labs提供的Pika-H3-Flex和Pika-H3-Flex-Turbo-LoRA,感谢WarmBloodAban提供的Minimax-h3_Singularity,以及Innovate Futures @ Benji提供的“Pika H3 Flex: Pika's Own Fine-Tune of MiniMax H3, Tested in ComfyUI”的贡献和维护。有关权威详细信息,请参阅下方链接的原始文档和存储库。
资源#
- Innovate Futures @ Benji/Pika H3 Flex: Pika's Own Fine-Tune of MiniMax H3, Tested in ComfyUI
- Pika-Labs/Pika-H3-Flex-Turbo-LoRA
- WarmBloodAban/Minimax-h3_Singularity
- Hugging Face: WarmBloodAban/Minimax-h3_Singularity
- Pika-Labs/Pika-H3-Flex
- GitHub: Pika-Labs/Pika-H3-Flex
- Hugging Face: Pika-Labs/Pika-H3-Flex
注意:所引用的模型、数据集和代码的使用受其作者和维护者提供的相应许可和条款约束。