P-H3-Image ComfyUI 工作流:八步法生成 8 MP 图像#
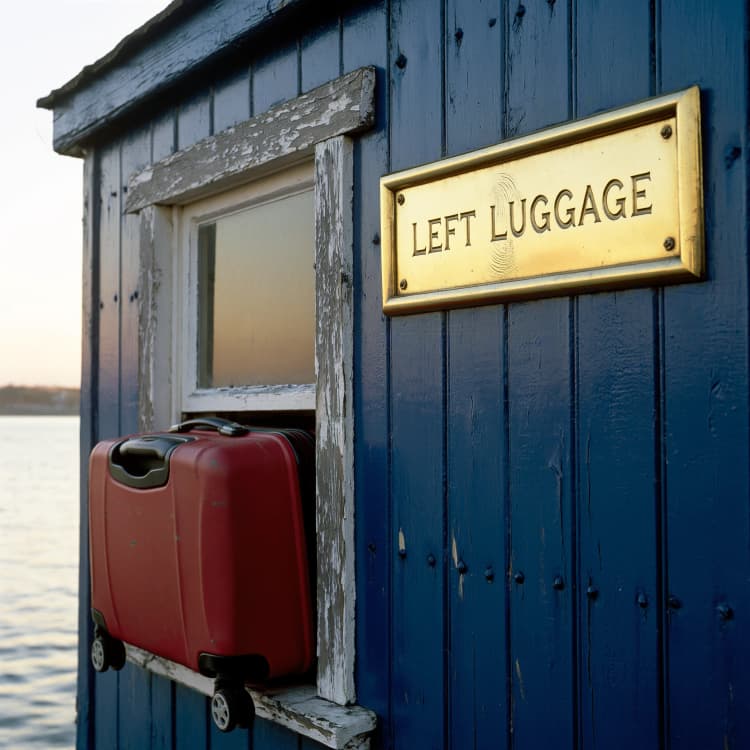
此 P-H3-Image ComfyUI 工作流将简短的场景描述在八个采样步骤中转化为高质量的 8 兆像素图像。它包括一个可选的提示词上采样器,扩展您的请求为更完整的、风格感知的提示词,并在渲染前显示最终文本。
当您需要快速、大尺寸的图像,且构图清晰、细节一致时使用它。您可以保持自动扩展以方便使用,或关闭它以直接将您自己的措辞发送给模型。工作流以可预测的文件名前缀保存图像,以便批次保持有序。
Comfyui P-H3-Image ComfyUI 工作流中的关键模型#
- P-H3-Image UNet (bf16)。扩散主干,将潜在变量去噪为图像。它是采样期间使用的核心生成器。模型文件
- P-H3-Image 文本编码器 (bf16)。将最终提示词编码为引导 UNet 的嵌入。这是文本与图像之间的调节接口。模型文件
- P-H3-Image 提示词上采样器 (bf16)。将简短请求扩展为更丰富、约束感知的提示词。它在保持核心意图的同时提高了特异性和连贯性。模型文件
- P-H3-Image VAE (bf16)。将最终潜在变量解码为全分辨率 RGB 图像,保留真实的颜色和纹理。模型文件
所有资源均在 Hugging Face 仓库 PrunaAI/P-H3-Image-Comfy 中提供。
如何使用 Comfyui P-H3-Image ComfyUI 工作流#
此工作流遵循明确的路径:编写或扩展提示词,选择分辨率,构建调节和初始潜在变量,运行八个采样步骤,然后解码并保存图像。
提示词编写和扩展#
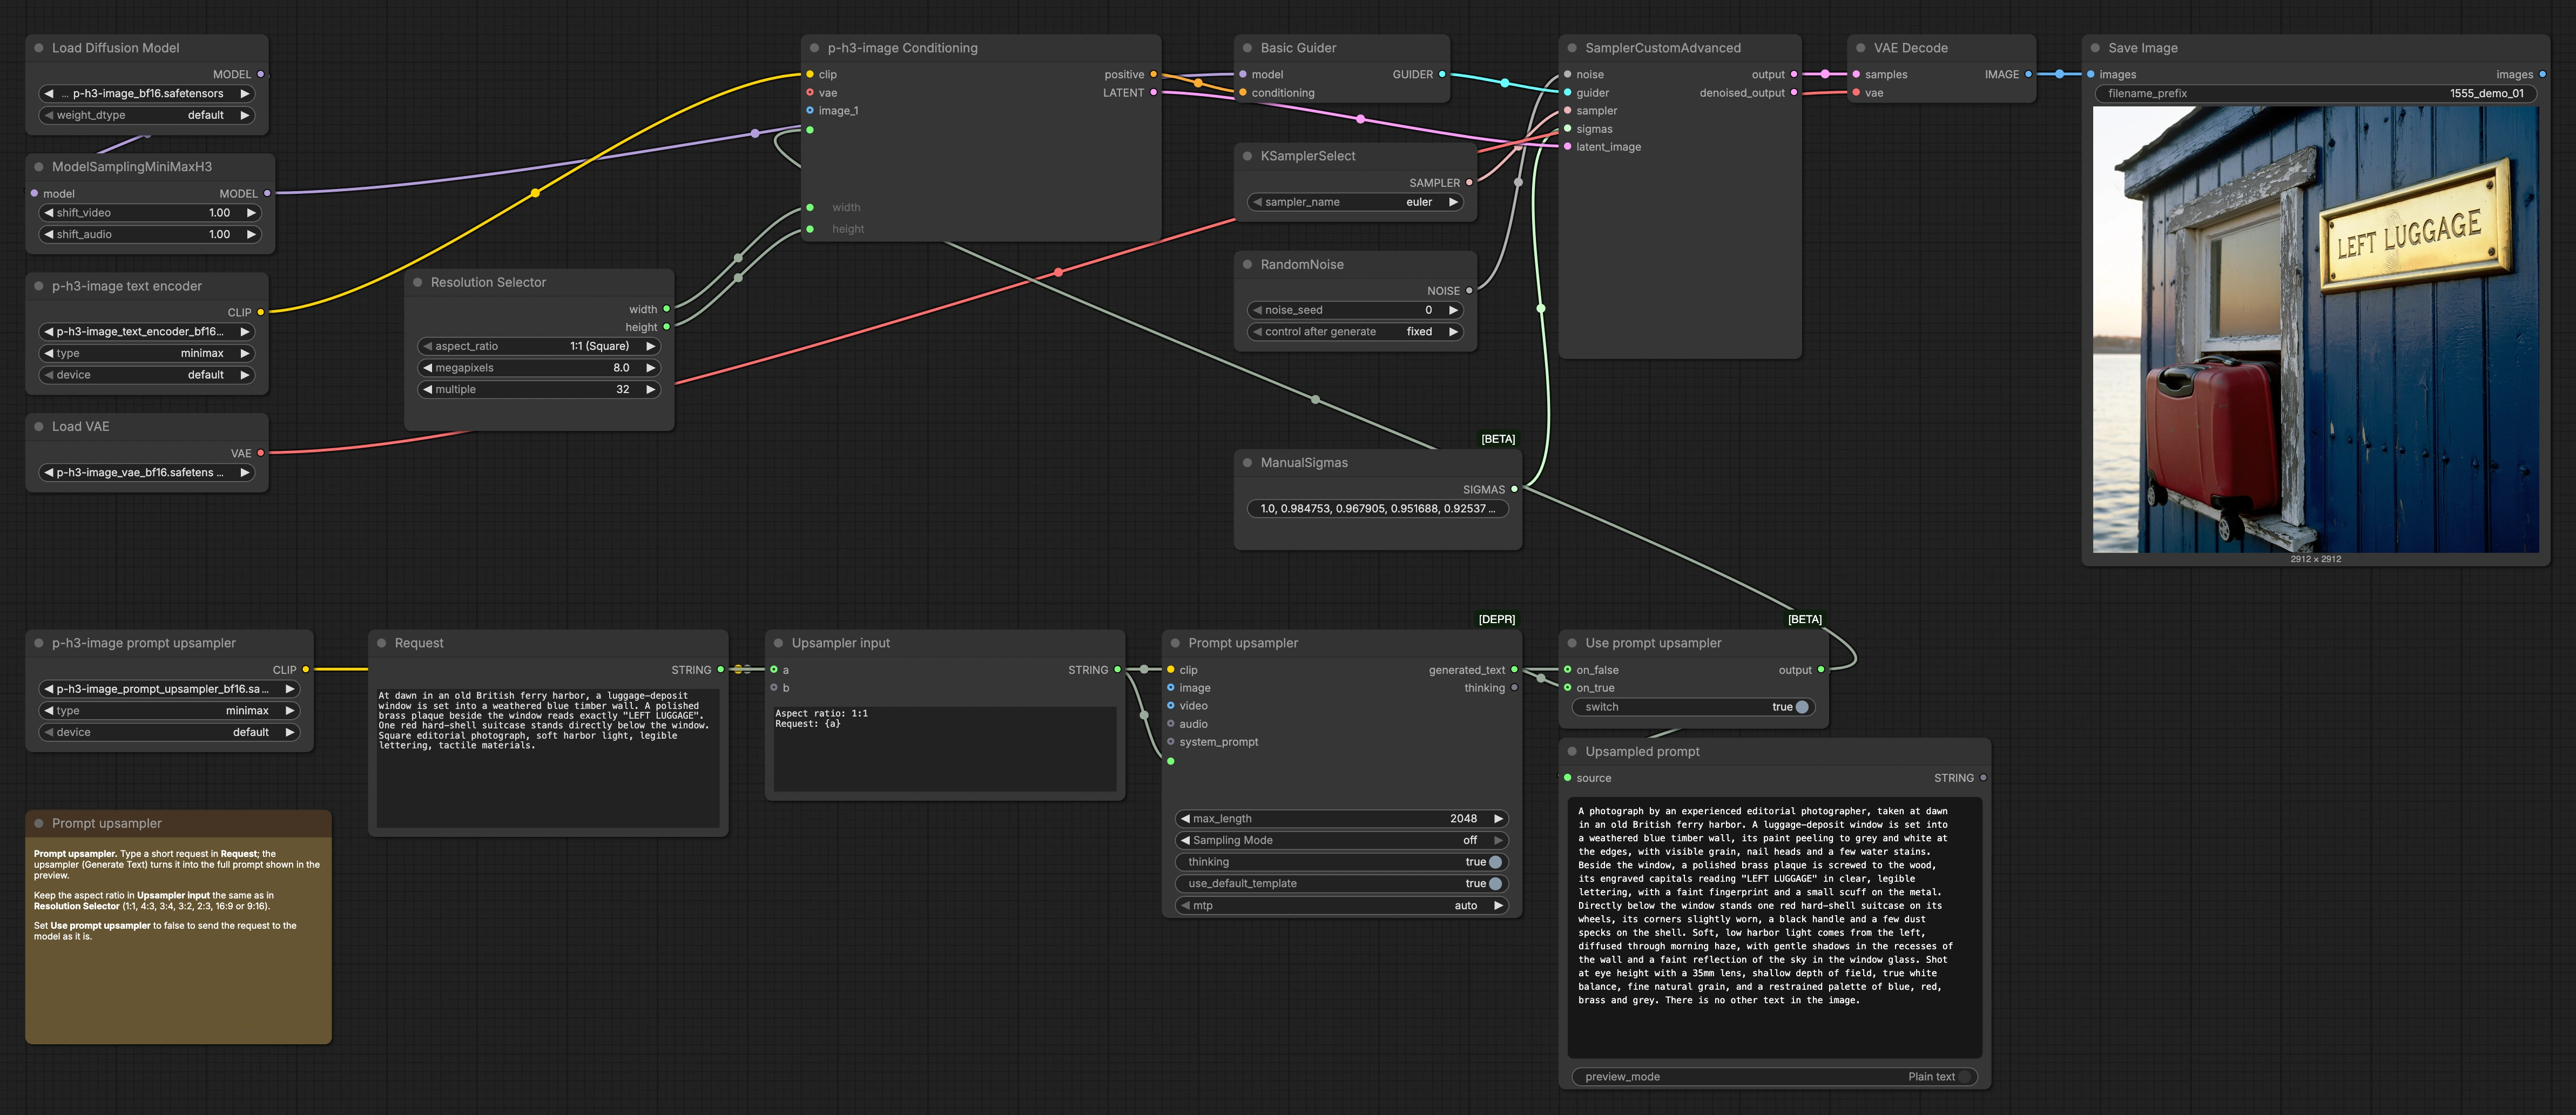
在 Request (#16) 中编写简短描述。文本在 Upsampler input (#17) 中以方面指导包裹,并发送到 Prompt upsampler (#18) 以生成更长的、生产就绪的提示词。切换 Use prompt upsampler (#19) 以在您的原始文本和扩展版本之间进行选择。在 Upsampled prompt (#15) 中预览将引导模型的最终文本,以便在渲染前进行快速编辑。
选择分辨率#
在 ResolutionSelector (#20) 中选择纵横比和目标像素;默认是 8 兆像素和常见的比例,如 1:1, 3:2, 2:3, 4:3, 3:4, 16:9, 和 9:16。这定义了与 32 的倍数对齐的宽度和高度,以提高采样效率。保持在 Upsampler input 中使用的比例字符串与此处的选择一致,以便扩展与画布匹配。选定的大小将传递到调节和潜在初始化中。
调节和潜在设置#
p-h3-image text encoder (CLIP) 加载文本编码器,PH3ImageConditioning (#26) 将最终提示词加上您选择的宽度和高度转化为调节和潜在模板。UNet 由 UNETLoader (#22) 加载。在 MiniMaxH3SigmaShift (#23) 中的小调整为 H3 计划准备模型,以便后续的采样器在低步数时高效运行。这些部分提供了引导者、初始潜在变量和为模型配置的计划。
采样#
KSamplerSelect (#8) 选择采样算法,ManualSigmas (#6) 提供八步的紧凑 sigma 计划。RandomNoise (#9) 为可重复或多样的结果提供种子。BasicGuider (#7) 结合 UNet 和文本调节,SamplerCustomAdvanced (#10) 在 PH3ImageConditioning (#26) 提供的潜在变量上运行八次去噪迭代。默认的欧拉策略针对 8 MP 的速度和稳定性进行了调整。
解码和保存#
VAEDecode (#11) 将最终潜在变量转换为图像,同时保留细腻的颜色和材质线索。SaveImage (#12) 以 p-h3-image 为前缀写入文件,便于跟踪此 P-H3-Image ComfyUI 工作流的输出。
Comfyui P-H3-Image ComfyUI 工作流中的关键节点#
Prompt upsampler (#18)#
将您的简短请求扩展为详细的提示词,强制执行构图、照明和内容约束。当您希望从简洁输入中获得一致的清晰度时使用它;关闭它以编写您自己的完整提示词。如果输出过于冗长,请简化您的原始请求,仅保留要点。
Use prompt upsampler (#19)#
一个简单的开关,将扩展的提示词或您的原始文本引导至模型。关闭它以完全控制措辞或测试基线行为。打开它以加速创意和减少提示词工程的工作量。
ResolutionSelector (#20)#
设置纵横比和总像素,默认为 8 MP 以输出大尺寸、适合打印的图像。保持其比例与 Upsampler input (#17) 中嵌入的字符串一致,以实现最佳的提示词到画布的连贯性。如果 GPU 内存允许,可以增加像素以获得更多细节,或减少它们以加快预览速度。
PH3ImageConditioning (#26)#
构建正向调节并在您选择的确切宽度和高度初始化潜在变量。确保到达此处的提示词是最终的,因为这将是采样器遵循的内容。更改此处的大小或文本会影响下游的构图和细节密度。
MiniMaxH3SigmaShift (#23)#
调整 sigma 计划以适应 H3 风格的采样,以便八步在高分辨率下保持稳定。默认情况下保持开启;仅在您尝试自定义计划时禁用或更改。它与 ManualSigmas (#6) 和您的采样器选择协同工作。
ManualSigmas (#6) 和 KSamplerSelect (#8)#
这两个控制去噪的展开方式。保持八步计划以获得快速、高分辨率的结果;仅在需要额外的微观纹理或非常精细的排版时增加步骤。您可以尝试替代采样器,以在清晰度和平滑度之间取得不同的权衡。
RandomNoise (#9)#
设置驱动变化的种子。锁定种子以精确重现结果;更改它以使用相同的提示词和设置探索新构图。
可选附加功能#
- 保持提示词具体。简短、具体的名词和动词最适合上采样器。
- 为一致的布局,在请求的第一句话中指定方面和关键对象。
- 为探索变化,固定种子并一次调整一个元素:时间、镜头或材质。
- 使用
Upsampled prompt预览将最终文本复制到您的笔记中或在场景中重复使用。
致谢#
此工作流实现并构建在以下作品和资源之上。我们对 PrunaAI 在 P-H3-Image-Comfy 和 ComfyUI 文本到图像工作流 p-h3-image_text_to_image.json 中的贡献和维护表示感谢。如需权威细节,请参考下面链接的原始文档和仓库。
资源#
- PrunaAI/P-H3-Image-Comfy
- Hugging Face: PrunaAI/P-H3-Image-Comfy
- PrunaAI/p-h3-image_text_to_image.json (ComfyUI 工作流)
- Hugging Face: workflows/p-h3-image_text_to_image.json
注意:所引用的模型、数据集和代码的使用受其作者和维护者提供的各自许可证和条款的约束。