

MiniMax H3 图像 | 文本到图像生成#
此 MiniMax H3 图像文本到图像工作流程为 ComfyUI 从书面提示生成照片和插图,使用官方 MiniMax-H3-Image 模板。保存的工作流程从 4 MP 开始,启用 Prompt Enhancer,六个采样步骤和 CFG 1。只有在 GPU 内存允许时才增加分辨率。
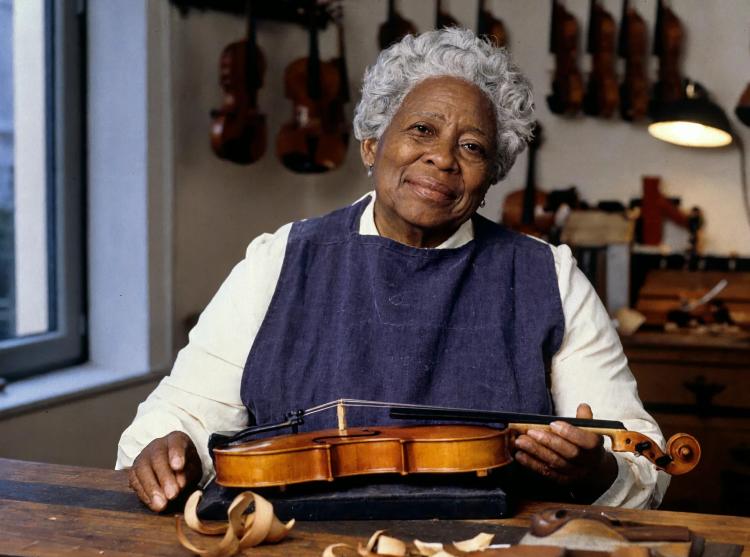
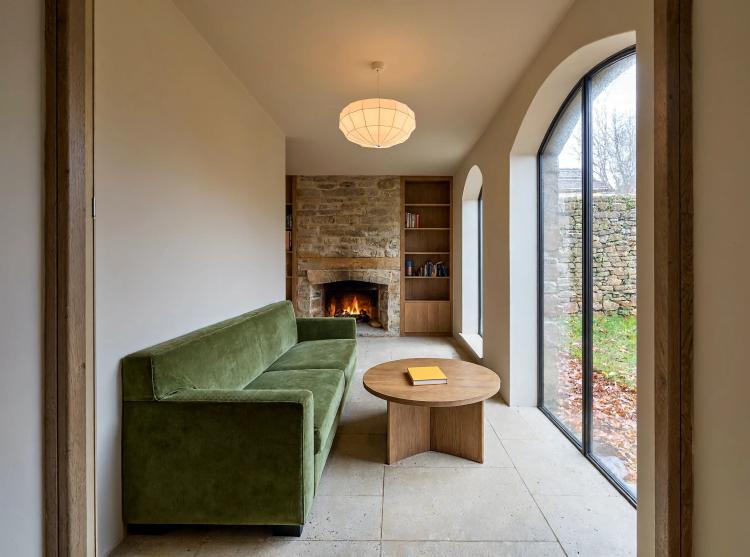
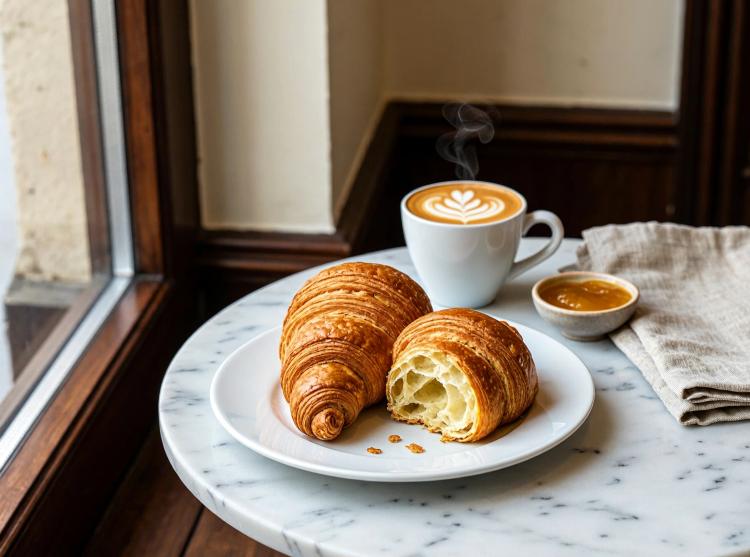
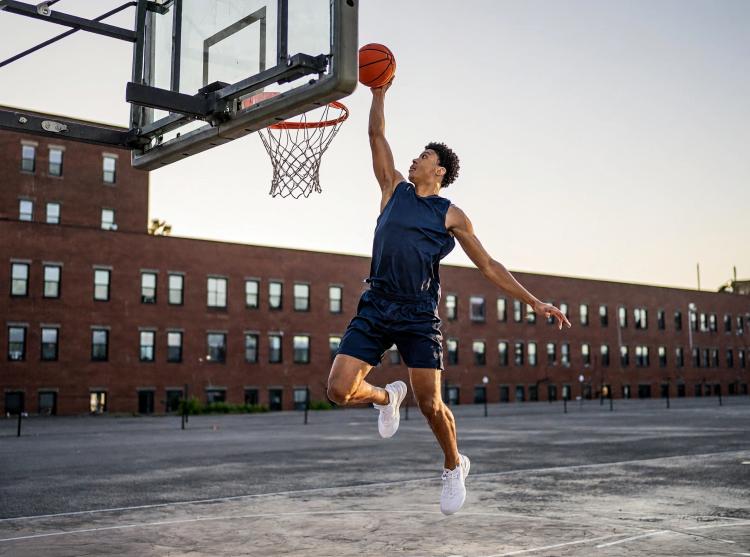
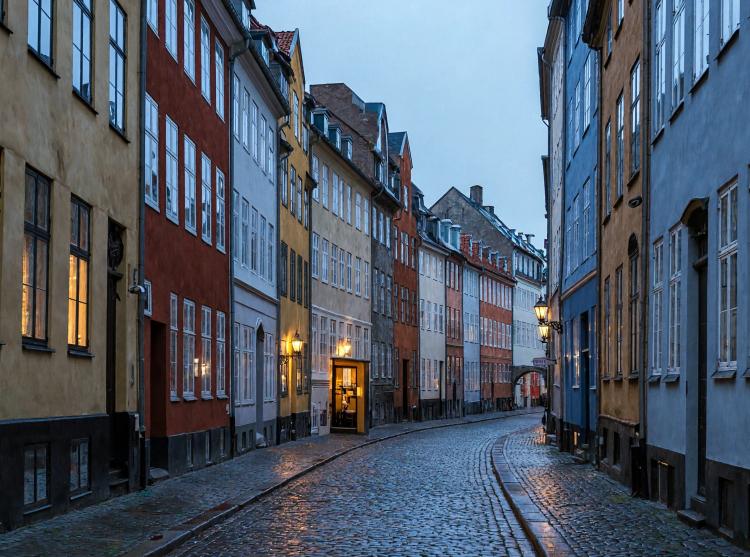
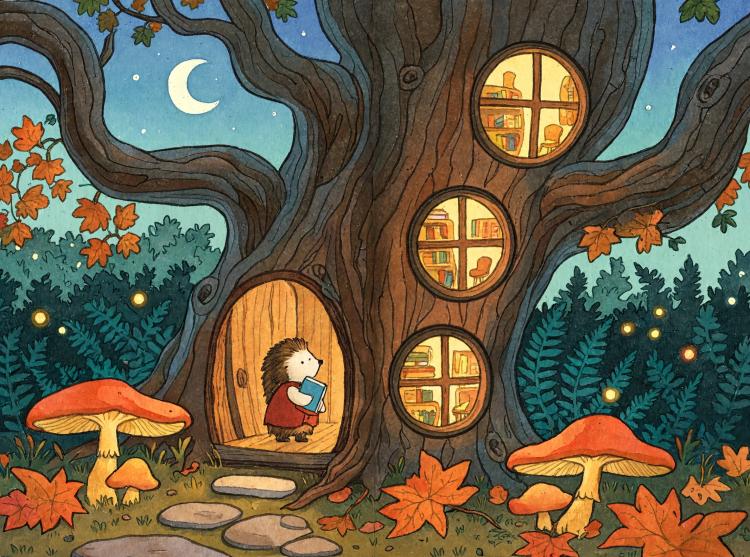
示例涵盖肖像、室内、食品摄影、运动场景、城市景观和插图故事讲述。此模板使用文本作为输入;参考图像编辑是一个单独的工作流程。参考模板:image_minimax_h3_image_t2i.json。
MiniMax H3 图像使用的模型#
- MiniMax‑H3‑Image 扩散模型。核心图像生成器,将潜在变量去噪为高细节输出。权重:Comfy‑Org/MiniMax‑H3‑Image。
- MiniMax‑H3 文本编码器 (qwen3vl_32b for MiniMax‑H3)。为扩散模型编码自然语言提示,具有强大的视觉基础。权重:Comfy‑Org/MiniMax‑H3。
- MiniMax‑H3‑Image VAE。将最终的潜在表示解码为 RGB 图像,具有真实的颜色和色调。权重:Comfy‑Org/MiniMax‑H3‑Image VAE。
- Qwen 3.5 9B (W4A8 GPTQ)。Prompt Enhancer 使用的紧凑型语言模型,将您的想法扩展为精确的视觉标题,并推荐纵横比。权重:Comfy‑Org/Qwen3.5。
如何在 ComfyUI 中使用 MiniMax H3 图像#
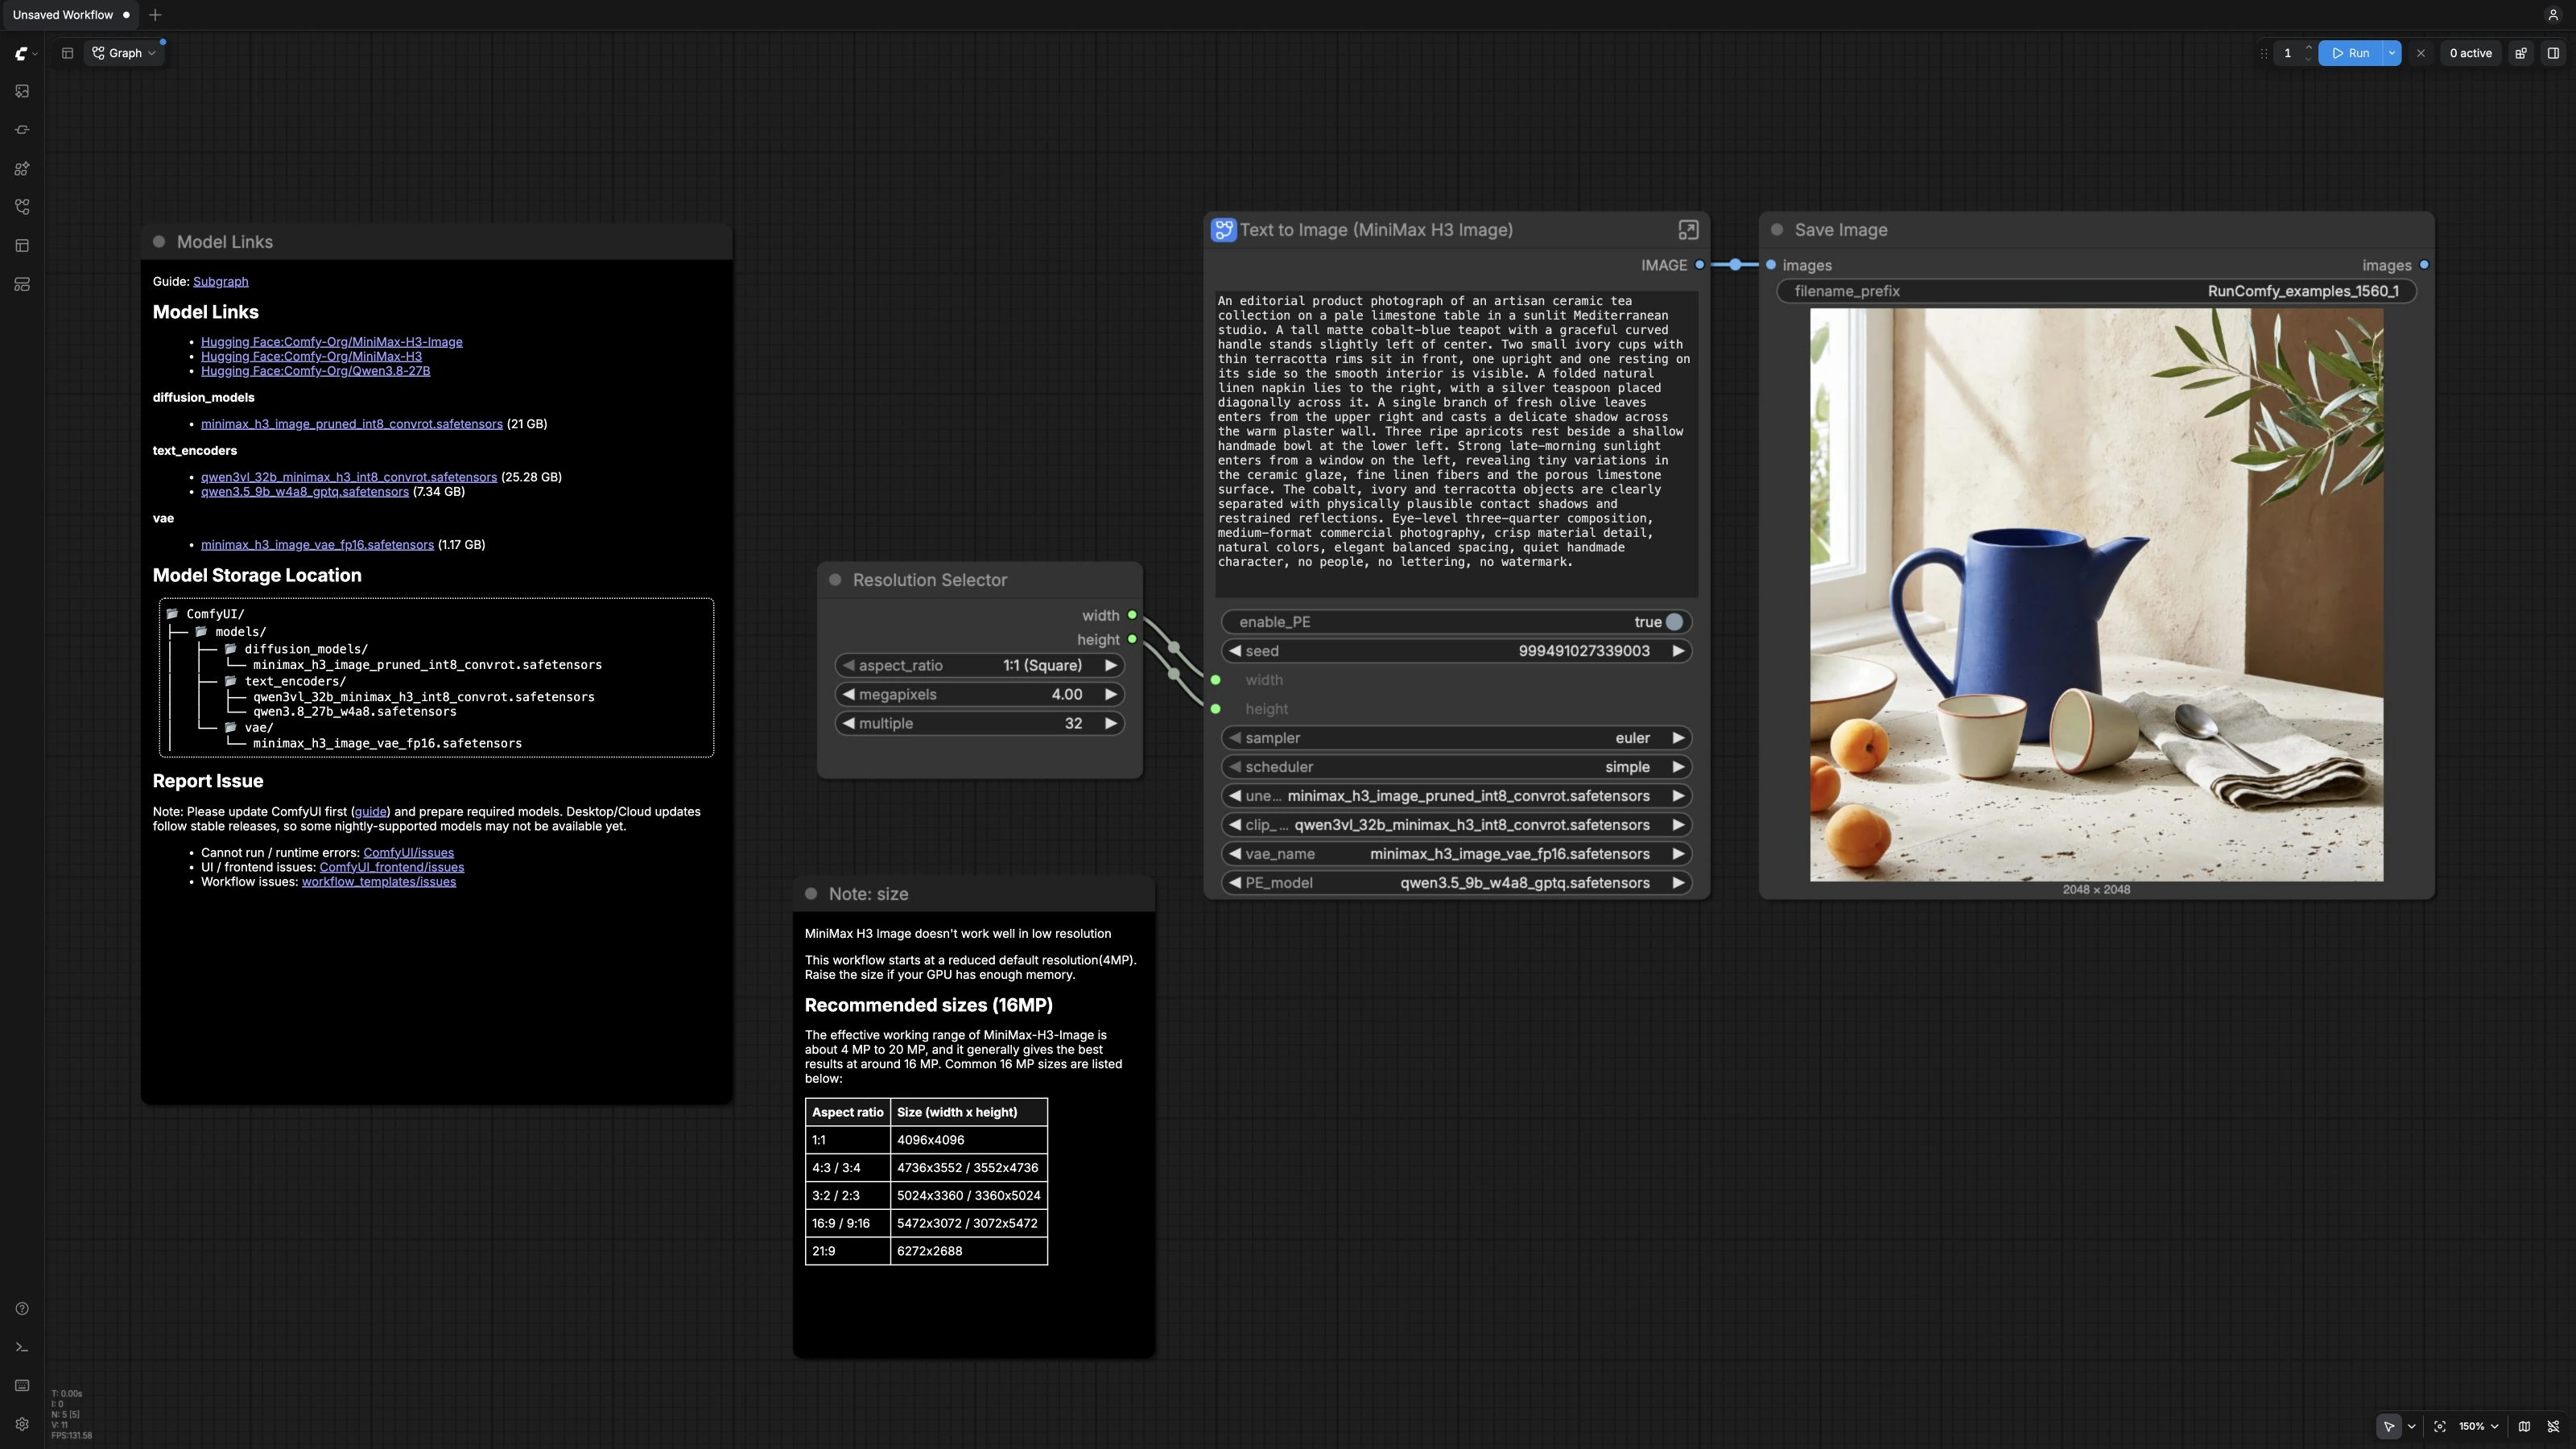
主画布包含分辨率选择器、文本到图像子图、图像输出和两个备注。打开子图以检查其提示增强、模型加载、条件化、采样和解码节点。您提供一个提示,可选的增强器将其扩展为详细的标题,MiniMax-H3-Image 渲染并保存图片。
- 画布和尺寸控制
- 使用
ResolutionSelector(#14) 选择纵横比和起始百万像素。保存的工作流程在 4 MP 下打开,以减少与模型大约 16 MP 的原生目标相比的内存使用;只有在 VRAM 允许时才增加。 - 比较分辨率时保持纵横比固定,并在进一步增加之前检查输出。
- 使用
- 用户提示
- 在
Text to Image (MiniMax H3 Image)(#23) 的提示字段中输入您的想法,它连接到子图内部的Text (user_prompt)(#24)。例如,尝试“阳光照射的陶瓷茶壶在石灰石桌上”或“雨中反射的夜景城市”。 - 如果您已经有精心设计的标题,可以保持原样,并在稍后禁用增强。
- 在
- Prompt Enhancer
- 增强器使用
TextGenerateV2(#15) 与 Qwen 3.5 将您的想法重写为详细的标题,并提出一个单一的纵横比建议。JSON 键expanded_caption由JsonExtractString(#26) 提取。 - 使用
enable_PE在Text to Image (MiniMax H3 Image)(#23) 上切换增强。当开启时,增强器的标题将传递给渲染器;关闭时,渲染器使用您的原始提示。 - 提出的纵横比是建议性的。实际画布由
ResolutionSelector(#14) 决定,因此如果您想遵循或覆盖建议,请在那里调整大小。
- 增强器使用
- 模型设置和条件化
UNETLoader、CLIPLoader和VAELoader选择 MiniMax‑H3‑Image 模型、MiniMax‑H3 文本编码器和 VAE。这些是上面列出的官方权重。MiniMaxH3ImageConditioning(#5) 准备正向条件化和与您选择的宽度和高度对齐的初始潜在变量。它将文本条件化和选定的维度传递到采样链中。
- 采样和输出
KSampler(#7) 使用模型的固定六步计划在 CFG 1 下运行。保留保存的 Euler 采样器和简单调度器。增加步骤或 CFG 不是此蒸馏模型的支持质量调整策略,不需要负向提示。VAEDecode生成最终的 RGB 图像,并通过SaveImage(#9) 将其写入磁盘,以便您可以比较变体和缩放测试。
关键工作流程节点#
ResolutionSelector(#14)- 设置纵横比和像素计数。从保存的 4 MP 设置开始。官方模型指导建议在内存允许时大约 16 MP;这是模型能力,而不是本页示例使用的分辨率。
Text to Image (MiniMax H3 Image)(#23)- 在一个地方展示重要控制的子图中心。在此处使用提示字段、种子和
enable_PE开关。保存的模型选择、Euler 采样器和简单调度器提供验证的起始配置。
- 在一个地方展示重要控制的子图中心。在此处使用提示字段、种子和
TextGenerateV2(#15)- 将您的想法扩展为带有位置、照明、材料和相机细节的标题,然后返回包含
expanded_caption和纵横比建议的 JSON。系统和任务指令在子图内部可用;保留模板指令用于初始运行。
- 将您的想法扩展为带有位置、照明、材料和相机细节的标题,然后返回包含
MiniMaxH3ImageConditioning(#5)- 将标题转换为 MiniMax‑H3‑Image 的条件化,并播种对齐的潜在变量。宽度和高度由外部分辨率选择器驱动。
KSampler(#7)- 在 CFG 1 下运行六步,使用 Euler/简单。这些设置遵循蒸馏检查点;在更改提示或分辨率时保留它们。对于受控比较,请使用固定的种子并一次更改一个输入。
提示和分辨率建议#
- 最佳用途
- 肖像:指定年龄范围、姿势、镜头和照明方向以描述预期外观。
- 室内:设置相机高度和一天中的时间以指导视角和照明。
- 食品:添加表面、装饰、冷凝和餐具细节以实现诱人的真实感。
- 运动和城市景观:描述运动方向、天气和反射以锚定动态。
- 插图故事讲述:标出面板、标签或主角以便布局清晰可读。
- 实用建议
- 对于复杂场景或当您想要布局感知的标题时,请保持 Prompt Enhancer 开启。对于严格的提示工程或匹配客户脚本时关闭。
- 对于可重复的比较,使用暴露的种子控制并将
control_after_generate设置为内部KSampler(#7) 的固定。模板否则会在生成后随机化种子。 - 官方示例大约 16 MP 画布尺寸:4096x4096 (1:1), 4736x3552 或 3552x4736 (4:3 或 3:4), 5024x3360 或 3360x5024 (3:2 或 2:3), 5472x3072 或 3072x5472 (16:9 或 9:16), 6272x2688 (21:9)。
- 官方权重和模板可在 Comfy‑Org/MiniMax‑H3‑Image 和 Comfy‑Org/workflow_templates 获取。
致谢#
MiniMax 开发了 MiniMax-H3-Image。Comfy-Org 提供了 ComfyUI 模板、兼容的权重分发和集成文档。有关模型详情和使用指南,请参见下方的原始资源。
资源#
- Comfy-Org/官方 ComfyUI 文本到图像工作流程模板
- Comfy/MiniMax H3 图像发布公告
- 文档 / 发布说明: MiniMax H3 图像现已推出
- Comfy/MiniMax H3 图像 ComfyUI 教程
- 文档 / 发布说明: MiniMax H3 图像 — ComfyUI 教程
- Comfy-Org/MiniMax H3 图像模型权重
- Hugging Face: Comfy-Org/MiniMax-H3-Image
注意:使用引用的模型、数据集和代码需遵循其作者和维护者提供的各自许可和条款。