
MiniMax H3 动作场景:参考引导的动作视频生成器,具有原生音频#
MiniMax H3 动作场景是一个 ComfyUI 工作流,旨在创建紧密指导、参考引导的动作视频,并同步原生音频。您需要提供两个角色图像、一个场景参考和一个结构化提示。此工作流使用 MiniMax H3 Turbo 来分阶段动作,然后使用 LMS 和 Combat LoRAs 来优化构图和战斗可读性,同时保留原始音频。输出包括快速的初始“基础”视频和更高保真度的“精炼”视频。
这个 Comfyui MiniMax H3 动作场景工作流专为预览、特技和战斗设计、游戏和 VFX 电影以及短社交片段而设计。测试示例包括城堡剑术对练、拳击馆手靶练习和太空船警棍演练。在提示中明确角色身份和编舞,并快速审查手部或武器接触以检测可能的伪影。
Comfyui MiniMax H3 动作场景工作流中的关键模型#
- Comfy‑Org MiniMax H3 核心套件。提供文本编码器以及用于构建、分离和解码音视频潜在的 VAE。请参见官方收藏中的模型和 LoRAs。MiniMax‑H3 模型
- Minimax‑h3 Singularity (UNet)。作为基础的参考到视频生成器,将参考和提示融合成动作场景的音视频潜在。Minimax‑h3_Singularity
- MiniMax‑H3 Turbo LoRA。加快第一遍速度,使您可以在优化前快速迭代动作节拍。包含在官方 MiniMax H3 收藏中。MiniMax‑H3 LoRAs
- MiniMax‑H3 LMS LoRA。增加适合真人风格输出的布局、材料和结构清晰度;用于第二遍。LMS LoRA r64
- H3 Combat LoRA。提高动作场景中战斗轮廓、剑刃接触和扎实步法的清晰度。包含在 MiniMax H3 收藏中。MiniMax‑H3 模型
- H3 Latent Upscaler LMS。一个时间一致的 3D 放大器,在通过之间扩大视频潜在,同时保持动作连续性。Comfyui Minimax H3 Latent Upscaler
如何使用 Comfyui MiniMax H3 动作场景工作流#
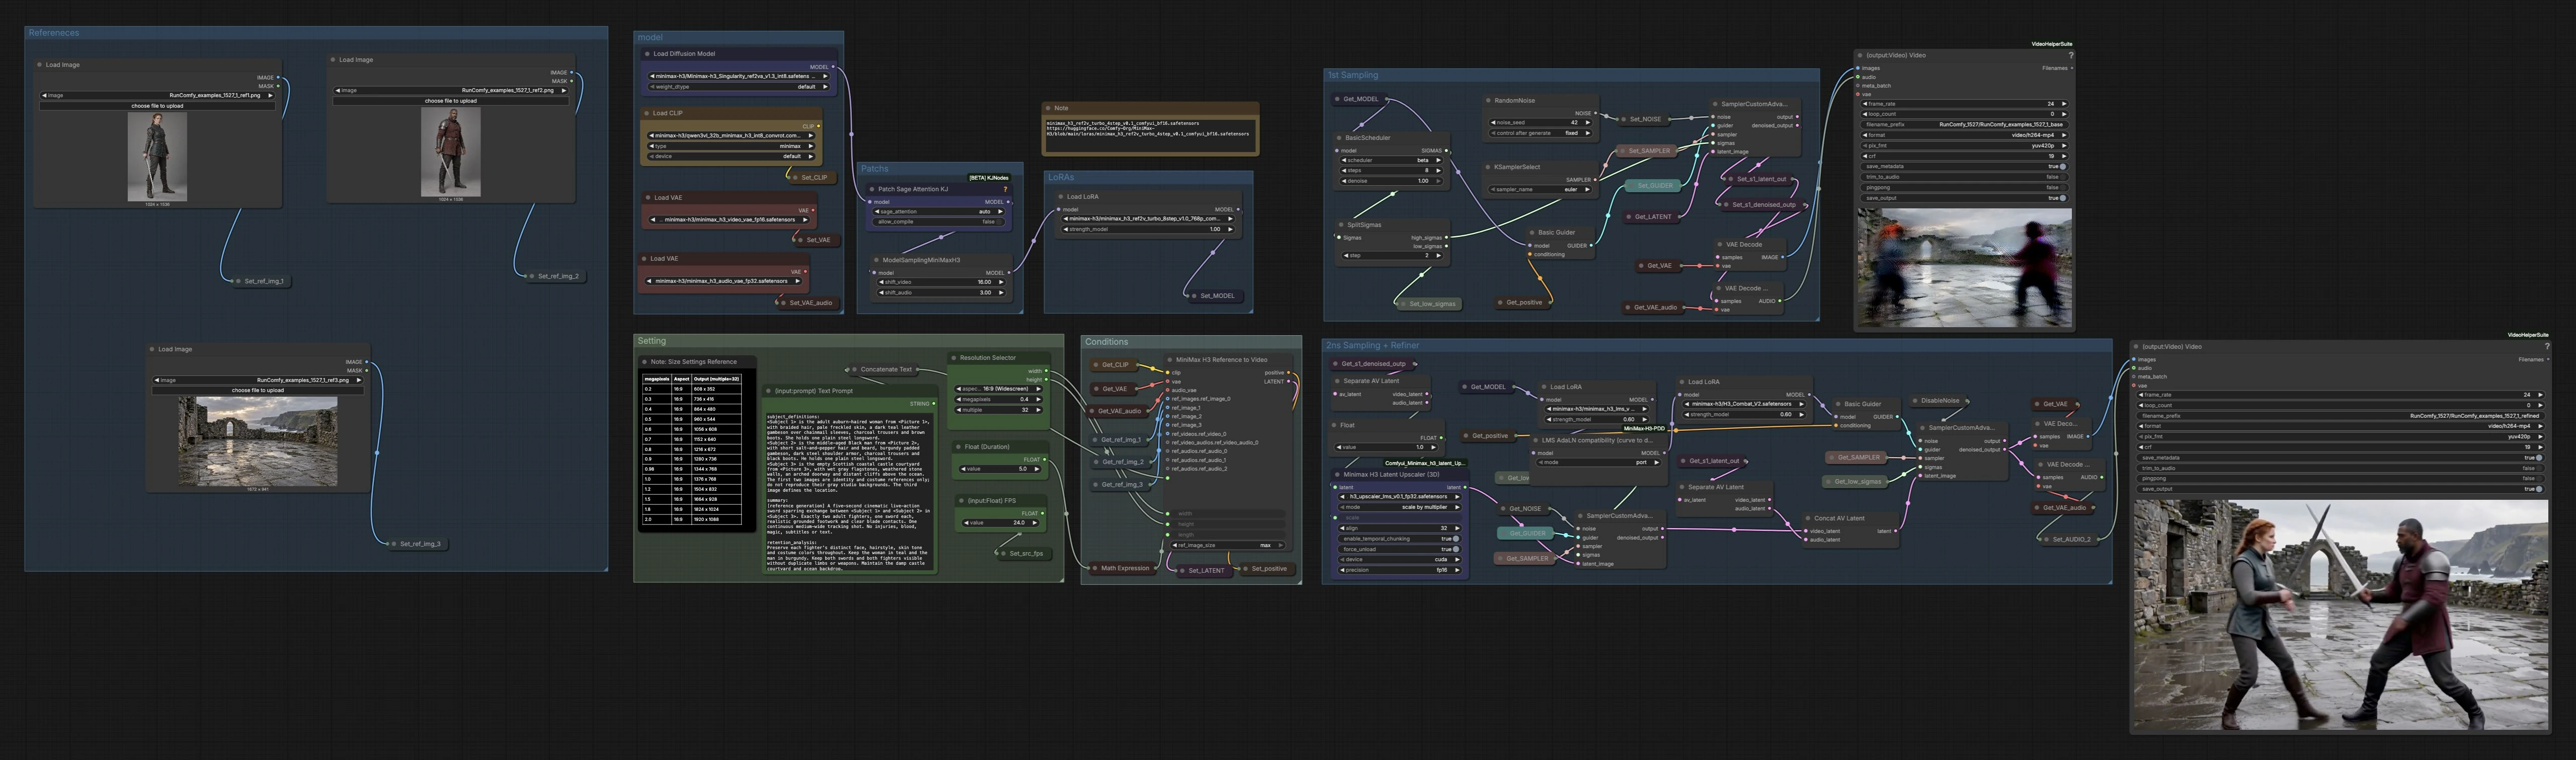
管道在两个协调的通过中运行。第一遍使用 Turbo 确立动作和时间。然后在第二遍中使用 LMS 和 Combat LoRAs 对视频潜在进行放大和优化,同时保留原生音频。您将获得快速的“基础”预览和精致的“精炼”导出。
设置#
使用设置组选择纵横比、工作分辨率、剪辑时长和帧率。时长控制将秒数转换为帧数,与采样器的分块对齐,有助于稳定性。起初选择较低的以快速预览,然后在框架和节拍看起来正确时增加。更高的分辨率和更长的剪辑会增加 VRAM 和渲染时间。
参考#
加载三个参考:每个角色一张图像和定义环境的一张图像。角色图像作为身份和服装指南,而不是背景,因此选择清晰的肖像,面部和关键服装元素易于辨识。场景参考设置照明、调色板和建筑;选择一个匹配您预期相机高度的视图。您可以自由更换参考,以探索不同的搭配和位置。
条件#
MiniMaxH3ReferenceToVideo (#56) 节点将结构化提示与参考和 MiniMax H3 编码器结合,生成联合音视频潜在和正向条件。提示在划分为主题定义、总结、保留分析、详细描述、整体音景和非叙述音乐等部分时效果最佳。明确战斗者数量、武器、相机移动和干净接触的准确数量。避免额外的角色、瞬移、超人动作或效果,如果您想要扎实的结果。
LoRAs#
LoRAs 在两个阶段应用。Turbo 在第一遍中注入,以加速动作探索而不牺牲身份保留。LMS LoRA 通过 AdaLN 兼容性修复流动,然后应用 Combat 使精炼器强调可读轮廓和打击-阻挡交换。您可以调整 LoRA 强度以平衡现实主义与风格化,以适应您的类型。
修补#
此组配置性能和计划塑形。PathchSageAttentionKJ (#199) 优化注意力以提高内存和速度,使高动作场景保持响应。MiniMaxH3SigmaShift (#297) 对齐视频和音频 sigma 计划,改善口型和拟音相对于动作的时间。看到时间漂移或小身份不稳定时使用这些。
第一次采样#
第一次通过初始化噪声,设置紧凑的计划,并使用 SamplerCustomAdvanced (#238) 采样,由您的正向条件引导。输出保存为基础潜在,并可以解码为具有原生音频的快速预览视频以供快速审查。这一遍是您判断阻挡、相机移动和打击节奏的地方。如果节拍图不对,请在此处修改提示和参考,然后再优化。
第二次采样 + 精炼#
在优化之前,音频和视频从第一次通过中分离,视频潜在通过 MinimaxH3LatentUpscaler3D (#124) 放大,而音频潜在保持不变。然后精炼器使用较低噪声的 sigmas 采样,使用 LMS 和 Combat LoRAs 增加材料细节、边缘保真度和战斗可读性。最后,图像和保留的音频被解码并组合成精炼导出。相比基础通过,期望更清晰的边缘、更干净的手和剑刃,以及更稳定的身份。
Comfyui MiniMax H3 动作场景工作流中的关键节点#
MiniMaxH3ReferenceToVideo (#56)#
使用 MiniMax H3 文本编码器和 VAE 从您的结构化提示和参考图像构建同步的音视频潜在。调整 prompt、width、height 和 length 以控制内容、框架和持续时间。为获得最佳效果,请保持主题定义和场景限制明确。参考:Comfy‑Org MiniMax‑H3。
MinimaxH3LatentUpscaler3D (#124)#
时间一致的 3D 潜在放大器,在优化前在通过之间放大视频潜在。适度增加 mode.scale 以获得细节,而不破坏动作稳定性。当您喜欢第一遍的时间但想要更清晰的边缘和纹理时,非常有用。参考:Comfyui Minimax H3 Latent Upscaler。
MiniMaxH3SigmaShift (#297)#
调整 MiniMax H3 使用的音视频 sigma 计划,使动作、口型提示和拟音保持对齐。调整 shift_video 和 shift_audio 可以减少对话或撞击中的时间漂移。除非您注意到在剪切点的不同步,否则请保留小偏移。参考:MiniMax‑H3 collection。
VHS_VideoCombine (#264)#
将解码的帧和音频结合成带有您选择的帧率和质量设置的最终 MP4。启用元数据保存以在导出中保留来源和工作流详细信息。当您的精炼视频超出保留音频时,使用 trim_to_audio。参考:ComfyUI‑VideoHelperSuite。
PathchSageAttentionKJ (#199)#
注意力优化,可以提高高细节场景和更大分辨率的吞吐量和稳定性。对于更长的镜头或复杂的环境,请保持启用。如果您在较小的剪辑上遇到性能回退,请尝试其自动模式。参考:ComfyUI‑KJNodes。
可选额外功能#
- 提示模式。使用提供的分段格式,并为动作写出节拍图。指定战斗者和武器的确切数量、相机移动以及可读接触的数量和时间。
- 参考策划。选择具有清晰面部和服装的身份照片,以及与预期视角和照明匹配的位置图像。避免在角色参考中使用繁忙的背景,以减少冲突。
- 审查通过。观看基础视频,以验证阻挡和时间,然后再优化。如果接触看起来模糊,请在提示中增加清晰度,并减少手或剑刃的急速。
- 常见问题和修复。快速的手或武器接触可能导致小的失真;简化围绕影响的编舞,缩短交换或增加与相机的距离,以帮助模型干净地渲染时刻。
- 可交付成果。工作流写入快速基础预览和精炼导出,以便您比较动作与最终外观。一旦身份、环境和节拍符合您的目标,请使用精炼片段进行分享。
通过 MiniMax H3 动作场景,您可以将两个角色图像、一个场景参考和一个精确的简报转化为扎实的、参考忠实的动作片段,具备同步的原生音频,准备好用于编辑、预览或发布。
致谢#
此工作流实现并基于以下作品和资源构建。我们诚挚感谢 Innovate Futures @ Benji 提供的 AI 视频 MiniMax H3 ComfyUI 工作流指导,WarmBloodAban 的 Minimax-h3_Singularity,以及 Comfy-Org 和 RunningHubAI 提供的 MiniMax-H3 基础模型和 LMS LoRA 的贡献和维护。有关权威详细信息,请参阅下方链接的原始文档和存储库。
资源#
- Innovate Futures @ Benji/AI Video MiniMax H3 (workflow source)
- WarmBloodAban/Minimax-h3_Singularity
- Hugging Face: WarmBloodAban/Minimax-h3_Singularity
- Comfy-Org/MiniMax-H3
- GitHub: Comfy-Org/workflow_templates
- Hugging Face: Comfy-Org/MiniMax-H3
- RunningHubAI/rh-minimax-h3-lms-v1.0-r64-lora
- Hugging Face: RunningHubAI/rh-minimax-h3-lms-v1.0-r64-lora
注意:使用引用的模型、数据集和代码受其作者和维护者提供的相应许可证和条款的约束。