Qwen Image 2.1 Outfit Change ComfyUI Workflow#
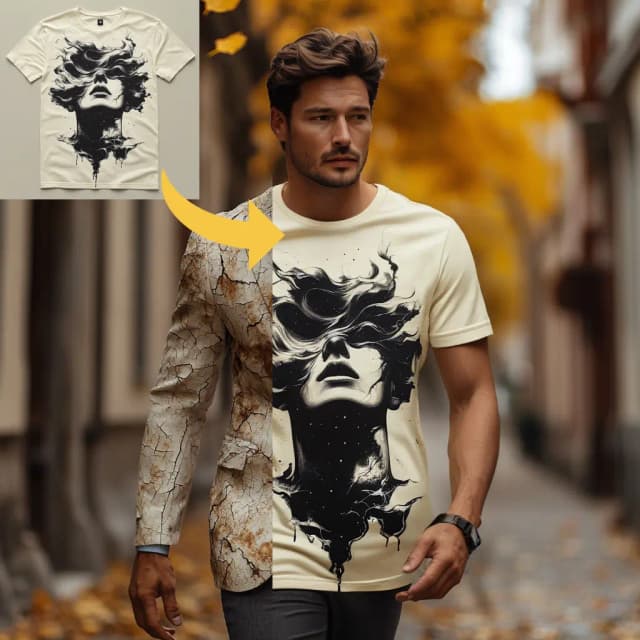
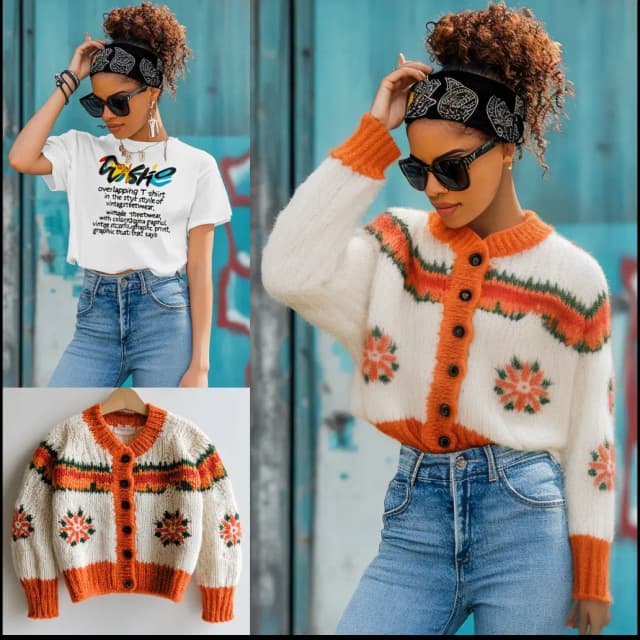
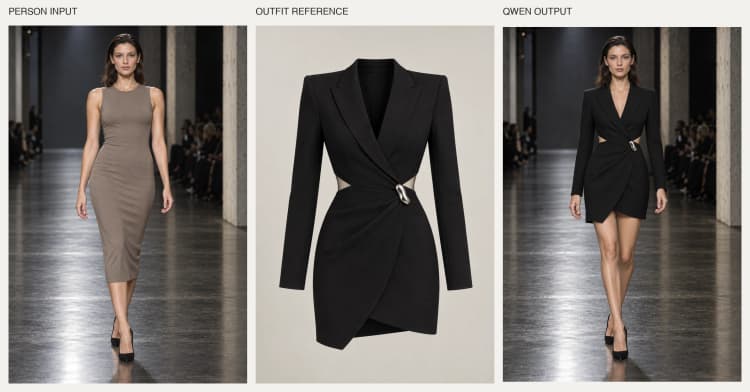
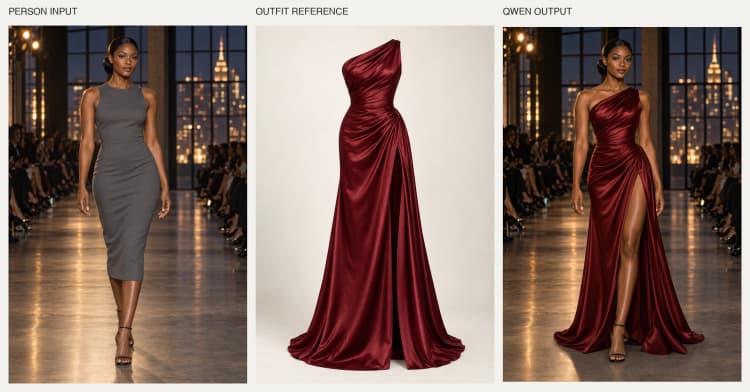
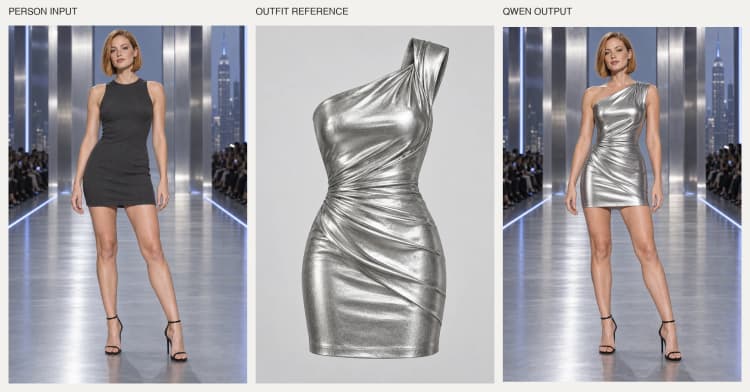
Qwen Image 2.1 Outfit Change ComfyUI Workflow переносит одежду с референсного изображения наряда на человека с другого изображения, руководствуясь короткой инструкцией. Цель состоит в том, чтобы сохранить объект, позу, лицо, фон и кадрирование камеры с Изображения 1, заимствуя силуэт, цвет и текстуру с Изображения 2, создавая единое реалистичное фото.
Основанный на единой модели Qwen-Image-2.1 с улучшенной подсказкой, этот рабочий процесс предназначен для виртуального стайлинга, модных редакционных материалов, макетов для электронной коммерции и визуализации гардероба. Вы предоставляете Изображение 1 (человек), Изображение 2 (наряд) и краткую подсказку; конвейер обрабатывает мультимодальную кондиционирование, генерацию и декодирование за вас.
Основные модели в ComfyUI Qwen Image 2.1 Outfit Change ComfyUI Workflow#
- Qwen-Image-2.1. Унифицированная модель генерации изображений и языка, которая интерпретирует вашу инструкцию вместе с обоими изображениями, а затем управляет процессом диффузии для синтеза окончательной замены наряда. Model card
- Qwen-Image-2.1 VAE. Вариационный автокодировщик, который кодирует изображения в латенты для кондиционирования и декодирует выходные данные сэмплера обратно в RGB, сохраняя мелкие детали ткани и цветовую точность. Веса предоставляются с пакетом ComfyUI. Weights
- Qwen-Image-2.1 текстовые кодировщики. Включенные текстовые кодировщики семейства Qwen-VL, которые превращают вашу инструкцию и визуальный контекст в кондиционирование, которое может следовать диффузионный бэкбоун. Включено с весами ComfyUI. Weights
Как использовать ComfyUI Qwen Image 2.1 Outfit Change ComfyUI Workflow#
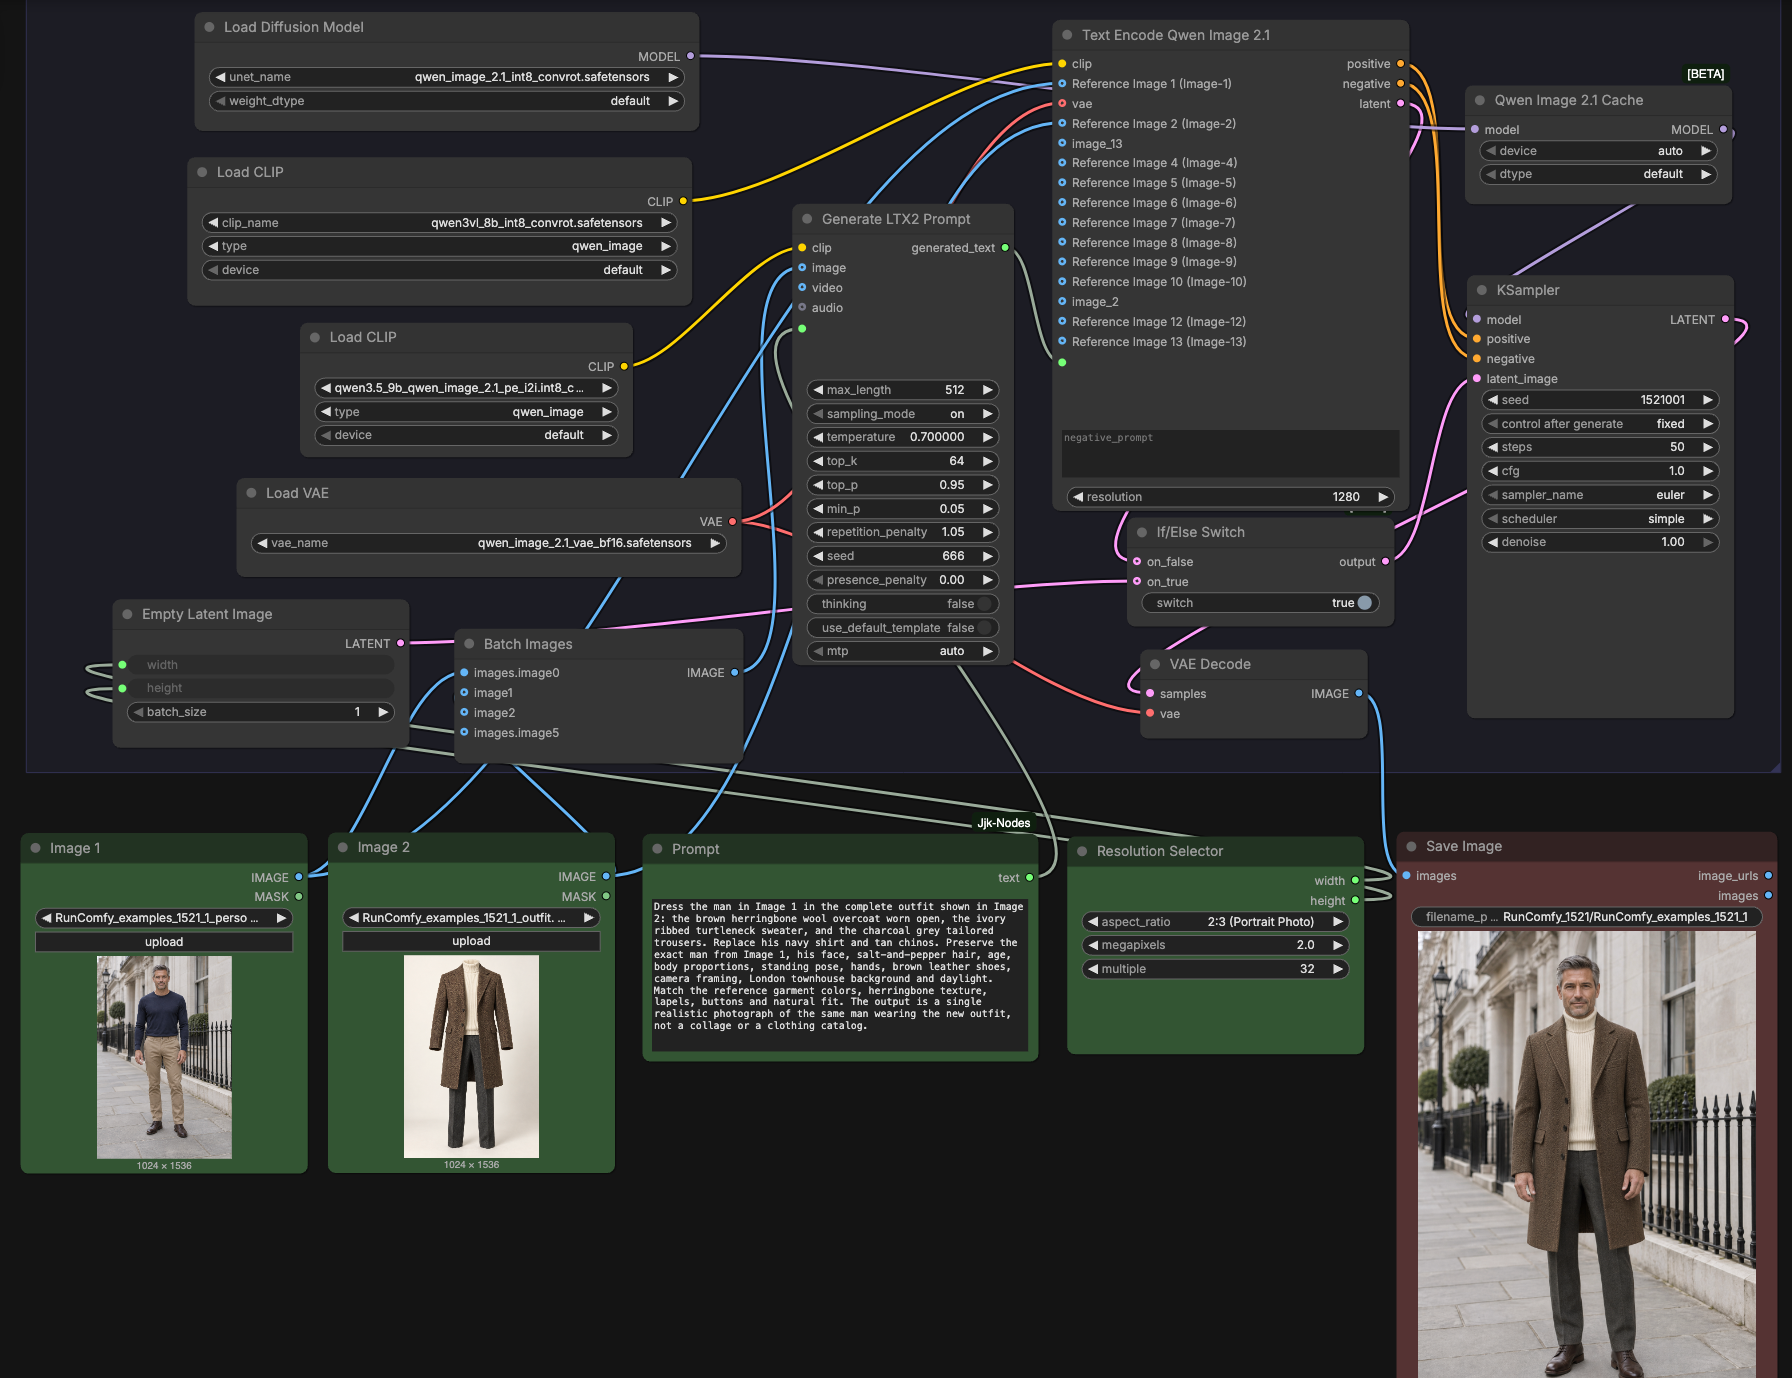
Этот рабочий процесс выполняется как единая группа, которая принимает два изображения плюс текстовую инструкцию, обогащает подсказку с использованием обоих визуальных элементов, строит мультимодальную кондиционирование для Qwen-Image-2.1, затем сэмплирует и декодирует окончательное изображение.
Группа Qwen Image 2.1 Outfit Swap#
Эта группа объединяет Изображение 1 (человек для изменения стиля) с Изображением 2 (референс наряда) и вашей инструкцией, затем направляет их через улучшение подсказки и кондиционирование Qwen-Image-2.1. Конвейер сохраняет идентичность и сцену из Изображения 1, перенося при этом силуэт одежды, цвет и тканевые черты из Изображения 2. Он создает латентный холст с разрешением, выбранным вами, сэмплирует с помощью модели Qwen-Image-2.1 и декодирует в готовое к сохранению изображение. Используйте эту группу для полной смены наряда с минимальной настройкой.
LoadImage (#470) Изображение 1#
Загрузите фотографию источника здесь. Выберите один, хорошо кадрированный снимок, где объект и поза, которые вы хотите сохранить, четко видны. Изображение подается как в улучшитель подсказок, так и в кодировщик Qwen-Image-2.1, чтобы идентичность, поза и фон сохранялись во время генерации.
LoadImage (#510) Изображение 2#
Загрузите здесь референс наряда. Выберите четкий вид одежды с видимым силуэтом и текстурами. Этот референс информирует об улучшении подсказки и становится частью визуального кондиционирования кодировщика, чтобы цвет, ткань и структура одежды переносились точно.
JjkText (#516) Подсказка#
Напишите короткую инструкцию, которая говорит модели, что нужно заменить и что сохранить. Упомяните одежду, которую нужно перенести с Изображения 2, и четко укажите, что идентичность, поза и фон из Изображения 1 должны остаться. Держите это конкретным и кратким для более сильного соблюдения.
BatchImagesNode (#505)#
Эта утилита объединяет Изображение 1 и Изображение 2 для улучшителя подсказок. Она обеспечивает, чтобы улучшитель видел оба визуальных элемента при перефразировании вашей инструкции, что улучшает названия одежды, цветовые термины и описания ткани в окончательной подсказке.
TextGenerateLTX2Prompt (#502)#
Генерирует уточненную, дружественную к модели инструкцию, читая оба изображения вместе с вашим текстом. Результатом является единая улучшенная строка подсказки, которая захватывает атрибуты одежды, соответствие и сигналы о сохранении сцены. Эта строка передается вниз по потоку как окончательная инструкция.
CLIPLoader (#500) и CLIPLoader (#478)#
Эти узлы загружают текстовые кодировщики Qwen-Image-2.1, используемые улучшителем и основным кодировщиком. Они токенизируют вашу уточненную инструкцию и подготавливают языковые встраивания, согласованные с визуальными особенностями, извлеченными из двух изображений.
TextEncodeQwenImage21 (#485)#
Создает мультимодальное кондиционирование для Qwen-Image-2.1 из Изображения 1, Изображения 2, уточненной подсказки и VAE. Оно излучает положительное и отрицательное кондиционирование плюс необязательное начальное латентное, которое может закреплять композицию и макет. Это сердце переноса наряда, выравнивающее язык и оба изображения перед сэмплированием.
ResolutionSelector (#13)#
Выбирает ширину и высоту выхода для генерации. Выберите соотношение сторон, которое соответствует вашему целевому кадрированию, затем установите общий размер. Выбор управляет латентным холстом, используемым во время сэмплирования.
EmptyLatentImage (#480) и ComfySwitchNode (#483)#
Создает новый латентный холст с выбранным разрешением и позволяет переключаться между началом с этого пустого латента или с латента кодировщика. Используйте переключатель, чтобы отдать предпочтение более сильному переносу наряда (пустой латент) или более плотному сохранению композиции Изображения 1 (латент кодировщика).
UNETLoader (#477) и QwenImage21Cache (#484)#
Загружают и подготавливают диффузионный бэкбоун Qwen-Image-2.1 для эффективного сэмплирования. Кэш сохраняет состояние модели готовым к использованию в течение нескольких запусков, снижая затраты на накладные расходы во время итерации.
KSampler (#482)#
Запускает процесс диффузии с моделью Qwen-Image-2.1 и ранее произведенным кондиционированием. Он интерпретирует вашу инструкцию, балансируя соблюдение одежды с Изображения 2 и сохранение идентичности и сцены из Изображения 1. Результатом является латентное изображение, готовое для декодирования.
VAEDecode (#481) и SaveImage (#518)#
Декодируют окончательный латент обратно в RGB изображение с помощью Qwen-Image-2.1 VAE, затем сохраняют его с использованием выбранного вами префикса имени файла. Сохраненный вывод представляет собой единое целостное фото объекта из Изображения 1, одетого в наряд из Изображения 2.
Основные узлы в ComfyUI Qwen Image 2.1 Outfit Change ComfyUI Workflow#
TextEncodeQwenImage21 (#485)#
Этот узел объединяет Изображение 1, Изображение 2, вашу уточненную инструкцию и VAE в кондиционирование, которое может следовать бэкбоун Qwen-Image-2.1. Настройте prompt и опциональный negative_prompt, чтобы управлять деталями одежды в противовес сохранению сцены. Вход resolution определяет рабочий масштаб кодировщика и должен соответствовать выбранному вами размеру выхода. См. карту модели для контекста поведения. Qwen/Qwen-Image-2.1
ComfySwitchNode (#483)#
Управляет начальной точкой для сэмплирования. Оставьте switch включенным, чтобы начать с нового латента для более сильного принятия наряда, или выключите его, чтобы повторно использовать латент кодировщика, когда вы хотите закрепить композицию или позу из Изображения 1. Переключайте его, чтобы исследовать различные компромиссы между идентичностью и нарядом без переписывания вашей подсказки.
KSampler (#482)#
Управляет тем, насколько точно модель следует инструкции и ссылкам. Используйте denoise, чтобы сбалансировать силу наряда против сохранения базового изображения, и настройте cfg, sampler_name, steps и seed для вкуса, резкости и воспроизводимости. Для общего руководства по поведению сэмплирования в ComfyUI обратитесь к репозиторию проекта. ComfyUI
ResolutionSelector (#13)#
Устанавливает размеры вашего выхода. Соответствуйте соотношению сторон кадрированию вашего входного фото, когда вы хотите, чтобы фон и кроп оставались стабильными, или измените его, чтобы перекомпоновать снимок. Большие размеры захватывают больше текстуры ткани за счет вычислений.
Дополнительные возможности#
- Используйте высококачественные входные данные: резкое, фронтальное освещение Изображения 1 и четкое, незагроможденное Изображение 2 обеспечивают лучшее перенесение силуэта и текстуры.
- Будьте конкретными в вашей инструкции: указывайте детали одежды, цвета, текстуры и что должно быть сохранено из Изображения 1.
- Чтобы сохранить композицию, лица и фон почти идентичными Изображению 1, переключитесь на латент кодировщика и уменьшите общую агрессивность через
denoise. - Для более сильного захвата стиля, когда наряд из Изображения 2 очень отличается, начните с нового латента и держите подсказку краткой и конкретной.
- Изменяйте
seed, чтобы исследовать альтернативы без изменения вашей настройки, затем зафиксируйте ту, которая вам нравится, для воспроизводимых результатов.
Ссылки на ресурсы модели
- Qwen-Image-2.1 model card: https://huggingface.co/Qwen/Qwen-Image-2.1
- ComfyUI weights bundle (UNet, VAE, text encoders): https://huggingface.co/Comfy-Org/Qwen-Image-2.1
Благодарности#
Этот рабочий процесс реализует и основывается на следующих работах и ресурсах. Мы с благодарностью признаем Qwen за модель Qwen-Image-2.1 и выпуск, Comfy-Org за веса ComfyUI Qwen-Image-2.1, и Wendy Wu за исходный рабочий процесс за их вклад и поддержку. Для авторитетных деталей, пожалуйста, обратитесь к оригинальной документации и репозиториям, указанным ниже.
Ресурсы#
- Wendy Wu/Source workflow
- Документы / Примечания к выпуску: runninghub.ai post
- Qwen/Qwen-Image-2.1
- GitHub: QwenLM/Qwen-Image-2.1
- Hugging Face: Qwen/Qwen-Image-2.1
- Comfy-Org/ComfyUI Qwen-Image-2.1 weights
- GitHub: Comfy-Org/workflow_templates
- Hugging Face: Comfy-Org/Qwen-Image-2.1
- Qwen/Qwen-Image-2.1 release
- Документы / Примечания к выпуску: Qwen blog
Примечание: Использование упомянутых моделей, наборов данных и кода подчиняется соответствующим лицензиям и условиям, предоставленным их авторами и поддерживающими.