logo
RunComfy
  • ComfyUI
  • Treinador
  • Modelos
  • MCPNovo
  • Preços
  • Seedance 2.5Hot
  • Seedream 5.5Novo

Workflows por modelo

HotMiniMax H3Vídeo com áudio a partir de texto, imagens ou referênciasHotQwen Image 2.1Crie imagens e edite fotos com referênciasWanVídeo a partir de texto ou imagens, transferência de movimentoFLUXGeração e edição de imagens e variações de personagensLTXVídeo com áudio sincronizado a partir de texto ou imagensQwen Image EditEdição de fotos com texto e imagens de referênciaKrea 2Criação de imagens, transferência de estilo e ediçõesZ-ImageRetratos e conceitos rápidos a partir de texto

Workflows populares e novos

NovoMiniMax H3 Character Swap V1.5Troque personagens do vídeo mantendo o áudio originalNovoP-H3-Image Reference EditEdite uma foto guiada por uma imagem de referênciaHotMiniMax H3 Image-to-VideoUma imagem em vídeo cinematográfico com áudio sincronizadoHotLTX 2.5 Image-to-VideoUm quadro em vídeo nítido com áudio sincronizadoHotMiniMax H3 Character Swap (SAM3)Troque personagens do vídeo seguindo o movimentoQwen Image 2.1 Multi-Image EditingCenas precisas com até 10 imagens de referênciaFLUX Klein Face SwapTroca de rosto natural e realistaSeedVR2 Video UpscalerUpscaling de vídeo nítido e suave
Ver mais workflows

Treinar um modelo

NovoMOSS-Image BaseGeração de imagens, recém-suportadoNovoFLUX.3 KleinGeração de imagens, recém-suportadoHotKrea 2O modelo de imagem mais treinadoHotKrea 2 TurboGeração de imagens em poucos passosHotQwen Image 2.1Geração e edição de imagensZ-Image TurboRetratos e imagens conceituais rápidosMiniMax H3Vídeo com áudio sincronizado

Treinar e implantar

Primeiros passosSeu primeiro treinamento com Ostris AI ToolkitConjuntos de dadosEnvie e gerencie conjuntos de dadosInferênciaUse seus modelos no playground ou via APIImplantaçõesImplante seus modelos em endpoints dedicados
Treinar mais modelos

Modelos de Imagem

NovoGPT Image 2.65% OFF · Texto para imagem detalhado, GIF e SVG, até 4KNovoSeedream 5.510% OFF · Texto para imagem até 2K, com PNGs transparentesNovoMiniMax H3 Image10% OFF · Texto ou referências para uma imagem até 4KNovoFLUX 3 Image Klein10% OFF · Texto ou referências para uma imagem de 768 a 4KHotSeedream 5.0 Pro41% OFF · Edições com referência e texto multilíngueHotSeedream 4.520% OFF · Edições fotorrealistas com consistência de marcaHotWan 2.6 ImageEdição de imagens por instruçõesNano Banana Pro77% OFF · Imagens precisas de 2K a 4K a partir de esboços

Modelos de Vídeo

NovoSeedance 2.5 Flash34% OFF · Text, image, or reference to videoNovoKling 4.010% OFF · Anime uma imagem em um clipe de 3 a 30 sHotWan 3.0 Prime13% OFF · Clipes rápidos a partir de vídeos de referênciaHotSeedance 2.536% OFF · Vídeo cinematográfico mais longo e consistenteHotWan 3.0Clipes a partir de imagens, vídeo e áudioHotMiniMax H3Anime o primeiro quadro em um clipe de 5 a 15 sWan 2.510% OFF · Movimento fluido com áudio nativoFLUX 3 MaxClipes a partir de texto, imagem ou quadros-chave
Ver mais modelos

API

Serverless (ComfyUI)Implante fluxos de trabalho ComfyUI como endpoints serverless.Serverless (LoRA)Implante LoRAs como endpoints serverless.Model APIExecute modelos hospedados sob demanda sem implantação.Trainer APITreine, gerencie e recupere LoRAs via API.CLIRun RunComfy models from your terminal.
MODELOS
Explorar
Todos os modelos
BIBLIOTECA
Gerações
APIS DE MODELOS
Documentação da API
Chaves API
CONTA
Uso

Wan 2.7 Texto para imagem: Gere imagens com IA online | Modelos e API | RunComfy

wan-ai/wan-2.7/text-to-image

Crie imagens de alta qualidade com o WAN 2.7 usando prompts em chinês ou inglês, prompt negativo, tamanhos predefinidos, até cinco variações por solicitação e seeds reproduzíveis. Cerca de US$ 0,03 por imagem no RunComfy. Também inclui um filtro de segurança configurável.

Prompt de texto que descreve a imagem desejada. Compatível com chinês e inglês.
Conteúdo que deve ser evitado na imagem gerada. Máximo de 500 caracteres.
Tamanho de saída predefinido. Quando houver suporte, um objeto `{width, height}` personalizado pode substituir a string predefinida.
Número máximo de imagens a gerar (1–5). Padrão: 1.
Seed aleatório para reproduzir resultados (0–2147483647).
Idle
The rate is $0.03 per image.

Introdução ao Wan 2.7 texto para imagem

O Wan 2.7 texto para imagem da Alibaba foi pensado para criar imagens prontas para produção: segue prompts com precisão, aceita instruções em chinês e inglês e oferece tamanhos práticos via image_size. No RunComfy, você pode configurar prompt, negative_prompt, image_size, max_images e seed. A família Wan 2.7 se destaca pela composição bem estruturada e pela fidelidade ao prompt. O filtro de segurança é controlado por enable_safety_checker.

Ideal para: imagens de marketing | concept art | formatos sociais | exploração rápida de layout antes de renderizações Pro

Wan 2.7 texto para imagem#


Visão geral#


O Wan 2.7 texto para imagem no RunComfy transforma prompts em chinês ou inglês em imagens estáticas. O modelo prioriza a compreensão precisa do prompt e resultados detalhados. A resolução máxima e os limites fixos dependem da implantação atual no RunComfy.


Campos de resposta#


Cada solicitação concluída retorna de uma a cinco imagens no array images, um texto opcional do modelo em generated_text e um seed na resposta.


Principais recursos#


  • Avisos bilíngues: Suporte para inglês e chinês.
  • Prompt negativo: Até 500 caracteres para evitar elementos indesejados.
  • Predefinições de image_size: square_hd, square, retrato e paisagem 4:3 e 16:9. Um objeto {width, height} pode ser suportado em integrações avançadas.
  • Exploração em lote: max_images 1–5 para variações em um trabalho.
  • Reprodução: seed inteiro opcional no intervalo [0, 2147483647].
  • Segurança: enable_safety_checker modera entrada e saída (padrão ativado).

Parâmetros#

ParâmetroObrigatórioTipoPadrãoIntervalo / OpçõesDescrição
prompt*Simstring——Tema principal, estilo e composição
negative_promptNãostring""máx. 500 caracteresConteúdo a evitar
image_sizeNãostringsquare_hdenum presetsProporção ou tamanho de saída
max_imagesNãointeger11–5Número de imagens a gerar
seedNãointeger—0–2147483647Reprodução do resultado
enable_safety_checkerNãobooleantrueon / offModeração de entrada e saída

Preços#

CobrançaPreço
Por imagem geradaUS$ 0,03

As cobranças variam de acordo com o número de imagens (max_images) em uma única solicitação.


Como usar#


  1. Escreva uma solicitação estruturada: assunto, ambiente, iluminação, lente e estilo.
  2. Adicione um negative_prompt curto apenas para coisas concretas que você deseja suprimir.
  3. Escolha uma predefinição de tamanho que corresponda à proporção da sua entrega.
  4. Defina max_images maior que 1 ao explorar variações; mantenha seed fixo para comparar as edições do prompt.
  5. Envie e repita. Aperte o vocabulário da câmera se a composição mudar.

Dicas de prompts#


  • Comece com o tema do herói, depois a iluminação e os materiais.
  • Especifique explicitamente as necessidades de aspecto quando não estiver usando uma predefinição correspondente.
  • Para iteração, altere uma dimensão de cada vez (prompt vs. seed vs. size).

Modelos Wan 2.7 relacionados#


  • Wan 2.7 Text-to-Image Pro no RunComfy — nível de maior fidelidade.
  • Wan 2.7 Image Edit no RunComfy — edições orientadas por referência.
  • Wan 2.7 Text-to-Video — fluxos de trabalho de movimento no RunComfy.

Modelos relacionados

qwen-edit-2509/lora

Edite de 1 a 10 imagens de origem com um prompt obrigatório e, se necessário, aplique até três entradas LoRA. Escolha entre seis tamanhos de saída e configure etapas de inferência, escala de orientação, de 1 a 4 resultados, seed e saída Default, JPEG ou PNG.

gemini-3-pro-image-preview/text-to-image

Gere de 1 a 4 imagens a partir de um prompt obrigatório, com 10 proporções, resolução 1K, 2K ou 4K, três formatos de arquivo e retorno síncrono opcional.

seedream-4-0/edit

Edite ou combine de 1 a 10 imagens JPEG ou PNG necessárias com um prompt obrigatório. Escolha `1K`, `2K`, `4K` ou uma das oito predefinições de resolução fixa.

flux-2/flex/edit

Edite de uma a dez imagens por prompt e controle tamanho, expansão, guidance, etapas, seed e formato.

flux-1-schnell/text-to-image

Geração de imagens rápida e fiel ao texto para uso criativo e pro

dreamina-4-0/edit

Crie visuais 4K com edições precisas e controle de estilo para designers.

Perguntas Frequentes

O que alimenta a conversão de texto em imagem do Wan 2.7 no RunComfy?

O RunComfy integra o Wan 2.7 texto para imagem da família de modelos da Alibaba. Os campos documentados prompt, negative_prompt, image_size, max_images, seed e enable_safety_checker são enviados ao serviço de inferência configurado para este modelo.

Quanto custa o texto para imagem do Wan 2.7 por imagem no RunComfy?

O preço do RunComfy é de US$ 0,03 por imagem gerada. Se você definir max_images acima de 1, o custo total aumentará conforme o número de imagens realmente retornadas.

O texto para imagem do Wan 2.7 oferece suporte a prompts em chinês?

Sim. Na interface do modelo RunComfy, você pode escrever prompts em chinês ou inglês.

Quantas imagens posso gerar em uma solicitação de texto para imagem do Wan 2.7?

Para este modelo, max_images deve ser um número inteiro entre 1 e 5.

Devo usar texto para imagem Wan 2.7 ou texto para imagem Wan 2.7 Pro?

As duas versões usam os mesmos nomes de parâmetros. A versão Standard custa menos e é indicada para rascunhos e iterações rápidas; a Pro busca resultados mais detalhados por um preço maior por imagem. Use Standard para explorar e Pro para criar o key visual final.

Posso definir largura e altura personalizadas em vez de usar uma predefinição `image_size`?

Esta interface usa predefinições do tipo string para que a integração padrão mapeie as entradas com confiabilidade. Um objeto {width, height} personalizado pode ser aceito em configurações avançadas ou somente via API. Confirme a compatibilidade no seu workspace do RunComfy antes de usar dimensões arbitrárias.

Siga-nos
  • LinkedIn
  • Facebook
  • Instagram
  • Twitter
Suporte
  • Discord
  • E-mail
  • Status do Sistema
  • afiliado
Modelos de Vídeo
  • Seedance 2.5 Flash Text To Video
  • Seedance 2.5 Flash
  • Seedance 2.5 Flash Reference to Video
  • Wan 3.0
  • MiniMax H3 Fast
  • Wan 2.5
  • Ver todos os modelos →
Modelos de Imagem
  • Seedream 5.5
  • Seedream 5.5 Edit
  • Seedream 5.5 Layer Decomposition
  • Wan 2.6 Image to Image
  • Nano Banana Pro
  • Seedream 5.0 Pro
  • Ver todos os modelos →
Legal
  • Termos de Serviço
  • Política de Privacidade
  • Política de Cookies
RunComfy
Copyright 2026 RunComfy. Todos os Direitos Reservados.

RunComfy é a principal ComfyUI plataforma, oferecendo ComfyUI online ambiente e serviços, juntamente com fluxos de trabalho do ComfyUI apresentando visuais impressionantes. RunComfy também oferece AI Models, permitindo que artistas utilizem as mais recentes ferramentas de AI para criar arte incrível.

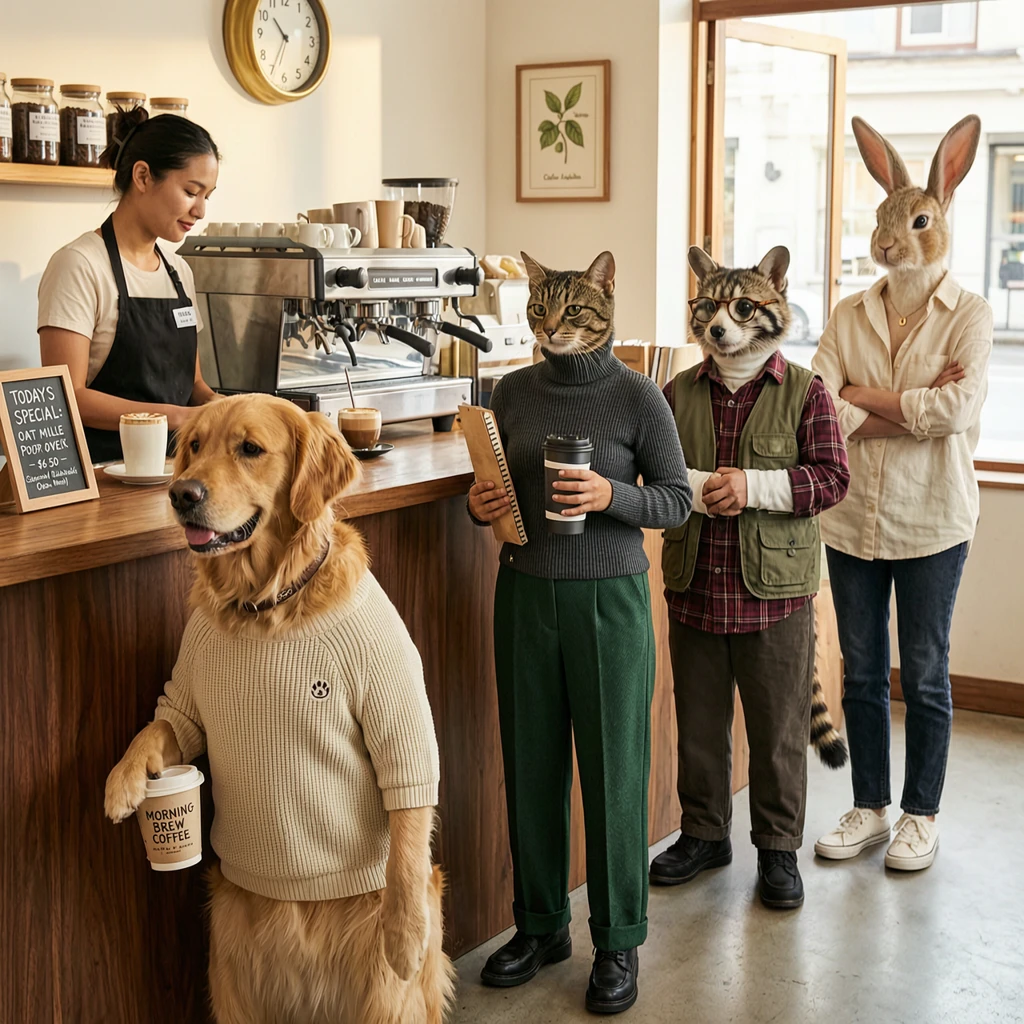
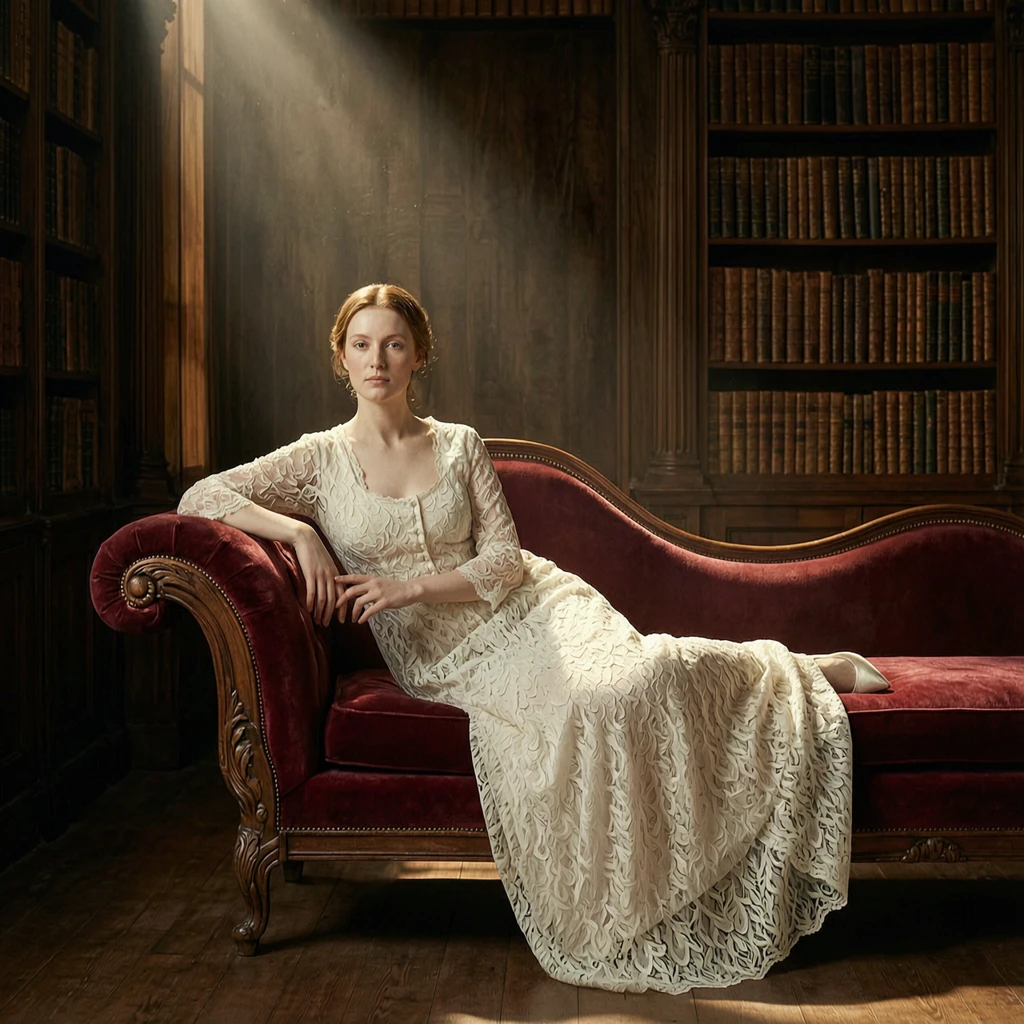
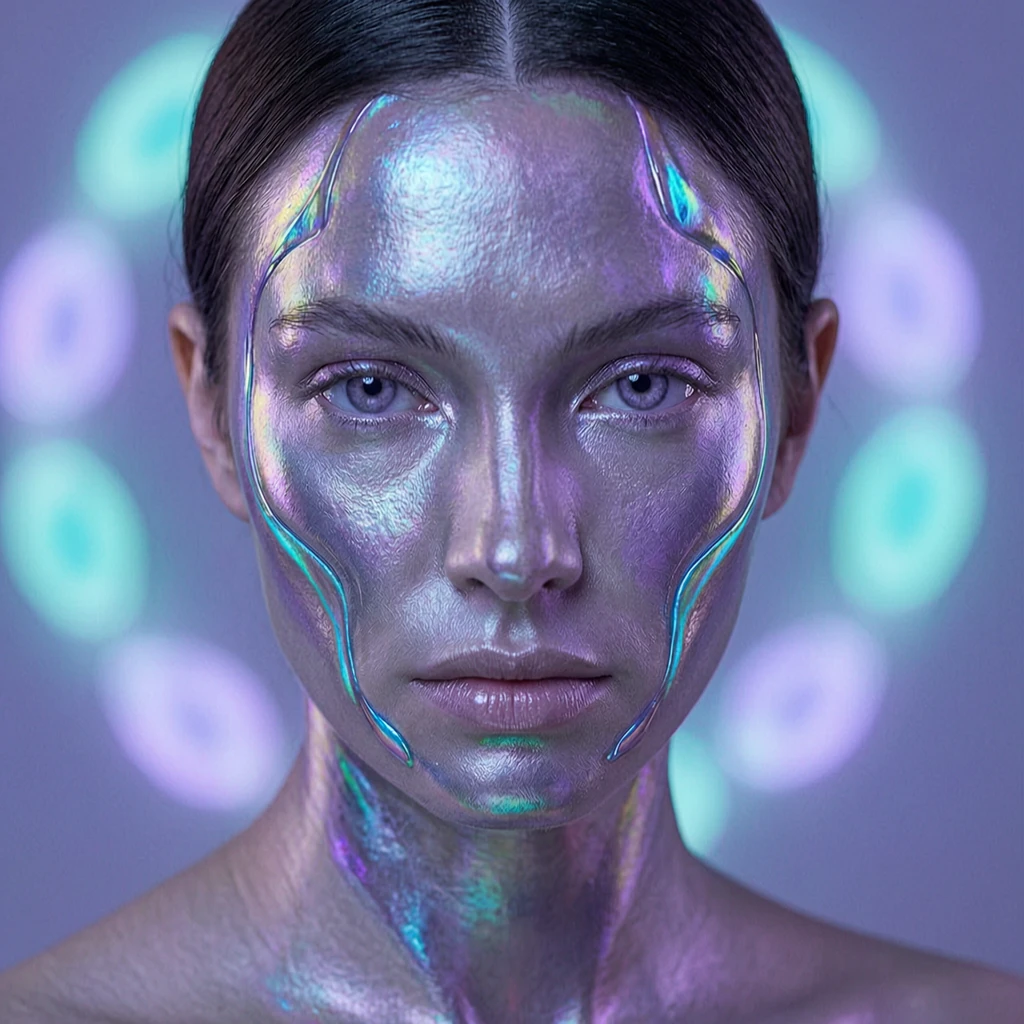
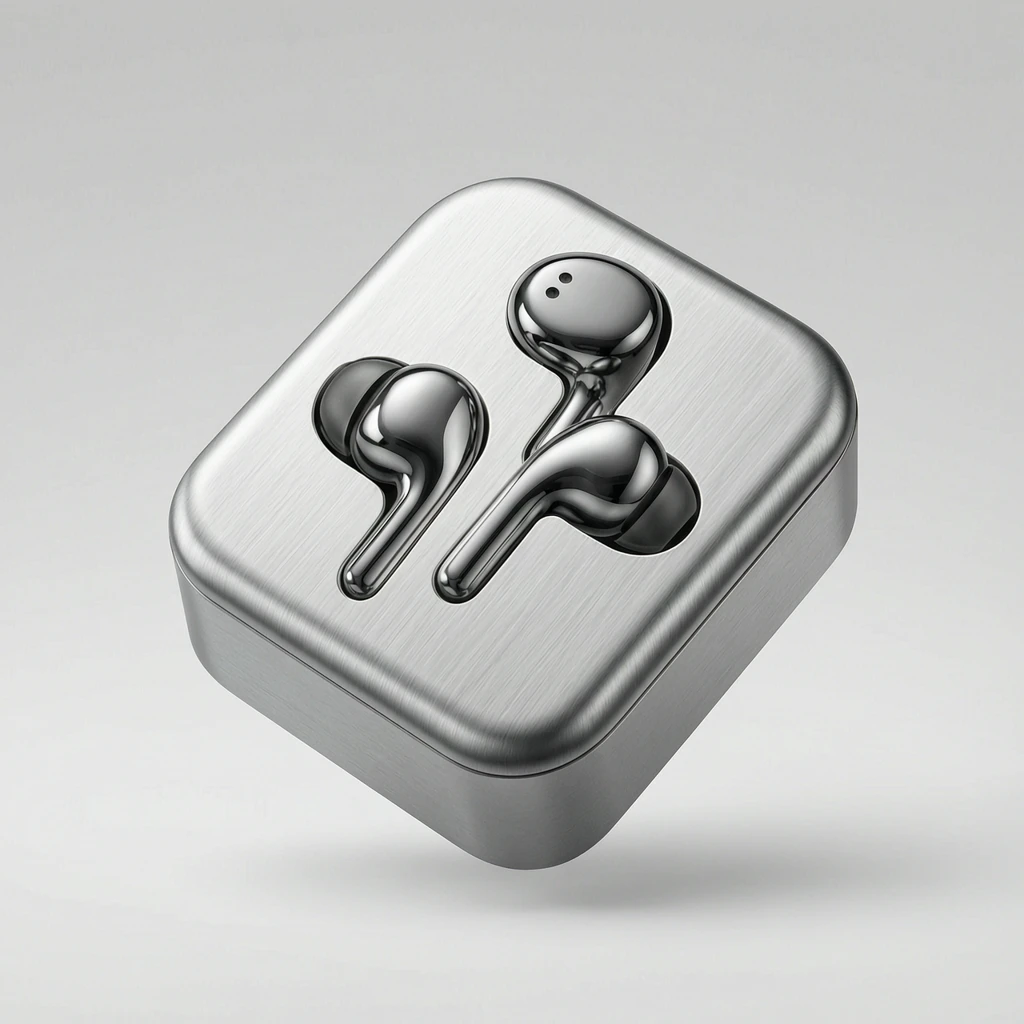
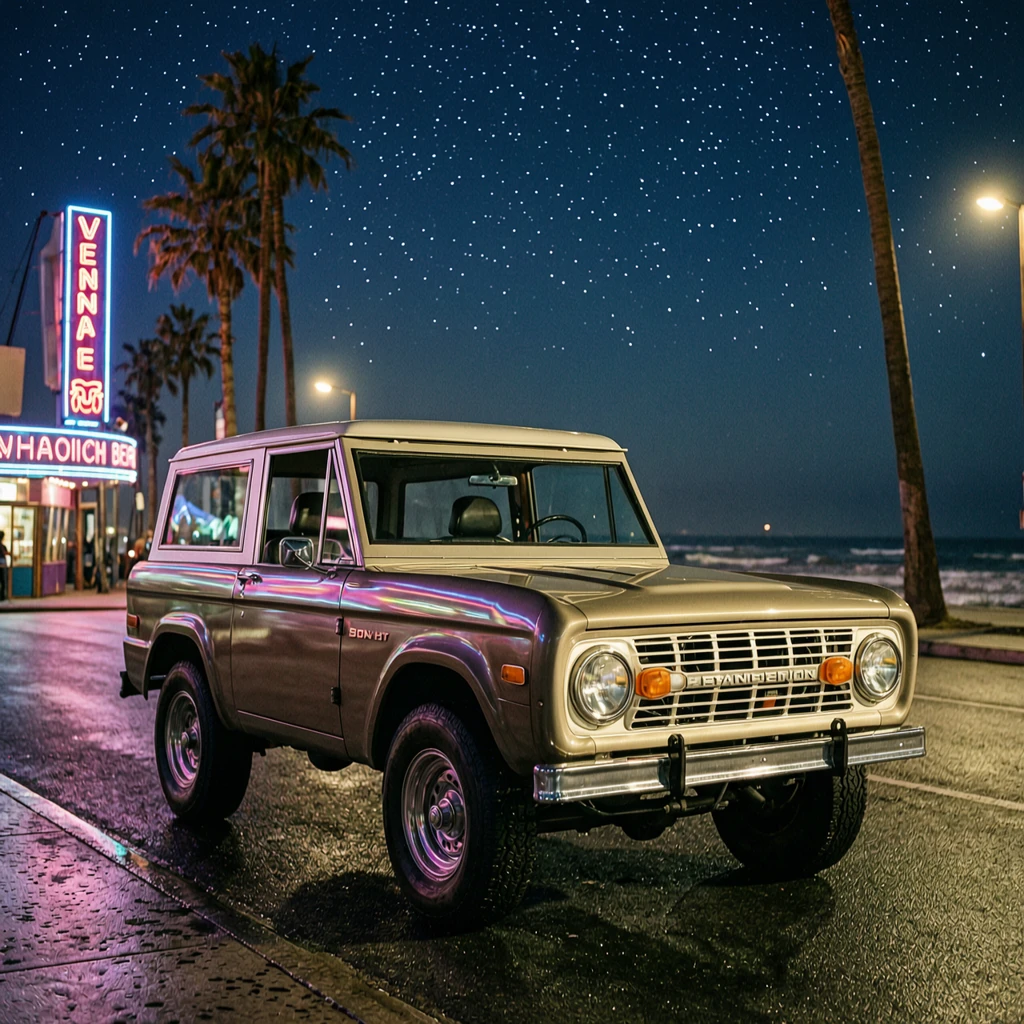
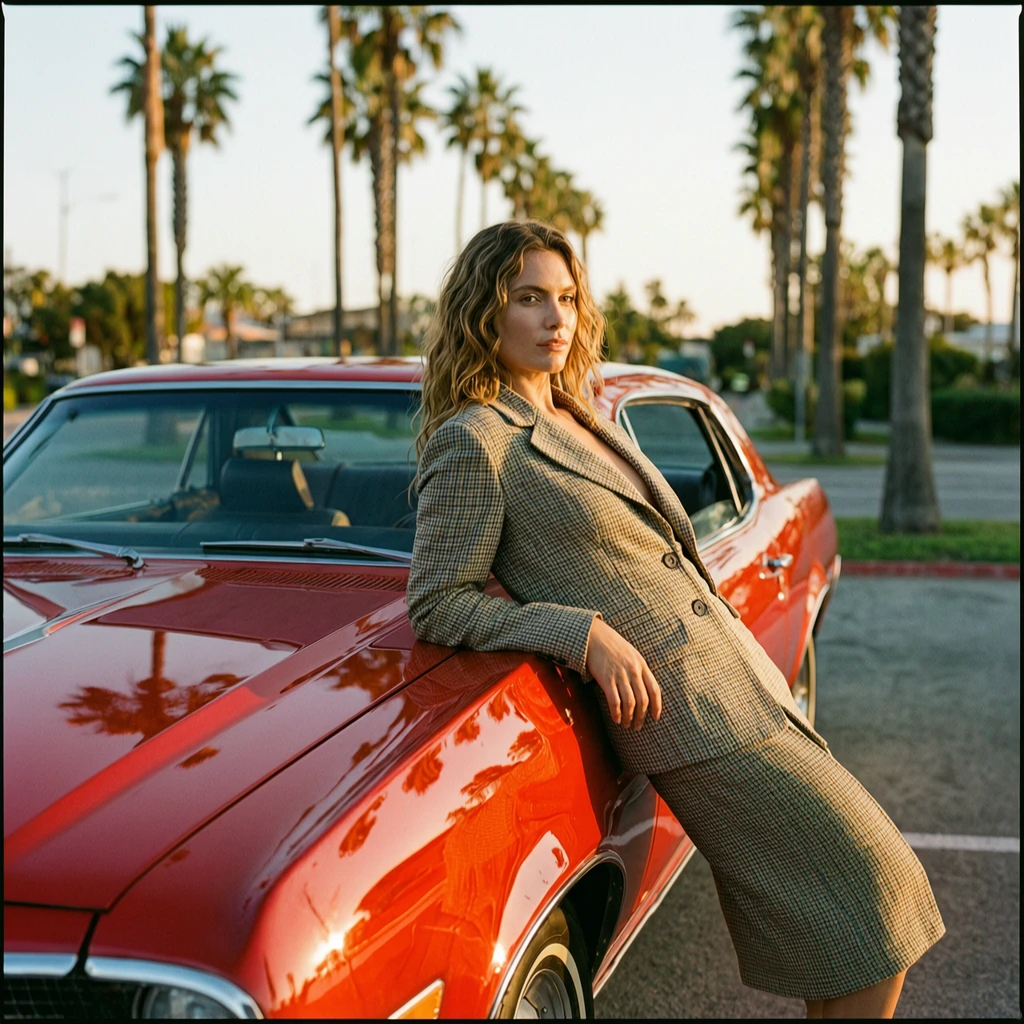
Exemplos do Wan 2.7 texto para imagem