MOSS-Image Text to Image: um fluxo de trabalho ComfyUI com amostragem de prompt para visuais cinematográficos, de produto e tipográficos#
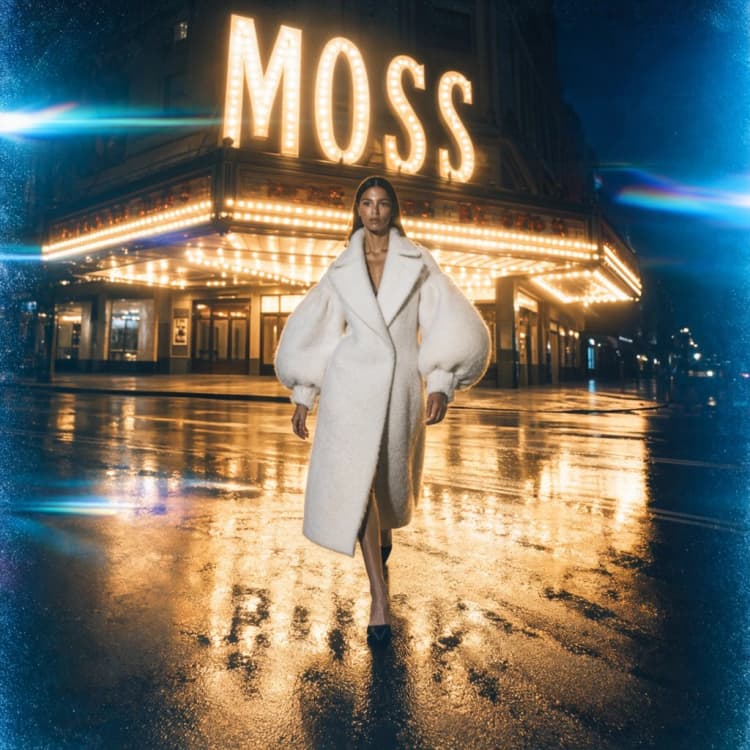
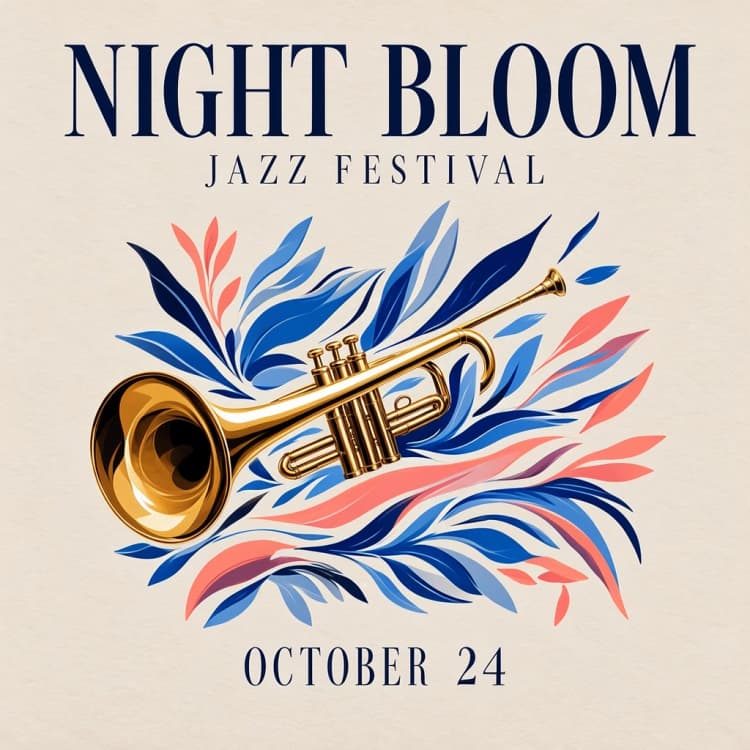
Este fluxo de trabalho MOSS-Image Text to Image transforma prompts simples em imagens finalizadas com forte renderização de texto, layouts claros e proporções flexíveis. Ele vem com a amostragem de prompt ativada para que ideias curtas sejam expandidas em legendas de cena ricas antes da geração, oferecendo resultados consistentes para retratos, cenas cinematográficas, visuais de produtos e designs guiados por tipografia.
Construído em torno do checkpoint MOSS-Image SFT, o gráfico expõe apenas os controles de que você precisa: tamanho da imagem, semente, etapas de amostragem e orientação. É ideal para exploração rápida de conceitos e para a elaboração de composições ilustradas ou fotográficas diretamente a partir de texto dentro do ComfyUI.
Modelos principais no fluxo de trabalho Comfyui MOSS-Image Text to Image#
- Checkpoint MOSS-Image SFT. A base de difusão ajustada por instrução que remove o ruído dos latentes para transformá-los em imagens. Este template carrega a variante SFT usada pelo lançamento oficial. Model card and files
- Codificador de texto Qwen 3.5 9B W4A8 GPTQ. O codificador de texto usado pelo MOSS-Image e também aproveitado pelo ampliador de prompt embutido. File
- FLUX.2 VAE Small. Comprime as imagens em latentes para amostragem e decodifica a imagem final para visualização e salvamento. File
Repositórios de referência: Comfy‑Org/MOSS‑Image (Hugging Face) e OpenMOSS/MOSS‑Image (GitHub).
Como usar o fluxo de trabalho Comfyui MOSS-Image Text to Image#
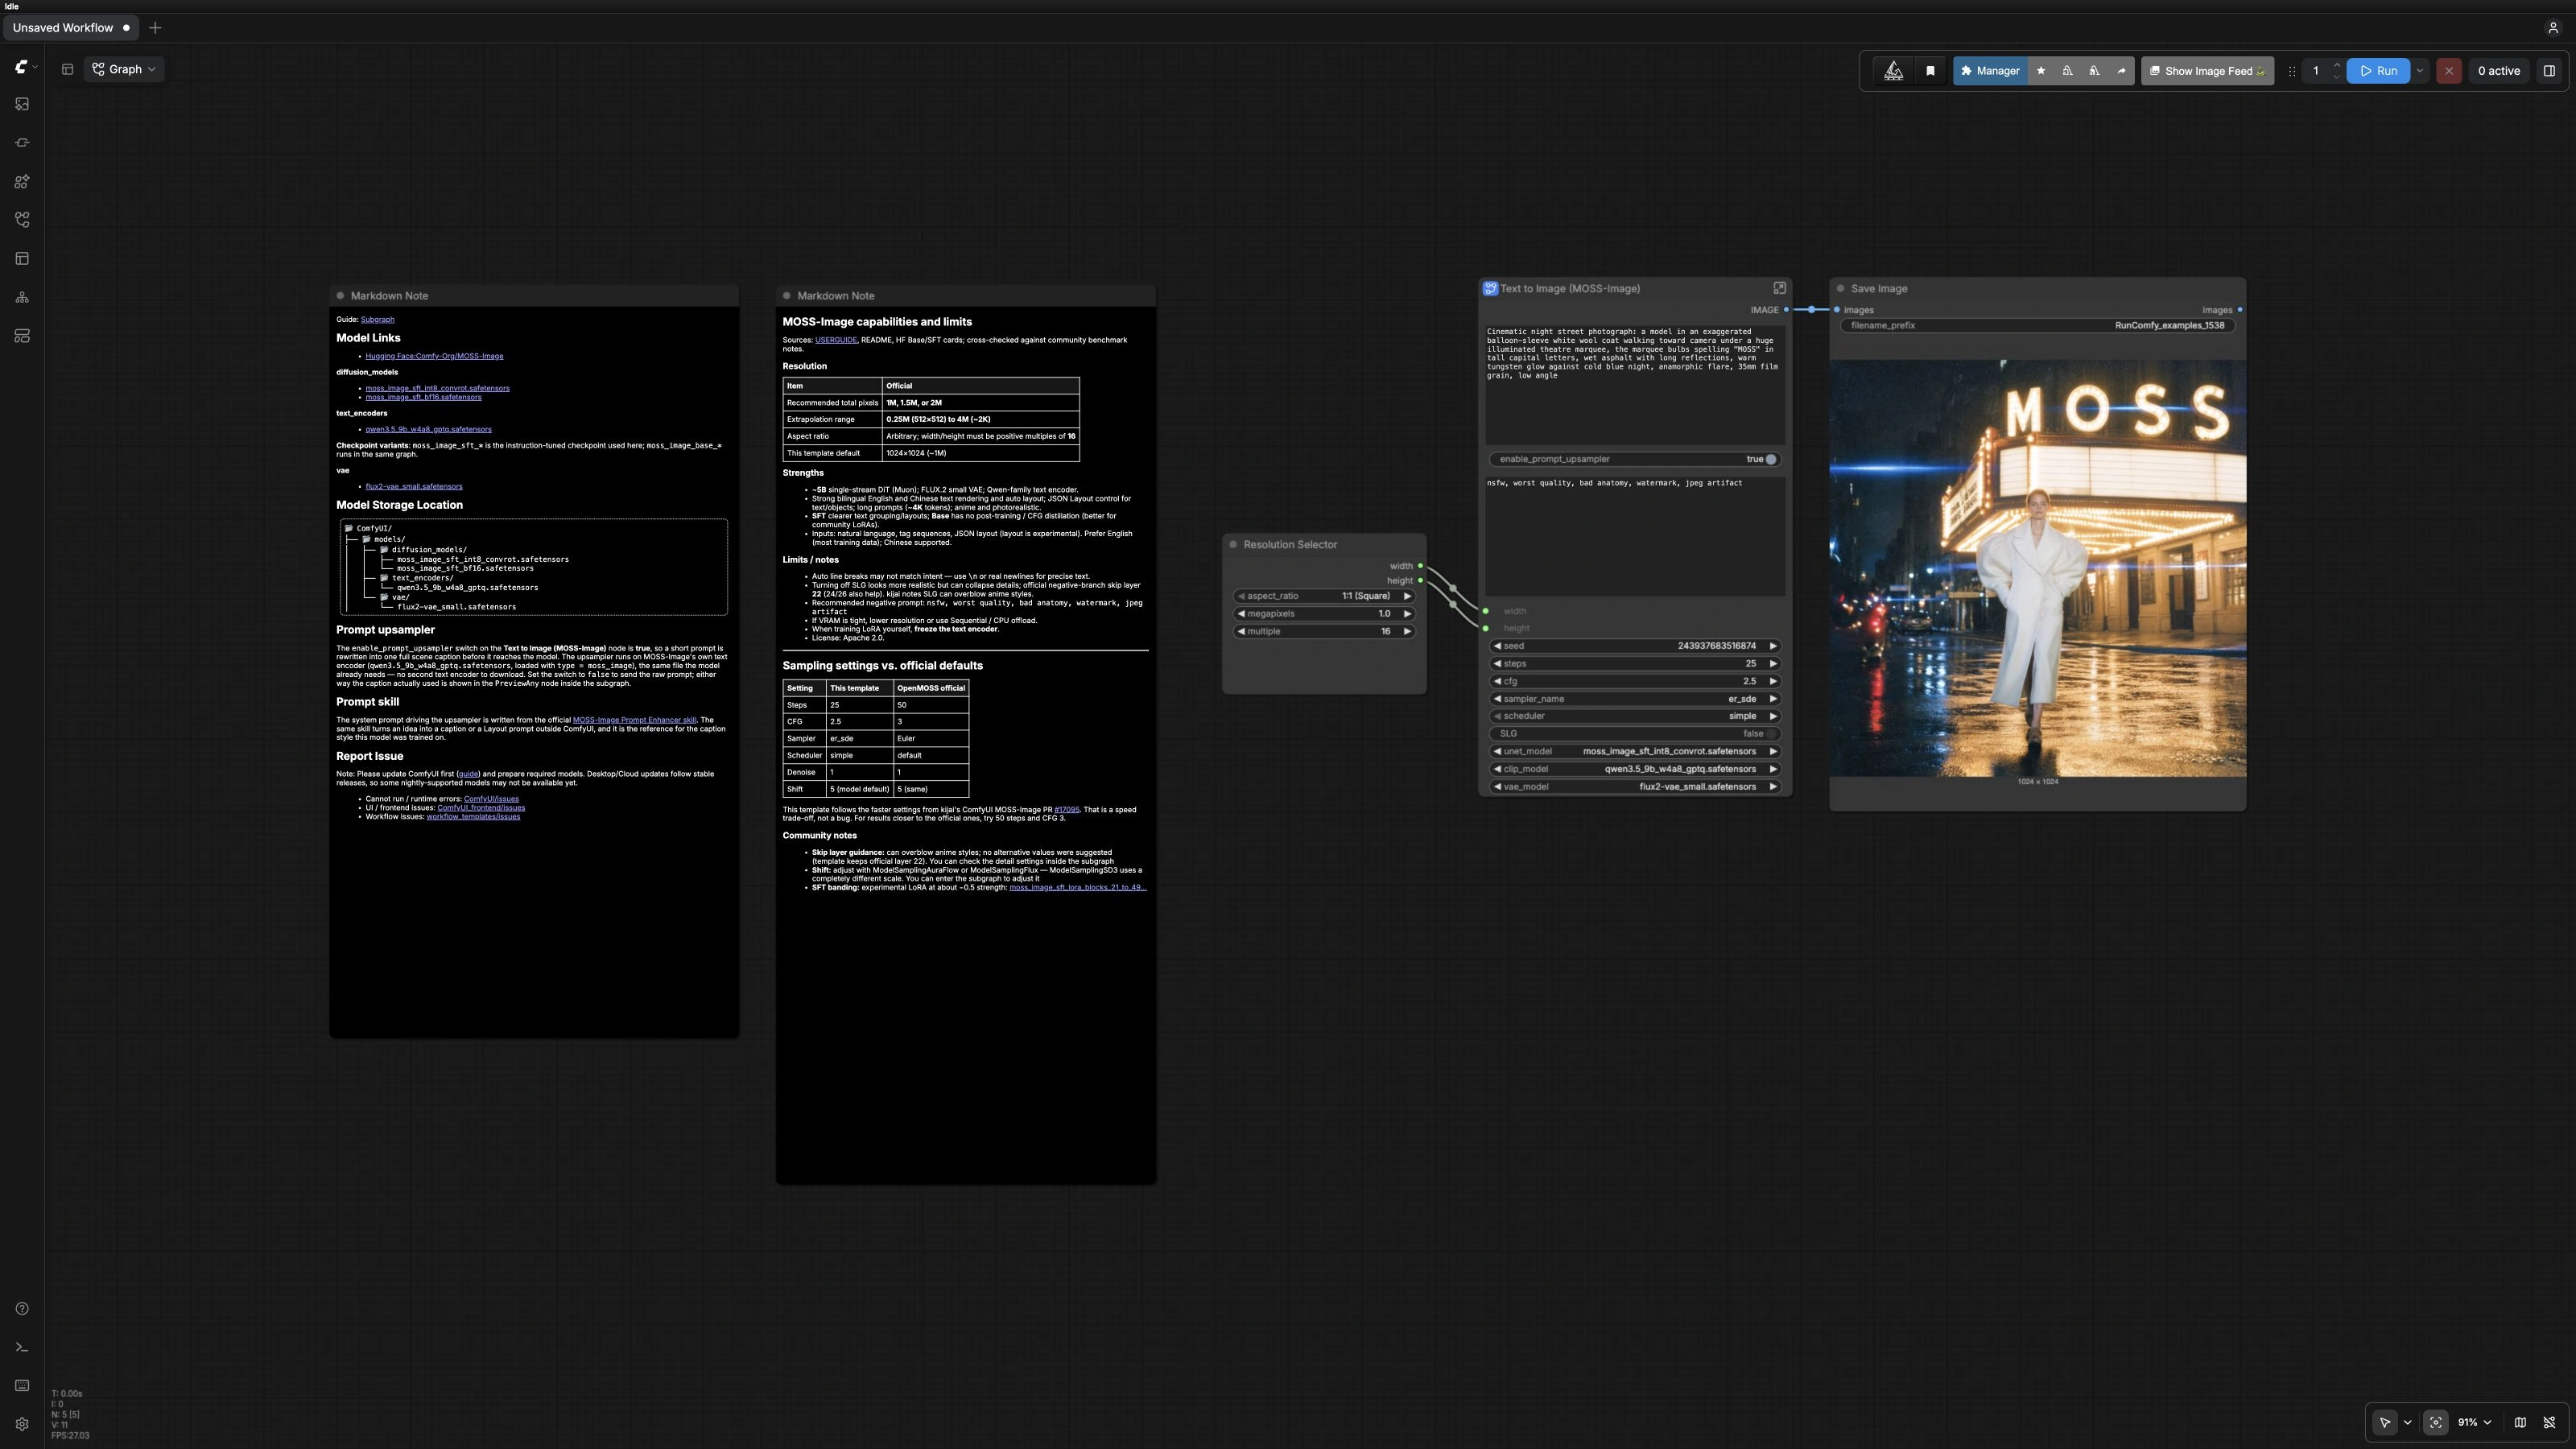
A primeira vista, o gráfico envia seu prompt através de um ampliador de prompt, codifica-o com o codificador de texto do modelo, amostra latentes com o MOSS‑Image SFT UNet, depois decodifica e salva a imagem. O subgrafo é organizado em quatro grupos para que você sempre saiba onde ajustar as coisas.
Modelos#
Este grupo carrega os ativos essenciais e a fiação para a geração. UNETLoader (#1) carrega o checkpoint MOSS‑Image SFT, enquanto CLIPLoader (#2) carrega o codificador de texto Qwen 3.5 usado tanto para legendagem quanto para condicionamento. VAELoader (#3) fornece o FLUX.2 VAE para decodificação. Existe uma etapa opcional SkipLayerGuidanceDiTSimple (#15) roteada por um ComfySwitchNode (#24); mantenha-o desligado para uma linha de base limpa ou ative-o quando quiser ênfase extra na estrutura e legibilidade.
Prompt#
Seu prompt final flui para CLIPTextEncode (#4) para o ramo positivo e CLIPTextEncode (#5) para o ramo negativo. Deixe o prompt negativo vazio para usar o padrão de referência no gráfico, ou cole o seu próprio para se afastar dos artefatos. KSampler (#7) gera o latente usando suas escolhas de seed, steps, cfg, sampler_name e scheduler, e VAEDecode (#8) o transforma em uma imagem. Use steps mais altos para mais refinamento, valores mais baixos para rascunhos mais rápidos e ajuste cfg moderadamente para equilibrar a adesão à legenda versus a variação criativa.
Tamanho da Imagem#
Este grupo controla a resolução. EmptyFlux2LatentImage (#6) cria o latente inicial com a width e height escolhidas, e o ResolutionSelector (#19) de nível superior oferece proporções comuns e orçamentos de pixels. Para a maioria dos assuntos, comece em 1024×1024, depois escale para mais detalhes se sua VRAM permitir. Mantenha a largura e a altura como múltiplos de 16 para permanecer compatível com o VAE.
Ampliador de Prompt#
Prompts curtos são expandidos em legendas detalhadas e amigáveis ao modelo antes da codificação. TextGenerate (#11) executa uma habilidade do sistema concisa adaptada ao MOSS‑Image para adicionar dicas de composição, iluminação e layout enquanto preserva qualquer texto entre aspas que você fornecer. O ComfySwitchNode (#16) alterna este ampliador; está ativado por padrão neste template MOSS-Image Text to Image. Use Preview as Text (final prompt) PreviewAny (#13) para ler exatamente o que será alimentado ao modelo, depois itere rapidamente editando sua ideia ou desligando o ampliador quando preferir prosa de controle bruto.
Quando estiver satisfeito com o resultado, o SaveImage (#9) do gráfico pai grava arquivos com o prefixo escolhido para que você possa comparar variações lado a lado.
Nós principais no fluxo de trabalho Comfyui MOSS-Image Text to Image#
TextGenerate(#11). Expande sua ideia em uma legenda polida usando a mesma família de codificadores de texto que o modelo. Ligue para resultados robustos e conscientes do layout; desligue se você já tiver um prompt preciso, totalmente especificado ou uma cópia estruturada que não deseja reescrever. Mantenha o texto visível entre aspas para garantir a renderização exata.KSampler(#7). O principal dial de qualidade-velocidade. Aumentestepspara refinar detalhes e ajustecfgpara trocar fidelidade por variação. Quando aumentar a resolução, considere um aumento modesto de etapas para manter a nitidez sem exagerar.SkipLayerGuidanceDiTSimple(#15). Etapa opcional que pode aumentar a estrutura e a legibilidade guiando camadas específicas do transformador. Ative via o interruptor SLG quando quiser texto mais nítido ou layouts mais rigorosos; desative se os resultados parecerem excessivamente estilizados para o seu assunto.ResolutionSelector(#19). Um nó de conveniência para escolher proporções comuns e contagens de pixels. Use-o para padronizar saídas em um projeto, depois ajuste exatamentewidtheheightno grupo de tamanho, se necessário.
Extras opcionais#
- Coloque entre aspas cada pedaço de texto que você deseja renderizado na imagem e insira quebras de linha onde precisar para preservar o layout.
- Para fotos de produtos ou designs com cópia estrita, desative o ampliador de prompt para manter a redação 100% literal.
- Trave uma
seedque você goste para fazer comparações "maçã com maçã" enquanto ajustasteps,cfge tamanho. - Se a memória for limitada, reduza primeiro a resolução, depois reduza
steps; revise os dials de qualidade depois de confirmar o visual. - Explore checkpoints alternativos no mesmo repositório, como variantes base versus SFT, trocando o arquivo em
UNETLoader(#1) do conjunto de modelos oficial.
Agradecimentos#
Este fluxo de trabalho implementa e se baseia nos seguintes trabalhos e recursos. Agradecemos imensamente à Comfy-Org pelo tutorial MOSS-Image ComfyUI e pelos arquivos do modelo MOSS-Image por suas contribuições e manutenção. Para detalhes autoritativos, consulte a documentação original e os repositórios vinculados abaixo.
Recursos#
- Comfy-Org/MOSS-Image ComfyUI Tutorial
- Docs / Release Notes: Official MOSS-Image ComfyUI tutorial
- Comfy-Org/MOSS-Image
- Hugging Face: Comfy-Org/MOSS-Image
Nota: O uso dos modelos, conjuntos de dados e código referenciados está sujeito às respectivas licenças e termos fornecidos por seus autores e mantenedores.