Qwen Image 2.1 Outfit Change ComfyUI Workflow#
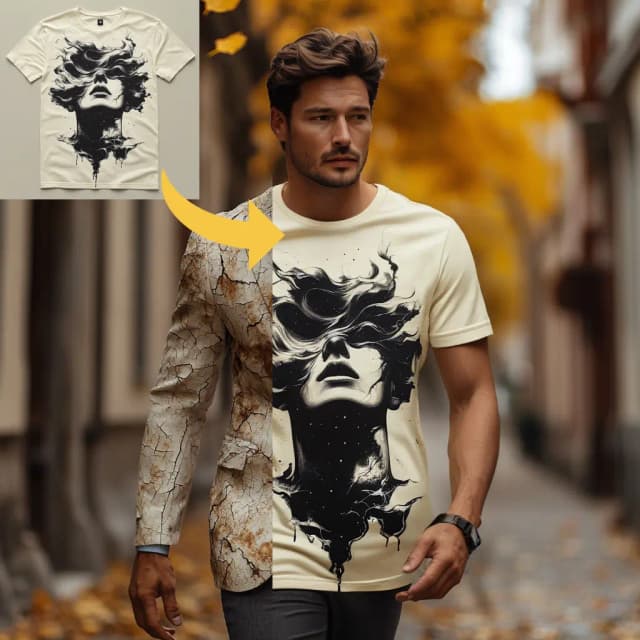
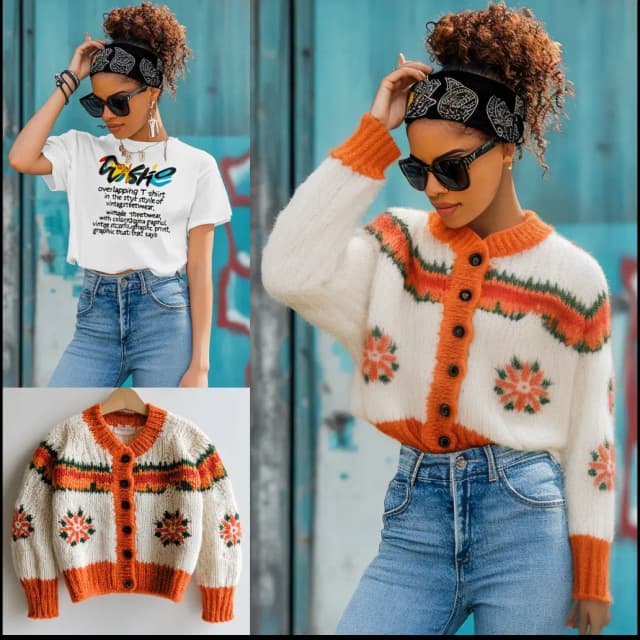
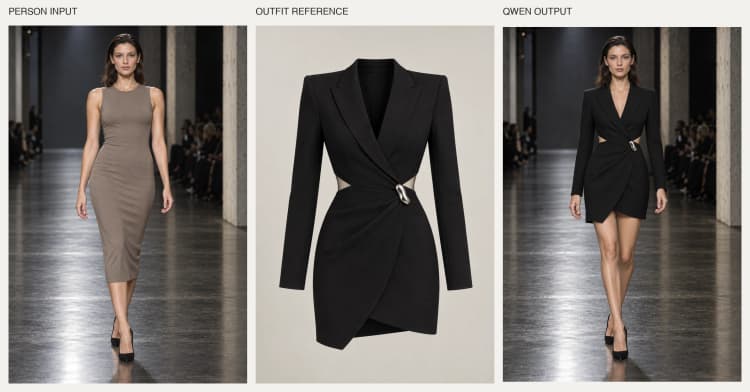
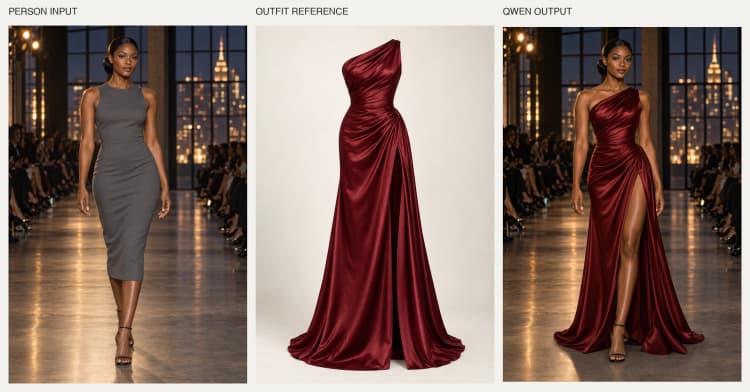
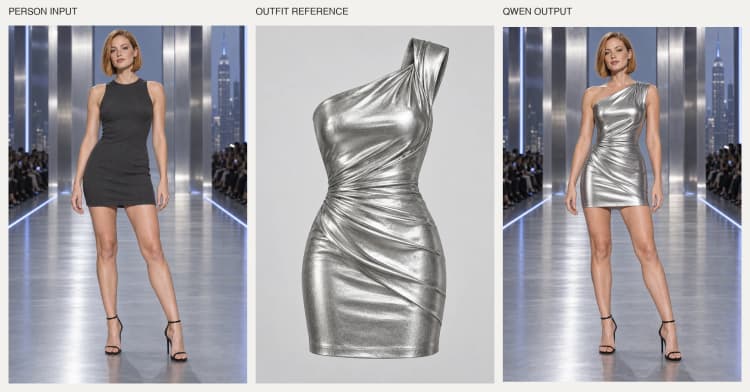
Qwen Image 2.1 Outfit Change ComfyUI Workflow는 의상 참조 이미지에서 두 번째 이미지의 사람에게 의상을 전송합니다. 짧은 지침에 따라 피사체, 포즈, 얼굴, 배경 및 카메라 구도를 Image 1에서 유지하면서 Image 2에서 실루엣, 색상 및 질감을 차용하여 단일 현실적인 사진을 생성합니다.
프롬프트 향상이 포함된 통합 Qwen-Image-2.1 모델을 기반으로 구축된 이 워크플로우는 가상 스타일링, 패션 편집, 전자상거래 목업 및 옷장 시각화를 위해 설계되었습니다. Image 1 (사람), Image 2 (의상) 및 간결한 프롬프트를 제공하면 파이프라인이 멀티모달 컨디셔닝, 생성 및 디코딩을 처리합니다.
ComfyUI Qwen Image 2.1 Outfit Change ComfyUI Workflow의 주요 모델#
- Qwen-Image-2.1. 귀하의 지침을 두 이미지와 함께 해석한 후 확산 과정을 주도하여 최종 의상 교체를 합성하는 통합 비전-언어 및 이미지 생성 모델입니다. Model card
- Qwen-Image-2.1 VAE. 이미지를 잠재로 인코딩하여 컨디셔닝하고 샘플러의 출력을 RGB로 디코딩하여 직물 세부사항 및 색상 충실도를 보존하는 변분 오토인코더입니다. ComfyUI 팩과 함께 제공됩니다. Weights
- Qwen-Image-2.1 텍스트 인코더. Qwen-VL 패밀리 텍스트 인코더가 포함되어 있어 귀하의 지침과 시각적 컨텍스트를 확산 백본이 따를 수 있는 컨디셔닝으로 변환합니다. ComfyUI 가중치와 함께 포함되어 있습니다. Weights
ComfyUI Qwen Image 2.1 Outfit Change ComfyUI Workflow 사용 방법#
이 워크플로우는 두 이미지와 텍스트 지침을 수집하는 단일 그룹으로 실행되며, 두 시각적 요소를 사용하여 프롬프트를 풍부하게 하고, Qwen-Image-2.1에 대한 멀티모달 컨디셔닝을 구축한 다음 최종 이미지를 샘플링하고 디코딩합니다.
Qwen Image 2.1 Outfit Swap 그룹#
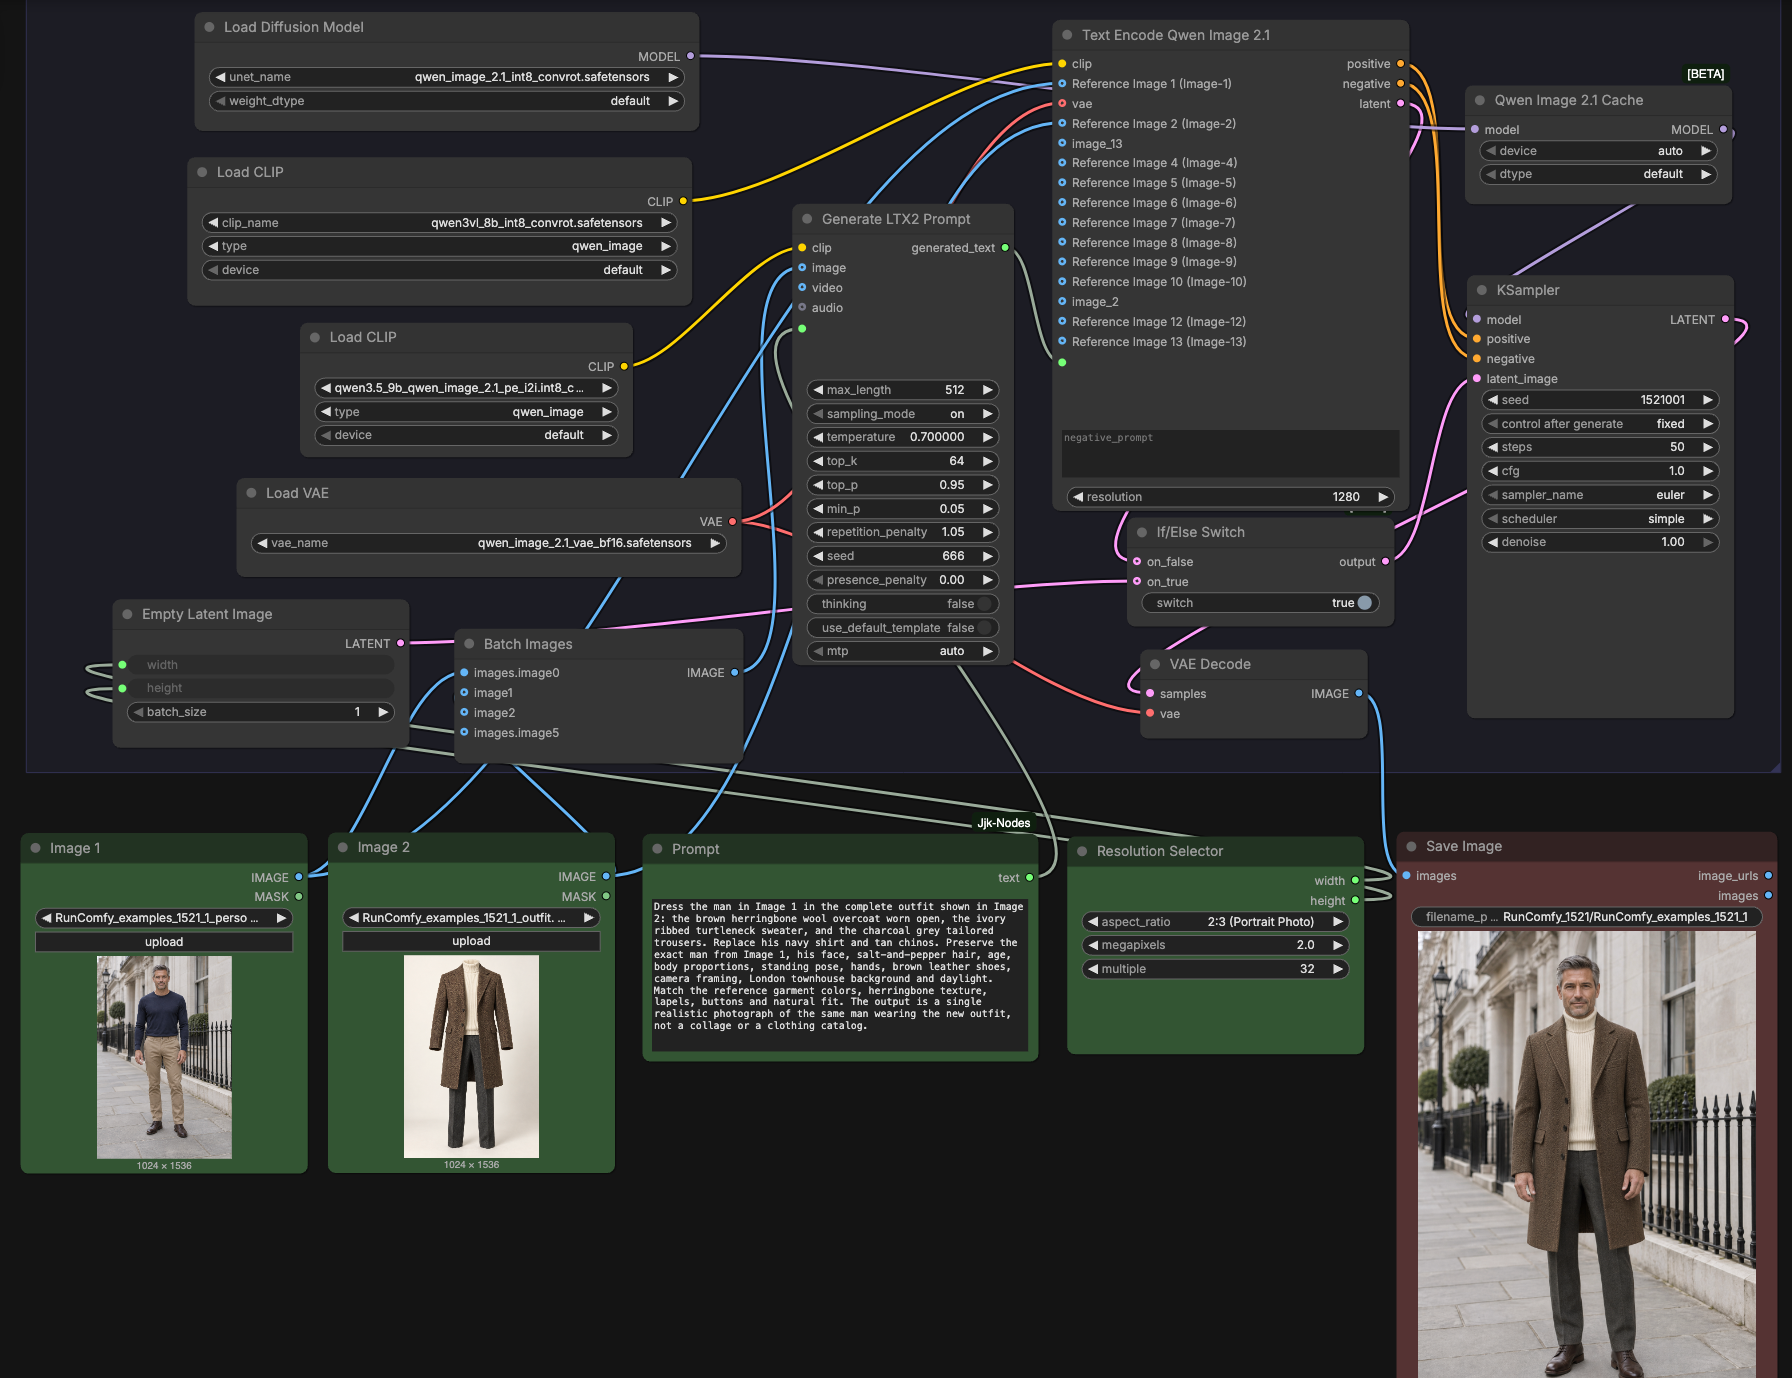
이 그룹은 Image 1 (스타일을 변경할 사람)과 Image 2 (의상 참조) 및 귀하의 지침을 짝지어 프롬프트 향상 및 Qwen-Image-2.1 컨디셔닝을 경로로 안내합니다. 파이프라인은 Image 1의 아이덴티티와 장면을 보존하면서 Image 2에서 의상의 실루엣, 색상 및 직물 특성을 전송합니다. 선택한 해상도에서 잠재 캔버스를 생성하고, Qwen-Image-2.1 모델로 샘플링하며, 저장할 준비가 된 이미지로 디코딩합니다. 최소한의 설정으로 의상 교체를 위한 엔드 투 엔드 사용에 적합합니다.
LoadImage (#470) Image 1#
여기에 소스 인물 사진을 로드하세요. 보존하고자 하는 피사체와 포즈가 명확하게 보이는 단일, 잘 구성된 샷을 선택하세요. 이미지는 프롬프트 향상기와 Qwen-Image-2.1 인코더에 공급되어 생성 중에 아이덴티티, 포즈 및 배경이 보존됩니다.
LoadImage (#510) Image 2#
여기에 의상 참조를 로드하세요. 실루엣과 질감이 보이는 명확한 의상의 뷰를 선택하세요. 이 참조는 프롬프트 향상에 정보를 제공하고 인코더의 시각적 컨디셔닝의 일부가 되어 색상, 직물 및 의상 구조가 정확하게 전송됩니다.
JjkText (#516) Prompt#
모델에게 무엇을 교체하고 무엇을 보존해야 하는지 지시하는 짧은 지침을 작성하세요. Image 2에서 전송할 의상 조각을 언급하고 Image 1에서 아이덴티티, 포즈 및 배경이 유지되어야 한다고 명확히 언급하세요. 강한 일관성을 위해 구체적이고 간결하게 유지하세요.
BatchImagesNode (#505)#
이 유틸리티는 프롬프트 향상을 위해 Image 1과 Image 2를 결합합니다. 지침을 재구성할 때 향상기가 두 시각적 요소를 볼 수 있도록 하여 최종 프롬프트에서 의상 명칭, 색상 용어 및 직물 설명을 개선합니다.
TextGenerateLTX2Prompt (#502)#
두 이미지를 귀하의 텍스트와 함께 읽어 모델 친화적인 세련된 지침을 생성합니다. 결과는 의상 속성, 핏 및 장면 보존 큐를 캡처하는 단일 향상된 프롬프트 문자열로, 최종 지침으로 전달됩니다.
CLIPLoader (#500) and CLIPLoader (#478)#
이 노드는 향상기와 메인 인코더에서 사용되는 Qwen-Image-2.1 텍스트 인코더를 로드합니다. 세련된 지침을 토큰화하여 두 이미지에서 추출된 시각적 기능과 정렬된 언어 임베딩을 준비합니다.
TextEncodeQwenImage21 (#485)#
Image 1, Image 2, 세련된 프롬프트 및 VAE에서 Qwen-Image-2.1의 멀티모달 컨디셔닝을 구축합니다. 긍정적 및 부정적 컨디셔닝을 방출하며, 구성 및 레이아웃을 고정할 수 있는 선택적 초기 잠재를 제공합니다. 이는 의상 전송의 중심이며, 샘플링 전에 언어와 두 이미지를 정렬합니다.
ResolutionSelector (#13)#
생성을 위한 출력 너비와 높이를 선택합니다. 대상 프레임에 맞추려는 경우 입력 사진의 프레임과 일치하는 종횡비를 선택한 다음 전체 크기를 설정하세요. 선택은 샘플링 중에 사용되는 잠재 캔버스를 구동합니다.
EmptyLatentImage (#480) and ComfySwitchNode (#483)#
선택한 해상도에서 새 잠재 캔버스를 생성하고, 이 빈 잠재에서 시작할지 인코더의 잠재에서 시작할지를 전환할 수 있습니다. 스위치를 사용하여 더 강한 의상 전송(빈 잠재) 또는 Image 1의 구성 보존(인코더 잠재)을 선호하세요.
UNETLoader (#477) and QwenImage21Cache (#484)#
효율적인 샘플링을 위해 Qwen-Image-2.1 확산 백본을 로드하고 준비합니다. 캐시는 실행 간 모델 상태를 준비 상태로 유지하여 반복 중 오버헤드를 줄입니다.
KSampler (#482)#
Qwen-Image-2.1 모델과 이전에 생성된 컨디셔닝으로 확산 프로세스를 실행합니다. 귀하의 지침을 해석하면서 Image 2의 의상에 대한 준수와 Image 1의 아이덴티티 및 장면 보존 간의 균형을 맞춥니다. 결과는 디코딩을 위한 잠재 이미지입니다.
VAEDecode (#481) and SaveImage (#518)#
Qwen-Image-2.1 VAE로 최종 잠재를 RGB 이미지로 디코딩한 다음, 선택한 파일 이름 접두사를 사용하여 저장합니다. 저장된 출력은 Image 1의 피사체가 Image 2의 의상을 입은 단일 통합 사진입니다.
ComfyUI Qwen Image 2.1 Outfit Change ComfyUI Workflow의 주요 노드#
TextEncodeQwenImage21 (#485)#
이 노드는 Image 1, Image 2, 세련된 지침 및 VAE를 Qwen-Image-2.1 백본이 따를 수 있는 컨디셔닝으로 융합합니다. 의상 세부사항 대 장면 보존을 조정하기 위해 prompt와 선택적 negative_prompt를 조정하세요. resolution 입력은 인코더의 작동 규모를 결정하며 선택한 출력 크기와 일치해야 합니다. 동작 컨텍스트는 모델 카드를 참조하세요. Qwen/Qwen-Image-2.1
ComfySwitchNode (#483)#
샘플링의 시작점을 제어합니다. 더 강한 의상 채택을 위해 새 잠재에서 시작하려면 switch를 켜두고, Image 1의 구성 또는 포즈를 고정하려면 인코더의 잠재를 재사용하려면 끄세요. 프롬프트를 다시 작성하지 않고도 다른 아이덴티티 대 의상 절충을 탐색하기 위해 전환하세요.
KSampler (#482)#
모델이 지침과 참조를 얼마나 충실하게 따르는지를 관리합니다. 기본 이미지의 보존에 대한 의상의 강도를 균형 있게 조정하기 위해 denoise를 사용하고, cfg, sampler_name, steps 및 seed를 조정하여 맛, 선명도 및 재현성을 조정하세요. ComfyUI의 샘플링 동작에 대한 일반적인 지침은 프로젝트 저장소를 참조하세요. ComfyUI
ResolutionSelector (#13)#
출력 크기를 설정합니다. 배경과 크롭을 안정적으로 유지하려면 입력 사진의 프레임과 일치하는 종횡비를 선택하거나, 샷을 재구성할 경우 변경하세요. 더 큰 크기는 계산 비용을 대가로 더 많은 직물 질감을 캡처합니다.
선택적 추가 기능#
- 고품질 입력 사용: 선명하고, 전면 조명이 비친 Image 1과 명확하고 방해받지 않는 Image 2는 더 나은 실루엣 및 질감 전송을 생성합니다.
- 지침에서 명확히 하세요: 의상 조각, 색상, 질감 및 Image 1에서 보존해야 할 것을 명명하세요.
- 구성, 얼굴 및 배경을 Image 1과 거의 동일하게 유지하려면 인코더 잠재로 전환하고
denoise를 통해 전체 공격성을 낮추세요. - Image 2의 의상이 매우 다를 때 더 강한 스타일 인수를 위해 새 잠재에서 시작하고 프롬프트를 간결하고 구체적으로 유지하세요.
- 설정을 변경하지 않고 대안을 탐색하기 위해
seed를 다양화한 다음, 재현 가능한 결과를 위해 선호하는 것을 잠그세요.
모델 리소스 링크
- Qwen-Image-2.1 모델 카드: https://huggingface.co/Qwen/Qwen-Image-2.1
- ComfyUI 가중치 번들 (UNet, VAE, 텍스트 인코더): https://huggingface.co/Comfy-Org/Qwen-Image-2.1
감사#
이 워크플로우는 다음 작업 및 리소스를 구현하고 기반으로 합니다. 우리는 Qwen의 Qwen-Image-2.1 모델 및 릴리스, Comfy-Org의 ComfyUI Qwen-Image-2.1 가중치 및 Wendy Wu의 소스 워크플로우의 기여 및 유지 관리에 대해 감사드립니다. 권위 있는 세부사항은 아래에 링크된 원본 문서 및 저장소를 참조하세요.
리소스#
- Wendy Wu/Source workflow
- 문서 / 릴리스 노트: runninghub.ai post
- Qwen/Qwen-Image-2.1
- GitHub: QwenLM/Qwen-Image-2.1
- Hugging Face: Qwen/Qwen-Image-2.1
- Comfy-Org/ComfyUI Qwen-Image-2.1 weights
- GitHub: Comfy-Org/workflow_templates
- Hugging Face: Comfy-Org/Qwen-Image-2.1
- Qwen/Qwen-Image-2.1 release
- 문서 / 릴리스 노트: Qwen blog
참고: 참조된 모델, 데이터 세트 및 코드의 사용은 해당 저자 및 유지 관리자가 제공하는 라이센스 및 조건에 따릅니다.