


kling/lipsync/text-to-video
テキストから音声を生成して動画に同期し、音声ID、言語、速度を設定します。
Wan 2.2 S2Vは、必須の静止画像と音声トラックから人物動画を生成します。録音内容に合わせてspeech、sing、performを選び、解像度を480Pまたは720Pに設定します。画像と音声には、形式、寸法、長さ、ファイルサイズの制限があります。
テキストから音声を生成して動画に同期し、音声ID、言語、速度を設定します。
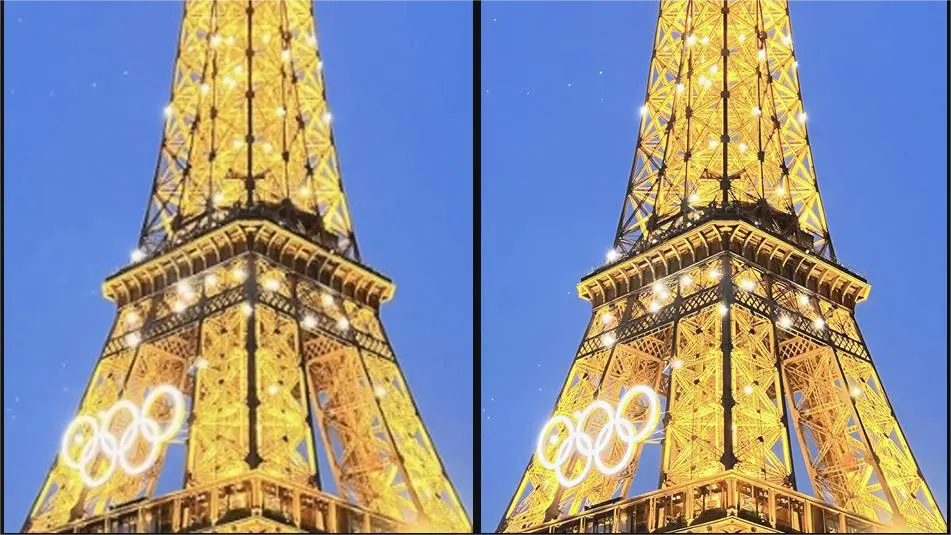
必須の元動画を復元・アップスケールします。出力幅、読み込むフレーム数、フレームレート、シード、復元ガイダンス、バッチサイズを設定できます。

ネイティブ音声に対応し、テキストプロンプトで元動画を自在に作り替えます。

FLUX 3 Draft: 720p での高速かつ低コストのテキストからビデオへのプレビュー

スタイルタグと歌詞から、ボーカル入りの楽曲を最長4分まで生成。
静止画を滑らかな映像へ変換。Seedance 1.0で創造的なアニメーション制作を実現。
画像1枚と音声ファイル1つが必須です。この画面にはテキストプロンプト入力はありません。
JPG、JPEG、PNG、BMP、WEBPに対応します。幅と高さはいずれも400ピクセルより大きく、7000ピクセル以下にしてください。
20秒未満のWAVまたはMP3を使用します。ファイルサイズは15 MB未満にしてください。
speech、sing、performから選べます。初期値はspeechです。
480Pまたは720Pです。初期値は480Pです。
5秒の動画生成には68クレジットが必要です。
会話にはspeech、歌声にはsing、会話や歌唱に限定されない幅広い演技にはperformを選びます。
対応形式と制限を確認してください。画像は寸法条件、音声は形式、長さ、ファイルサイズの各条件を満たす必要があります。
はい。バッチサイズは1、2、3、4から選択できます。
いいえ。speech、sing、performのいずれも、形式、寸法、長さ、ファイルサイズの制限は同じです。
RunComfyは最高の ComfyUI プラットフォームです。次のものを提供しています: ComfyUIオンライン 環境とサービス、および ComfyUIワークフロー 魅力的なビジュアルが特徴です。 RunComfyはまた提供します AI Models, アーティストが最新のAIツールを活用して素晴らしいアートを作成できるようにする。


