Qwen Image 2.1 服裝更換 ComfyUI 工作流程#
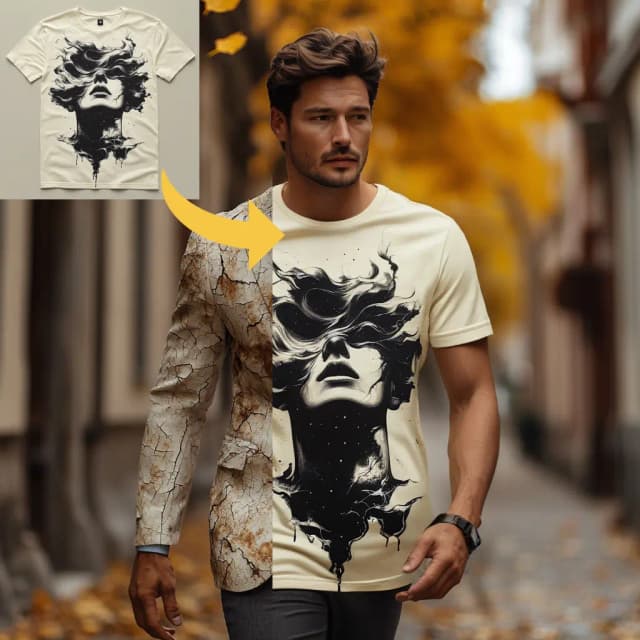
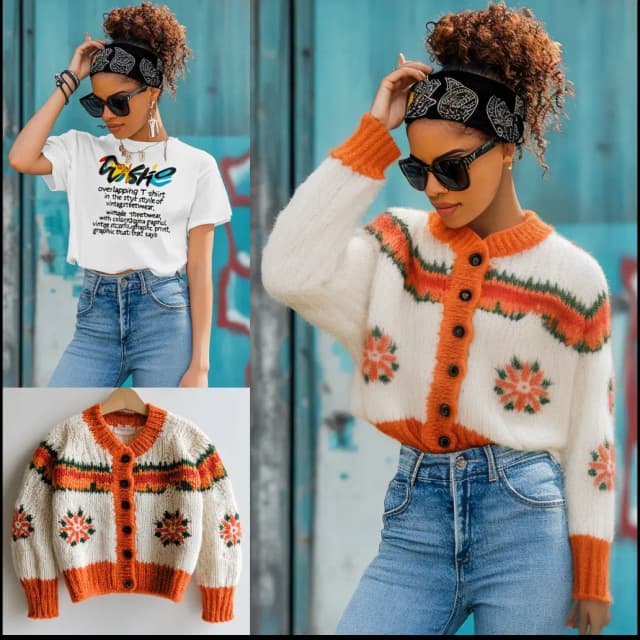
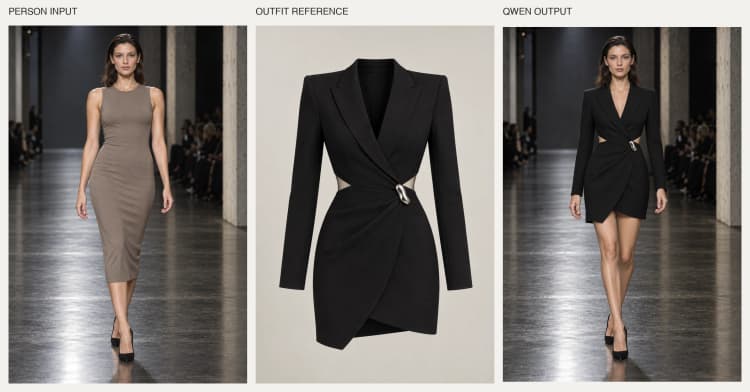
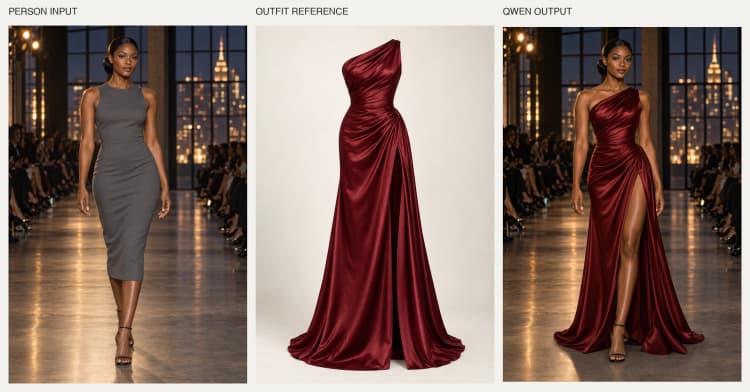
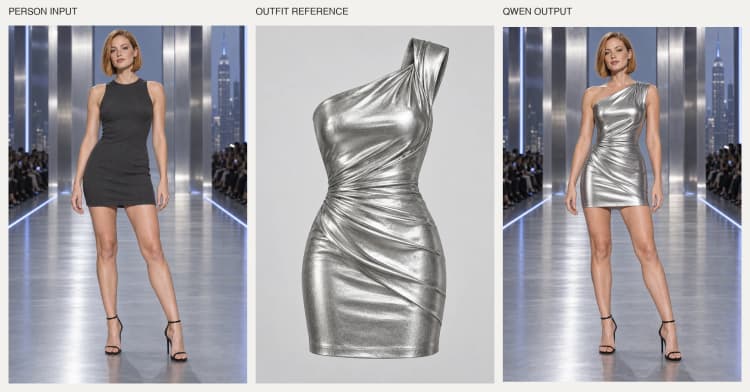
Qwen Image 2.1 服裝更換 ComfyUI 工作流程從服裝參考圖像轉移服裝到第二張圖像中的人物,並由簡短的指令指導。它旨在保留圖像1中的主體、姿勢、面部、背景和相機構圖,同時借用圖像2的輪廓、顏色和紋理,生成單一的真實照片。
該工作流程基於統一的 Qwen-Image-2.1 模型和提示增強設計,旨在用於虛擬造型、時尚編輯、電子商務模型和衣櫥可視化。您提供圖像1(人物)、圖像2(服裝)和簡明提示;管道為您處理多模態條件、生成和解碼。
ComfyUI Qwen Image 2.1 服裝更換 ComfyUI 工作流程中的關鍵模型#
- Qwen-Image-2.1。統一的視覺-語言和圖像生成模型,它解釋您的指令以及兩張圖像,然後驅動擴散過程以合成最終的服裝更換。模型卡
- Qwen-Image-2.1 VAE。變分自編碼器,將圖像編碼為潛在變量以進行條件化,並將取樣器的輸出解碼回RGB,保留細緻的布料細節和顏色保真度。權重隨 ComfyUI 包提供。權重
- Qwen-Image-2.1 文本編碼器。捆綁的 Qwen-VL 系列文本編碼器,將您的指令和視覺上下文轉換為擴散骨幹可遵循的條件。隨 ComfyUI 權重提供。權重
如何使用 ComfyUI Qwen Image 2.1 服裝更換 ComfyUI 工作流程#
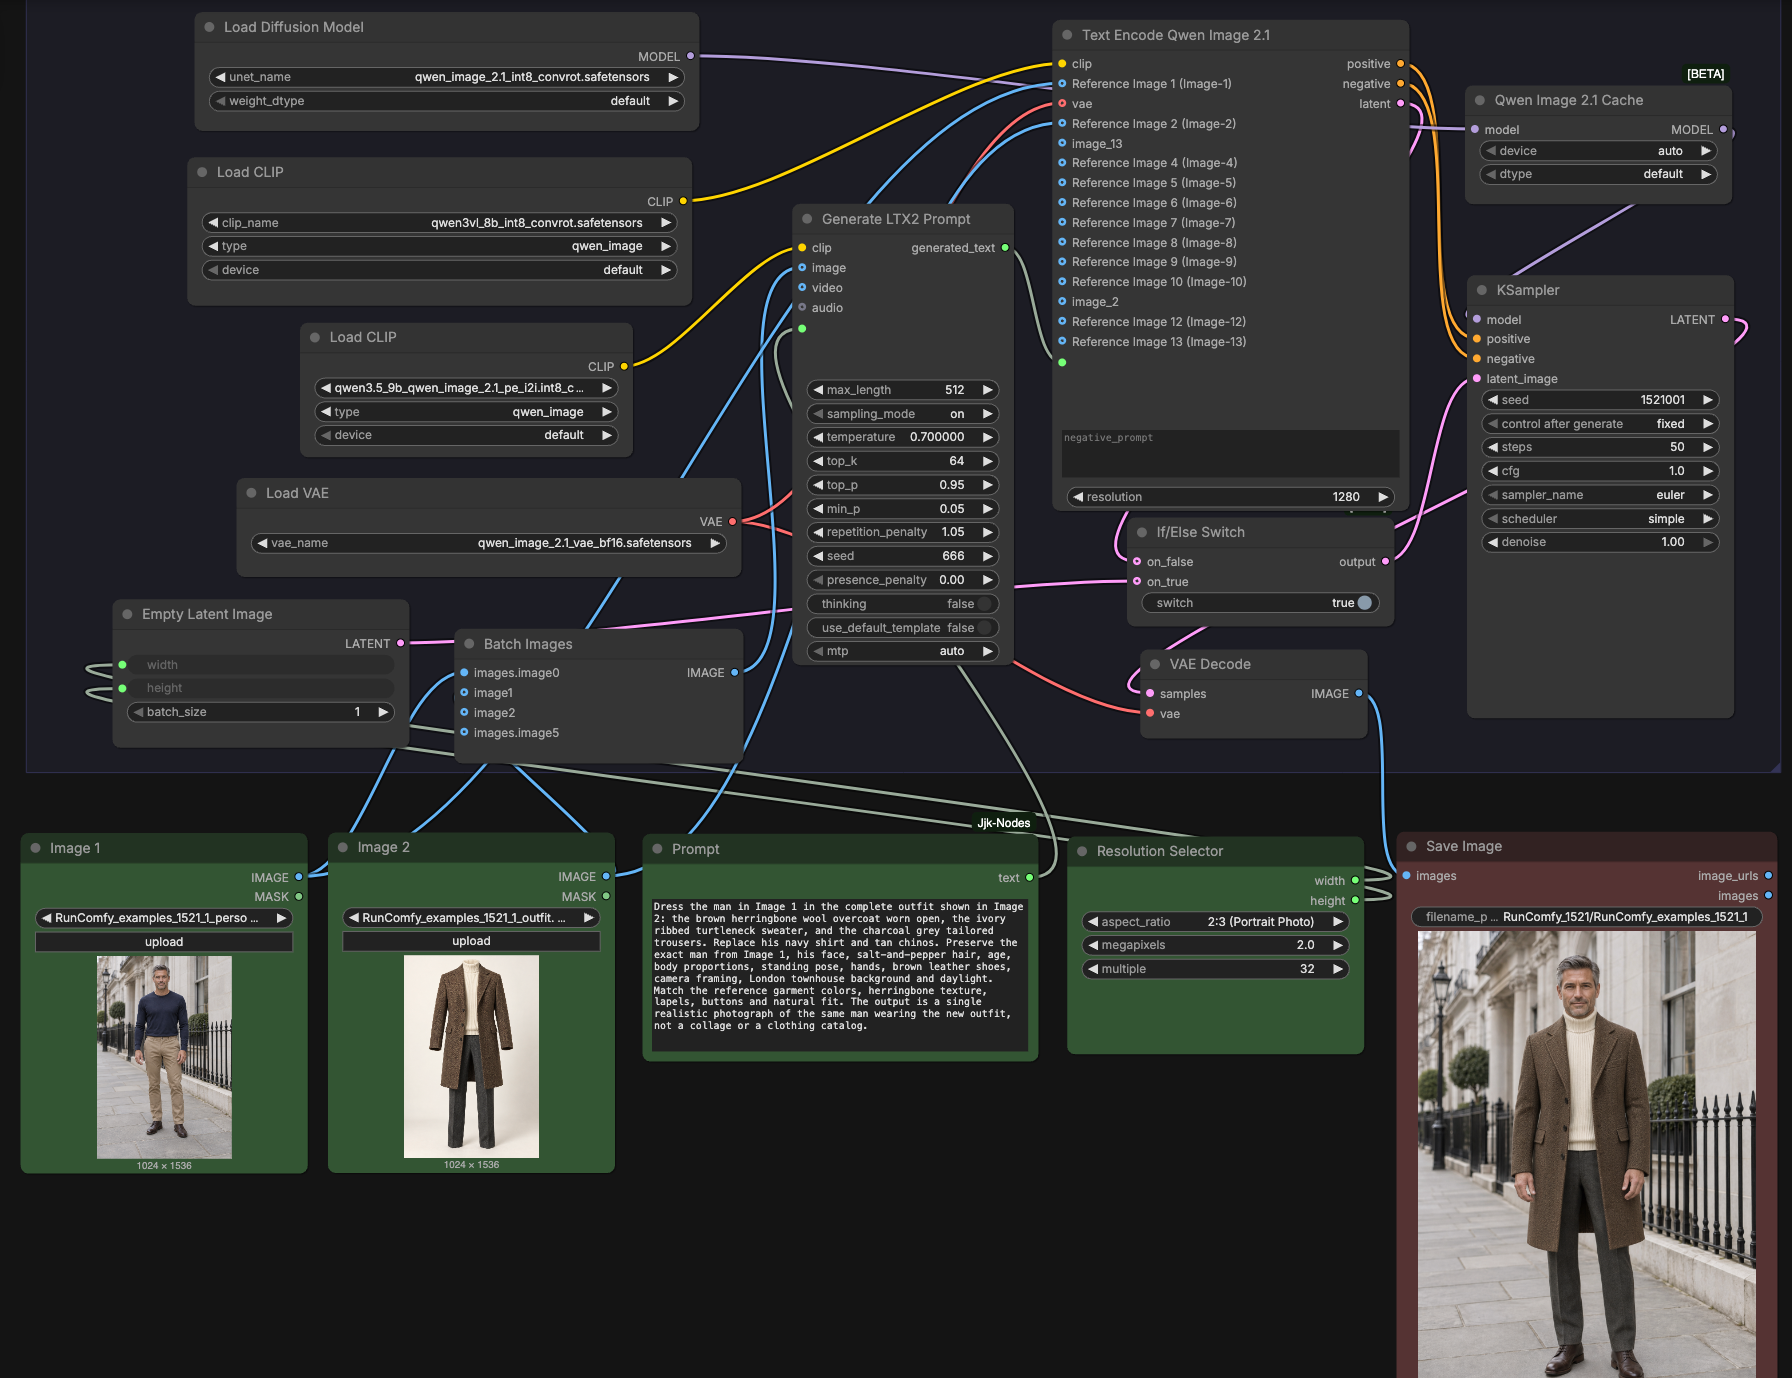
此工作流程作為一個單一組運行,攝取兩張圖像加上一個文本指令,使用兩個視覺豐富提示,為 Qwen-Image-2.1 構建多模態條件,然後取樣並解碼最終圖像。
Qwen Image 2.1 服裝更換組#
此組合將圖像1(待重新設計的人物)與圖像2(服裝參考)及您的指令配對,然後通過提示增強和 Qwen-Image-2.1 條件化進行路由。管道保留圖像1的身份和場景,同時轉移圖像2的服裝輪廓、顏色和布料特徵。它在您選擇的分辨率上創建潛在畫布,使用 Qwen-Image-2.1 模型取樣,並解碼為準備保存的圖像。使用此組進行端到端的服裝更換,設置最小。
LoadImage (#470) 圖像1#
在此加載來源人物照片。選擇一張單一、構圖良好的照片,清晰可見您想保留的主體和姿勢。圖像同時供應給提示增強器和 Qwen-Image-2.1 編碼器,以便在生成過程中保留身份、姿勢和背景。
LoadImage (#510) 圖像2#
在此加載服裝參考。選擇一個清晰可見服裝輪廓和紋理的視圖。這個參考信息提示增強過程並成為編碼器視覺條件的一部分,以便顏色、布料和服裝結構準確轉移。
JjkText (#516) 提示#
撰寫一個簡短的指令,告訴模型要交換什麼以及要保留什麼。提到要從圖像2轉移的服裝件,並明確指出要保留圖像1的身份、姿勢和背景。保持具體和簡潔,以獲得更強的遵從性。
BatchImagesNode (#505)#
此工具將圖像1和圖像2結合起來供提示增強器使用。它確保增強器在重新措辭您的指令時看到兩個視覺,這改善了最終提示中的服裝命名、顏色術語和布料描述。
TextGenerateLTX2Prompt (#502)#
通過同時閱讀兩張圖像和您的文本生成一個精緻的、對模型友好的指令。結果是一個單一的增強提示字符串,捕捉服裝屬性、合身和場景保留提示。此字符串作為最終指令下游傳遞。
CLIPLoader (#500) 和 CLIPLoader (#478)#
這些節點加載由增強器和主編碼器使用的 Qwen-Image-2.1 文本編碼器。它們將您精煉的指令標記化,並準備與從兩張圖像中提取的視覺特徵對齊的語言嵌入。
TextEncodeQwenImage21 (#485)#
從圖像1、圖像2、精煉提示和 VAE 構建 Qwen-Image-2.1 的多模態條件。它發出正面和負面條件以及可選的初始潛在變量,可以錨定構圖和佈局。這是服裝轉移的核心,對齊語言和兩張圖像,然後進行取樣。
ResolutionSelector (#13)#
選擇生成的輸出寬度和高度。選擇與目標構圖匹配的長寬比,然後設置整體尺寸。選擇驅動取樣期間使用的潛在畫布。
EmptyLatentImage (#480) 和 ComfySwitchNode (#483)#
在選擇的分辨率上創建一個新的潛在畫布,並讓您在從這個空白潛在開始或從編碼器的潛在開始之間切換。使用開關以便在更強的服裝轉移(空白潛在)或更緊密保留圖像1的構圖(編碼器潛在)之間進行選擇。
UNETLoader (#477) 和 QwenImage21Cache (#484)#
加載並準備 Qwen-Image-2.1 擴散骨幹以進行高效取樣。緩存保持模型狀態在運行間準備就緒,減少迭代期間的開銷。
KSampler (#482)#
使用 Qwen-Image-2.1 模型和早先生成的條件運行擴散過程。它在平衡遵循圖像2的服裝和保留圖像1的身份和場景上解釋您的指令。結果是一個準備解碼的潛在圖像。
VAEDecode (#481) 和 SaveImage (#518)#
用 Qwen-Image-2.1 VAE 將最終潛在解碼回 RGB 圖像,然後使用您選擇的文件名前綴保存。保存的輸出是一張將圖像1中的主體穿上圖像2服裝的單一連貫照片。
ComfyUI Qwen Image 2.1 服裝更換 ComfyUI 工作流程中的關鍵節點#
TextEncodeQwenImage21 (#485)#
此節點將圖像1、圖像2、您精煉的指令和 VAE 融合為 Qwen-Image-2.1 骨幹可遵循的條件。調整 prompt 和可選的 negative_prompt 以引導服裝細節與場景保留。resolution 輸入確定編碼器的工作範圍,應與您選擇的輸出尺寸一致。請參閱模型卡以了解行為上下文。Qwen/Qwen-Image-2.1
ComfySwitchNode (#483)#
控制取樣的起點。保持 switch 開啟以從新的潛在開始,以更強的服裝採用,或關閉它以在您希望鎖定圖像1的構圖或姿勢時重用編碼器的潛在。切換它以探索不同的身份與服裝取捨,而不需要重寫您的提示。
KSampler (#482)#
管理模型對指令和參考的遵循程度。使用 denoise 平衡服裝強度與基礎圖像的保留,並調整 cfg、sampler_name、steps 和 seed 以獲得風味、銳度和可重複性。有關 ComfyUI 中取樣行為的一般指導,請參考項目存儲庫。ComfyUI
ResolutionSelector (#13)#
設置您的輸出尺寸。當您希望背景和裁剪保持穩定時,將長寬比匹配到您的輸入照片的構圖,或更改它以重新組合拍攝。較大的尺寸捕捉更多的布料紋理,但需要更多的計算。
可選附加項#
- 使用高質量的輸入:清晰、正面光照的圖像1和清晰、無遮擋的圖像2可產生更好的輪廓和紋理轉移。
- 在您的指令中明確指出:命名服裝件、顏色、紋理以及必須從圖像1保留的內容。
- 若要保持構圖、面部和背景幾乎與圖像1相同,切換到編碼器潛在並通過
denoise降低整體侵略性。 - 當圖像2的服裝非常不同時,為了更強的風格接管,從新的潛在開始,保持提示簡潔具體。
- 改變
seed以探索不同選項而不改變您的設置,然後鎖定您喜歡的選項以獲得可重複的結果。
模型資源鏈接
- Qwen-Image-2.1 模型卡: https://huggingface.co/Qwen/Qwen-Image-2.1
- ComfyUI 權重包(UNet、VAE、文本編碼器):https://huggingface.co/Comfy-Org/Qwen-Image-2.1
致謝#
此工作流程實施並構建於以下工作和資源之上。我們誠摯感謝 Qwen 提供的 Qwen-Image-2.1 模型和發布,Comfy-Org 提供的 ComfyUI Qwen-Image-2.1 權重,以及 Wendy Wu 提供的源工作流程的貢獻和維護。欲獲得權威的詳細信息,請參考下列鏈接的原始文檔和存儲庫。
資源#
- Wendy Wu/Source 工作流程
- 文檔 / 發布說明: runninghub.ai post
- Qwen/Qwen-Image-2.1
- GitHub: QwenLM/Qwen-Image-2.1
- Hugging Face: Qwen/Qwen-Image-2.1
- Comfy-Org/ComfyUI Qwen-Image-2.1 權重
- GitHub: Comfy-Org/workflow_templates
- Hugging Face: Comfy-Org/Qwen-Image-2.1
- Qwen/Qwen-Image-2.1 發布
- 文檔 / 發布說明: Qwen blog
注意:引用模型、數據集和代碼的使用受其作者和維護者提供的相應許可和條款的約束。