MOSS-Image Layout-Guided Text to Image 用於海報和產品視覺效果#
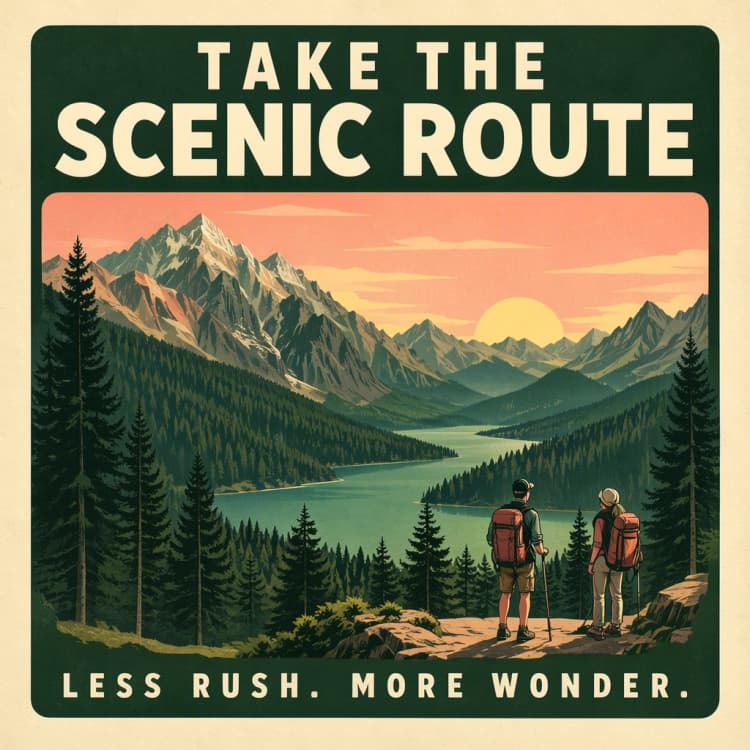
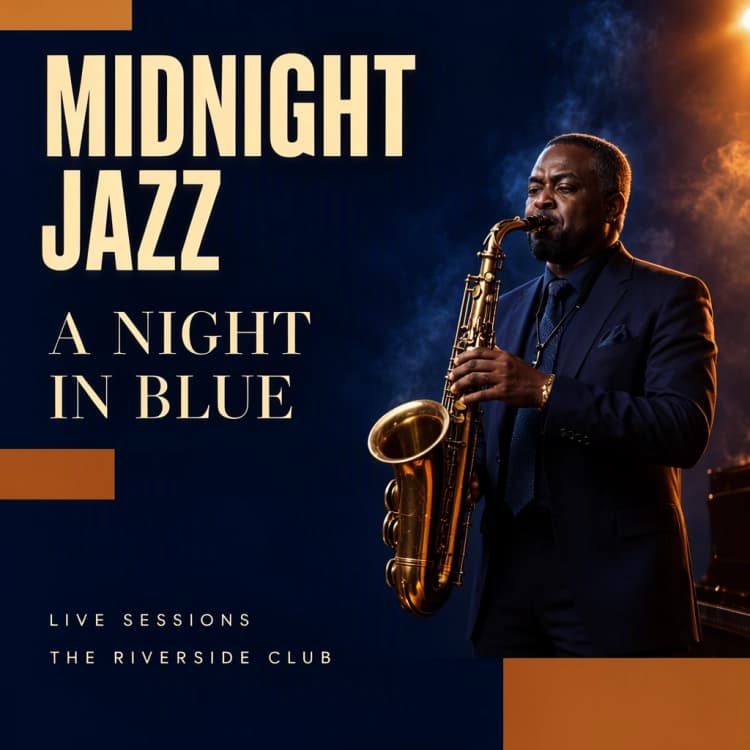
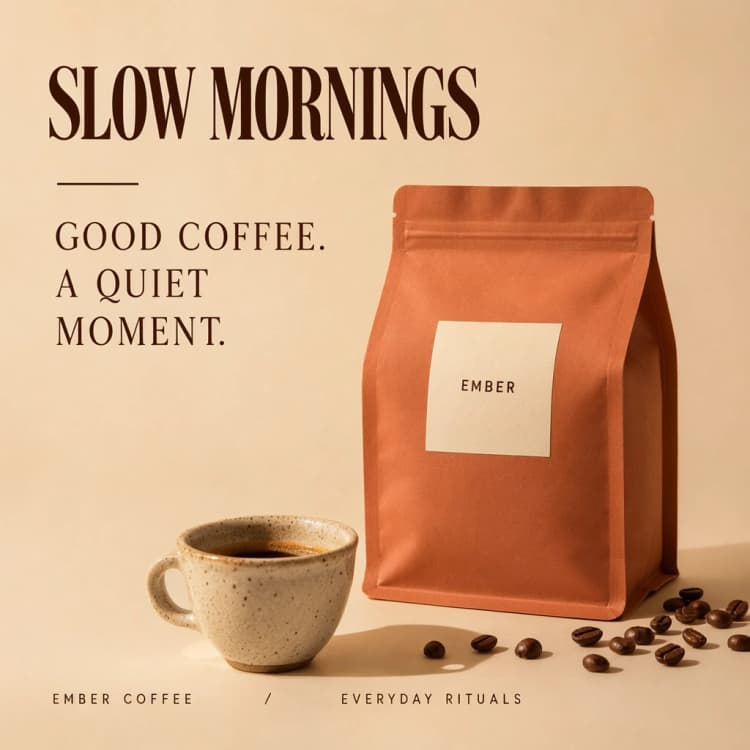
這個 ComfyUI 工作流程使用 MOSS-Image 將結構化布局轉換為完成的圖像。它讓您可以用邊界框計劃字體設計和物體位置,然後渲染出尊重您構圖的乾淨、可讀的設計。MOSS-Image Layout-Guided Text to Image 方法非常適合宣傳藝術作品、產品主圖和插圖旅行海報,這些地方文本層次和焦點尤為重要。
工作流程默認禁用提示升頻器,以保留結構化布局提示。您可以控制文本和物體的位置,MOSS-Image 會填充每個區域的請求內容和樣式。為了可靠的易讀性,偏好簡短、間隔良好的行,而不是密集的小字,這是 MOSS-Image Layout-Guided Text to Image 生成的一般最佳做法。
Comfyui MOSS-Image Layout-Guided Text to Image 工作流程中的關鍵模型#
- MOSS-Image SFT 擴散模型。監督微調的檢查點提供布局感知生成和強大的雙語文本渲染。這是此工作流程使用的核心圖像生成器。Model card
- Qwen 3.5 9B GPTQ 文本編碼器。此編碼器解釋您的標題和布局提示,使模型理解內容和字體設計意圖。權重與 MOSS-Image 在同一存儲庫中分發。Repository
- FLUX.2 小型 VAE。此解碼器從潛在變量中重建高質量圖像,同時保持清晰的邊緣,有助於可讀的字體和清晰的形狀。Repository
- MOSS-Image 技能和參考提示。官方項目記錄了模型訓練遵循的標題風格和布局提示。Project
- 官方布局模板。參考模板顯示了此處使用的相同布局驅動模式,用於 MOSS-Image Layout-Guided Text to Image。Template
如何使用 Comfyui MOSS-Image Layout-Guided Text to Image 工作流程#
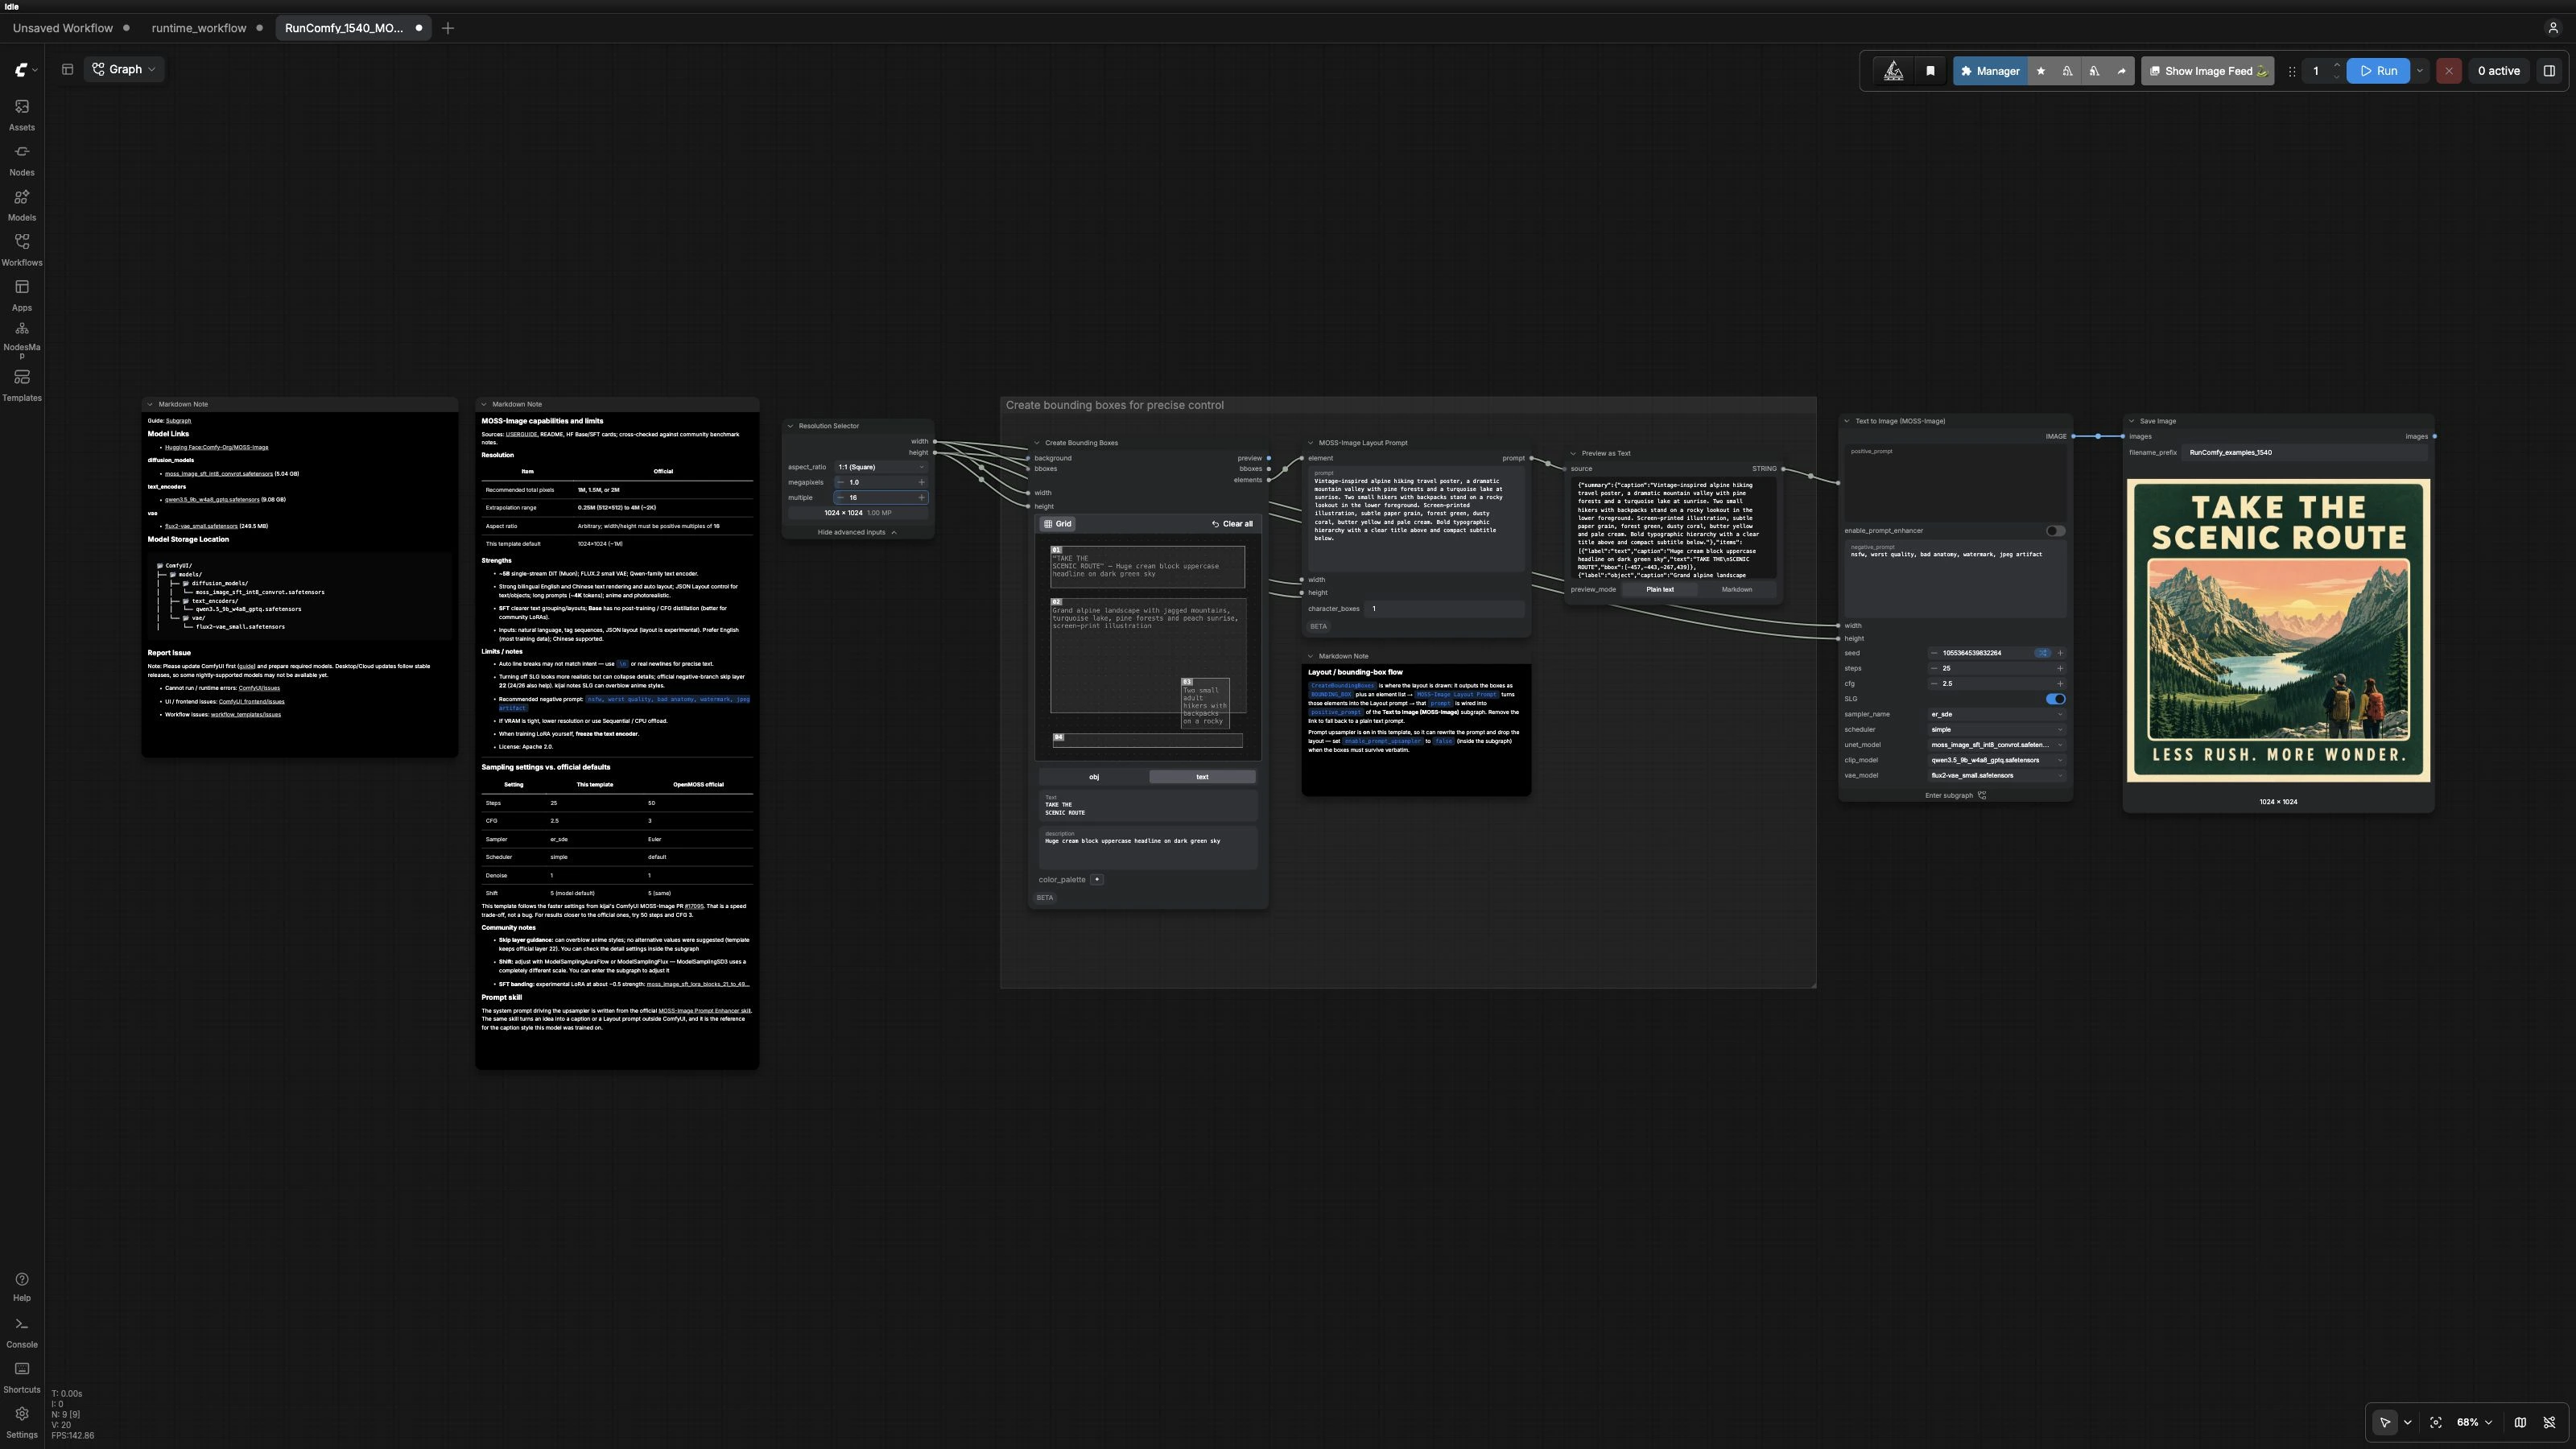
在高層次上,您定義畫布大小,為文本和物體繪製邊界框,將這些框轉換為結構化布局提示,然後生成最終圖像。邊界框組首先運行,然後布局提示提供給 MOSS-Image 生成器,產生您的結果。
設置畫布大小 (ResolutionSelector (#19))#
選擇您的設計的寬高比和分辨率。節點輸出寬度和高度,這些會傳播到布局工具和生成器,保持同步。為了獲得 MOSS-Image Layout-Guided Text to Image 的最佳效果,從接近 1 百萬像素的速度開始,一旦您喜歡構圖就放大。寬度和高度必須是 16 的倍數。
創建精確控制的邊界框 (CreateBoundingBoxes (#25))#
直接在畫布上繪製文本和物體區域,並在需要的地方添加簡短文本。每個框攜帶其角色、可選文本和引導應出現內容的簡短視覺描述。將這些描述視為每個區域的微提示。保持標題簡潔,並在需要出現的位置添加手動換行。
將框轉換為布局提示 (MOSSImageLayoutPrompt (#27))#
此節點將您的元素轉換為 MOSS-Image 理解的單一結構化布局提示。它將區域描述與您的全局樣式描述合併,以便模型知道內容的位置。使用生動但具體的語言描述調色板、媒介和情緒。如果您計劃嚴格的層次結構,請清楚描述,以便布局提示編碼該意圖。
檢查最終的正面提示 (PreviewAny (#26))#
在渲染之前預覽組裝的布局提示。這是檢查每個預期文本行是否被引用以及區域描述是否有意義的最佳位置。在此處緊密調整措辭,以獲得更可靠的 MOSS-Image Layout-Guided Text to Image 結果。如果看到不需要的措辭,調整框或全局樣式行,然後再次預覽。
生成圖像 (Text to Image (MOSS-Image) (#18))#
子圖加載 MOSS-Image SFT 模型,編碼最終提示,並將潛在變量採樣為圖像。默認情況下,工作流程禁用提示增強器,以便布局提示直接通過。如果您不使用框並希望模型闡述您的想法,請啟用增強器,讓 MOSS-Image 更自由地重寫標題。跳過層指導在子圖內可用,以強調結構;當您需要更緊密的文本放置或更自然的外觀時,可以切換它。
保存結果 (SaveImage (#9))#
您的圖像由 FLUX.2 VAE 解碼並寫入磁盤。用不同的種子重新運行,以探索保持相同布局的變化。當構圖有效時,增加分辨率以獲得生產質量的導出。
Comfyui MOSS-Image Layout-Guided Text to Image 工作流程中的關鍵節點#
CreateBoundingBoxes (#25) 這是布局創作表面。用它來定義具有簡短、具體描述的文本和物體區域。短而間隔良好的文本提高了可靠性,顯式換行控制換行。保持框圍繞文本寬鬆,以避免模型渲染字形時發生碰撞。
MOSSImageLayoutPrompt (#27) 它將每個框組合成單一結構化提示,生成器尊重它。將全局樣式視為藝術指導,而每個框的文本或物體註釋視為局部約束。如果需要精確的布局保真度,請保持提示增強器禁用,以免重寫丟失您的布局指令。
ComfySwitchNode (#16) 此開關選擇原始布局提示和內置標題技能生成的增強提示之間。關閉它以保護布局引導的指令。只有當您想要自由的標題擴展且不依賴邊界框進行嚴格放置時,才打開它。開關影響驅動整個渲染的正面提示。
SkipLayerGuidanceDiTSimple (#15) 此指導路徑可以強調結構和可讀性。當您想要更清晰的文本分組或更強的布局依從性時使用它,特別是在海報中。如果您偏好更柔和、更具攝影感的效果,請嘗試禁用它,並在提示中使用風格化措辭進行補償。
KSampler (#7) 這是對採樣的全局質量和速度控制。更多步驟往往會細化細節和文本邊緣,而更強的指導如果推得過高可能會過度限制風格。謹慎調整這些,並在相同分辨率下評估變化,以便您可以公平地比較結果。
ResolutionSelector (#19) 畫布大小驅動布局網格和模型的潛在變量。選擇適合目標媒介的大小,並記住更高的分辨率會消耗更多的 VRAM 和時間。由於框隨畫布縮放,您可以在較小尺寸下快速迭代,然後再放大。
可選附加功能#
- 保持可見文本簡短,並添加手動換行以預測換行。
- 避免指定真實字體名稱;描述字體感覺,如塊狀襯線、緊湊無襯線或等寬。
- 用自然術語定義有限的調色板,以幫助模型保持一致的品牌外觀。
- 如果您想要不帶布局的純文本到圖像,請斷開布局提示線,並啟用增強器以獲得更豐富的標題。
- 對於高級用戶,MOSS-Image 的社區 LoRAs 存在於樣式調整中。根據您的使用情況仔細評估它們。
致謝#
此工作流程實施並基於以下作品和資源。我們感謝 Comfy-Org 提供的 MOSS-Image ComfyUI 教程、Comfy-Org 提供的官方布局工作流程模板以及 OpenMOSS 提供的 MOSS-Image 模型的貢獻和維護。欲了解詳細信息,請參閱下方鏈接的原始文檔和存儲庫。
資源#
- Comfy-Org/MOSS-Image ComfyUI 教程
- GitHub: OpenMOSS/MOSS-Image
- Hugging Face: Comfy-Org/MOSS-Image
- arXiv: MOSS-Image Technical Report
- Docs / Release Notes: MOSS-Image in ComfyUI: Text-to-Image and Layout Workflows
- Comfy-Org/Official layout workflow template
- GitHub: image_moss_image_t2i_bboxes.json
- Comfy-Org/MOSS-Image model files
- Hugging Face: Comfy-Org/MOSS-Image
注意:使用引用的模型、數據集和代碼需遵循其作者和維護者提供的相應許可和條款。