logo
RunComfy
  • ComfyUI
  • TrainerNuovo
  • Modelli
  • API
  • Prezzi
discord logo
MODELLI
Esplora
Tutti i modelli
LIBRERIA
Generazioni
API DEI MODELLI
Documentazione API
Chiavi API
ACCOUNT
Utilizzo

WAN 2.2 LoRA testo in immagine con dimensioni e formato | RunComfy

wan-ai/wan-2-2/lora/text-to-image

Trasforma il testo in immagine e imposta LoRA, dimensioni, formato e seed.

Descrivi soggetto, azione, ambiente, inquadratura e direzione visiva desiderata.
LoRA #1
URL o ID repository Hugging Face (owner/repo) dei pesi LoRA.
Scegli `high`, `low` o `both`; il valore predefinito è `both`.
Intensità di applicazione da 0 a 4; il valore predefinito è 1.
Elenco obbligatorio di massimo 3 LoRA; ogni percorso può essere un URL o l’ID di un repository Hugging Face.
Scegli una delle 7 dimensioni, inclusa `Custom`; il valore predefinito è `square_hd`.
Scegli `png` o `jpeg`; il valore predefinito è `jpeg`.
Seed intero da 10000 a 99999.
Idle
The rate is $0.05 per image.

WAN 2.2 LoRA da testo a immagine

Questa pagina da testo a immagine usa un prompt e un elenco LoRA obbligatorio di massimo 3 elementi. Per ogni LoRA è possibile impostare percorso, destinazione (high, low o both) e intensità da 0 a 4.

Le dimensioni disponibili sono square_hd, square, portrait_4_3, portrait_16_9, landscape_4_3, landscape_16_9, Custom. Il formato di output può essere png o jpeg; è inoltre disponibile un seed da 10000 a 99999.

Modelli correlati

ltx-2-19b/image-to-video/lora

Trasforma immagini statiche in clip dinamiche ed espressive con audio sincronizzato.
kling-2-5/turbo/text-to-video

Crea un video con Kling 2.5 Turbo da un prompt e scegli durata, proporzioni e prompt negativo.
fantasy-portrait/image-to-video

Trasforma un ritratto e un video di riferimento in un'animazione espressiva guidata da un prompt di testo richiesto.

kling-video-o3/4K/reference-to-video

Generazione cinematografica 4K da riferimenti a $0.419 per secondo di output.

hunyuan-video-v1.5/image-to-video

Anima un’immagine con un prompt per creare un video di 5 o 8 secondi in 480p o 720p.

aurora

Genera un video da un’immagine, un file audio e un prompt, con controllo separato del testo e dell’audio.

Domande Frequenti

Che cosa fa WAN 2.2 LoRA in questa pagina?

Genera un’immagine da un prompt di testo e applica i LoRA selezionati.

Quali input sono obbligatori?

prompt e loras sono obbligatori; l’elenco accetta al massimo 3 LoRA.

Quali impostazioni ha ogni LoRA?

Percorso, destinazione (high, low o both) e intensità da 0 a 4; i valori predefiniti sono both e 1.

Quali dimensioni immagine sono disponibili?

square_hd, square, portrait_4_3, portrait_16_9, landscape_4_3, landscape_16_9, Custom; il valore predefinito è square_hd.

A cosa serve `Custom`?

Custom è una delle dimensioni selezionabili.

Quali formati immagine sono disponibili?

png e jpeg; il valore predefinito è jpeg.

Qual è l’intervallo del seed?

seed va da 10000 a 99999; il valore predefinito è 74965.

Seguici
  • LinkedIn
  • Facebook
  • Instagram
  • Twitter
Supporto
  • Discord
  • Email
  • Stato del Sistema
  • affiliato
Modelli Video
  • Kling 4.0 Image to Video
  • Kling 4.0 Reference to Video
  • Kling 4.0 Video Editing
  • Wan 3.0
  • Wan 2.5
  • MiniMax H3 Fast
  • Visualizza tutti i modelli →
Modelli Immagine
  • Seedream 4.5
  • Seedream 5.0 Pro
  • Flux 2 Pro
  • Qwen Image Edit 2511 LoRA
  • seedream 4.0
  • Nano Banana Pro
  • Visualizza tutti i modelli →
Legale
  • Termini di Servizio
  • Informativa sulla Privacy
  • Informativa sui Cookie
RunComfy
Copyright 2026 RunComfy. Tutti i Diritti Riservati.

RunComfy è la piattaforma principale ComfyUI che offre ComfyUI online ambiente e servizi, insieme a workflow di ComfyUI con visuali mozzafiato. RunComfy offre anche AI Models, consentire agli artisti di sfruttare gli ultimi strumenti di AI per creare arte incredibile.
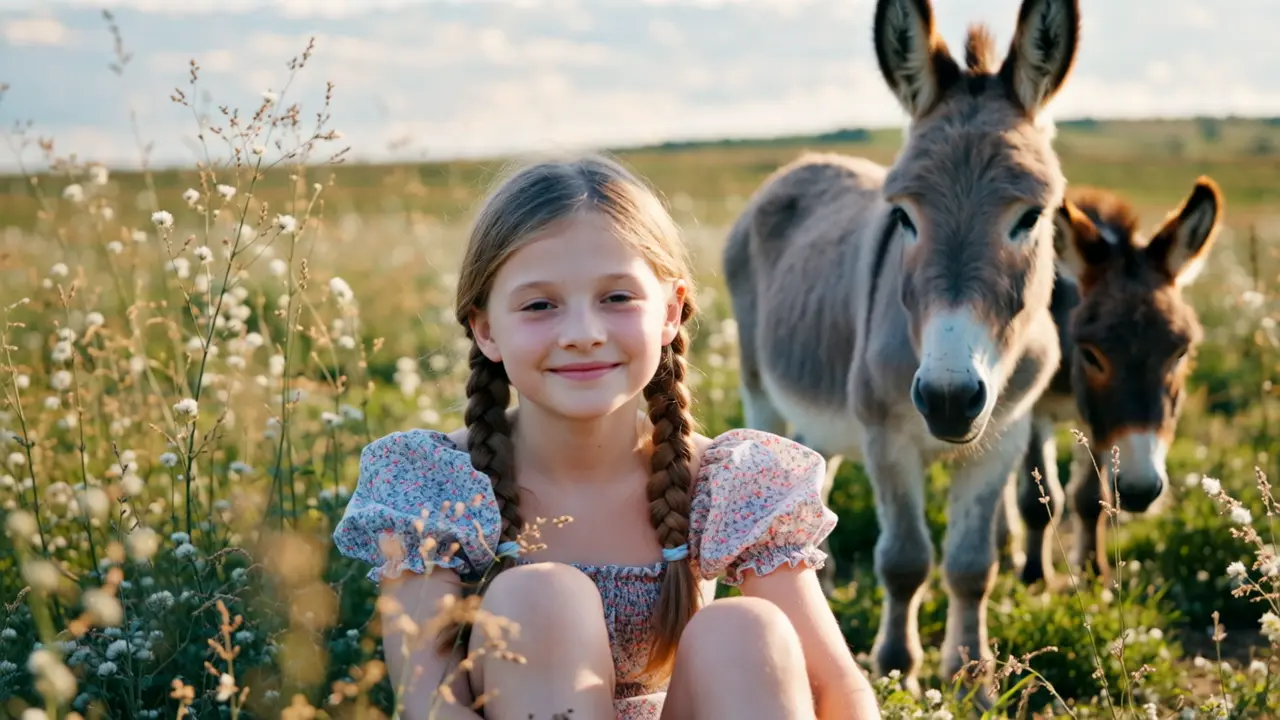
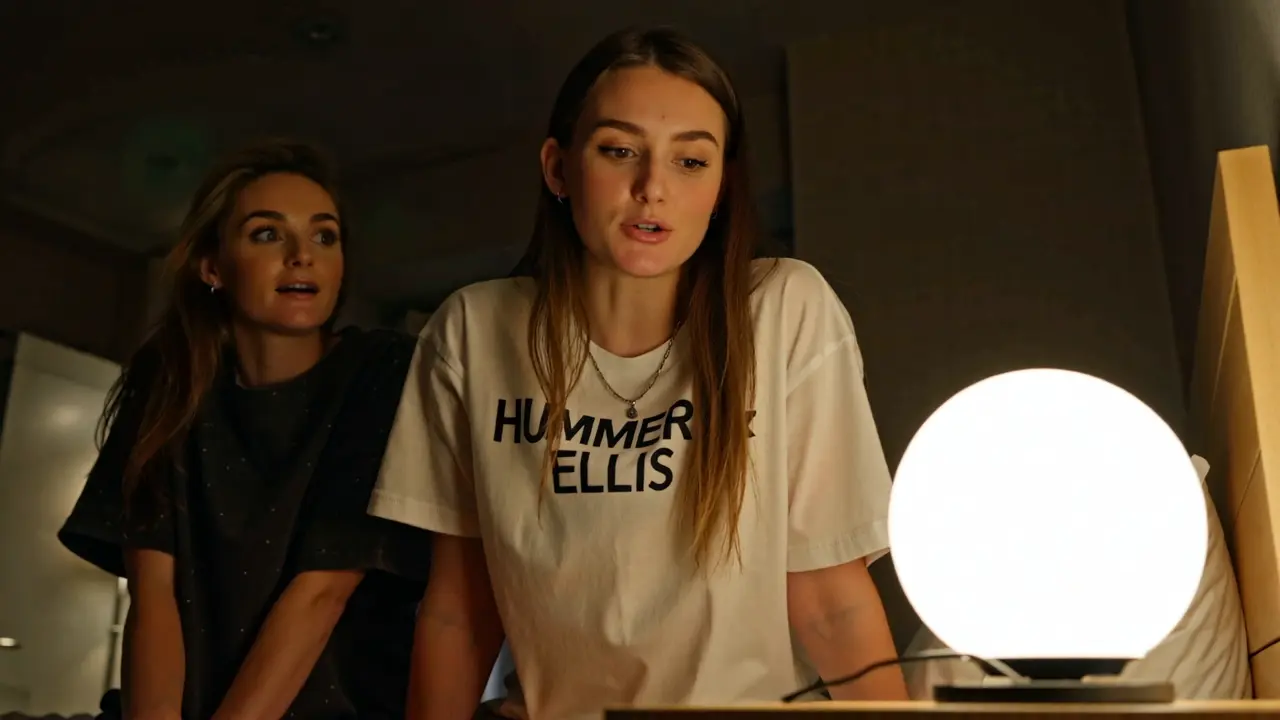
Esempi WAN 2.2 LoRA da testo a immagine