z-image/turbo/image-to-image
Trasforma un'immagine di input con prompt, intensità, dimensioni, passaggi di inferenza da 1 a 8, seed, espansione di prompt e output JPEG, PNG o WebP.
| Parameter | Type | Default/Range | Descrizione |
|---|---|---|---|
| image_url | string | Required | URL dell'immagine di input. |
| prompt | string | Optional | Linee guida per la struttura dei livelli e il contenuto dell'immagine. |
| negative_prompt | string | Optional | Elementi da escludere. |
| num_layers | integer | Default: 4; Range: 1-10 | Numero di livelli RGBA da generare. |
| num_inference_steps | integer | Default: 28; Range: 1-50 | Numero di passaggi di inferenza. |
| guidance_scale | float | Default: 5; Range: 1-20 | Quanto da vicino il risultato segue prompt. |
| seed | integer | Default: 0 | Valore seed costante per risultati ripetibili. |
| output_format | string | Options: png, webp; Default: png | Formato immagine in uscita; png è consigliato quando è necessario preservare la trasparenza. |
L'API RunComfy utilizza gli stessi campi dell'interfaccia del browser. image_url è obbligatorio; prompt e negative_prompt sono controlli opzionali. La risposta contiene le risorse del livello generate da utilizzare in un editor o in una pipeline automatizzata.
Endpoint API per Qwen Image Layered
Per modificare aree specifiche di un’immagine piatta, prova Qwen-Image-Edit-2509.
Trasforma un'immagine di input con prompt, intensità, dimensioni, passaggi di inferenza da 1 a 8, seed, espansione di prompt e output JPEG, PNG o WebP.

Genera da 1 a 4 immagini da un prompt obbligatorio, con 10 rapporti d’aspetto, risoluzione 1K, 2K o 4K, tre formati di file e restituzione sincrona facoltativa.
Genera con FLUX1.1 Pro Ultra immagini fotorealistiche fino a 2K.

Cambia l’angolazione di ripresa di un’immagine sorgente o applica un’altra modifica tramite un prompt obbligatorio. Puoi impostare sei dimensioni di output, i passaggi di inferenza, la scala di guida, da 1 a 4 risultati e l’output JPEG o PNG.

Crea immagini da testo con un massimo di tre adattatori LoRA e controlla dimensioni, pesi e seed.

Conversione da testo a immagine ad alta precisione per immagini raffinate e di livello produttivo.
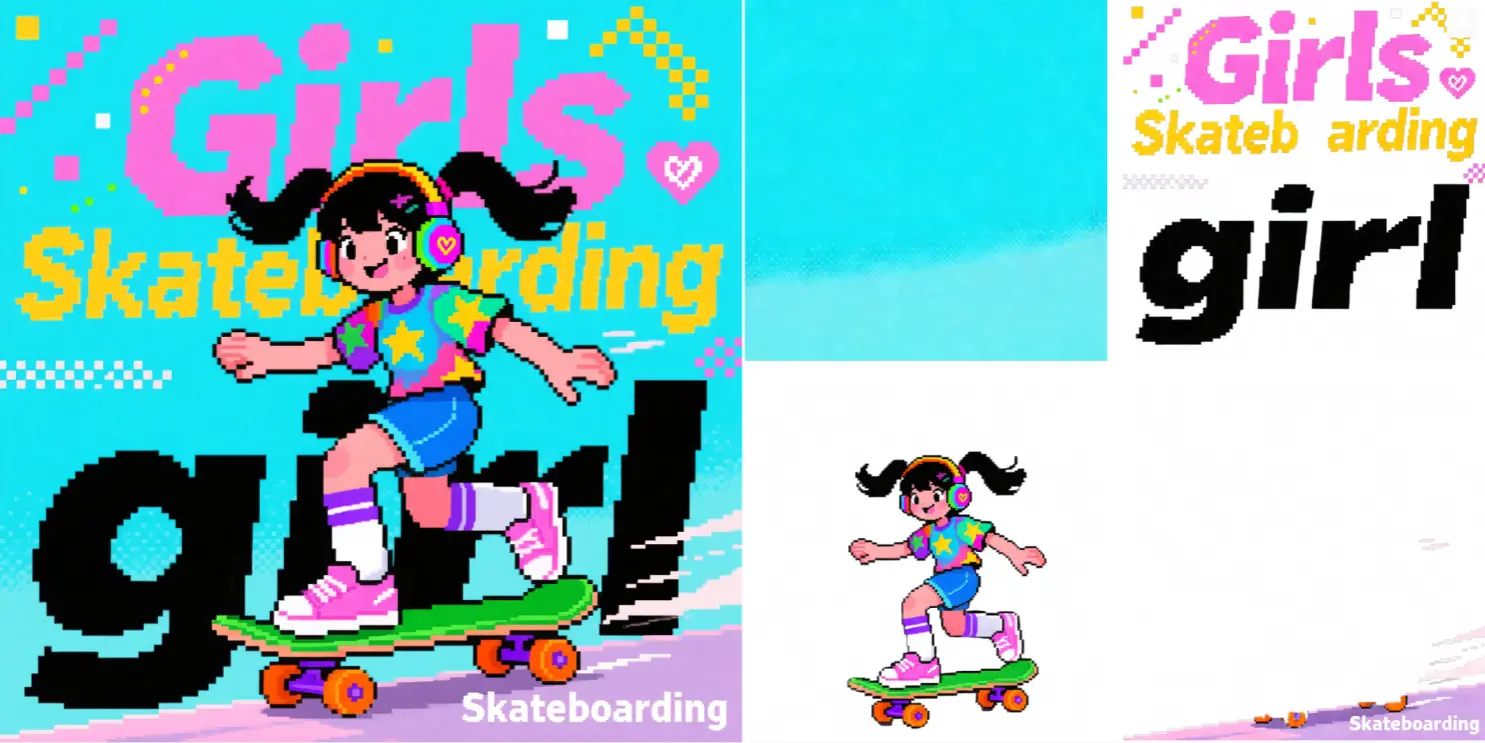
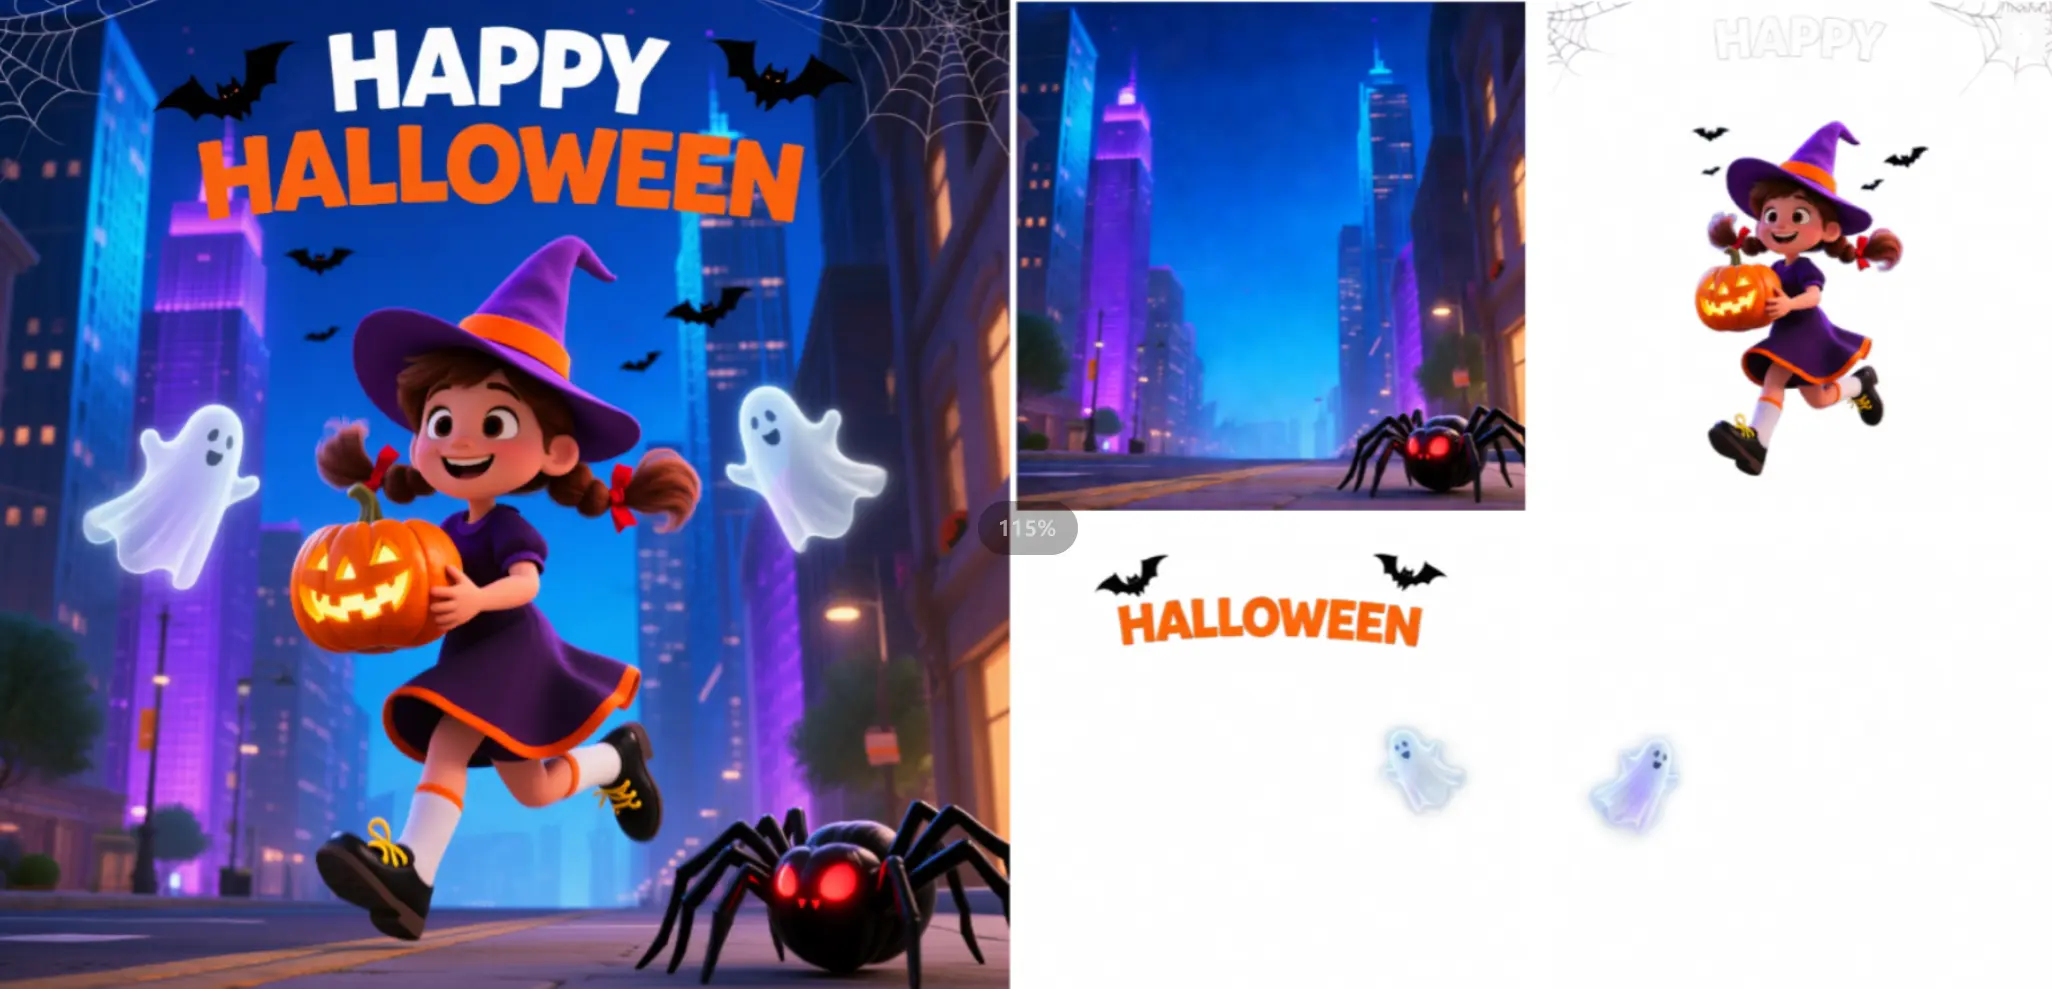
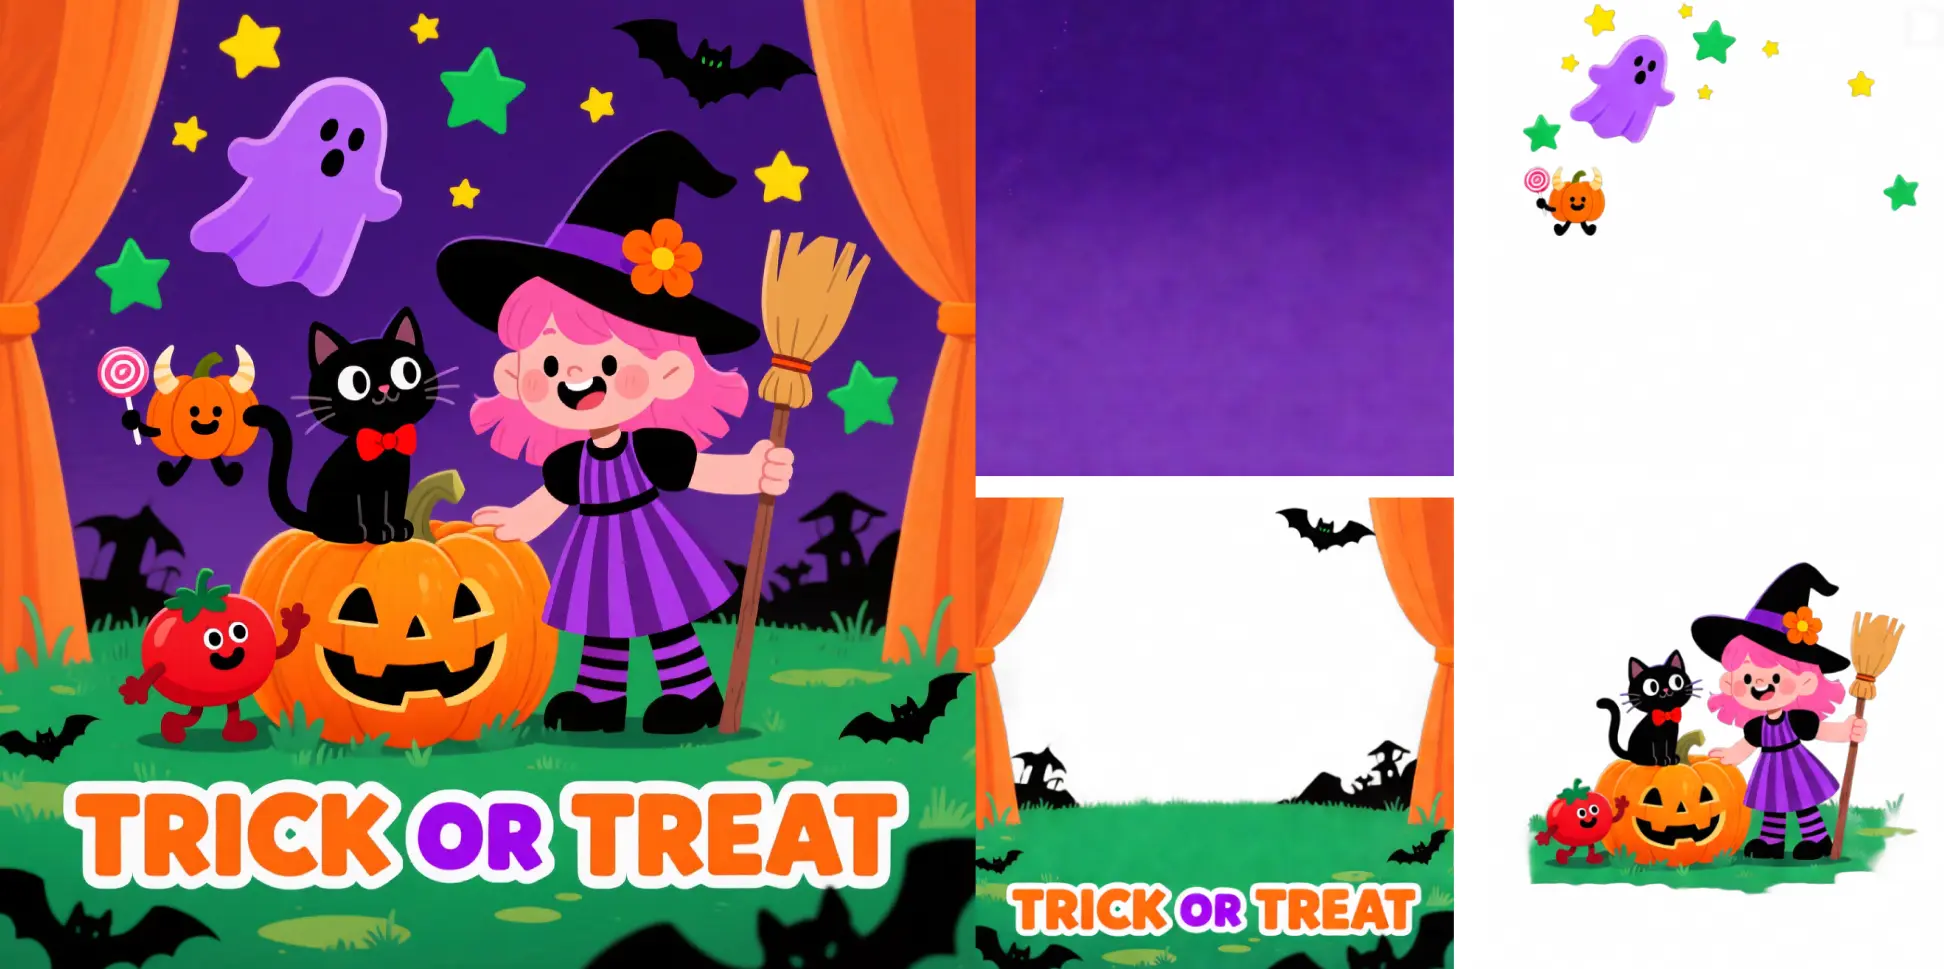
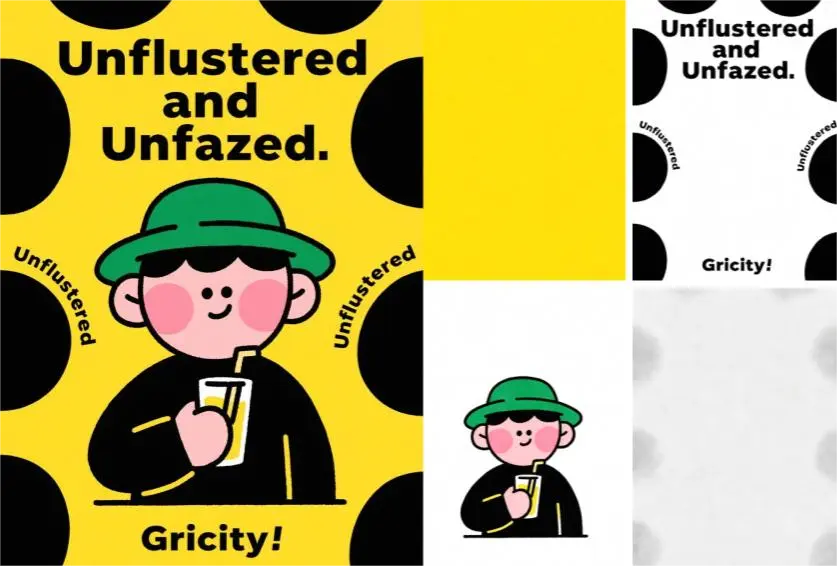
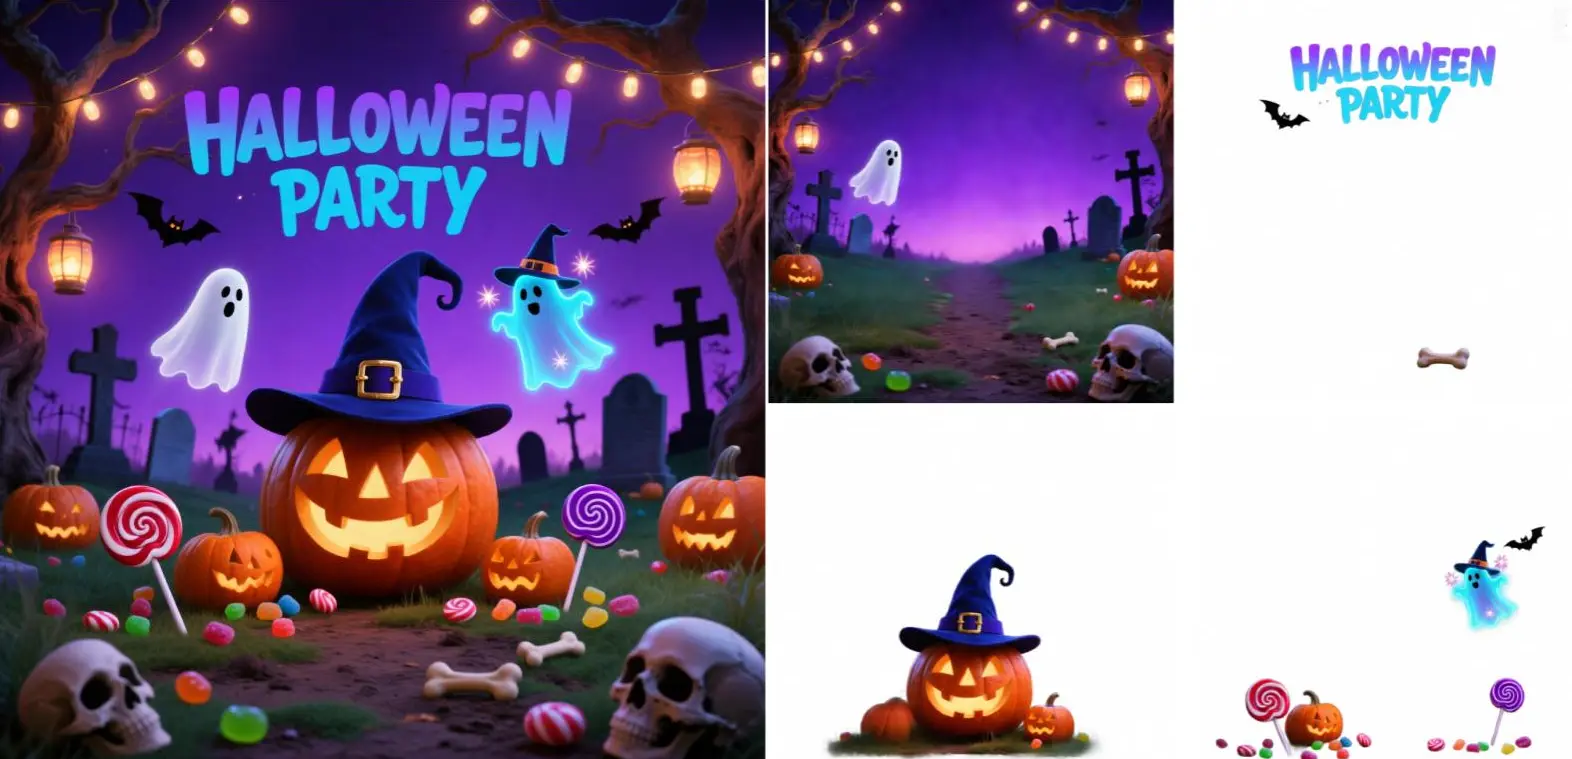
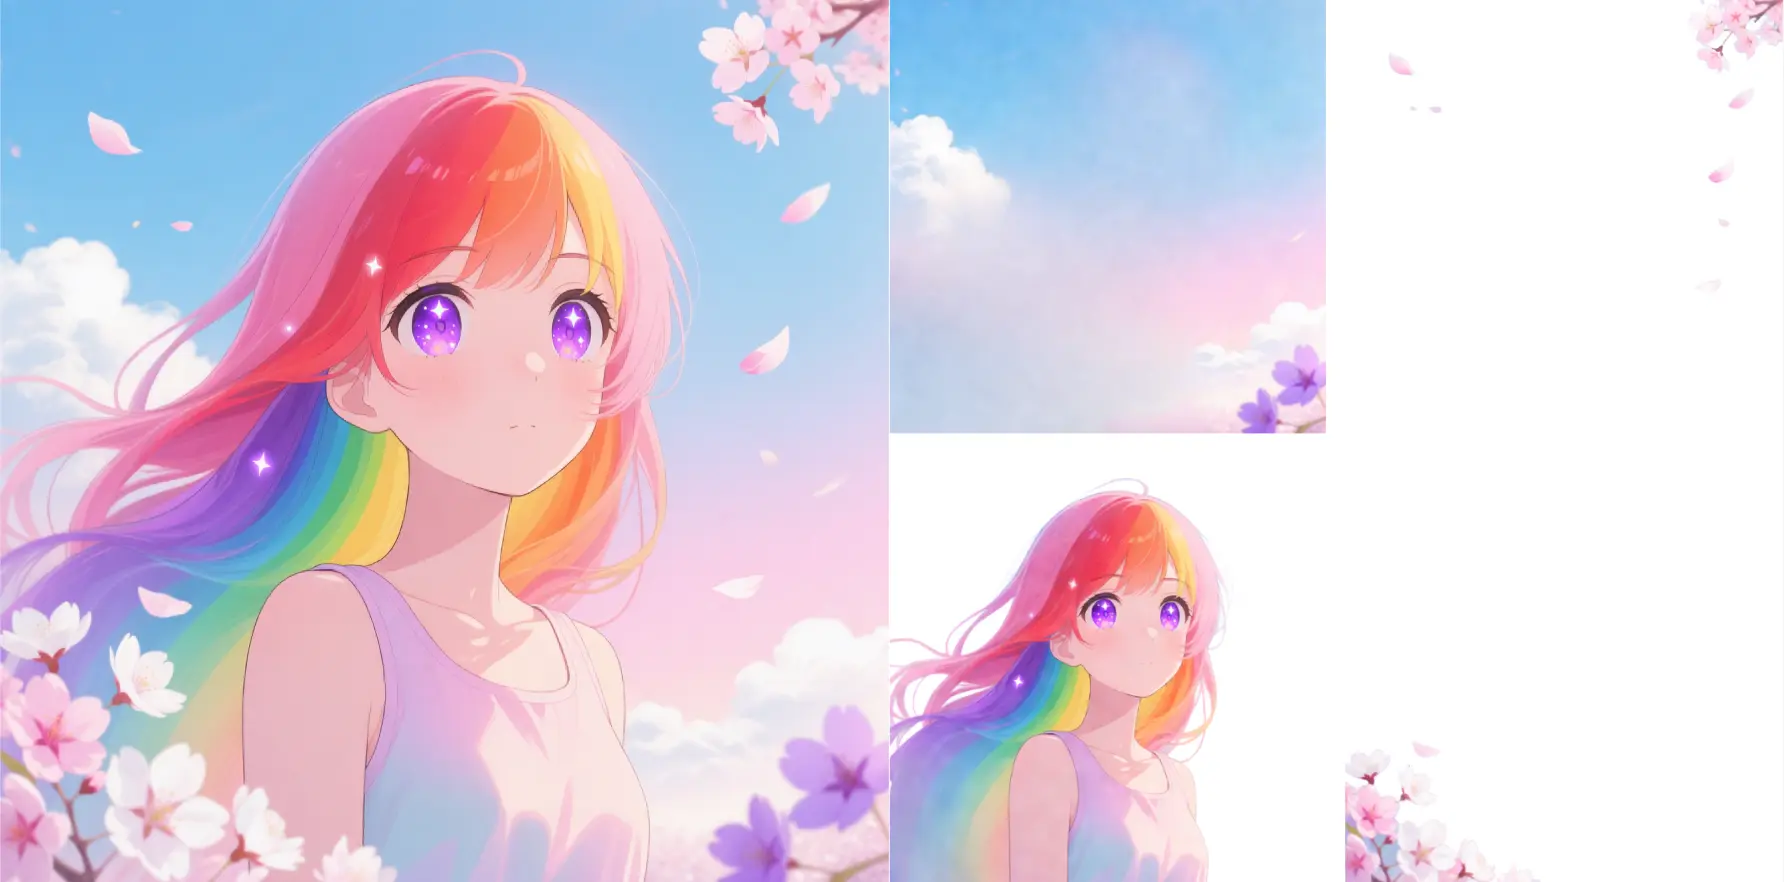
Decompone un'immagine di input in più livelli RGBA semanticamente separati. Ogni livello mantiene la trasparenza e può essere spostato, ricolorato, modificato o composto in modo indipendente.
Il modello è rilasciato con licenza Apache-2.0, che ne consente l'uso commerciale secondo i termini della licenza. Devi comunque avere i diritti sull'immagine in ingresso e rispettare qualsiasi proprietà intellettuale di terze parti nel contenuto.
num_layers varia da 1 a 10, num_inference_steps da 1 a 50 e guidance_scale da 1 a 20. L'endpoint non espone un'impostazione di risoluzione o un limite di token prompt.
Nessun input di questo tipo è esposto nello schema di questo endpoint. Richiede un image_url e facoltativamente accetta prompt e negative_prompt per guidare la scomposizione.
Testa le impostazioni nell'interfaccia del browser RunComfy, quindi utilizza l'endpoint API RunComfy del modello con gli stessi campi di input. image_url è obbligatorio; gli altri controlli esposti possono essere aggiunti secondo necessità.
La descrizione del modello pubblicata identifica una dorsale VLD-MMDiT con incorporamenti posizionali Layer3D RoPE, progettata per condividere il contesto tra livelli mantenendo separati gli elementi semantici.
Il suo RGBA-VAE rappresenta i dati RGB e RGBA in uno spazio latente condiviso. Ciò aiuta a produrre informazioni alfa coerenti per ciascun componente semantico in modo che i livelli possano essere modificati o compositi a valle.
Può separare le aree contenenti testo in livelli modificabili, ma l'esatta fedeltà del testo può variare in base all'input e alle impostazioni. Ispeziona la tipografia importante prima di utilizzare gli strati nella produzione.
Gli usi tipici includono l'isolamento degli oggetti, l'adattamento delle risorse del marchio, l'estrazione dei componenti dell'interfaccia utente, la sostituzione dello sfondo, la prototipazione del layout, la preparazione delle animazioni e la composizione degli effetti visivi.
Qwen Image Edit modifica le regioni selezionate di un'immagine piatta. Qwen Image Layered decompone invece un'immagine in più livelli RGBA, che è più adatto alla modifica e alla composizione ripetute a livello di livello.
RunComfy è la piattaforma principale ComfyUI che offre ComfyUI online ambiente e servizi, insieme a workflow di ComfyUI con visuali mozzafiato. RunComfy offre anche AI Models, consentire agli artisti di sfruttare gli ultimi strumenti di AI per creare arte incredibile.