OpenAI / GPT Image 2#
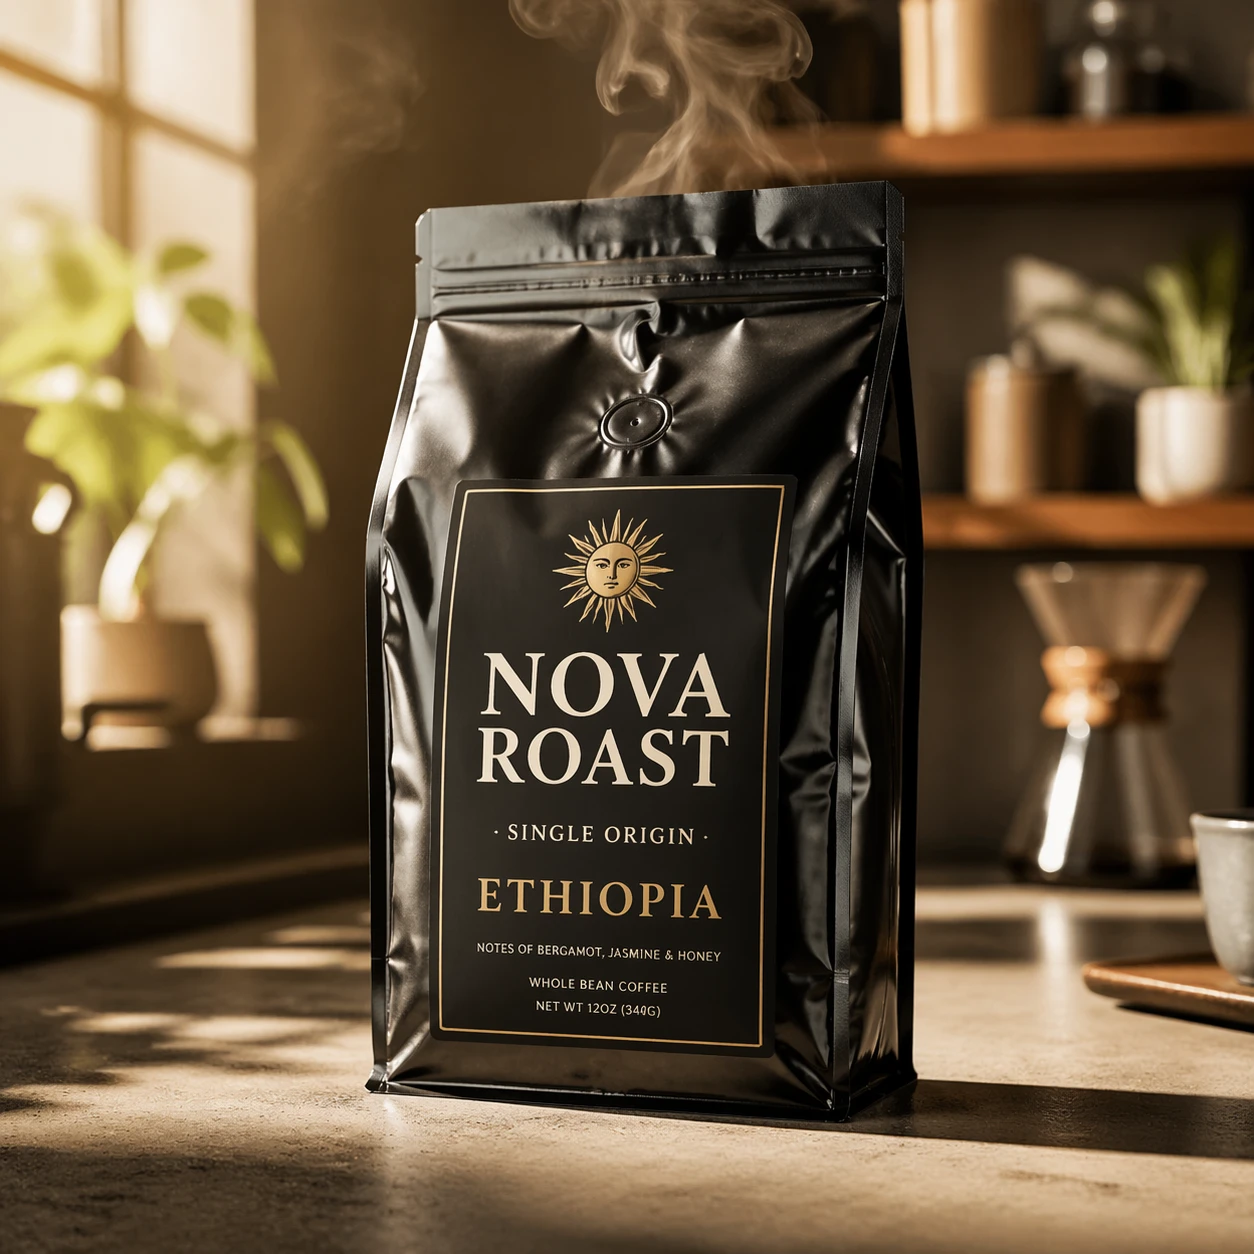
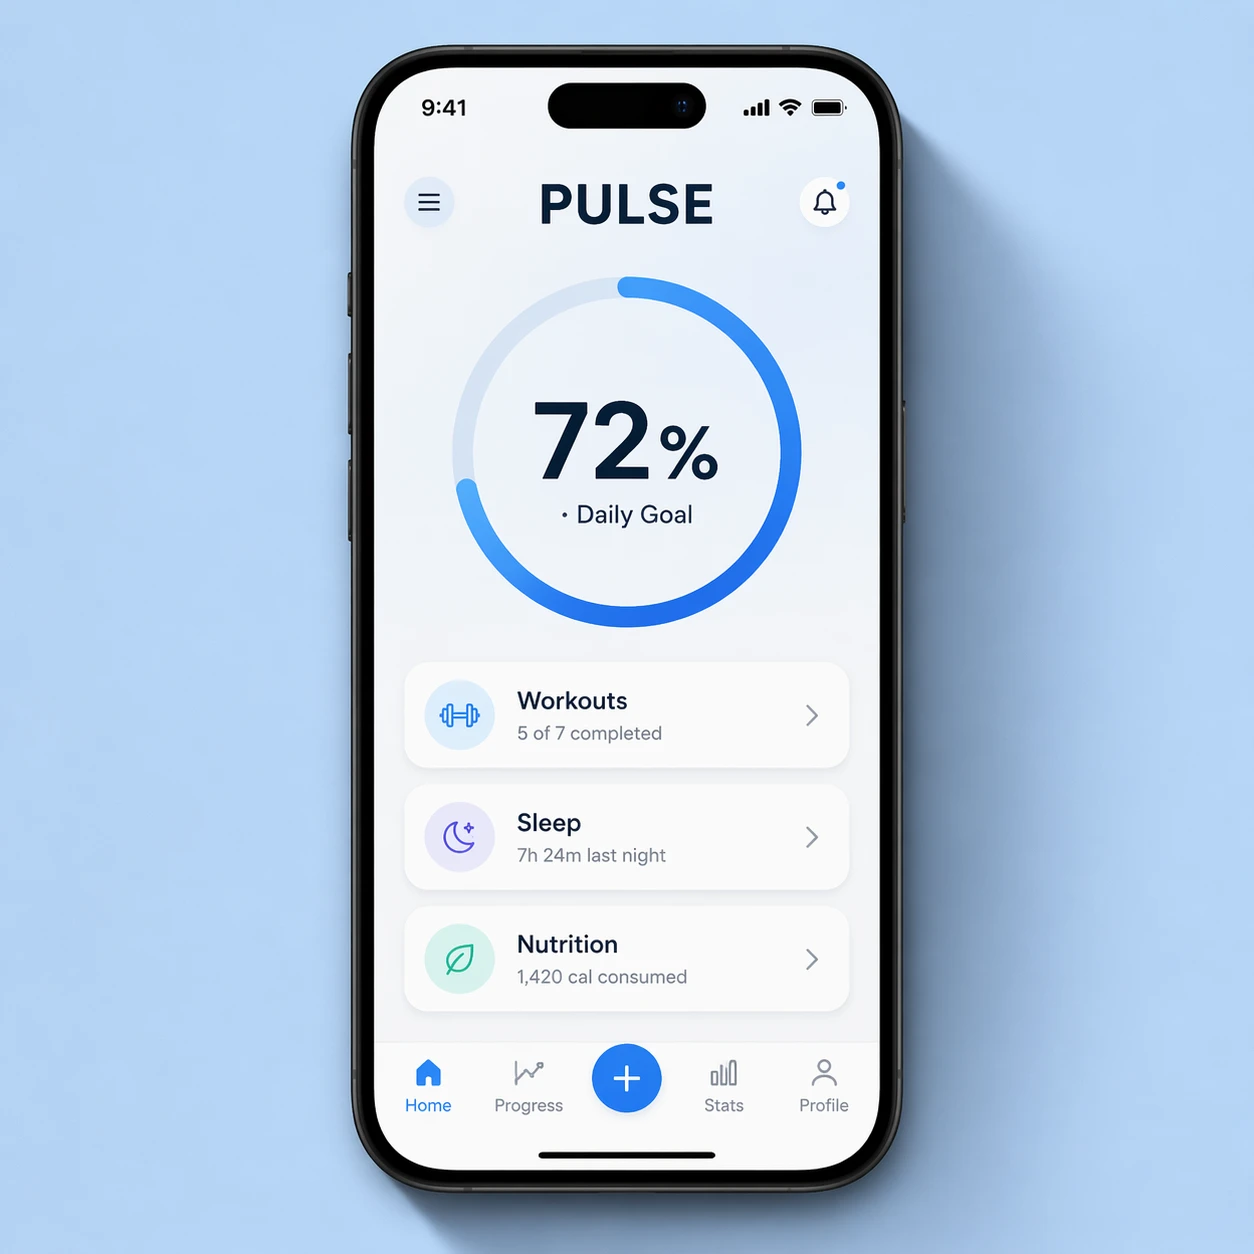
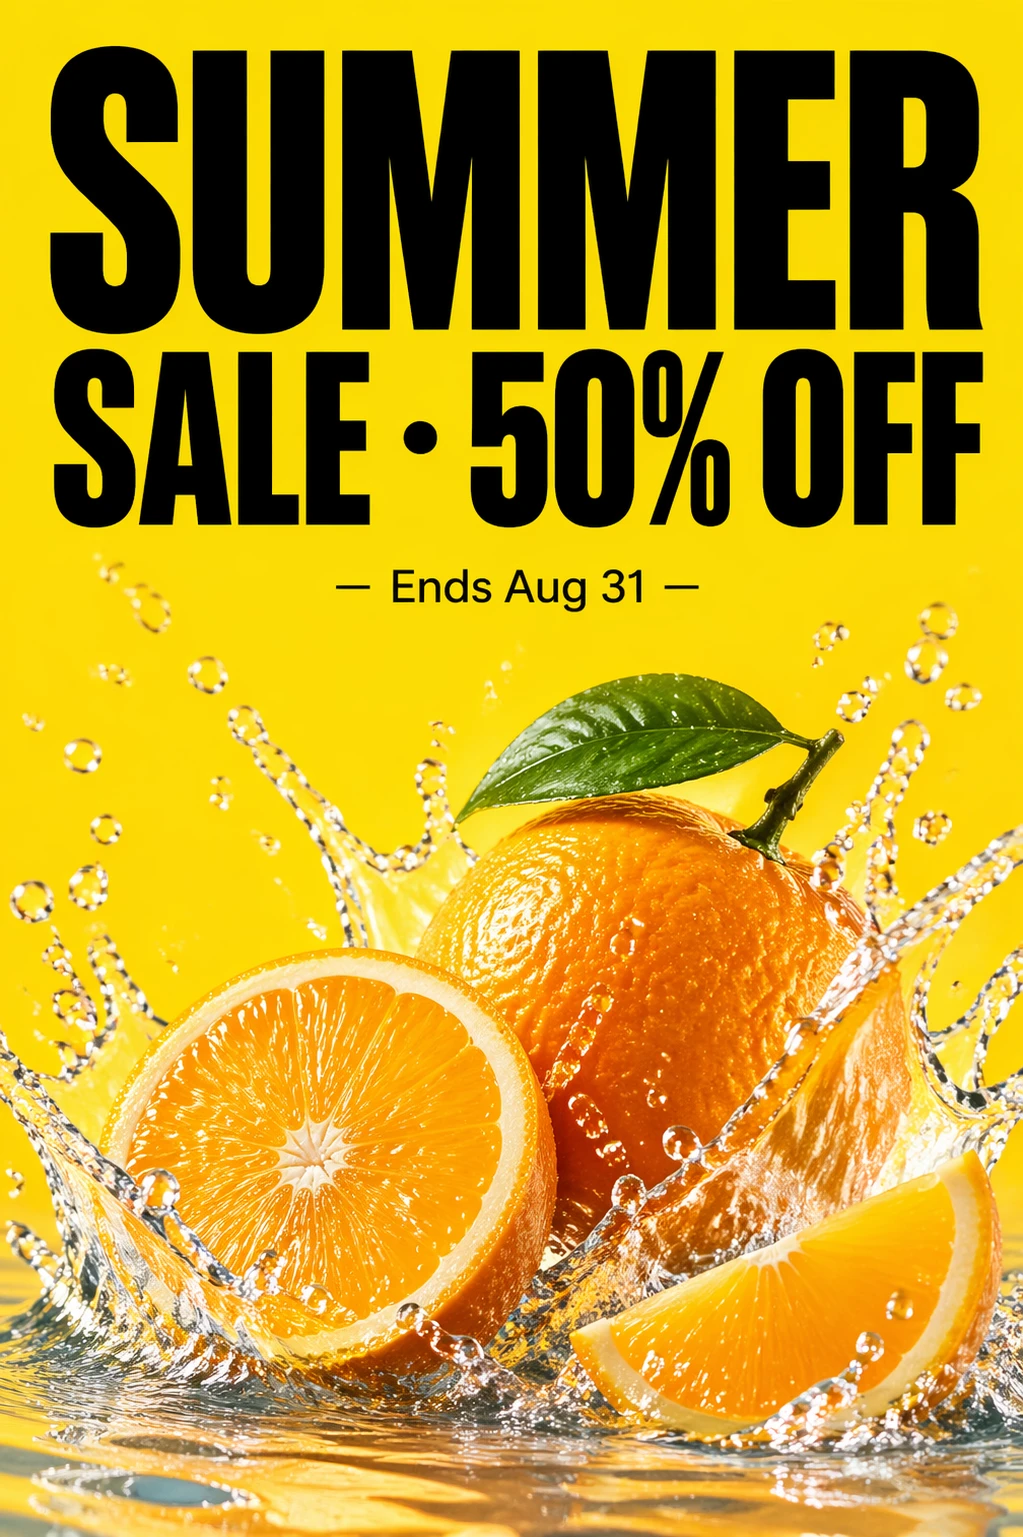
GPT Image 2 è un modello text-to-image di OpenAI che riceve un prompt scritto e restituisce un’immagine di alta qualità. Su RunComfy supporta risoluzione e proporzioni selezionabili, risultando adatto a mockup prodotto, visual di marketing, concept art ed esplorazione del design.
Formato di output: risoluzione 1K, 2K, 4K / fps: n/d / durata: n/d / proporzioni: 1:1, 3:2, 2:3, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 21:9 / audio: n/d
Funzionalità principali#
- Fedeltà alle istruzioni: GPT Image 2 segue bene prompt con più elementi, indicazioni di layout e vincoli stilistici.
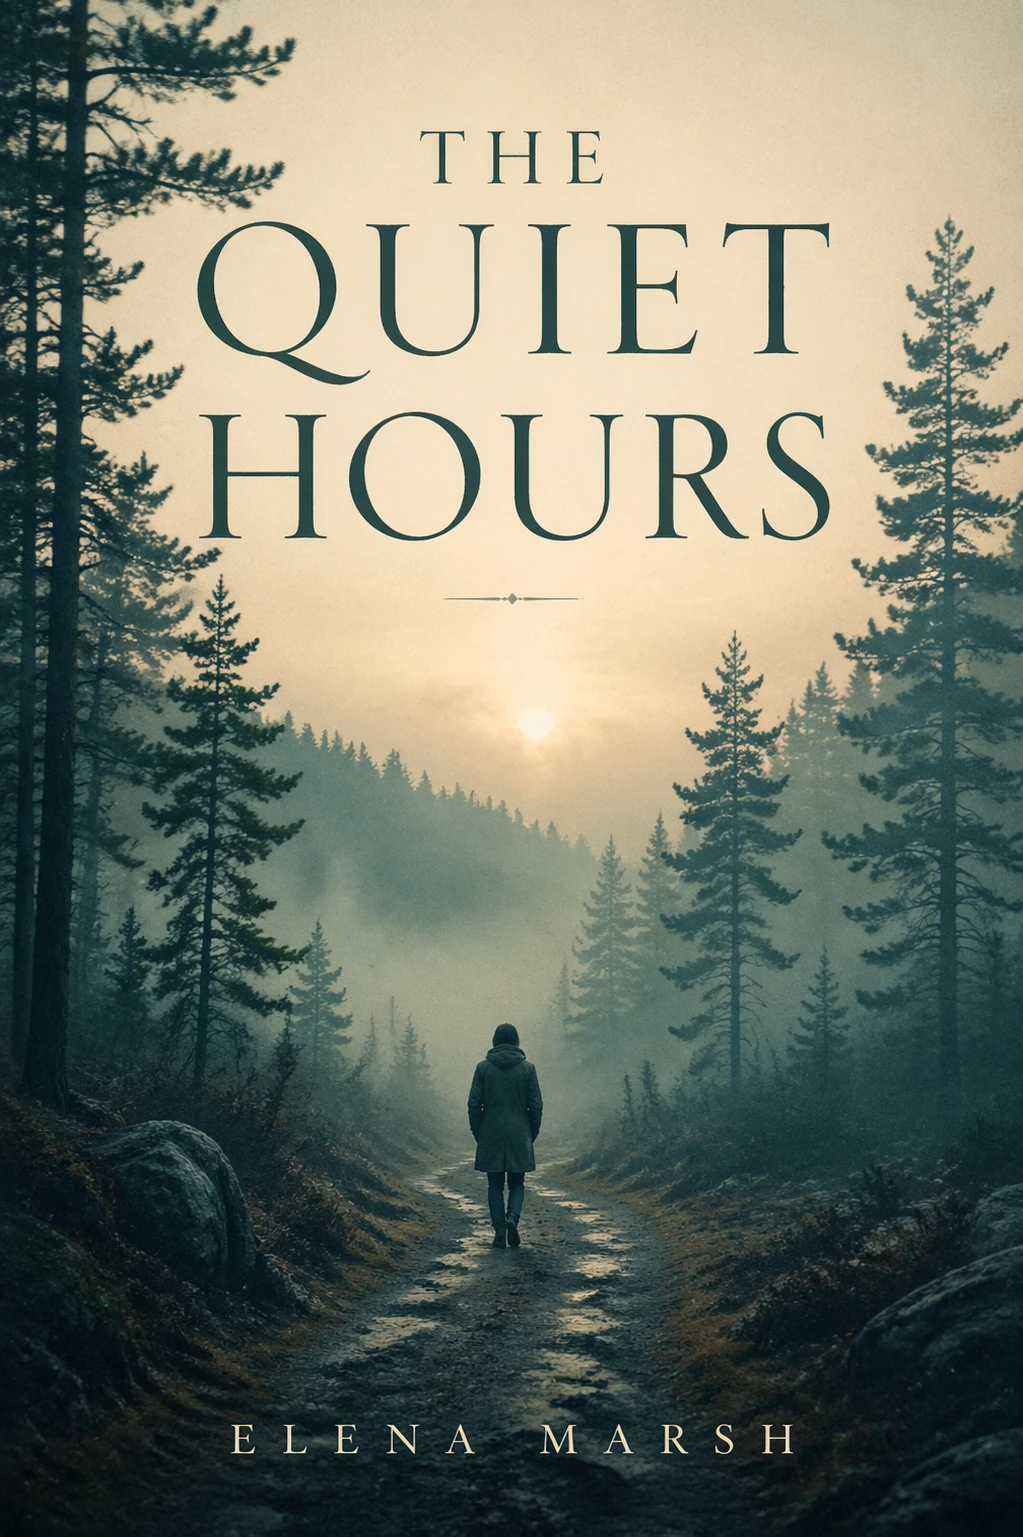
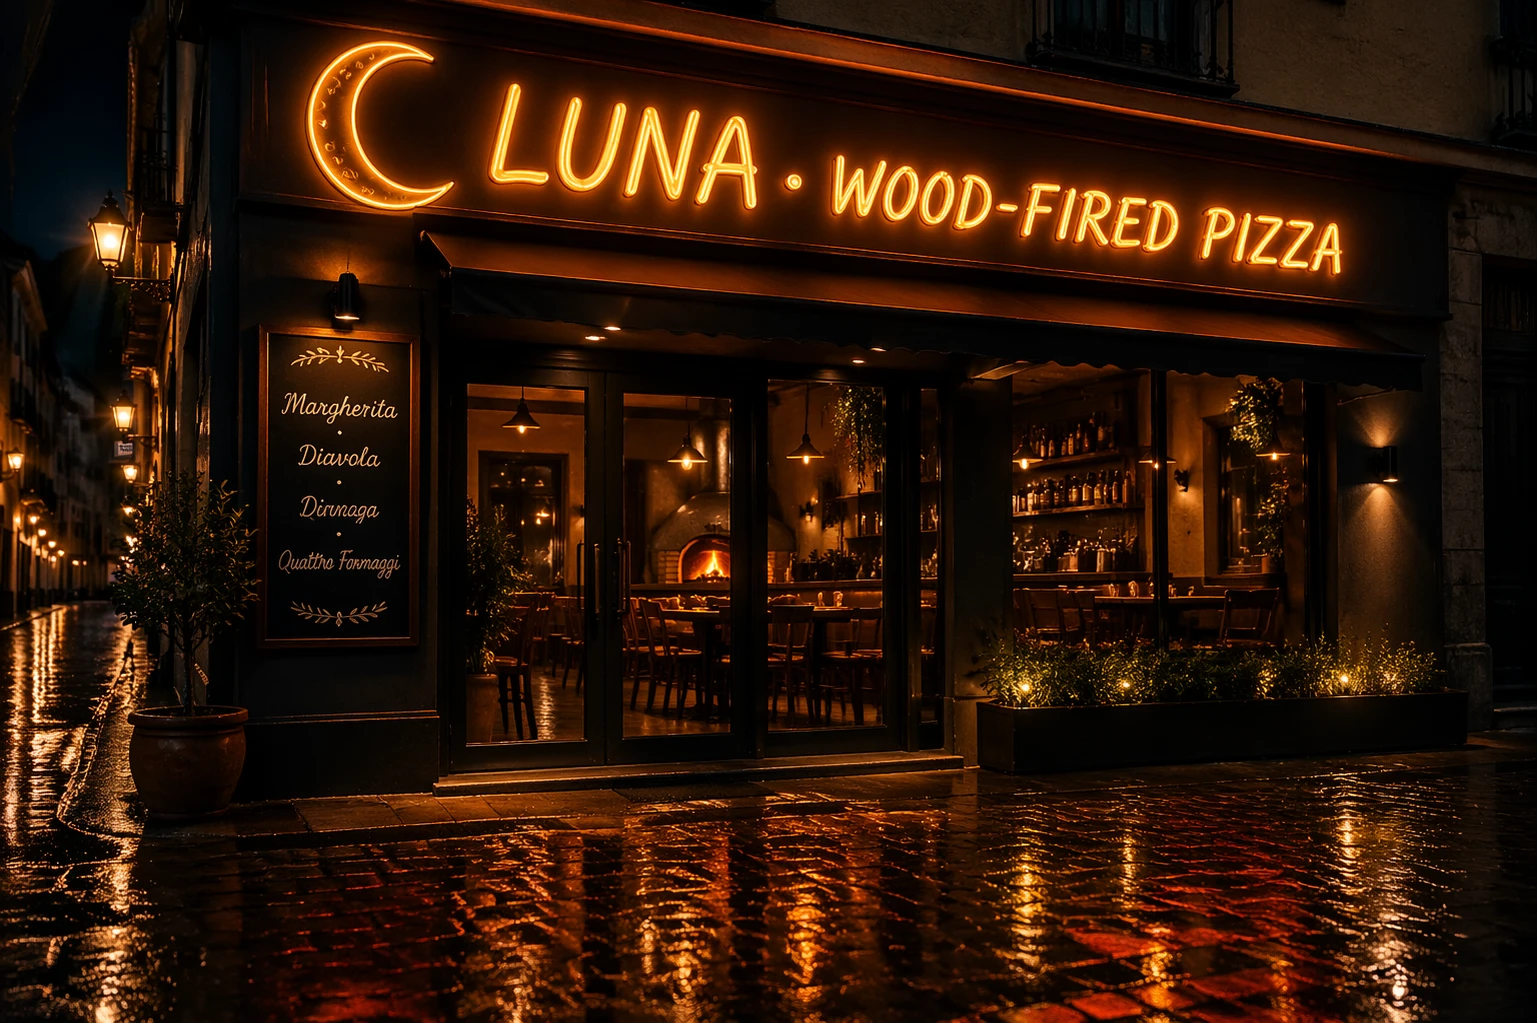
- Testo affidabile nell’immagine: la migliore gestione di testo e loghi produce insegne, etichette e asset di brand più puliti.
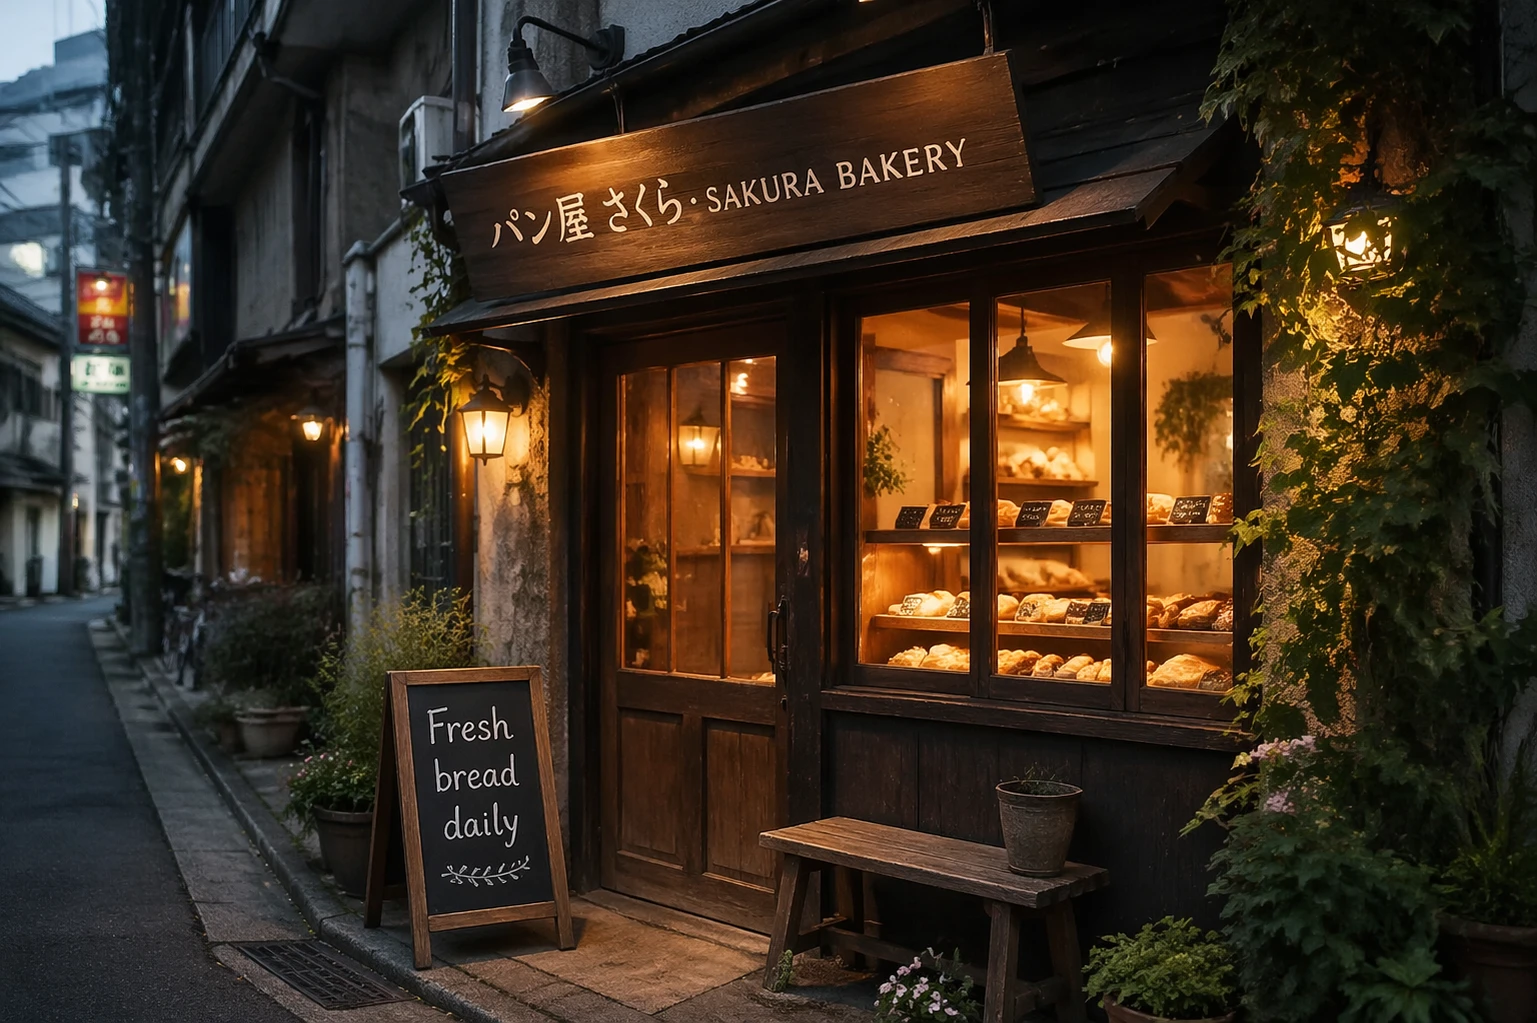
- Comprensione multilingue: accetta prompt in più lingue e, in molti casi, riproduce caratteri non latini nelle immagini.
- Coerenza tra iterazioni: maggiore stabilità di stile e layout consente una direzione creativa ripetibile con modifiche minime al prompt.
- Dimensioni adatte alla produzione: RunComfy offre risoluzioni e proporzioni selezionate per output quadrati, verticali o orizzontali senza regolazioni manuali.
Parametri#
| Parametro | Obbligatorio | Tipo | Predefinito | Intervallo / Opzioni | Descrizione |
|---|
| prompt* | Sì (*) | string | — | — | Prompt positivo della generazione. |
| resolution | No | string | 1K | 1K, 2K, 4K | Livello di risoluzione dell’immagine generata. |
| aspect_ratio | No | string | 1:1 | 1:1, 3:2, 2:3, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 21:9 | Proporzioni dell’immagine generata. |
Come si usa#
- Apri la pagina del modello su RunComfy e seleziona GPT Image 2 dal catalogo Models.
- Scegli la risoluzione 1K, 2K o 4K e le proporzioni 1:1, 3:2, 2:3, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9 o 21:9 in base all’output.
- Scrivi un prompt chiaro con soggetto, ambiente, illuminazione, stile ed eventuale testo da inserire.
- Aggiungi vincoli come angolo di ripresa, composizione o palette cromatica senza sovraccaricare il prompt.
- Fai clic su Generate e controlla l’anteprima quando è pronta.
- Procedi per iterazioni modificando poche parole alla volta, così da isolare l’effetto di ogni cambiamento.
- Scarica il risultato oppure avvia un’altra generazione dall’interfaccia o dall’API RunComfy, quando disponibile.
Suggerimenti per prompt e riferimenti#
- Specifica chiaramente soggetto principale, ambiente e atmosfera, così GPT Image 2 dà priorità agli elementi giusti.
- Per il testo incorporato, racchiudi le parole esatte tra virgolette e mantienile brevi per migliorarne la leggibilità.
- Per testo multilingue, indica lingua e sistema di scrittura, ad esempio kana giapponesi, per ridurre l’ambiguità.
- Usa termini compositivi come regola dei terzi, primo piano o vista aerea per vincolare l’inquadratura.
- Per più varianti, mantieni stabile l’istruzione principale e modifica un solo attributo alla volta.
- Evita istruzioni in conflitto, come “senza testo” insieme alla richiesta di un’insegna, ed elenchi eccessivamente lunghi di stili.
- Se in futuro RunComfy abiliterà l’editing, usa maschere precise e prompt brevi per concentrare GPT Image 2 sull’area desiderata.
Confronto tra GPT Image 2 e altri modelli#
- Rispetto a GPT Image 1.5, GPT Image 2 segue meglio i prompt, rende testo e loghi con maggiore affidabilità e, presso alcuni provider, supporta risoluzioni native più elevate; i dettagli possono variare per piattaforma.
- Miglioramenti principali: gestione multilingue, precisione del layout e coerenza tra generazioni sono miglioramenti spesso citati da utenti e documentazione.
- Caso d’uso ideale: scegli GPT Image 2 per immagini adatte al brand, attente al testo, fedeli alle istruzioni e coerenti tra iterazioni.
- Rispetto a modelli orientati allo stile, come Flux 2, o al fotorealismo, come Nano Banana Pro, privilegia controllo preciso, layout e testo incorporato; scegli alternative per stilizzazione estrema o ritratti fotorealistici di nicchia.
In breve, GPT Image 2 su RunComfy combina qualità, controllo e rendering affidabile del testo per workflow di produzione.
Altri modelli da provare#
- GPT Image 1.5 — Generazione precedente, utile per confronti o prompt più semplici.
- Flux 2 — Maggiore stilizzazione e varietà artistica per look illustrativi.
- Seedream 4.5 — Narrazione cinematografica e atmosfere suggestive tra le scene.
- Nano Banana Pro — Eccellente fotorealismo, soprattutto per ritratti e prodotti.
- Z-Image-Turbo — Opzione rapida e leggera per bozze veloci.
Risorse ufficiali#
- Documentazione del modello OpenAI: https://developers.openai.com/api/docs/models/gpt-image-2
- GitHub di OpenAI: https://github.com/openai