logo
RunComfy
  • ComfyUI
    Workflows par modèle
    • HotMiniMax H3Vidéo avec audio à partir de texte, d'images ou de références
    • HotQwen Image 2.1Créez des images et retouchez des photos par référence
    • WanVidéo à partir de texte ou d'images, transfert de mouvement
    • FLUXGénération, retouche et variations de personnages
    • LTXVidéo avec audio synchronisé à partir de texte ou d'images
    • Qwen Image EditRetouche photo par texte et images de référence
    • Krea 2Création d'images, transfert de style et retouches
    • Z-ImagePortraits et concepts rapides à partir de texte
    Workflows populaires et nouveaux
    • NouveauMiniMax H3 Character Swap V1.5Remplacez des personnages en gardant l'audio d'origine
    • NouveauP-H3-Image Reference EditRetouchez une photo guidée par une image de référence
    • HotMiniMax H3 Image-to-VideoUne image en vidéo cinématique avec audio synchronisé
    • HotLTX 2.5 Image-to-VideoUne image en vidéo nette avec audio synchronisé
    • HotMiniMax H3 Character Swap (SAM3)Remplacez des personnages en suivant le mouvement
    • Qwen Image 2.1 Multi-Image EditingScènes précises avec jusqu'à 10 images de référence
    • FLUX Klein Face SwapÉchange de visage naturel et réaliste
    • SeedVR2 Video UpscalerUpscaling vidéo net et fluide
    Voir plus de workflows
  • Entraîneur
    Entraîner un modèle
    • NouveauMOSS-Image BaseGénération d'images, nouvellement prise en charge
    • NouveauFLUX.3 KleinGénération d'images, nouvellement prise en charge
    • HotKrea 2Le modèle d'image le plus entraîné
    • HotKrea 2 TurboGénération d'images en peu d'étapes
    • HotQwen Image 2.1Génération et retouche d'images
    • Z-Image TurboPortraits et images conceptuelles rapides
    • MiniMax H3Vidéo avec audio synchronisé
    Entraîner et déployer
    • Pour commencerVotre premier entraînement avec Ostris AI Toolkit
    • Jeux de donnéesImportez et gérez vos jeux de données
    • InférenceUtilisez vos modèles dans le playground ou via l'API
    • DéploiementsDéployez vos modèles sur des endpoints dédiés
    Entraîner d'autres modèles
  • Modèles
    Modèles d'images
    • NouveauGPT Image 2.6-5 % · Texte vers image détaillé, GIF et SVG, jusqu'en 4K
    • NouveauSeedream 5.5-10 % · Texte vers image jusqu'en 2K, avec PNG transparents
    • HotSeedream 5.0 Pro-41 % · Retouches par référence, texte multilingue
    • HotSeedream 4.5-20 % · Retouches photoréalistes fidèles à la marque
    • HotWan 2.6 ImageRetouche d'image par instructions
    • FLUX.2Retouches précises et photoréalistes
    • Nano Banana Pro-77 % · Visuels 2K à 4K précis à partir de croquis
    • Qwen Image EditRetouche par LoRA qui respecte la structure
    Modèles vidéo
    • NouveauKling 4.0-10 % · Animez une image en clip de 3 à 30 s
    • HotWan 3.0 Prime-13 % · Clips rapides à partir de vidéos de référence
    • HotSeedance 2.5-36 % · Vidéo cinématique plus longue et plus cohérente
    • HotWan 3.0Clips à partir d'images, de vidéos et d'audio
    • HotMiniMax H3Animez une première image en clip de 5 à 15 s
    • Wan 2.5-10 % · Mouvement fluide et audio natif
    • FLUX 3 MaxClips à partir de texte, d'une image ou d'images clés
    • Wan 2.6 FlashScènes réalistes à partir d'images, dialogues synchronisés
    Voir plus de modèles
  • MCPNouveau
  • Tarification
  • Seedance 2.5Hot
  • Seedream 5.5Nouveau
MODÈLES
Explorer
Tous les modèles
BIBLIOTHÈQUE
Générations
APIS DE MODÈLES
Documentation API
Clés API
COMPTE
Utilisation

Wan 2.7 Texte-image : Générez des images IA en ligne | Modèles et API | RunComfy

wan-ai/wan-2.7/text-to-image

Créez des images de haute qualité avec WAN 2.7 grâce aux prompts chinois ou anglais, au prompt négatif, aux formats prédéfinis, à cinq variantes maximum par requête et aux seeds reproductibles. Environ 0,03 USD par image sur RunComfy. Un filtre de sécurité configurable est également inclus.

Prompt texte décrivant l’image souhaitée. Le chinois et l’anglais sont pris en charge.
Contenu à éviter dans l’image générée. 500 caractères maximum.
Format de sortie prédéfini. Lorsque cette option est prise en charge, un objet `{width, height}` personnalisé peut remplacer la chaîne prédéfinie.
Nombre maximal d’images à générer (1–5). Valeur par défaut : 1.
Seed aléatoire permettant de reproduire un résultat (0–2147483647).
Idle
The rate is $0.03 per image.

Présentation de Wan 2.7 texte-image

Wan 2.7 texte-image d’Alibaba est conçu pour produire des visuels prêts pour la production : respect précis des prompts, instructions en chinois et en anglais, et formats pratiques avec image_size. Sur RunComfy, vous pouvez régler prompt, negative_prompt, image_size, max_images et seed. La famille Wan 2.7 se distingue par ses compositions structurées et sa fidélité aux prompts. Le filtre de sécurité se règle avec enable_safety_checker.
Idéal pour : visuels marketing | concept art | formats pour réseaux sociaux | exploration rapide de mises en page avant un rendu Pro

Wan 2.7 texte-image#


Présentation#


Wan 2.7 texte-image sur RunComfy transforme les prompts chinois ou anglais en images fixes. Le modèle privilégie une compréhension précise des prompts et des résultats détaillés. La résolution maximale et les limites fixes dépendent du déploiement RunComfy actuel.


Champs de réponse#


Chaque requête réussie renvoie une à cinq images dans le tableau images, un éventuel texte du modèle dans generated_text et un seed dans la réponse.


Fonctionnalités principales#


  • Invites bilingues : Anglais et chinois pris en charge.
  • Invite négative : Jusqu'à 500 caractères pour éviter les éléments indésirables.
  • Préréglages image_size : square_hd, square, portrait et paysage 4:3 et 16:9. Un objet {width, height} peut être pris en charge dans les intégrations avancées.
  • Exploration par lots : max_images 1 à 5 pour les variations dans une tâche.
  • Reproductibilité : seed entier facultatif dans la plage [0, 2147483647].
  • Sécurité : enable_safety_checker modère les entrées et les sorties (activé par défaut).

Paramètres#

ParamètreObligatoireTypePar défautPlage / OptionsDescription
prompt*Ouistring——Sujet principal, style et composition
negative_promptNonstring""500 caractères max.Contenu à éviter
image_sizeNonstringsquare_hdenum presetsFormat ou taille de sortie
max_imagesNoninteger11–5Nombre d’images à générer
seedNoninteger—0–2147483647Reproductibilité
enable_safety_checkerNonbooleantrueon / offModération de l’entrée et de la sortie

Tarifs#

FacturationTarif
Par image générée0,03 USD

Les frais évoluent en fonction du nombre d'images (max_images) dans une seule requête.


Mode d’emploi#


  1. Rédigez une invite structurée : sujet, environnement, éclairage, objectif et style.
  2. Ajoutez un court negative_prompt uniquement pour les éléments concrets que vous souhaitez supprimer.
  3. Choisissez une taille prédéfinie qui correspond au rapport hauteur/largeur de votre livraison.
  4. Définissez max_images supérieur à 1 lors de l'exploration des variantes ; gardez seed fixe pour comparer les modifications apportées aux invites.
  5. Soumettez et itérez. Resserrez le vocabulaire de la caméra si la composition dérive.

Conseils pour les prompts#


  • Diriger avec le sujet du héros, puis l'éclairage et les matériaux.
  • Spécifiez explicitement les besoins en matière d'aspect lorsque vous n'utilisez pas de préréglage correspondant.
  • Pour l'itération, modifiez une dimension à la fois (invite vs graine vs taille).

Modèles Wan 2.7 associés#


  • Wan 2.7 Text-to-Image Pro sur RunComfy — niveau de fidélité plus élevé.
  • Wan 2.7 Image Edit sur RunComfy — modifications basées sur des références.
  • Wan 2.7 Text-to-Video — flux de travail de mouvement sur RunComfy.

Modèles similaires

qwen-edit-2509/lora/relight

Rééclairez ou modifiez une image source à partir d’un prompt obligatoire. Vous pouvez régler six tailles de sortie, les étapes d’inférence, l’échelle de guidage, 1 à 4 résultats, la graine et la sortie JPEG ou PNG.
seedream-4-0/edit-sequential

Créez des séquences visuelles fluides et harmonieuses avec un contrôle précis du style.

longcat-image/text-to-image

Générez une image à partir de texte avec six préréglages et contrôles de taille exacte pour les étapes d'inférence, le guidage, la graine et la sortie JPEG, PNG ou WebP.

gpt-image-2/edit

GPT Image 2 Image Edit d'OpenAI : modifications d'image à image avec contrôle précis du texte et peinture in-out
ideogram-v3/remix

Remixez une image avec Ideogram 3 à l’aide d’un prompt et contrôlez le poids de l’image, le rapport largeur/hauteur et d’autres options.

gpt-image-2.6/sunburst/edit

Édition précise basée sur des instructions de jusqu'à 16 images avec des détails stables.

Questions Fréquemment Posées

Qu'est-ce qui alimente la conversion texte-image Wan 2.7 sur RunComfy ?

RunComfy intègre Wan 2.7 texte-image de la famille de modèles Alibaba. Les champs documentés prompt, negative_prompt, image_size, max_images, seed et enable_safety_checker sont envoyés au service d’inférence configuré pour ce modèle.

Combien coûte la conversion texte-image Wan 2.7 par image sur RunComfy ?

Le tarif RunComfy est de 0,03 USD par image générée. Si vous définissez max_images sur une valeur supérieure à 1, le coût total augmente selon le nombre d’images réellement renvoyées.

La conversion texte-image Wan 2.7 prend-elle en charge les invites chinoises ?

Oui. Dans l’interface du modèle RunComfy, vous pouvez rédiger vos prompts en chinois ou en anglais.

Combien d'images puis-je générer dans une seule requête texte-image Wan 2.7 ?

Pour ce modèle, max_images doit être un entier compris entre 1 et 5.

Dois-je utiliser le texte-image Wan 2.7 ou le texte-image Wan 2.7 Pro ?

Les deux versions utilisent les mêmes noms de paramètres. La version standard est moins chère et convient aux brouillons et aux itérations rapides ; Pro vise un résultat plus détaillé à un tarif supérieur par image. Choisissez Standard pour explorer et Pro pour produire le visuel principal final.

Puis-je définir une largeur et une hauteur personnalisées au lieu d’un préréglage `image_size` ?

Cette interface utilise des préréglages de type string afin que l’intégration par défaut associe les entrées de manière fiable. Un objet {width, height} personnalisé peut être pris en charge dans les configurations avancées ou via l’API uniquement. Vérifiez cette possibilité dans votre espace de travail RunComfy avant d’utiliser des dimensions arbitraires.

Suivez-nous
  • LinkedIn
  • Facebook
  • Instagram
  • Twitter
Support
  • Discord
  • Email
  • État du système
  • affilié
Modèles vidéo
  • LTX 2
  • Wan 3.0
  • MiniMax H3 Fast
  • Wan 2.5
  • Seedance 2.5 Reference to Video 480p
  • Seedance 1.0 Pro Fast
  • Voir tous les modèles →
Modèles d'images
  • GPT Image 2.6 Sunburst Image Edit
  • GPT Image 2.6 Sunburst
  • Wan 2.6 Image to Image
  • Nano Banana Pro
  • Seedream 5.0 Pro
  • Flux 2 Max Edit
  • Voir tous les modèles →
Légal
  • Conditions d'utilisation
  • Politique de confidentialité
  • Politique relative aux cookies
RunComfy
Droits d'auteur 2026 RunComfy. Tous droits réservés.

RunComfy est la première ComfyUI plateforme, offrant des ComfyUI en ligne environnement et services, ainsi que des workflows ComfyUI proposant des visuels époustouflants. RunComfy propose également AI Models, permettant aux artistes d'utiliser les derniers outils d'IA pour créer des œuvres d'art incroyables.
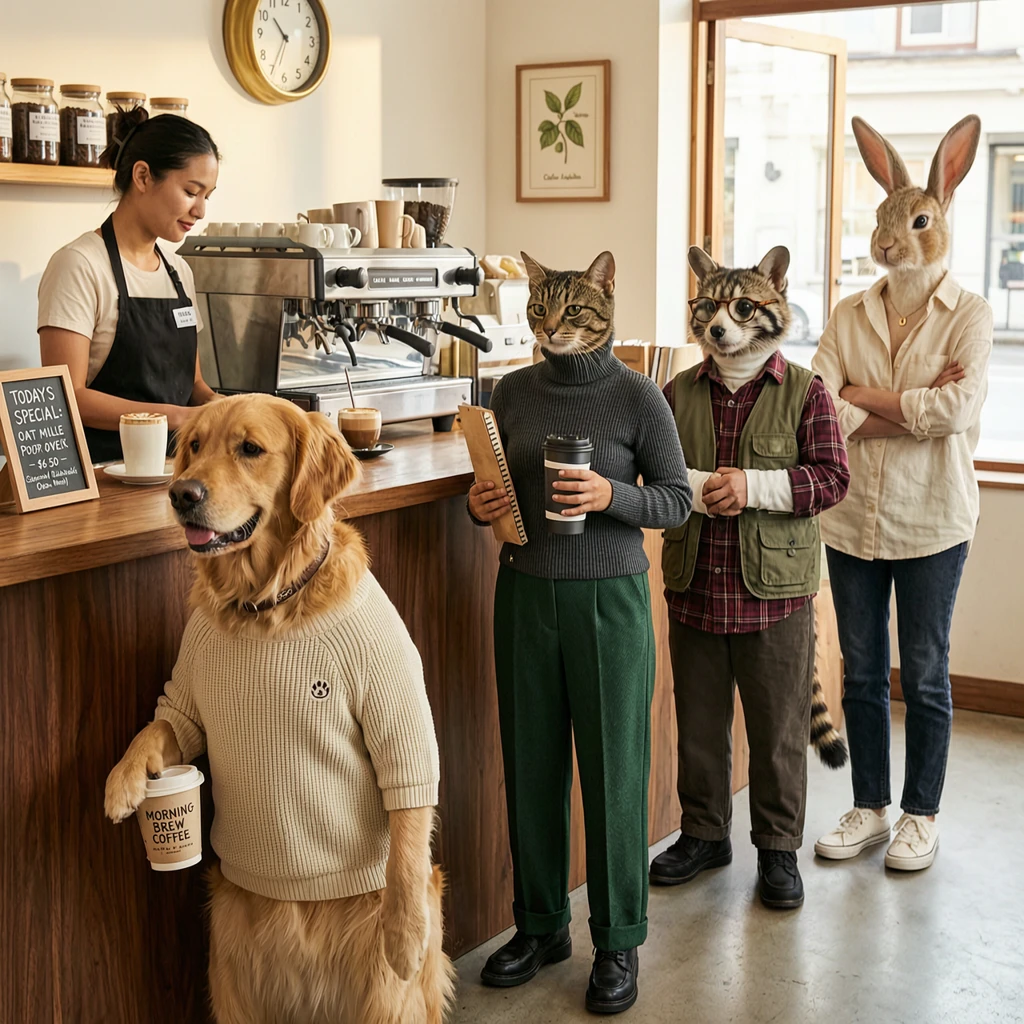
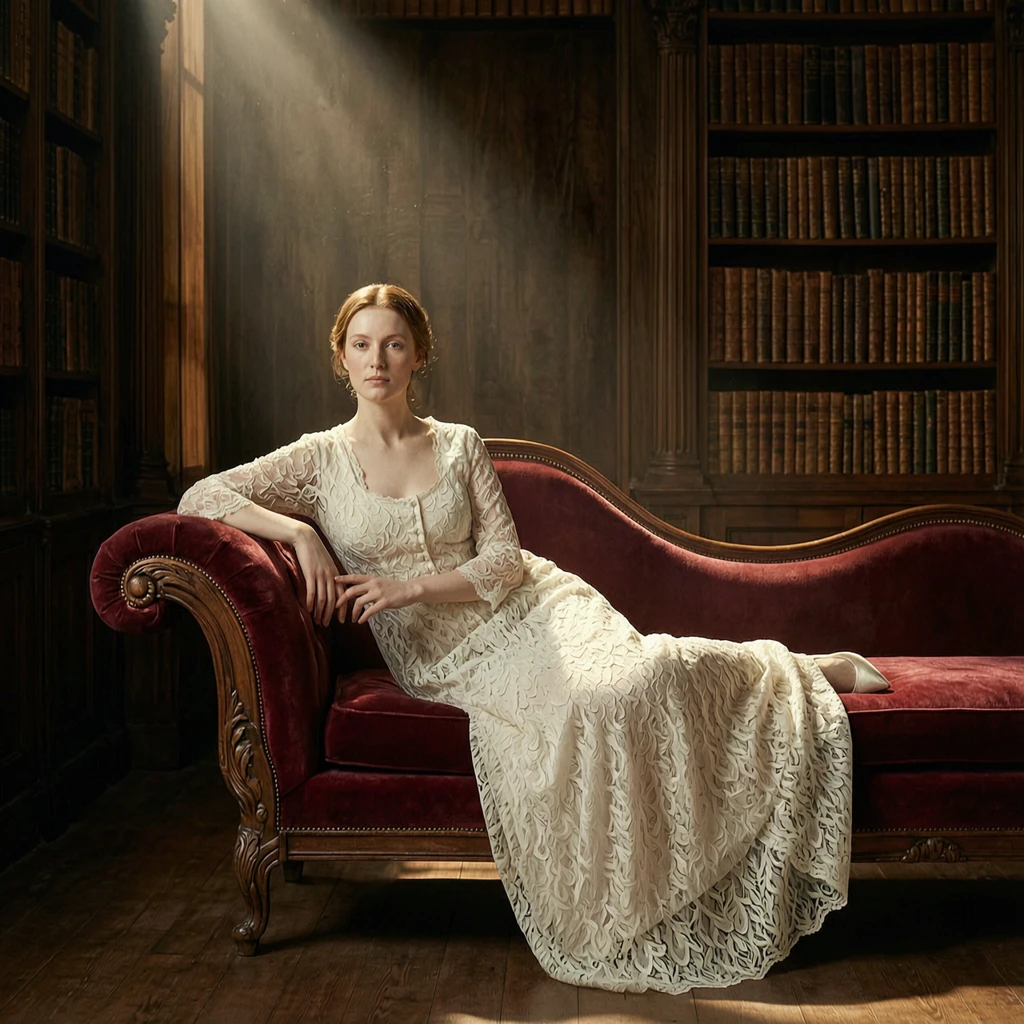
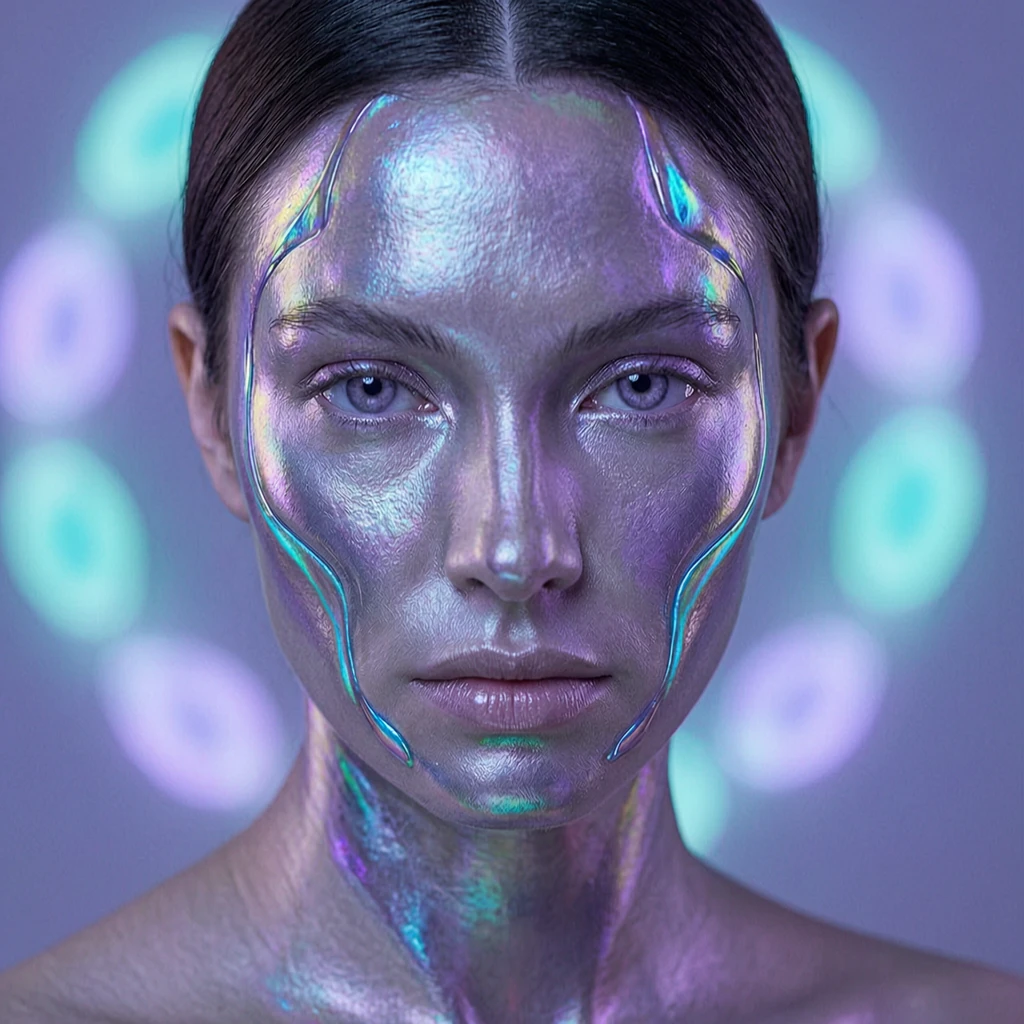
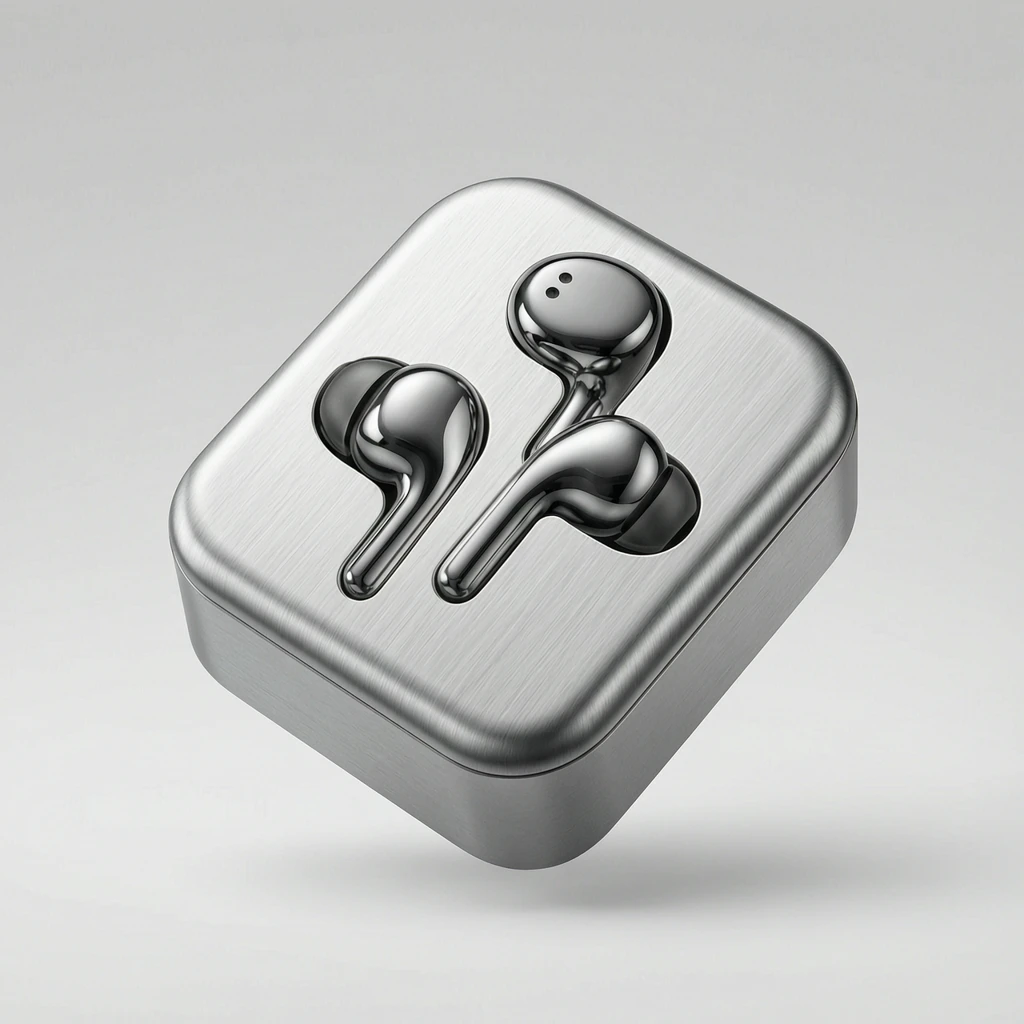
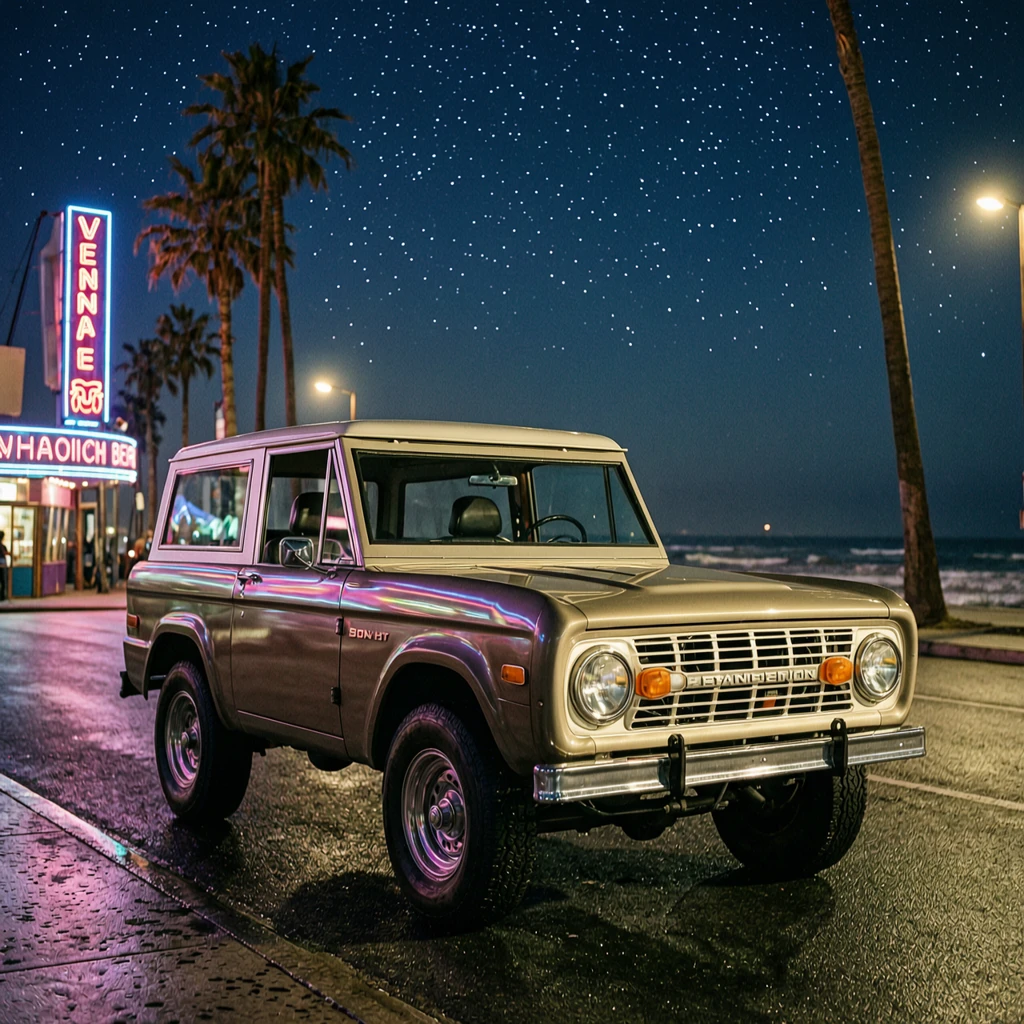
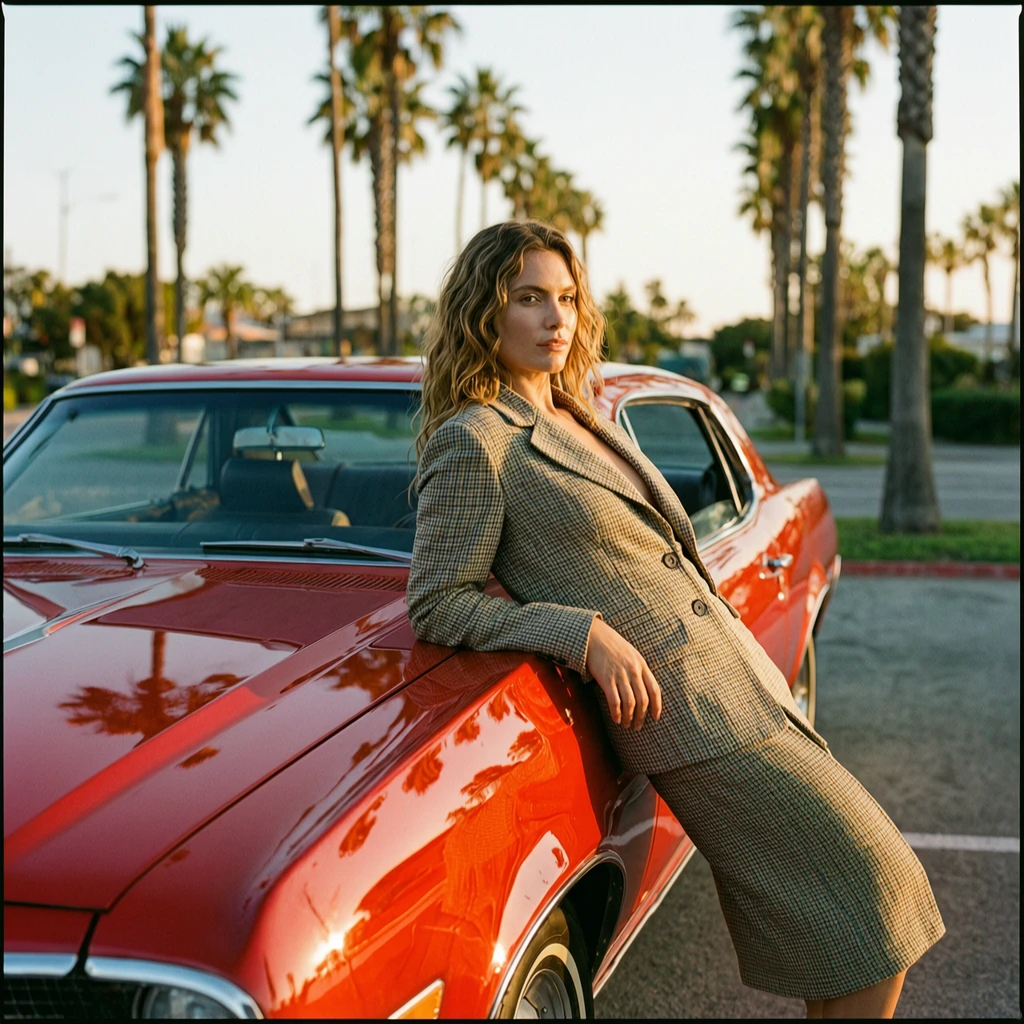
Exemples avec Wan 2.7 texte-image