logo
RunComfy
  • ComfyUI
  • TrainerNeu
  • Modelle
  • API
  • Preise
discord logo
MODELLE
Erkunden
Alle Modelle
BIBLIOTHEK
Generierungen
MODELL-APIS
API-Dokumentation
API-Schlüssel
KONTO
Nutzung

WAN 2.2 LoRA Text-zu-Bild mit Größe und Format | RunComfy

wan-ai/wan-2-2/lora/text-to-image

Text in ein Bild umsetzen und LoRAs, Bildgröße, Format und Seed festlegen.

Beschreiben Sie Motiv, Handlung, Umgebung, Bildausschnitt und gewünschte visuelle Richtung.
LoRA #1
URL oder Hugging-Face-Repo-ID (owner/repo) der LoRA-Gewichte.
Wählen Sie `high`, `low` oder `both`; Standard ist `both`.
Stärke der LoRA-Anwendung von 0 bis 4; Standard ist 1.
Erforderliche LoRA-Liste mit höchstens 3 Einträgen; jeder Pfad kann eine URL oder eine Hugging-Face-Repo-ID sein.
Wählen Sie eine der 7 aufgeführten Größen, einschließlich `Custom`; Standard ist `square_hd`.
Wählen Sie `png` oder `jpeg`; Standard ist `jpeg`.
Ganzzahliger Seed von 10000 bis 99999.
Idle
The rate is $0.05 per image.

WAN 2.2 LoRA Text-zu-Bild

Diese Text-zu-Bild-Seite verwendet einen Prompt und eine erforderliche LoRA-Liste mit höchstens 3 Einträgen. Für jeden LoRA-Eintrag lassen sich Pfad, Ziel (high, low oder both) und Stärke von 0 bis 4 einstellen.

Für die Bildgröße stehen square_hd, square, portrait_4_3, portrait_16_9, landscape_4_3, landscape_16_9, Custom zur Auswahl. Das Ausgabeformat ist png oder jpeg; zusätzlich kann ein Seed von 10000 bis 99999 festgelegt werden.

Ähnliche Modelle

Veo 2

Realistische Bewegungen, dynamische Kameraarbeit und physikgetreue Szenen

kling-video-o3/pro/image-to-video

Bildanimation in Pro-Qualität: cineastische Clips mit 3–15 Sekunden Dauer ab 0,111 $ pro Sekunde.

seedance-2.5/image-to-video/720p

Seedance 2.5: Animieren Sie ein Standbild in ein filmisches KI-Video
kling-2-1/master/text-to-video

Erzeugen Sie mit Kling 2.1 Master ein Video aus einem Prompt und wählen Sie Dauer, Seitenverhältnis, negativen Prompt und Prompt-Stärke.

kling-video-o1/video-to-video/edit

Bearbeiten Sie ein Referenzvideo anhand eines Prompts und optionaler Element- oder Bildreferenzen; auf Wunsch bleibt der Originalton erhalten.

ai-avatar/v2/pro

Erstellen Sie ein Avatar-Video aus einer erforderlichen Bild- und Audiodatei, mit einem optionalen Prompt zur Unterstützung bei der Generierung.

Häufig gestellte Fragen

Was macht WAN 2.2 LoRA auf dieser Seite?

Es erzeugt aus einem Text-Prompt ein Bild und wendet die gewählten LoRAs an.

Welche Eingaben sind erforderlich?

prompt und loras sind erforderlich; die LoRA-Liste kann höchstens 3 Einträge enthalten.

Welche Einstellungen besitzt ein LoRA-Eintrag?

Pfad, Ziel (high, low oder both) und Stärke von 0 bis 4; Standardwerte sind both und 1.

Welche Bildgrößen sind verfügbar?

square_hd, square, portrait_4_3, portrait_16_9, landscape_4_3, landscape_16_9, Custom; Standard ist square_hd.

Wofür dient `Custom`?

Custom ist eine der wählbaren Größenoptionen.

Welche Bildformate sind verfügbar?

png und jpeg; Standard ist jpeg.

Welcher Bereich gilt für den Seed?

seed reicht von 10000 bis 99999; Standard ist 74965.

Folge uns
  • LinkedIn
  • Facebook
  • Instagram
  • Twitter
Support
  • Discord
  • E-Mail
  • Systemstatus
  • Partner
Videomodelle
  • Kling 4.0 Image to Video
  • Kling 4.0 Reference to Video
  • Kling 4.0 Video Editing
  • Wan 3.0
  • Wan 2.5
  • MiniMax H3 Fast
  • Alle Modelle anzeigen →
Bildmodelle
  • Seedream 4.5
  • Seedream 5.0 Pro
  • Flux 2 Pro
  • Qwen Image Edit 2511 LoRA
  • seedream 4.0
  • Nano Banana Pro
  • Alle Modelle anzeigen →
Rechtliches
  • Nutzungsbedingungen
  • Datenschutzrichtlinie
  • Cookie-Richtlinie
RunComfy
Urheberrecht 2026 RunComfy. Alle Rechte vorbehalten.

RunComfy ist die führende ComfyUI Plattform, die ComfyUI online Umgebung und Services bietet, zusammen mit ComfyUI Workflows mit atemberaubenden Visualisierungen. RunComfy bietet auch AI Models, Künstlern ermöglichen, die neuesten AI-Tools zu nutzen, um unglaubliche Kunst zu schaffen.
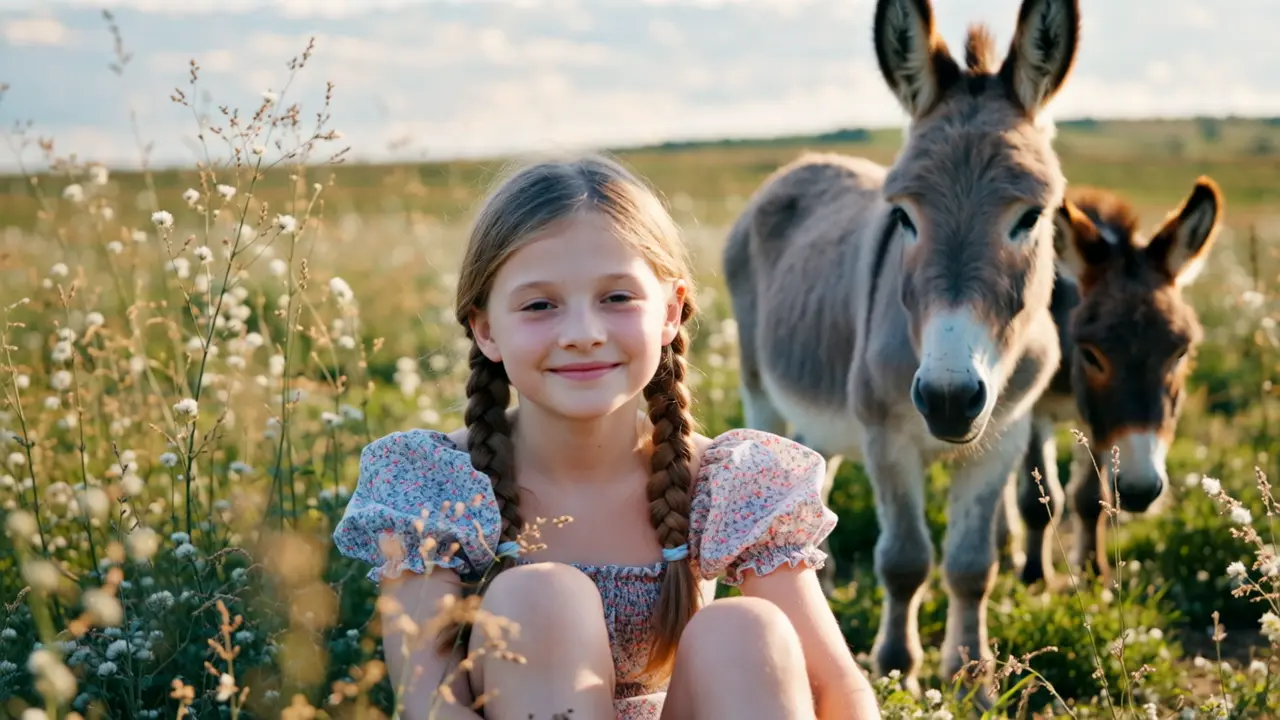
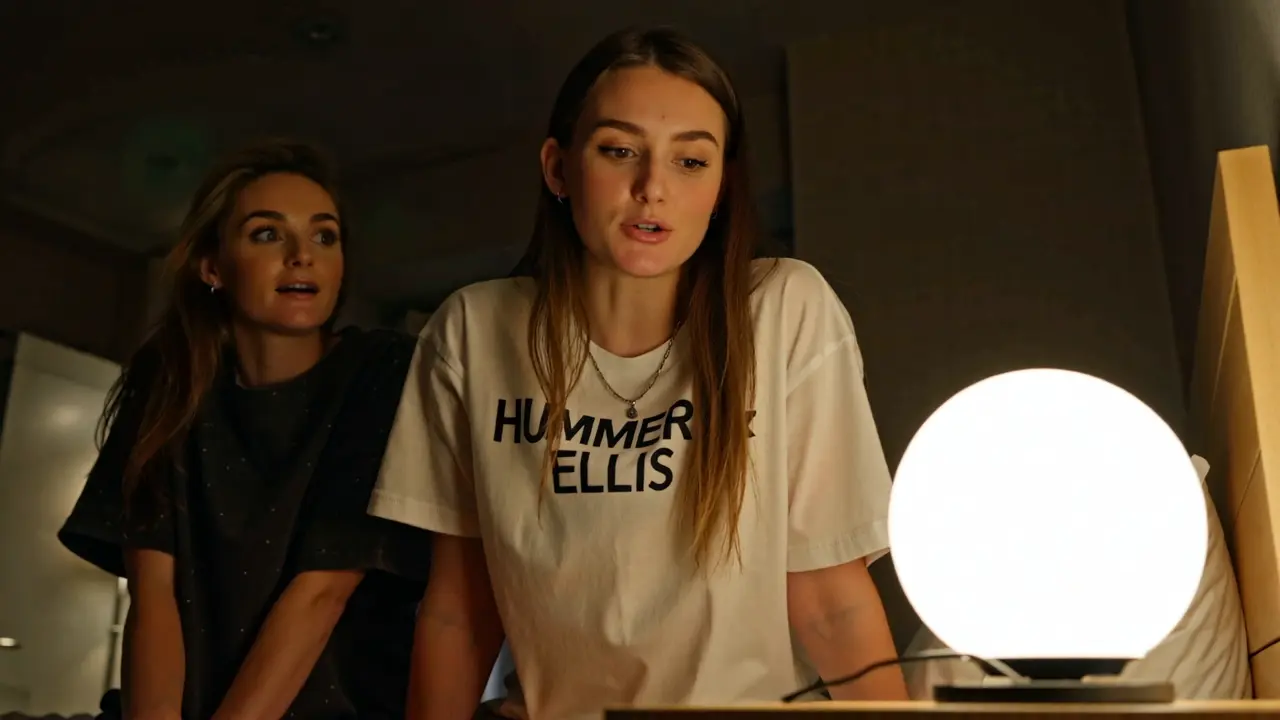
Beispiele mit WAN 2.2 LoRA Text-zu-Bild